

Los invito a revisar la transcripción de la presentación de Alexander Sigachev sobre el Service Discovery en sistemas distribuidos tomando como ejemplo Consul.
El Service Discovery está creado para permitir la conexión de nuevas aplicaciones en nuestro entorno existente con costos mínimos. Utilizando el Service Discovery, podemos separar al máximo ya sea un contenedor en forma de Docker o un servicio virtual del entorno en el que se ejecuta.
¡Hola a todos! Soy Alexander Sigachev, trabajo en la empresa Inventos. Hoy les presentaré el concepto de Service Discovery. Analizaremos el Service Discovery a través del ejemplo de Consul.
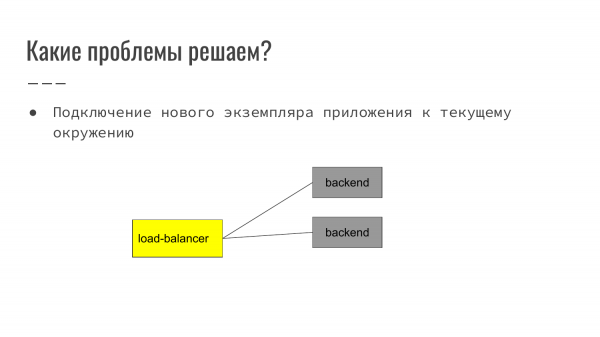
¿Qué problemas resuelve el Service Discovery? Este se creó para facilitar la conexión de nuevas aplicaciones a nuestro entorno existente con los mínimos costos. Al utilizar el Service Discovery, podemos separar al máximo un contenedor en forma de Docker o un servicio virtual del entorno en el que se ejecuta.
¿Cómo se ve esto? En un ejemplo clásico en la web: es el frontend que recibe la solicitud del usuario. Luego realiza la ruta hacia el backend. En este caso, un balanceador de carga que se distribuye entre dos backends.
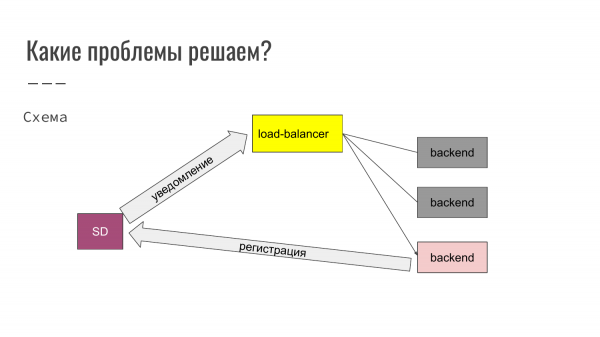
Aquí vemos que estamos lanzando una tercera instancia de la aplicación. Cuando se inicia la aplicación, se registra en el Service Discovery. Este notifica al balanceador de carga. El balanceador de carga actualiza automáticamente su configuración y el nuevo backend se activa. De esta manera, los backends pueden ser añadidos o, por el contrario, excluidos de operación.
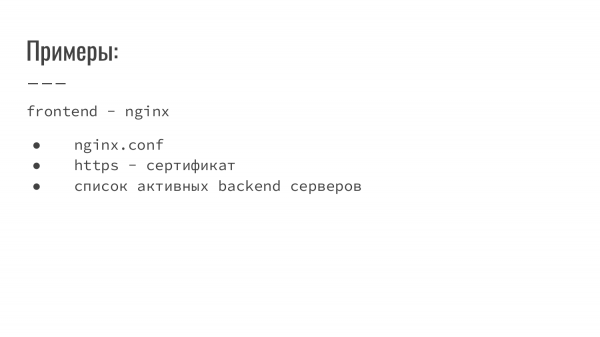
¿Qué más se puede hacer con el Service Discovery? Puede almacenar configuraciones de nginx, certificados y una lista de servidores backend activos.
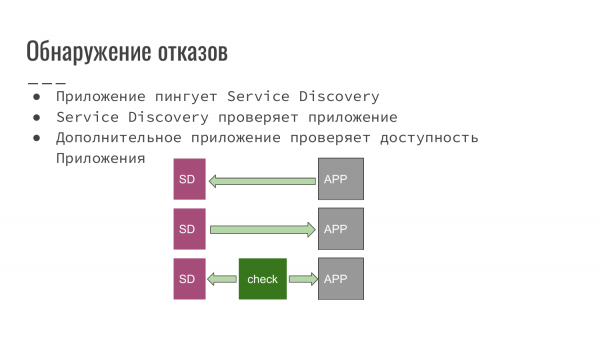 Además, el Service Discovery permite detectar fallos y errores. ¿Cuáles son los posibles esquemas para la detección de fallos?
- Esta aplicación que hemos desarrollado, se notifica a sí misma al Service Discovery que sigue operativo.
- El Service Discovery, por su parte, interroga a la aplicación para verificar su disponibilidad.
- O se puede utilizar un script o aplicación externa que verifique la disponibilidad de nuestra aplicación y notifique al Service Discovery tanto que todo está bien y se puede operar, como por el contrario, que hay problemas y es necesario excluir esa instancia de la equilibración.
Cada uno de los esquemas puede aplicarse dependiendo del software que usemos. Por ejemplo, si hemos comenzado a desarrollar un nuevo proyecto, podemos establecer fácilmente un esquema donde nuestra aplicación notifica a Service Discovery. O podemos conectar Service Discovery para que realice la verificación.
Sin embargo, si la aplicación nos fue heredada o fue desarrollada por algún tercero, entonces se aplica la tercera opción, donde escribimos un manejador, y todo esto se integra automáticamente en nuestro trabajo.
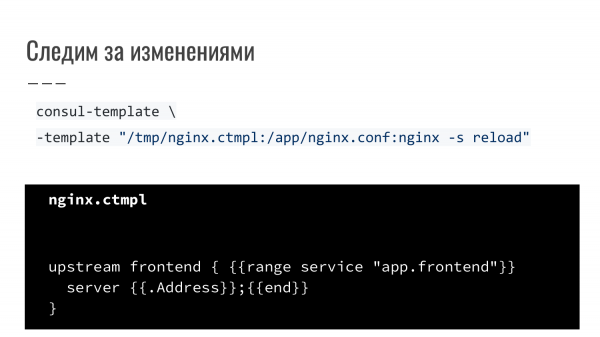
Este es uno de los ejemplos. Un balanceador de carga en forma de nginx se reinicia. Es una utilidad adicional que se proporciona junto con Consul. Esto es consul-template. Describimos una regla. Decimos que usamos una plantilla (plantillador de Golang). Al ocurrir eventos, cuando se notifican cambios, se regenera y Service Discovery recibe el comando «reload». Un ejemplo simple es cuando nginx se reconfigura y se reinicia debido a un evento.
¿Qué es Consul?
Sobre todo, es Service Discovery.
Tiene un mecanismo de verificación de disponibilidad: Health Checking.
También cuenta con KV Store.
Y su fundamento permite el uso de Multi Datacenter.
¿Para qué se puede utilizar todo esto? En KV Store podemos almacenar ejemplos de configuraciones. Con el Health Checking podemos verificar servicios locales y notificar. Multi Datacenter se utiliza para construir un mapa de servicios. Por ejemplo, Amazon tiene varias zonas y dirige el tráfico de la manera más óptima para evitar solicitudes innecesarias entre data centers, que se tarifan por separado del tráfico local y, por lo tanto, tienen menor latencia.
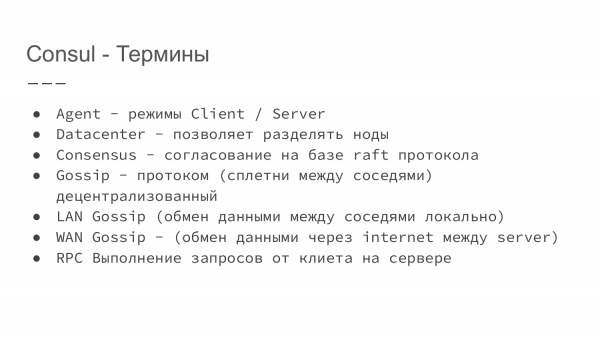
Vamos a aclarar un poco los términos que se utilizan en Consul.
- Consul es un servicio escrito en Go. Una de las ventajas de un programa en Go es que es un único archivo binario, que simplemente descargas, ejecutas desde cualquier lugar y no tienes dependencias.
- A continuación, mediante claves, podemos iniciar este servicio ya sea en modo cliente o en modo servidor.
- Además, el atributo «datacenter» permite marcar a qué data center pertenece este servidor.
- Consensus se basa en el protocolo raft. Si alguien está interesado, se puede leer más sobre esto en el sitio web de Consul. Este es un protocolo que permite determinar un líder y establecer qué datos considerar válidos y disponibles.
- Gossip es un protocolo que asegura la interacción entre nodos. Además, este sistema es descentralizado. Dentro de un mismo centro de datos, todos los nodos se comunican con sus vecinos. Por lo tanto, se intercambia información sobre el estado actual. Se puede decir que son chismes entre vecinos.
- LAN Gossip es el intercambio local de datos entre vecinos dentro de un mismo centro de datos.
- WAN Gossip se utiliza cuando necesitamos sincronizar información entre dos centros de datos. La información circula entre nodos que están etiquetados como servidores.
- RPC permite realizar solicitudes a través del cliente en el servidor.
Descripción de RPC. Supongamos que en una máquina virtual o en un servidor físico se está ejecutando Consul como cliente. Nos dirigimos a él localmente. Luego, el cliente local solicita información al servidor y se sincroniza. Dependiendo de la configuración, la información puede ser proporcionada desde la caché local o puede sincronizarse con el líder, con el servidor maestro.
Ambos esquemas tienen sus ventajas y desventajas. Si trabajamos con caché local, es rápido. Si trabajamos con datos que se almacenan en el servidor, es más lento, pero obtenemos información más actualizada.
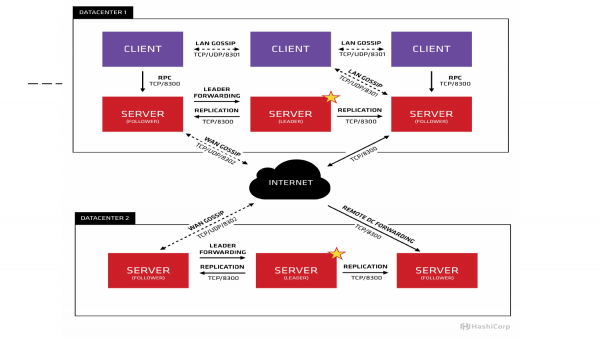
Si lo representamos gráficamente, sería una imagen del sitio. Vemos que tenemos tres maestros activados. Uno está marcado con una estrella como líder. En este ejemplo hay tres clientes que intercambian información localmente a través de UDP/TCP. La información entre centros de datos se transmite entre servidores. Aquí, los clientes interactúan entre sí localmente.
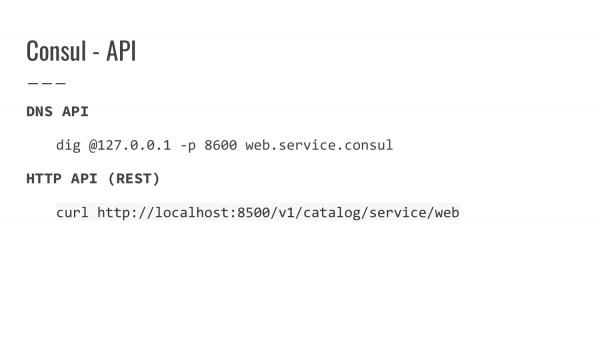
¿Qué API proporciona Consul? Para obtener información, hay dos tipos de API en Consul.
Esta es la API DNS. Por defecto, Consul se inicia en el puerto 8600. Podemos configurar el proxy de solicitud y garantizar el acceso a través de la resolución local, a través del DNS local. Podemos solicitar por dominio y recibir información sobre la dirección IP a cambio.
HTTP API - o podemos solicitar información sobre un servicio específico localmente en el puerto 8500 y recibiremos una respuesta JSON, que indica qué IP tiene el servidor, qué host, qué puerto está registrado. Y puede ser que información adicional se envíe a través de un token.
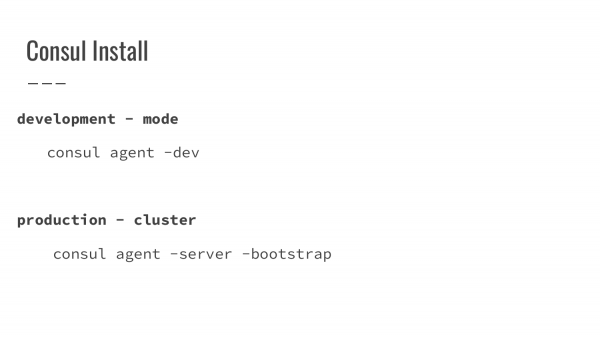
¿Qué se necesita para ejecutar Consul?
En la primera opción, en modo desarrollador, indicamos una bandera que marca este como el modo de desarrollo. El agente se inicia como un servidor y realiza toda la función de manera independiente en una sola máquina. Es conveniente, rápido y prácticamente no se requieren configuraciones adicionales para el primer inicio.
El segundo modo es el inicio en producción. Aquí, el inicio es un poco más complicado. Si no tenemos ninguna versión del consulado, debemos traer la primera máquina en bootstrap, es decir, esta máquina asumirá las responsabilidades de líder. La levantamos, luego levantamos una segunda instancia del servidor, pasándole la información sobre dónde está el maestro. Finalmente, levantamos la tercera. Una vez que tenemos tres máquinas operativas, reiniciamos la primera máquina desde el bootstrap en modo normal. Los datos se sincronizan, y el clúster inicial ya está operativo.
Se recomienda ejecutar entre tres y siete instancias en modo servidor. Esto se debe a que al aumentar el número de servidores, el tiempo de sincronización de la información entre ellos también aumenta. El número de nodos debe ser impar para garantizar el quorum.
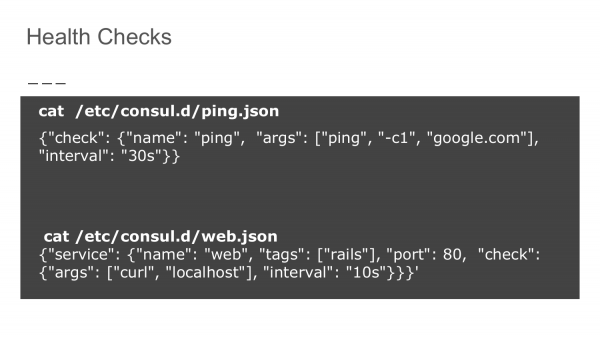
¿Cómo se realizan los Health Checks? En el directorio de configuración de Consul, escribimos una regla de verificación en formato JSON. La primera opción es la disponibilidad del dominio google.com, en este ejemplo. Indicamos que esta verificación debe realizarse cada 30 segundos. De esta manera, comprobamos que nuestro nodo tiene acceso a la red externa.
La segunda opción es la auto-verificación. Usamos curl para consultar localhost en el puerto indicado cada 10 segundos.
Estas verificaciones se suman y se envían a Service Discovery. Basado en la disponibilidad, estos nodos son excluidos o aparecen en la lista de máquinas disponibles y funcionando correctamente.
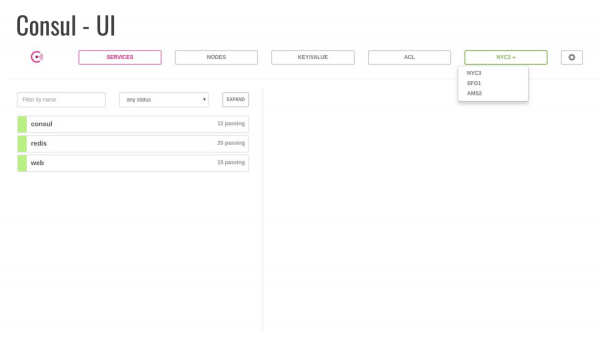
Consul también proporciona una interfaz de usuario que se inicia con un flag separado y estará disponible en la máquina. Esto permite visualizar información y también realizar algunas modificaciones.
En este ejemplo, está abierta la pestaña 'Servicio'. Se muestra que se han iniciado tres servicios, uno de los cuales es Consul. Se presenta el número de verificaciones realizadas y hay tres centros de datos donde se encuentran las máquinas.
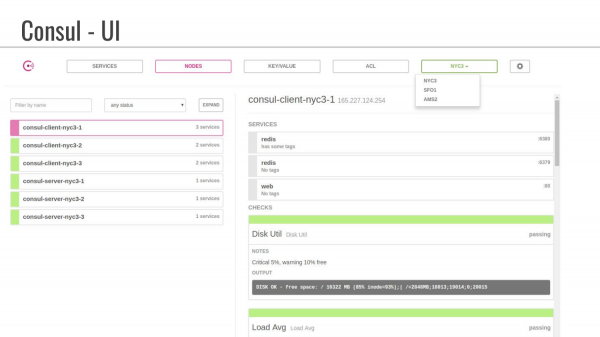
Este es un ejemplo de la pestaña «Nodes». Vemos que tienen nombres compuestos que incluyen centros de datos. También se muestra qué servicios están activos, es decir, vemos que no se han asignado etiquetas. En estas etiquetas adicionales se puede proporcionar información que el desarrollador puede usar para especificar parámetros adicionales.
También se puede transmitir información a Consul sobre el estado de los discos y la carga media.
Preguntas
Pregunta: Tenemos un contenedor de Docker, ¿cómo utilizarlo con Consul?
Respuesta: Para el contenedor de Docker hay varios enfoques. Uno de los más comunes es usar un contenedor de Docker de terceros que se encargue del registro. Al iniciarlo, se le pasa el socket de Docker. Todos los eventos de registro y despublicación del contenedor se registran en Consul.
Pregunta: O sea, ¿Consul inicia el contenedor de Docker por sí mismo?
Respuesta: No. Nosotros iniciamos el contenedor de Docker. Y en la configuración especificamos: escucha en este socket. Es algo similar a cómo funciona el certificado, cuando pasamos información sobre dónde y qué tenemos.
Pregunta: Entonces, ¿dentro del contenedor de Docker que estamos tratando de conectar a Service Discovery debe haber lógica que pueda enviar datos a Consul?
Respuesta: No exactamente. Cuando se inicia, pasamos variables a través del entorno. Por ejemplo, el nombre del servicio, el puerto del servicio. En el registro, esta información es escuchada y se registra en Consul.
Pregunta: Tengo otra pregunta sobre la interfaz de usuario. Hemos desplegado la interfaz de usuario, digamos, en el servidor de producción. ¿Qué pasa con la seguridad? ¿Dónde se almacenan los datos? ¿Se puede acumular información de alguna manera?
Respuesta: En la interfaz de usuario, de hecho, los datos provienen de la base de datos y de Service Discovery. Nosotros configuramos las contraseñas por nuestra cuenta.
Pregunta: ¿Se puede publicar esto en internet?
Respuesta: Por defecto, Consul se inicia en localhost. Para publicarlo en internet, será necesario configurar un proxy. Nos hacemos responsables de las reglas de seguridad.
Pregunta: ¿Proporciona datos históricos por defecto? Me gustaría ver estadísticas sobre los Health Checks. Se pueden diagnosticar problemas si el servidor falla con frecuencia.
Respuesta: No estoy seguro de que haya detalles sobre las comprobaciones.
Pregunta: No es tanto importante el estado actual, sino la dinámica.
Respuesta: Para el análisis, sí.
Pregunta: ¿No es mejor no usar Service Discovery para Docker con Consul?
Respuesta: No lo recomendaría. El objetivo de la presentación es familiarizarse con este concepto. Históricamente ha recorrido un camino, creo, hasta la versión 1. Actualmente hay soluciones más completas, como Kubernetes, que ya integra todo esto. En el ámbito de Kubernetes, Service Discovery pierde ante Etcd. Pero no lo conozco tan a fondo como a Consul. Por eso decidí hacer el ejemplo de Service Discovery con Consul.
Pregunta: ¿El esquema con un servidor líder no retrasa el inicio de la aplicación en general? ¿Y cómo determina Consul un nuevo líder si este falla?
Respuesta: Ellos han descrito todo un protocolo. Si es de su interés, se puede leer.
Pregunta: ¿Consul actúa como un servidor completo y todas las solicitudes pasan a través de él?
Respuesta: No actúa como un servidor completo, sino que asigna una zona específica. Esta, por lo general, termina en service.consul. Luego seguimos lógicamente. No usamos nombres de dominio en producción, sino infraestructura interna, que usualmente se oculta detrás del servidor de caché, si trabajamos por DNS.
Pregunta: Es decir, si queremos acceder a la base de datos, de cualquier manera consultaremos a Consul primero para encontrar esa base, ¿verdad?
Respuesta: Sí. Si trabajamos por DNS, esto funciona como sin Consul, al usar nombres DNS. Normalmente, las aplicaciones modernas no consultan el nombre de dominio en cada solicitud, porque hemos establecido la conexión, todo funciona y en el corto plazo no la utilizamos. Si la conexión se rompe, entonces sí, volvemos a preguntar dónde está nuestra base y vamos a buscarla.
— Chat de usuarios de Hashicorp: Consul, Nomad, Terraform
P.S. Acerca de los chequeos de salud. En Consul, al igual que en Kubernetes, se utiliza un sistema de verificación de la salud del servicio basado en el código de estado.
200 OK para saludable
503 Servicio no disponible para no saludable
Fuentes:
Fuente: habr.com
