

Hola, hubronianos. Continuamos compartiendo contenido interesante en la antesala del lanzamiento de nuevos cursos. Hoy, especialmente para ustedes, hemos traducido un artículo sobre Google Cloud Spanner, coincidiendo con el lanzamiento del curso. .
Publicado originalmente en .
Como empresa que ofrece numerosas soluciones POS en la nube para minoristas, restauradores y vendedores en línea en todo el mundo, Lightspeed utiliza varios tipos de plataformas de bases de datos para numerosos casos transaccionales, analíticos y de búsqueda. Cada una de estas plataformas de bases de datos tiene sus fortalezas y debilidades. Por lo tanto, cuando Google presentó Cloud Spanner al mercado, una solución prometedora con características sin precedentes en el mundo de las bases de datos relacionales, como escalabilidad horizontal prácticamente ilimitada y un SLA del 99.999%, ¡no pudimos dejar pasar la oportunidad de tenerla en nuestras manos!
Para ofrecer una visión completa de nuestra experiencia con Cloud Spanner, así como de los criterios de evaluación que utilizamos, abordaremos los siguientes temas:
- Nuestros criterios de evaluación
- Cloud Spanner en pocas palabras
- Nuestra evaluación
- Nuestras conclusiones
1. Nuestros criterios de evaluación
Antes de profundizar en las características de Cloud Spanner, sus similitudes y diferencias con otras soluciones en el mercado, primero hablemos sobre los principales casos de uso que consideramos al analizar dónde desplegar Cloud Spanner en nuestra infraestructura:
- Como sustituto (prevalente) de la solución tradicional de base de datos SQL
- Como solución OLTP con soporte para OLAP
Nota: Para facilitar la comparación, este artículo compara Cloud Spanner con las variantes de MySQL de las familias de soluciones GCP Cloud SQL y Amazon AWS RDS.
Uso de Cloud Spanner como sustituto de una solución tradicional de base de datos SQL
En un entorno de bases de datos tradicionales, cuando el tiempo de respuesta a las consultas de la base de datos se acerca o incluso supera los umbrales predefinidos de la aplicación (principalmente debido al aumento del número de usuarios y/o consultas), existen varias formas de reducir el tiempo de respuesta a niveles aceptables. Sin embargo, la mayoría de estas soluciones implican intervención manual.
Por ejemplo, el primer paso que hay que tomar es revisar los diferentes parámetros de la base de datos relacionados con el rendimiento y ajustarlos para que se adapten mejor a los patrones de uso de las aplicaciones. Si esto no es suficiente, se puede optar por escalar la base de datos de forma vertical u horizontal.
La escalabilidad vertical de la aplicación implica actualizar la instancia del servidor, generalmente agregando más procesadores/núcleos, mayor memoria RAM, almacenamiento más rápido, etc. Agregar más recursos de hardware conduce a un aumento en el rendimiento de la base de datos, medido principalmente en transacciones por segundo y en la latencia de transacciones para sistemas OLTP. Los sistemas de bases de datos relacionales (que utilizan un enfoque multihilo), como MySQL, escalan bien de forma vertical.
Este enfoque tiene varias desventajas, siendo la más obvia el tamaño máximo del servidor en el mercado. Una vez que se alcanza el límite de la instancia más grande del servidor, solo queda una opción: la escalabilidad horizontal.
La escalabilidad horizontal es un enfoque en el que se agregan más servidores al clúster, idealmente aumentando linealmente el rendimiento con la adición de más servidores. La mayoría de bases de datos de los sistemas de bases de datos escalan mal de forma horizontal o no escalan en absoluto. Por ejemplo, MySQL puede escalar horizontalmente para operaciones de lectura, agregando lectores esclavos, pero no puede escalar horizontalmente para operaciones de escritura.
Por otro lado, debido a su naturaleza, Cloud Spanner puede escalar horizontalmente con facilidad y mínima intervención.
Base de datos completamente funcional DBaaS debe evaluarse desde diferentes perspectivas. Como base, tomamos la base de datos en la nube más popular: para Google, GCP Cloud SQL y para Amazon, AWS RDS. En nuestra evaluación, nos centramos en las siguientes categorías:
- Comparación de características: extensión SQL, DDL, DML; bibliotecas de conexión/conectores, soporte para transacciones, etc.
- Soporte para desarrollo: facilidad de desarrollo y prueba.
- Soporte de administración: gestión de instancias, como escalado hacia arriba/abajo y actualización de instancias; SLA, copias de seguridad y recuperación; seguridad/control de acceso.
Uso de Cloud Spanner como solución OLTP con soporte OLAP
Aunque Google no afirma explícitamente que Cloud Spanner esté diseñado para procesamiento analítico, comparte algunos atributos con otros mecanismos como Apache Impala & Kudu y YugaByte, que están destinados a cargas de trabajo OLAP.
Incluso si hubiera solo una pequeña probabilidad de que Cloud Spanner incluyera un motor escalable horizontalmente coherente HTAP (procesamiento transaccional/analítico híbrido) con un conjunto de funciones OLAP (más o menos) utilizables, creemos que eso merecería nuestra atención.
Teniendo esto en cuenta, hemos revisado las siguientes categorías:
- Carga de datos, índices y soporte de particionamiento
- Rendimiento de consultas y DML
2. Cloud Spanner en pocas palabras
Google Spanner es un sistema de gestión de bases de datos relacionales (RDBMS) en clúster que Google utiliza para varios de sus propios servicios. Google lo hizo accesible para los usuarios de Google Cloud Platform a principios de 2017.
Aquí hay algunos de los atributos de Cloud Spanner:
- Clúster RDBMS escalable altamente coherente: utiliza sincronización de hardware para garantizar la coherencia de los datos.
- Soporte para transacciones intertablas: las transacciones pueden abarcar varias tablas, no limitándose a una sola tabla (a diferencia de Apache HBase o Apache Kudu).
- Tablas basadas en clave primaria: todas las tablas deben tener una clave primaria (PK) declarada, que puede estar compuesta por varias columnas de la tabla. Los datos tabulares se almacenan en orden PK, lo que los hace muy eficientes y rápidos para la búsqueda por PK. Al igual que otros sistemas basados en PK, la implementación debe modelarse teniendo en cuenta los casos de uso previamente planificados para lograr .
- Tablas alternadas: las tablas pueden tener dependencias físicas entre sí. Las filas de la tabla hija pueden estar relacionadas con las filas de la tabla padre. Este enfoque acelera la búsqueda de relaciones que pueden definirse en la etapa de modelado de datos, por ejemplo, al agrupar clientes y sus facturas.
- Índices: Cloud Spanner soporta índices secundarios. Un índice consiste en columnas indexadas y todas las columnas de la clave primaria. Si se desea, el índice también puede contener otras columnas no indexadas. Un índice puede superponerse a la tabla padre para acelerar las consultas. Se aplican varias restricciones a los índices, como el número máximo de columnas adicionales que se pueden almacenar en el índice. Además, las consultas a través de índices pueden no ser tan directas como en otros DBMS.
«Cloud Spanner elige el índice automáticamente solo en raras ocasiones. En particular, Cloud Spanner no selecciona un índice secundario automáticamente si la consulta solicita columnas que no se almacenan en ».
- Acuerdo de nivel de servicio (SLA): despliegue en una región con SLA del 99,99%; despliegues multirregionales con SLA del 99,999%. Aunque el propio acuerdo de nivel de servicio es solo un acuerdo, y no ninguna garantía, creo que los empleados de Google tienen datos precisos para hacer una afirmación tan seria. (Para referencia, el 99,999% significa 26,3 segundos de indisponibilidad del servicio al mes.)
- Más:
Nota: El proyecto Apache Tephra añade soporte ampliado para transacciones en Apache HBase (también ahora implementado en Apache Phoenix como versión beta).
3. Nuestra evaluación
Así que todos hemos leído las declaraciones de Google sobre las ventajas de Cloud Spanner: escalabilidad horizontal prácticamente ilimitada manteniendo alta consistencia y un SLA muy alto. Aunque estos requisitos son extremadamente difíciles de alcanzar, nuestro objetivo no era refutarlos. En su lugar, centrémonos en otras cosas que preocupan a la mayoría de los usuarios de bases de datos: la equidad y la facilidad de uso.
Hemos evaluado Cloud Spanner como un reemplazo de Sharded MySQL.
Google Cloud SQL y Amazon AWS RDS, las dos bases de datos OLTP más populares en el mercado de la nube, cuentan con un conjunto de funciones muy amplio. Sin embargo, para escalar estas bases de datos más allá del tamaño de un solo nodo, es necesario realizar la fragmentación de aplicaciones. Este enfoque añade complejidad tanto a las aplicaciones como a la administración. Hemos examinado cómo Spanner se integra en el escenario de combinar múltiples segmentos en una sola instancia y qué funciones (si las hay) podrían tener que sacrificarse.
¿Soporte para SQL, DML y DDL, así como conector y bibliotecas?
Primero, al iniciar con cualquier base de datos, es necesario crear un modelo de datos. Si piensas que puedes conectar JDBC Spanner a tu herramienta SQL favorita, descubrirás que puedes consultar tus datos con ella, pero no puedes usarla para crear tablas o realizar cambios (DDL) o cualquier operación de inserción/actualización/eliminación (DML). El JDBC oficial de Google no admite ninguno de los dos.
«Actualmente, los controladores no admiten operadores DML o DDL».
Documentación de Spanner
La situación con la consola de GCP no es mejor: solo puedes enviar consultas SELECT. Afortunadamente, hay un controlador JDBC con soporte para DML y DDL de la comunidad, que incluye transacciones . Aunque este controlador es extremadamente útil, la falta de un controlador JDBC propio de Google es sorprendente. Afortunadamente, Google ofrece un soporte bastante amplio para bibliotecas de clientes (basadas en gRPC): C#, Go, Java, node.js, PHP, Python y Ruby.
La obligación casi inevitable de usar APIs personalizadas de Cloud Spanner (debido a la falta de DDL y DML en JDBC) lleva a algunas limitaciones para las áreas de código relacionadas, como grupos de conexiones o marcos de vinculación de bases de datos (por ejemplo, Spring MVC). En general, al usar JDBC puedes elegir libremente tu grupo de conexiones favorito (por ejemplo, HikariCP, DBCP, C3PO, etc.), que ha sido probado y funciona bien. En el caso de las APIs personalizadas de Spanner, debemos confiar en los marcos/grupos de vinculación/sesiones que hemos creado nosotros mismos.
La construcción orientada a la clave primaria (PK) permite a Cloud Spanner ser muy rápido al acceder a los datos a través de la PK, pero también provoca algunos problemas con las consultas.
- No puede actualizar el valor de la clave principal; primero debe eliminar el registro con la clave principal original y volver a insertarlo con el nuevo valor. (Esto es similar a otras bases de datos / mecanismos de almacenamiento orientados a claves).
- Cualquier operador UPDATE y DELETE debe especificar la clave principal en WHERE, por lo tanto, no puede haber operadores DELETE vacíos; siempre debe haber una subconsulta, por ejemplo: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Falta la opción de autoincremento o algo similar que establezca una secuencia para el campo de clave principal. Para que esto funcione, el valor correspondiente debe ser creado del lado de la aplicación.
¿Índices secundarios?
Google Cloud Spanner tiene soporte integrado para índices secundarios. Esta es una característica muy agradable que no siempre está presente en otras tecnologías. Apache Kudu actualmente no admite índices secundarios en absoluto, y Apache HBase no soporta índices directamente, pero puede agregarles a través de Apache Phoenix.
Los índices en Kudu y HBase se pueden modelar como una tabla separada con diferentes combinaciones de claves primarias, pero la atomicidad de las operaciones realizadas con la tabla principal y las tablas de índices relacionadas debe cumplirse a nivel de aplicación y no es trivial en una implementación correcta.
Como se mencionó en la revisión de Cloud Spanner, sus índices pueden diferir de los índices MySQL. Por lo tanto, se debe tener especial cuidado al construir consultas y perfiles para garantizar que se utilice el índice adecuado donde sea necesario.
¿Vistas?
Un objeto muy popular y útil en la base de datos son las vistas. Pueden ser útiles para una gran cantidad de casos de uso; mis dos favoritos son el nivel de abstracción lógica y el nivel de seguridad. Desafortunadamente, Cloud Spanner NO admite vistas. Sin embargo, esto solo nos limita parcialmente, ya que para los permisos de acceso no hay detalles a nivel de columna, donde las vistas pueden ser una solución aceptable.
En la documentación de Cloud Spanner, en la sección que detalla las cuotas y limitaciones (), hay una en particular que puede ser problemática para algunas aplicaciones: Cloud Spanner tiene un límite predeterminado de un máximo de 100 bases de datos por instancia. Obviamente, esto puede ser un gran obstáculo para una base de datos que está diseñada para escalar a más de 100 bases de datos. Afortunadamente, después de hablar con nuestro representante técnico de Google, descubrimos que este límite puede aumentarse prácticamente a cualquier valor a través del servicio de atención al cliente de Google.
¿Soporte para el desarrollo?
Cloud Spanner ofrece un soporte bastante decente para lenguajes de programación que trabajan con su API. Las bibliotecas oficialmente soportadas están en C#, Go, Java, node.js, PHP, Python y Ruby. La documentación es bastante detallada, pero, como ocurre con otras tecnologías de vanguardia, la comunidad es bastante pequeña en comparación con las tecnologías de bases de datos más populares, lo que puede llevar a un aumento en el tiempo dedicado a resolver casos de uso o problemas menos comunes.
¿Y qué hay del soporte para el desarrollo local?
No encontramos una manera de crear una instancia de Cloud Spanner en un entorno local. Lo más cercano que conseguimos fue una imagen de Docker. , que en principio se parece, pero en la práctica es bastante diferente. Por ejemplo, CockroachDB puede usar PostgreSQL JDBC. Dado que el entorno de desarrollo debe ser lo más parecido posible al entorno de producción, Cloud Spanner no es ideal, ya que se debe depender de una instancia completa de Spanner. Para economizar costos, puede elegir una instancia de una sola región.
¿Soporte de administración?
Crear una instancia de Cloud Spanner es muy simple. Solo necesitas elegir entre crear una instancia multirregional o de una sola región, especificar la(s) región(es) y el número de nodos. En menos de un minuto, la instancia estará en funcionamiento y lista para usar.
Varias métricas básicas están disponibles directamente en la página de Spanner en la consola de Google. Vistas más detalladas están disponibles a través de Stackdriver, donde también puedes establecer umbrales para las métricas y políticas de alertas.
¿Acceso a los recursos?
MySQL ofrece configuraciones de permisos/roles de usuario amplias y muy detalladas. Es fácil configurar el acceso a una tabla específica o incluso a solo un subconjunto de sus columnas. Cloud Spanner utiliza la herramienta de Google Identity & Access Management (IAM), que permite establecer políticas y permisos solo a un nivel muy alto. La opción más detallada es el permiso a nivel de base de datos, que no se adapta a la mayoría de los casos de producción. Esta limitación te obliga a añadir medidas de seguridad adicionales en tu código, infraestructura o ambos para prevenir el uso no autorizado de los recursos de Spanner.
¿Copias de seguridad?
Hablando en términos simples, no existen copias de seguridad en Cloud Spanner. Si bien los altos requisitos de SLA de Google pueden garantizar que no pierdas datos debido a fallos de hardware o de la base de datos, no protegen contra errores humanos, defectos de aplicaciones, etc. Todos conocemos la regla: alta disponibilidad no reemplaza una estrategia de copia de seguridad razonable. Hasta ahora, la única forma de realizar copias de seguridad de datos es mediante la transmisión programática de estos desde la base de datos a un entorno de almacenamiento separado.
¿Rendimiento de consultas?
Para cargar datos y probar consultas utilizamos el Yahoo! Cloud Serving Benchmark. En la tabla a continuación se presenta la carga de trabajo B YCSB con una relación de lectura del 95% y de escritura del 5%.
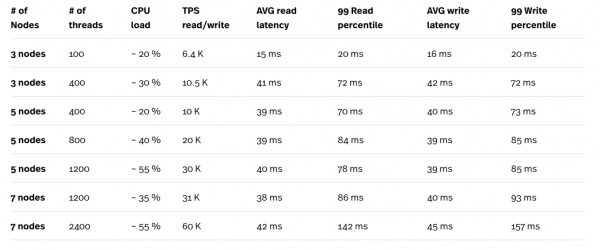
* La prueba de carga se realizó en un motor computacional (CE) n1-standard-32 (32 vCPU, 120 GB de memoria), y el instancia de prueba nunca fue un cuello de botella en las pruebas.
** El número máximo de hilos en una instancia YCSB es de 400. En total, se necesitaron ejecutar seis instancias paralelas de pruebas YCSB para alcanzar un total de 2400 hilos.
Al observar los resultados de las pruebas, en particular la combinación de carga del procesador y TPS, vemos claramente que Cloud Spanner se escala bastante bien. La alta carga generada por una gran cantidad de hilos es compensada por un mayor número de nodos en el clúster de Cloud Spanner. Aunque la latencia parece bastante alta, especialmente al trabajar con 2400 hilos, puede ser necesario volver a realizar pruebas con 6 instancias más pequeñas del motor de cómputo para obtener cifras más precisas. Cada instancia ejecutará una prueba YCSB en lugar de una gran instancia CE con 6 pruebas paralelas. De esta manera, será más fácil distinguir entre las latencias de las consultas de Cloud Spanner y las latencias añadidas por la conexión de red entre Cloud Spanner y la instancia CE donde se realizan las pruebas.
¿Cómo se desempeña Cloud Spanner como OLAP?
¿Particionamiento?
Dividir datos en segmentos físicamente y/o lógicamente independientes, llamados particiones, es un concepto muy popular en la mayoría de los mecanismos OLAP. Las particiones pueden mejorar significativamente el rendimiento de las consultas y la mantenibilidad de la base de datos. Profundizar en las particiones sería tema de un artículo (artículos) separado, así que simplemente mencionemos la importancia de tener un esquema de particionamiento y subtipo de particionamiento. La capacidad de dividir los datos en particiones y aún más en subparticiones es clave para el rendimiento de las consultas analíticas.
Cloud Spanner no admite particiones como tales. Divide los datos internamente en lo que se llama split-s basados en rangos de claves primarias. La división se realiza automáticamente para equilibrar la carga en el clúster de Cloud Spanner. Una función muy conveniente de Cloud Spanner es la división de la carga base de la tabla principal (la tabla que no se alterna con otra). Spanner determina automáticamente si contiene split datos que se leen más a menudo que los datos en otras split-s, y puede tomar una decisión sobre una separación adicional. Así, pueden estar involucrados más nodos en la consulta, lo que también aumenta eficazmente el rendimiento.
¿Carga de datos?
El método Cloud Spanner para grandes volúmenes de datos es el mismo que en una carga convencional. Para lograr el máximo rendimiento, debe seguir algunas recomendaciones, que incluyen:
- Ordene sus datos por la clave primaria.
- Divídalos en 10*nodos secciones separadas.
- Cree un conjunto de tareas que carguen datos en paralelo.
En esta carga de datos se utilizan todos los nodos de Cloud Spanner.
Utilizamos la carga de trabajo A YCSB para generar un conjunto de datos de 10M de filas.
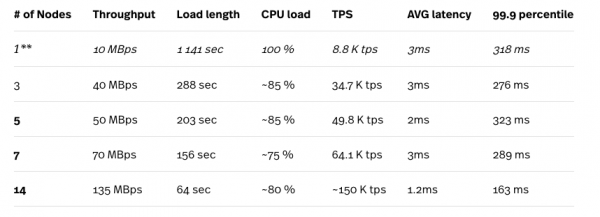
* La prueba de carga se realizó en el motor de computación n1-standard-32 (32 vCPU, 120 GB de RAM), y la instancia de prueba nunca fue un cuello de botella en las pruebas.
** La configuración de 1 nodo no se recomienda para ninguna carga de producción.
Como se mencionó anteriormente, Cloud Spanner maneja automáticamente los splits según su carga, por lo que los resultados mejoran después de varias repeticiones consecutivas de la prueba. Los resultados presentados aquí son los mejores que hemos obtenido. Al observar los números anteriores, podemos ver cómo Cloud Spanner se escala (bien) con el aumento del número de nodos en el clúster. Los números destacados representan latencias promedio increíblemente bajas que contrastan con los resultados de cargas de trabajo mixtas (95% de lectura y 5% de escritura), como se describe en la sección anterior.
¿Escalabilidad?
Aumentar y reducir el número de nodos en Cloud Spanner es una tarea que se realiza con un solo clic. Si desea cargar datos rápidamente, puede considerar aumentar la instancia al máximo (en nuestro caso, fueron 25 nodos en la región US-EAST), y luego reducir el número de nodos adecuado para su carga habitual, una vez que todos los datos estén en la base de datos, teniendo en cuenta el límite de 2 TB/nodo.
Nos recordaron este límite incluso con una base de datos mucho más pequeña. Después de varias ejecuciones de pruebas de carga, nuestra base de datos tenía un tamaño de alrededor de 155 GB, y al reducir a una instancia de 1 nodo, recibimos el siguiente error:
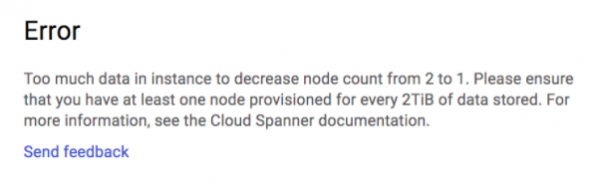
Pudimos reducir la escala de 25 a 2 instancias, pero nos quedamos atascados en dos nodos.
La expansión y contracción del número de nodos en un clúster de Cloud Spanner se puede automatizar mediante la API REST. Esto puede ser especialmente útil para reducir la carga del sistema durante las horas pico.
¿Rendimiento de consultas OLAP?
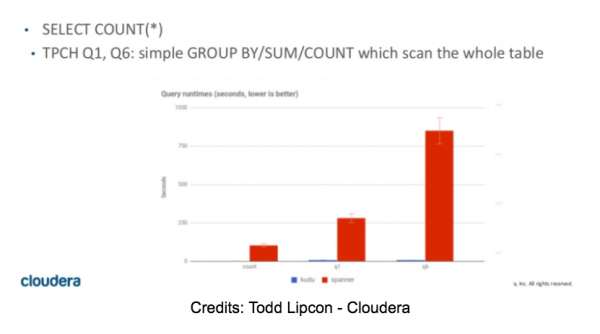
Inicialmente, planeábamos dedicar un tiempo considerable a nuestra evaluación de Spanner en esta parte. Después de varias selecciones COUNT, nos dimos cuenta de inmediato que la prueba sería breve y que Spanner NO sería adecuado como motor OLAP. Independientemente del número de nodos en el clúster, la simple selección del número de filas en una tabla de 10 millones de filas tardó entre 55 y 60 segundos. Además, cualquier consulta que requiriese más memoria para almacenar resultados intermedios terminó con un error OOM.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M valores distintos) -> SpoolingHashAggregateIterator se quedó sin memoria durante la nueva fila.
Algunos números para las consultas TPC-H se pueden encontrar en el artículo de Todd Lipcon , diapositivas 42 y 43. Estos números son consistentes con nuestros propios resultados (lamentablemente).
4. Nuestras conclusiones
Dado el estado actual de las funciones de Cloud Spanner, es difícil imaginarlo como un simple reemplazo de soluciones OLTP existentes, especialmente cuando sus necesidades superen sus capacidades. Sería necesario dedicar una cantidad significativa de tiempo para construir una solución que tenga en cuenta las deficiencias de Cloud Spanner.
Cuando comenzamos a evaluar Cloud Spanner, esperábamos que sus características de gestión estarían a la par o, al menos, no tan lejos de otras soluciones de Google SQL. Pero nos sorprendió la completa ausencia de copias de seguridad y el control de acceso muy limitado a los recursos. Sin mencionar la falta de vistas, la ausencia de un entorno de desarrollo local, secuencias no soportadas, JDBC sin soporte para DML y DDL, y así sucesivamente.
Entonces, ¿a dónde debe acudir alguien que necesita escalar una base de datos transaccional? Parece que en el mercado aún no hay una solución única que se adapte a todos los casos de uso. Existen numerosas soluciones de código cerrado y abierto (algunas de las cuales se mencionan en este artículo), cada una con sus fortalezas y debilidades, pero ninguna de ellas ofrece SaaS con SLA del 99,999% y un alto nivel de consistencia. Si un alto nivel de SLA es su principal objetivo y no tiene intención de crear su propia solución para múltiples entornos en la nube, Cloud Spanner podría ser la solución que está buscando. Pero debe conocer todas sus limitaciones.
A modo de justicia, cabe mencionar que Cloud Spanner fue lanzado al público únicamente en la primavera de 2017, por lo que es razonable esperar que algunas de sus deficiencias actuales eventualmente desaparezcan (esperemos), y cuando eso ocurra, podría cambiar las reglas del juego. Después de todo, Cloud Spanner no es solo un proyecto externo para Google. Google lo utiliza como base para otros productos de Google. Y cuando Google recientemente reemplazó Megastore en Google Cloud Storage por Cloud Spanner, esto permitió que Google Cloud Storage se volviera estrictamente coherente para listas de objetos a nivel mundial (lo cual aún no se aplica a ).
Así que aún hay esperanza... seguimos optimistas.
Eso es todo. Al igual que el autor del artículo, también seguimos teniendo esperanzas, ¿qué opinas tú al respecto? Escríbenos en los comentarios.
Invitamos a todos a asistir a nuestro donde explicaremos en detalle sobre el curso de OTUS.
Fuente: habr.com
