

Las ideas y reuniones sobre qué otros procesos se pueden automatizar surgen diariamente en negocios de diferentes tamaños. Pero además del tiempo que puede llevar crear un modelo, también es necesario dedicar tiempo a su evaluación y a verificar que el resultado obtenido no sea aleatorio. Después de implementar, cualquier modelo debe ser monitoreado y revisado periódicamente.
Y estas son todas etapas que deben atravesar las empresas, independientemente de su tamaño. Si hablamos de la magnitud y la herencia de Sberbank, la cantidad de configuraciones detalladas aumenta considerablemente. Para finales de 2019, ya se utilizaban más de 2000 modelos en Sber. No es suficiente con desarrollar un modelo, es necesario integrarse con sistemas industriales, crear vitrinas de datos para la construcción de modelos y asegurar el control de su funcionamiento en el clúster.
Nuestro equipo está desarrollando la plataforma Sber.DS. Permite resolver problemas de aprendizaje automático, acelera el proceso de verificación de hipótesis, simplifica básicamente el proceso de desarrollo y validación de modelos, y también controla el resultado del trabajo del modelo en PROM.
Para no decepcionar tus expectativas, quiero decir de antemano que esta publicación es introductoria, y a continuación se hablará sobre lo que hay en realidad bajo el capó de la plataforma Sber.DS. La historia sobre el ciclo de vida del modelo, desde su creación hasta su implementación, la contaremos por separado.
Sber.DS consta de varios componentes, siendo los clave la biblioteca, el sistema de desarrollo y el sistema de ejecución de modelos.
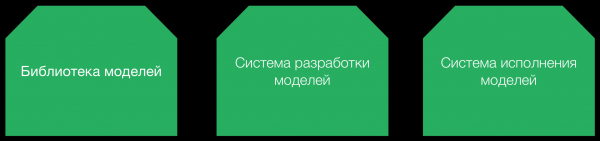
La biblioteca controla el ciclo de vida del modelo desde el momento en que surge la idea de desarrollarlo hasta su implementación en PROM, su monitoreo y su retiro de servicio. Muchas de las capacidades de la biblioteca están dictadas por las normas del regulador, como la presentación de informes y el almacenamiento de conjuntos de datos de entrenamiento y validación. De hecho, es un registro de todos nuestros modelos.
El sistema de desarrollo está destinado a la creación visual de modelos y métodos de validación. Los modelos desarrollados pasan por una validación inicial y se envían al sistema de ejecución para cumplir con sus funciones comerciales. Además, en el sistema de ejecución, el modelo puede ser monitoreado con el fin de ejecutar periódicamente métodos de validación para controlar su rendimiento.
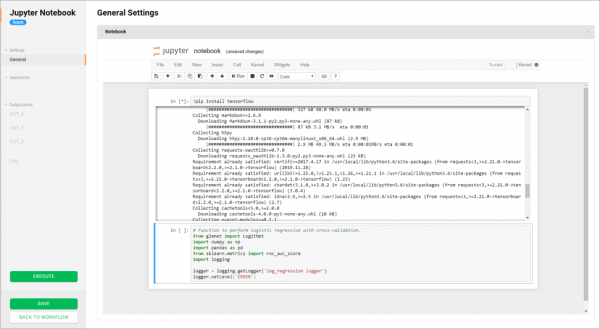
El sistema tiene varios tipos de nodos. Algunos están destinados a conectarse a diversas fuentes de datos, otros son para transformar los datos originales y enriquecerlos (anotación). Hay muchos nodos para construir diferentes modelos y nodos para su validación. El desarrollador puede cargar datos de cualquier origen, transformarlos, filtrarlos, visualizar datos intermedios y dividirlos en partes.
Además, la plataforma contiene módulos ya listos que se pueden arrastrar a la zona de proyectos. Todas las acciones se llevan a cabo utilizando una interfaz visual. De hecho, se puede resolver un problema sin escribir una sola línea de código.
Si las capacidades integradas no son suficientes, el sistema ofrece la posibilidad de crear rápidamente sus propios módulos. Hemos implementado un modo de desarrollo integrado basado en para quienes crean nuevos módulos desde cero.
La arquitectura de Sber.DS está construida sobre microservicios. Existen muchas opiniones sobre qué son los microservicios. Algunos piensan que es suficiente dividir el código monolítico en partes, pero aún así acceden a la misma base de datos. Para nosotros, un microservicio debe comunicarse con otro microservicio solo a través de REST API. No hay atajos para acceder directamente a la base de datos.
Nos esforzamos por que los servicios no sean muy grandes y pesados: una instancia no debe consumir más de 4-8 gigabytes de memoria RAM y debe permitir el escalado horizontal de solicitudes mediante el lanzamiento de nuevas instancias. Cada servicio se comunica con los demás solo a través de REST API (). El equipo responsable del servicio debe mantener la compatibilidad con versiones anteriores de la API hasta el último cliente que lo usa.
El núcleo de la aplicación está escrito en Java utilizando Spring Framework. La solución fue diseñada inicialmente para un rápido despliegue en la infraestructura en la nube, por lo que la aplicación está construida utilizando un sistema de contenerización (). La plataforma está en constante desarrollo, tanto en el aumento de la funcionalidad comercial (se agregan nuevos conectores, AutoML), como en términos de eficiencia tecnológica.
Una de las características de nuestra plataforma es que podemos ejecutar código desarrollado en una interfaz visual en cualquier sistema de ejecución de modelos de Sberbank. Actualmente hay dos: uno en Hadoop y otro en OpenShift (Docker). No nos detenemos aquí y estamos creando módulos de integración para ejecutar código en cualquier infraestructura, incluyendo on-premise y en la nube. En cuanto a las posibilidades de integración efectiva en el ecosistema de Sberbank, también planeamos soportar el trabajo con los entornos de ejecución existentes. A largo plazo, la solución puede integrarse de forma flexible "listo para usar" en cualquier paisaje organizativo.
Aquellos que han intentado mantener una solución que ejecuta Python en Hadoop en PROM saben que no basta con preparar y entregar el entorno de usuario de Python en cada nodo de datos. Una gran cantidad de bibliotecas C/C++ para aprendizaje automático que utilizan módulos de Python no te permitirán descansar tranquilo. No se debe olvidar actualizar los paquetes al agregar nuevas bibliotecas o servidores, manteniendo la compatibilidad con el código de modelos ya implementado.
Hay varios enfoques para lograr esto. Por ejemplo, preparar con antelación varias bibliotecas de uso común y implementarlas en PROM. En la distribución de Hadoop de Cloudera, normalmente se utiliza . También ahora hay una posibilidad de ejecutar contenedores en Hadoop. En algunos casos simples, se puede entregar el código junto con el paquete python.eggs .
Linux namespace , se puede limitar, por ejemplo, el acceso a la red y al disco local, lo que reduce significativamente las capacidades del código malicioso. Las áreas de datos de cada departamento están protegidas y son accesibles solo para los propietarios de esos datos. La plataforma garantiza que los datos de una área solo puedan pasar a otra área a través de un proceso de publicación de datos con control en todas las etapas desde el acceso a las fuentes hasta la llegada de los datos a la vitrina de destino.
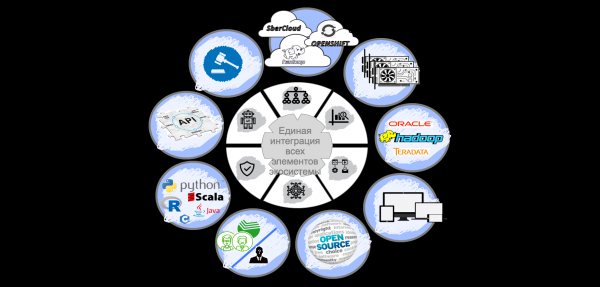
Este año planeamos completar el lanzamiento del MVP de modelos escritos en Python/R/Java sobre Hadoop. Nos hemos fijado un objetivo ambicioso de aprender a ejecutar cualquier entorno personalizado en Hadoop, para no limitar a los usuarios de nuestra plataforma.
Además, como resultó, muchos especialistas en DS conocen bien las matemáticas y la estadística, crean modelos geniales, pero no tienen mucha experiencia en transformaciones de grandes datos, y necesitan la ayuda de nuestros ingenieros de datos para preparar conjuntos de datos de entrenamiento. Decidimos ayudar a nuestros colegas y crear módulos convenientes para la transformación estándar y preparación de características para modelos en el motor Spark. Esto permitirá dedicar más tiempo al desarrollo de modelos y no tener que esperar a que los ingenieros de datos preparen un nuevo conjunto de datos.
En nuestro equipo hay personas con conocimientos en diversas áreas: Linux y DevOps, Hadoop y Spark, Java y Spring, Scala y Akka, OpenShift y Kubernetes. La próxima vez hablaremos sobre la biblioteca de modelos, cómo un modelo pasa por el ciclo de vida dentro de la empresa y cómo se lleva a cabo la validación y la implementación.
Fuente: habr.com
