

¡Nunca había pasado, y aquí estamos de nuevo!
En nuestro nuevo proyecto decidimos usar Liquibase desde el principio para evitar problemas en el futuro. Resulta que no todos los miembros jóvenes del equipo saben cómo usarlo correctamente. Organicé un taller interno que luego decidí convertir en un artículo.
El artículo incluye consejos útiles y la descripción de las tres trampas más evidentes en las que se puede caer al trabajar con herramientas de migración de bases de datos relacionales, en particular Liquibase. Está dirigido a desarrolladores Java de nivel Junior y Middle; para desarrolladores más experimentados puede ser interesante para estructurar y repasar lo que probablemente ya conocen.
Liquibase y Flyway son las principales tecnologías competidoras para el control de versiones de estructuras relacionales en el mundo de Java. La primera es completamente gratuita, y en la práctica, suele ser la elegida para su uso, por lo que Liquibase se convierte en la protagonista de esta publicación. Sin embargo, algunas de las prácticas descritas pueden ser universales, dependiendo de la arquitectura de tu aplicación.
Las migraciones de estructuras relacionales son una forma surgida por necesidad para lidiar con la rigidez de los almacenes de datos relacionales. En la era de la moda de la programación orientada a objetos, trabajar con bases de datos implicaba que describíamos un esquema una vez y no lo íbamos a tocar más. Pero la realidad es siempre cambiante, y los cambios en la estructura de las tablas son bastante frecuentes. Naturalmente, el proceso puede ser doloroso y desagradable.
No profundizaré en la descripción de la tecnología ni en las instrucciones para añadir la biblioteca a tu proyecto; ya se han escrito suficientes artículos sobre este tema:
Además, ya había un excelente artículo sobre consejos útiles:
Consejos
Quiero compartir mis consejos y comentarios que nacieron a través del sudor, la sangre y el dolor de resolver problemas de migración.
1. Antes de comenzar, es recomendable revisar la sección de mejores prácticas en Liquibase
se describen cosas simples pero muy importantes, sin las cuales el uso de la biblioteca puede complicarle la vida. Por ejemplo, un enfoque no estructurado para gestionar los changsets con el tiempo conducirá a confusiones y migraciones rotas. Si los cambios en la estructura de la base de datos y la lógica de los servicios que dependen unos de otros no se implementan simultáneamente, hay una gran probabilidad de que esto conduzca a pruebas fallidas o un entorno roto. Además, las recomendaciones para el uso de Liquibase en el sitio oficial incluyen un apartado sobre el desarrollo y verificación de scripts de rollback junto con los scripts principales de migración. Y en el artículo hay ejemplos de código relacionados con migraciones y el mecanismo de rollback.
2. Si ha comenzado a utilizar herramientas de migración, no permita correcciones manuales en la estructura de la base de datos.
Como se dice: «Una vez Persil, siempre Persil». Si la base de datos de su aplicación comenzó a gestionarse mediante Liquibase, cualquier cambio manual llevará inmediatamente a un estado inconsistente, y el nivel de confianza en los changsets será igual a cero. Los riesgos potenciales son varias horas gastadas en recuperar la base de datos, y en el peor de los casos, un servidor arruinado. Si en su equipo hay un DBA arquitecto de la «vieja guardia», explíquele con paciencia y reflexión cómo las cosas se complicarán si edita la base a su antojo desde un SQL Developer hipotético.
3. Si el changset ya ha sido subido al repositorio, evite editarlo.
Si otro desarrollador hizo un pull y aplicó un changset que luego será editado, seguramente recordará su nombre con cariño cuando obtenga un error al iniciar la aplicación. Si la edición del changset se filtra de alguna manera en el desarrollo, tendrá que recurrir a una peligrosa serie de hotfixes. La esencia del problema radica en la validación de los cambios por medio de la suma de verificación — el mecanismo principal de Liquibase. Al editar el código del changset, cambia la suma de verificación. La edición de changsets solo es posible cuando existe la capacidad de desplegar toda la base desde cero sin pérdida de datos. En tal caso, el refactorización del código SQL o XML puede, por el contrario, facilitar la vida y hacer que las migraciones sean más legibles. Un ejemplo podría ser la situación en la que, al inicio de la aplicación, el esquema inicial de la base de datos se acordó dentro del equipo.
4. Ten copias de seguridad comprobadas de bases de datos, si es posible
Aquí, creo que todo está claro. En caso de que la migración falle, se podrá revertir todo. Liquibase tiene una herramienta para deshacer cambios, pero los scripts de reversión los escribe el mismo desarrollador, y pueden haber problemas con ellos tan fácilmente como con los scripts del conjunto de cambios principal. Esto significa que es útil tener copias de seguridad en cualquier caso.
5. Utiliza copias de seguridad comprobadas de bases de datos en desarrollo, si es posible
Si esto no va en contra de los contratos y la privacidad, no hay datos personales en la base, y no pesa como dos soles, antes de aplicar la migración en los servidores en vivo se puede verificar cómo funcionará en la máquina del desarrollador y determinar casi el 100% de los problemas potenciales durante la migración.
6. Comunícate con otros desarrolladores en el equipo
En un proceso de desarrollo bien organizado, todos en el equipo saben qué está haciendo cada uno. En realidad, a menudo no es así, por lo que, si estás preparando cambios en la estructura de la base de datos dentro de tu tarea, sería deseable informar a todo el equipo sobre esto. Si alguien está haciendo cambios en paralelo, deberías organizarte cuidadosamente. Es importante comunicarte con los colegas también después de terminar el trabajo, no solo al inicio. Muchos problemas potenciales con los conjuntos de cambios pueden resolverse en la etapa de revisión de código.
7. ¡Piensa en lo que haces!
Puede parecer un consejo obvio, aplicable a cualquier situación. Sin embargo, muchos problemas podrían haberse evitado si el desarrollador analizara de nuevo lo que está haciendo y qué impacto podría tener. Trabajar con migraciones siempre requiere atención adicional y cuidado.
Trampas
Veamos ahora las trampas típicas en las que se puede caer si no se siguen los consejos anteriores, y ¿qué hacer al respecto?
Situación 1. Dos desarrolladores intentan agregar nuevos conjuntos de cambios al mismo tiempo
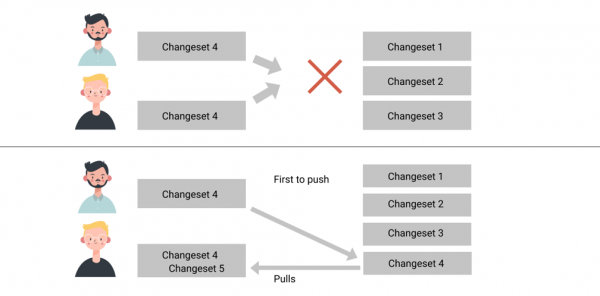
Vasya y Petya quieren crear el conjunto de cambios de la versión 4, sin saber el uno del otro. Han realizado cambios en la estructura de la base de datos y han lanzado una solicitud de extracción, con diferentes archivos de conjunto de cambios. A continuación, se propone el siguiente mecanismo de acción:
Cómo resolver
- De alguna manera, los colegas deben acordar en qué orden deben ir sus conjuntos de cambios, por ejemplo, el de Petya debería aplicarse primero.
- Alguien debe agregar el segundo a sí mismo y marcar el changeSet de Vasya con la versión 5. Esto se puede hacer a través de Cherry Pick o un merge cuidadoso.
- Después de los cambios, siempre se debe verificar la validez de las acciones realizadas.
En realidad, los mecanismos de Liquibase permitirán tener en el repositorio dos changeSets de la versión 4, por lo que se puede dejar todo como está. Es decir, tendrá simplemente dos cambios de la versión 4 con diferentes nombres. Con este enfoque, posteriormente se vuelve muy difícil orientarse en las versiones de la base de datos.
Además, Liquibase, como la casa de los hobbits, guarda muchos secretos. Uno de ellos es la clave validCheckSum, que apareció con la versión 1.7 y permite especificar un valor de hash válido para un changeSet determinado, independientemente de lo que esté almacenado en la base de datos. Documentación dice lo siguiente:
Agrega un checksum que se considera válido para este changeSet, independientemente de lo que esté almacenado en la base de datos. Se utiliza principalmente cuando necesita cambiar un changeSet y no desea que se genere errores en las bases de datos en las que ya se ha ejecutado (no se recomienda este procedimiento).
Sí, sí, este procedimiento no se recomienda. Pero a veces un poderoso mago blanco también domina técnicas oscuras.
Situación 2. Migración que depende de los datos.
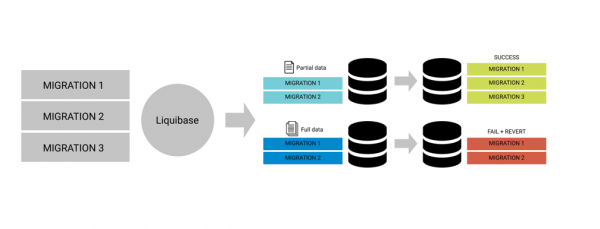
Supongamos que no tiene la oportunidad de utilizar copias de seguridad de bases de datos de servidores en vivo. Petya creó un changeSet, lo verificó localmente y, con total confianza en su verdad, hizo un pull request en dev. El líder del proyecto, por si acaso, preguntó si Petya lo había verificado, y luego lo fusionó. Pero el despliegue en el servidor de dev falló.
En realidad, esto es posible, y nadie está a salvo de ello. Esto ocurre cuando las modificaciones en la estructura de las tablas están de alguna manera vinculadas a datos específicos de la base de datos. Es evidente que si la base de datos de Petya solo está llena de datos de prueba, puede que no cubra todos los casos problemáticos. Por ejemplo, al eliminar una tabla, se descubre que hay registros en otras tablas mediante una clave foránea, relacionados con registros en la tabla eliminada. O al cambiar el tipo de columna, se descubren que no el 100% de los datos pueden convertirse al nuevo tipo.
Cómo resolver
- Escribir scripts especiales que se apliquen una sola vez junto con la migración y lleven los datos a su forma adecuada. Este es un enfoque general para resolver el problema de la migración de datos a nuevas estructuras ya después de aplicar las migraciones, aunque algo similar también puede aplicarse antes, en casos particulares. Por supuesto, este enfoque no siempre está disponible, ya que editar datos en servidores en vivo puede ser peligroso e incluso desastroso.
- Otro camino complicado es editar el changset existente. La dificultad radica en que todas las bases de datos en las que ya se ha aplicado en su forma actual tendrán que ser restauradas. Es bastante posible que todo el equipo backend se vea obligado a reinstalar la base de datos desde cero de manera local.
- Y el camino más universal es trasladar el problema de los datos al entorno del desarrollador, recreando la misma situación y añadiendo un nuevo changset que permita sortear el problema antes del que se había roto.

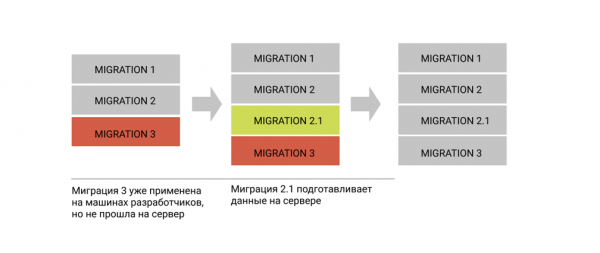
En general, cuanto más se asemeje la base de datos en cuanto a composición de datos a la base del servidor de producción, menor será la probabilidad de que los problemas con las migraciones se extiendan. Y, por supuesto, antes de enviar el changset al repositorio, vale la pena pensarlo dos veces: ¿no romperá nada?
Situación 3. Liquibase comienza a aplicarse ya después de salir a producción.
Supongamos que el líder de equipo pidió a Petya conectar Liquibase al proyecto, sin embargo, el proyecto ya está en producción y existe una estructura de base de datos ya existente.
Por lo tanto, el problema radica en que en cualquier nuevo servidor o máquina de desarrolladores, los datos de las tablas deben recrearse desde cero, y el entorno ya existente debe permanecer en un estado consistente, listo para aceptar nuevos changsets.
Cómo resolver
Aquí también hay varios caminos:
- El primero y más obvio es tener un script separado que deba aplicarse manualmente al inicializar un nuevo entorno.
- El segundo, menos obvio, es tener una migración de Liquibase que se encuentre en otro contexto de Liquibase y aplicarla. Más sobre el contexto de Liquibase se puede leer aquí: . En general, es un mecanismo interesante que puede aplicarse exitosamente, por ejemplo, para pruebas.
- El tercer camino consiste en varios pasos. Primero, se debe crear una migración para las tablas que ya existen. Luego, debe aplicarse en algún entorno y así se obtendrá su suma hash. El siguiente paso es inicializar las tablas vacías de Liquibase en nuestro servidor que no está vacío, y se puede agregar manualmente un registro en la tabla de historia de aplicación de cambios como si el cambio ya se hubiera aplicado con los cambios que ya existen en la base de datos. De esta manera, en el servidor ya existente, el conteo de la historia comenzará desde la versión 2, y todos los nuevos entornos se comportarán de manera idéntica.

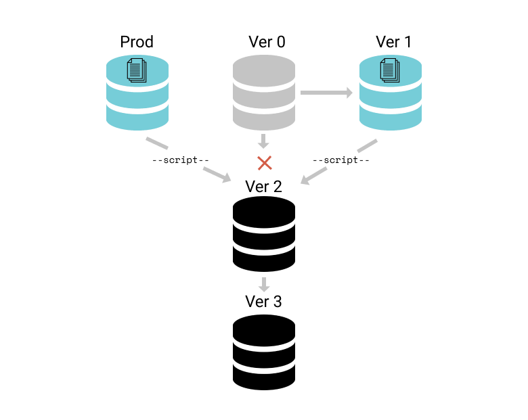
Situación 4. Las migraciones se vuelven enormes y no se logran ejecutar a tiempo.
Al inicio del desarrollo del servicio, generalmente, Liquibase se utiliza como una dependencia externa, y todas las migraciones se procesan al iniciar la aplicación. Sin embargo, con el tiempo, puede encontrarse con los siguientes casos:
- Las migraciones se vuelven enormes y tardan mucho tiempo en ejecutarse.
- Surge la necesidad de migrar en entornos distribuidos, por ejemplo, en varias instancias de servidores de bases de datos al mismo tiempo.
En este caso, la aplicación prolongada de migraciones provocará un time-out al iniciar la aplicación. Además, aplicar migraciones para cada instancia de aplicación por separado puede hacer que diferentes servidores queden en un estado fuera de sincronización.
Cómo resolver
En tales casos, su proyecto ya es grande, posiblemente incluso maduro, y Liquibase comienza a actuar como una herramienta externa independiente. La cuestión es que Liquibase, como biblioteca, se compila en un archivo jar, y puede funcionar tanto como una dependencia dentro del proyecto como de manera autónoma.
En modo autónomo, se puede delegar la aplicación de migraciones a su entorno CI/CD o a las fuertes manos de sus administradores de sistemas especializados en despliegue. Para esto necesitará la línea de comandos de Liquibase. . En este modo, existe la posibilidad de iniciar la aplicación ya después de que se hayan realizado todas las migraciones necesarias.
Salida
En realidad, puede haber muchas más trampas al trabajar con migraciones de base de datos, y muchas de ellas requieren un enfoque creativo. Es importante entender que si se utiliza correctamente la herramienta, se puede evitar la mayoría de estas trampas. Personalmente, me he enfrentado a todos los problemas mencionados en diferentes formas, y algunos de ellos fueron resultado de mis propios errores. Principalmente, esto sucede, por supuesto, por falta de atención, pero a veces – debido a una incapacidad criminal para utilizar la herramienta.
Fuente: habr.com
