

Me llamo Pavel Parkhomenko, soy desarrollador de ML. En este artículo, me gustaría hablar sobre el funcionamiento del servicio Yandex.Zen y compartir mejoras técnicas cuya implementación ha permitido aumentar la calidad de las recomendaciones. En la publicación, aprenderás cómo encontrar en cuestión de milisegundos los documentos más relevantes entre millones; cómo realizar una descomposición continua de una gran matriz (que consta de millones de columnas y decenas de millones de filas) para que los nuevos documentos obtengan su vector en cuestión de minutos; cómo reutilizar la descomposición de la matriz usuario-artículo para obtener una buena representación vectorial para videos.
Nuestra base de recomendaciones contiene millones de documentos de diferentes formatos: artículos de texto creados en nuestra plataforma y tomados de sitios externos, videos, narrativas y publicaciones breves. El desarrollo de un servicio como este implica numerosos desafíos técnicos. Algunos de ellos son:
- Dividir las tareas computacionales: realizar todas las operaciones pesadas de forma offline, y aplicar modelos de forma rápida en tiempo real, para responder en 100-200 ms.
- Registrar rápidamente las acciones del usuario. Para ello, es necesario que todos los eventos se envíen instantáneamente al recomendador y afecten los resultados de los modelos.
- Hacer que el feed se adapte rápidamente al comportamiento de los nuevos usuarios. Los recién llegados al sistema deben sentir que sus comentarios influyen en las recomendaciones.
- Entender rápidamente a quién recomendar un nuevo artículo.
- Reaccionar de manera ágil a la aparición constante de nuevo contenido. Decenas de miles de artículos se publican cada día, y muchos de ellos tienen una vida útil limitada (como las noticias). Esta es la diferencia con las películas, la música y otro contenido que es duradero y costoso de producir.
- Transferir conocimientos de un dominio a otro. Si en el sistema de recomendación hay modelos entrenados para artículos de texto y agregamos videos, se pueden reutilizar los modelos existentes para que el nuevo tipo de contenido sea mejor clasificado.
Voy a contar cómo abordamos estos desafíos.
Selección de candidatos
¿Cómo reducir en milisegundos la cantidad de documentos considerados en miles de veces, sin prácticamente perjudicar la calidad del ranking?
Supongamos que hemos entrenado muchos modelos de ML, generado características a partir de ellos y entrenado otro modelo que clasifica documentos para el usuario. Todo estaría bien, pero no se puede simplemente calcular todas las características para todos los documentos en tiempo real, si hay millones de estos documentos y las recomendaciones deben generarse en 100-200 ms. La tarea consiste en seleccionar de entre millones un subconjunto que será clasificado para el usuario. Este paso suele llamarse selección de candidatos. Se le presentan varios requisitos. Primero, la selección debe realizarse muy rápidamente, para que quede el mayor tiempo posible para el propio ranking. En segundo lugar, al reducir drásticamente la cantidad de documentos para clasificar, debemos conservar al máximo los documentos relevantes para el usuario.
Nuestro principio de selección de candidatos ha evolucionado, y en este momento hemos llegado a un esquema de múltiples etapas:
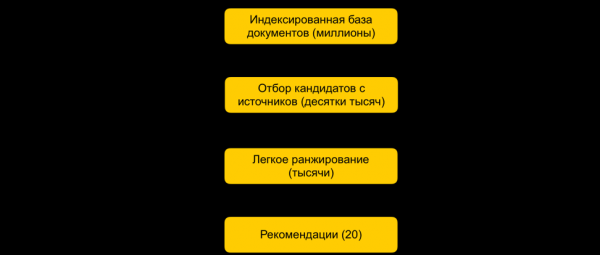
Primero, todos los documentos se dividen en grupos, y de cada grupo se eligen los documentos más populares. Los grupos pueden ser sitios web, temas, clústeres. Para cada usuario, se seleccionan los grupos más cercanos a su historial, y de ellos se sacan los mejores documentos. También utilizamos un índice kNN para encontrar los documentos más cercanos al usuario en tiempo real. Existen varios métodos para construir el índice kNN, y el que mejor nos ha funcionado es (gráficas de mundo pequeño jerárquicas navegables). Este es un modelo jerárquico que permite encontrar en milisegundos los N vectores más cercanos al usuario de una base de millones. Previamente, indexamos toda nuestra base de documentos fuera de línea. Dado que la búsqueda en el índice es bastante rápida, con varios embeddings potentes, se pueden crear varios índices (uno por cada embedding) y acceder a cada uno de ellos en tiempo real.
Tenemos decenas de miles de documentos para cada usuario. Aún así, sigue siendo mucho para contabilizar todas las características, así que en esta etapa aplicamos un ranking ligero: un modelo simplificado de ranking pesado con menos características. La tarea es predecir qué documentos estarán en el top de un modelo pesado. Los documentos con la mayor predicción se utilizarán en el modelo pesado, es decir, en la última etapa del ranking. Este enfoque permite reducir en decenas de milisegundos la base de documentos considerados para el usuario de millones a miles.
Paso ALS en tiempo de ejecución
¿Cómo tener en cuenta la retroalimentación del usuario inmediatamente después de hacer clic?
Un factor importante en las recomendaciones es el tiempo de respuesta a la retroalimentación del usuario. Esto es especialmente crucial para los nuevos usuarios: cuando una persona comienza a utilizar el sistema de recomendaciones, recibe un feed no personalizado de documentos diversos por temática. Tan pronto como hace su primer clic, es necesario tener en cuenta esto de inmediato y ajustarse a sus intereses. Si se calculan todos los factores fuera de línea, la rápida respuesta del sistema se vuelve imposible debido a la latencia. Por lo tanto, es necesario procesar las acciones del usuario en tiempo real. Para estos fines, utilizamos el paso ALS en tiempo de ejecución para construir una representación vectorial del usuario.
Supongamos que tenemos una representación vectorial para todos los documentos. Por ejemplo, podemos construir incrustaciones fuera de línea basándonos en el texto del artículo utilizando ELMo, BERT u otros modelos de aprendizaje automático. ¿Cómo se puede obtener una representación vectorial de los usuarios en este mismo espacio a partir de sus interacciones en el sistema?
Principio general de formación y descomposición de la matriz usuario-documentoSupongamos que tenemos m usuarios y n documentos. Para algunos usuarios, se conoce su relación con ciertos documentos. Entonces, esta información se puede representar en forma de una matriz m x n: las filas corresponden a los usuarios y las columnas a los documentos. Dado que la mayoría de los documentos no han sido vistos por el usuario, la mayor parte de las celdas de la matriz permanecerán vacías, mientras que otras estarán llenas. Para cada evento (me gusta, no me gusta, clic), hay un valor en la matriz, pero consideremos un modelo simplificado, en el que me gusta corresponde a 1 y no me gusta a -1.
Descomponemos la matriz en dos: P (m x d) y Q (d x n), donde d es la dimensión de la representación vectorial (generalmente un número pequeño). Entonces, a cada objeto le corresponde un vector de d dimensiones (al usuario le corresponde una fila en la matriz P, al documento le corresponde una columna en la matriz Q). Estos vectores serán los embeddings de los objetos correspondientes. Para predecir si a un usuario le gustará un documento, simplemente podemos multiplicar sus embeddings.
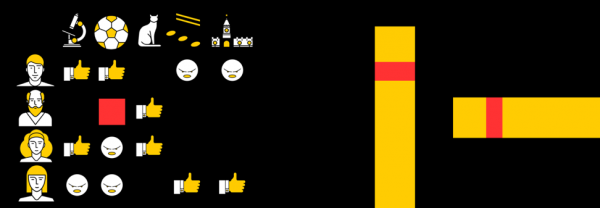
Una de las posibles formas de descomposición de la matriz es ALS (Alternating Least Squares). Vamos a optimizar la siguiente función de pérdida:

Aquí rui es la interacción del usuario u con el documento i, qi es el vector del documento i, pu es el vector del usuario u.
Entonces, el vector óptimo desde el punto de vista del error cuadrático medio del usuario (con los vectores de documentos fijos) se encuentra analíticamente resolviendo la correspondiente regresión lineal.
Esto se llama el "paso ALS". Y el propio algoritmo ALS consiste en que alternamos la fijación de una de las matrices (de usuarios y artículos) y actualizamos la otra, encontrando la solución óptima.
Afortunadamente, encontrar la representación vectorial del usuario es una operación bastante rápida, que se puede realizar en tiempo de ejecución, utilizando instrucciones vectoriales. Este truco permite tener en cuenta de inmediato la retroalimentación del usuario en el ranking. El mismo embedding se puede usar en el índice kNN para mejorar la selección de candidatos.
Filtrado colaborativo distribuido
¿Cómo hacer factorización matricial distribuida incremental y encontrar rápidamente la representación vectorial de nuevos artículos?
El contenido no es la única fuente de señales para recomendaciones. Otra fuente importante es la información colaborativa. Las buenas señales en el ranking tradicionalmente se pueden obtener de la descomposición de la matriz usuario-documento. Sin embargo, al intentar realizar dicha descomposición, nos encontramos con problemas:
1. Tenemos millones de documentos y decenas de millones de usuarios. La matriz no cabe en una sola máquina y la descomposición será muy larga.
2. La mayor parte del contenido en el sistema tiene una corta vida útil: los documentos solo son relevantes durante unas pocas horas. Por lo tanto, es necesario construir su representación vectorial lo más rápido posible.
3. Si se realiza la descomposición justo después de publicar un documento, no habrá sido evaluado por un número suficiente de usuarios. Por lo tanto, su representación vectorial probablemente no será muy buena.
4. Si un usuario ha dado un 'me gusta' o un 'no me gusta', no podremos tener en cuenta esto de inmediato en la descomposición.
Para resolver los problemas mencionados, implementamos una descomposición distribuida de la matriz usuario-documento con actualizaciones incrementales frecuentes. ¿Cómo funciona esto exactamente?
Supongamos que tenemos un clúster de N máquinas (N cuenta en cientos) y queremos realizar una descomposición distribuida de una matriz que no cabe en una sola máquina. La pregunta es: ¿cómo llevar a cabo esta descomposición de manera que, por un lado, cada máquina tenga suficientes datos y, por otro, los cálculos sean independientes?
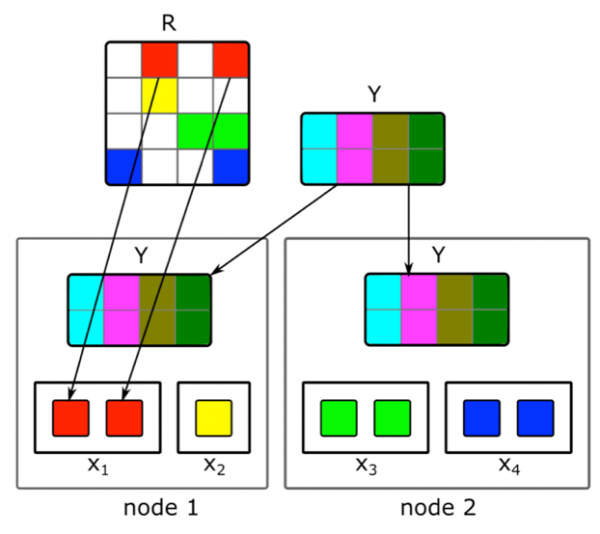
Usaremos el algoritmo de descomposición ALS descrito anteriormente. Veamos cómo realizar un paso de ALS de forma distribuida; los pasos restantes serán similares. Supongamos que tenemos fijada la matriz de documentos y queremos construir la matriz de usuarios. Para ello, la dividiremos en N partes por filas, cada parte contendrá aproximadamente la misma cantidad de filas. Enviaremos a cada máquina las celdas no vacías de las filas correspondientes, así como la matriz de embeddings de documentos (en su totalidad). Dado que su tamaño no es muy grande y la matriz usuario-documento suele estar muy dispersa, estos datos cabrán en una máquina convencional.
Este truco se puede repetir durante varias épocas hasta que el modelo converja, cambiando de manera alterna la matriz fija. Pero incluso así, la descomposición de la matriz puede tardar varias horas. Y esto no resuelve el problema de que se necesitan obtener rápidamente las incrustaciones de nuevos documentos y actualizar las incrustaciones de aquellos de los que había poca información al construir el modelo.
Nos ayudó la implementación de una actualización incremental rápida del modelo. Supongamos que tenemos el modelo entrenado actual. Desde que se entrenó, han aparecido nuevos artículos con los que interactuaron nuestros usuarios, así como artículos que tuvieron poca interacción durante el entrenamiento. Para obtener rápidamente la incrustación de tales artículos, utilizamos las incrustaciones de los usuarios obtenidas durante el primer gran entrenamiento del modelo y hacemos un paso de ALS para calcular la matriz de documentos mientras la matriz de usuarios se mantiene fija. Esto permite obtener las incrustaciones bastante rápido, en unos minutos después de la publicación del documento, y actualizar con frecuencia las incrustaciones de documentos recientes.
Para que las recomendaciones tengan en cuenta inmediatamente las acciones del usuario, en tiempo de ejecución no utilizamos las incrustaciones de usuarios obtenidas fuera de línea. En cambio, hacemos un paso de ALS y obtenemos el vector de usuario actualizado.
Transferencia a otro dominio.
¿Cómo utilizar el feedback del usuario en artículos textuales para construir una representación vectorial de videos?
Inicialmente, solo recomendábamos artículos textuales, por lo que muchos de nuestros algoritmos están adaptados a este tipo de contenido. Pero al agregar contenido de otro tipo, nos enfrentamos a la necesidad de adaptar los modelos. ¿Cómo abordamos esta tarea en el caso de videos? Una opción es volver a entrenar todos los modelos desde cero. Pero esto lleva tiempo, además, algunos algoritmos son exigentes en cuanto al volumen de la muestra de entrenamiento, la cual aún no está disponible en la cantidad necesaria para el contenido de un nuevo tipo en los primeros momentos de su vida en el servicio.
Hemos tomado un camino diferente y reutilizado modelos de texto para videos. En la creación de representaciones vectoriales de videos, nos ayudó el mismo truco con ALS. Tomamos la representación vectorial de los usuarios basada en artículos de texto y dimos un paso de ALS, utilizando la información sobre las vistas de los videos. De este modo, obtuvimos sin esfuerzo la representación vectorial de los videos. Y en tiempo de ejecución, simplemente calculamos la cercanía entre el vector de usuario, obtenido a partir de artículos de texto, y el vector del video.
Conclusión
El desarrollo del núcleo de un sistema de recomendación en tiempo real está asociado con numerosas tareas. Es necesario procesar datos rápidamente y aplicar métodos de ML para un uso efectivo de esos datos; construir sistemas distribuidos complejos, capaces de procesar señales de usuario y nuevas unidades de contenido en el menor tiempo posible; y muchas otras tareas.
En el sistema actual, cuya estructura describí, la calidad de las recomendaciones para el usuario aumenta con su actividad y la duración de su permanencia en el servicio. Pero, por supuesto, aquí radica la principal dificultad: al sistema le cuesta entender de inmediato los intereses de una persona que ha interactuado poco con el contenido. Mejorar las recomendaciones para nuevos usuarios es nuestra tarea clave. Continuaremos optimizando los algoritmos para que el contenido relevante para la persona llegue más rápido a su feed, mientras que el contenido no relevante no se muestre.
Fuente: habr.com
