

Mikhail Salosin (en adelante – MS): – ¡Hola a todos! Me llamo Mikhail. Trabajo como desarrollador backend en la empresa MC2 Software, y les hablaré sobre el uso de Go en el backend de la aplicación móvil «Smotri+».
¿Alguien de los presentes ama el hockey?
Entonces esta aplicación es para usted. Está diseñada para Android e iOS, y sirve para ver transmisiones de varios eventos deportivos en línea y en diferido. También incluye estadísticas diversas, transmisiones en texto, tablas de conferencias, torneos y otra información útil para los aficionados.
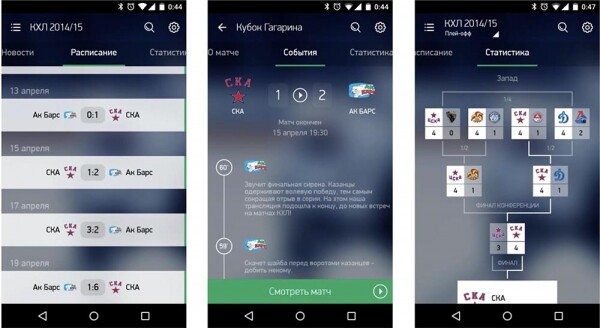
Además, la aplicación cuenta con una función de momentos destacados, es decir, puede ver los momentos álgidos de los partidos (goles, peleas, penaltis, etc.). Si no quiere ver toda la transmisión, puede ver solo lo más interesante.
¿Qué se utilizó en el desarrollo?
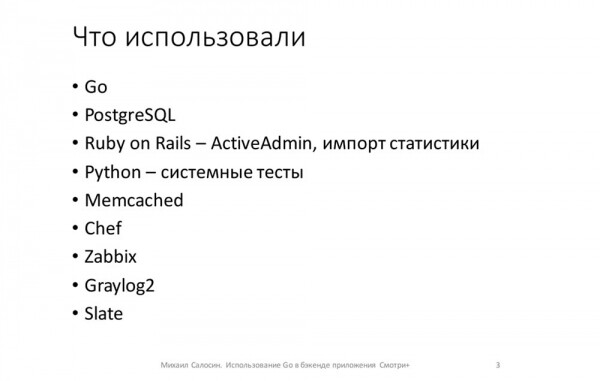
La mayor parte fue escrita en Go. La API que usaron los clientes móviles fue desarrollada en Go. También se creó un servicio en Go para enviar notificaciones push a los móviles. Además, tuvimos que escribir nuestra propia ORM, de la que quizás hablaremos algún día. Y se desarrollaron en Go algunos servicios menores: redimensionamiento y carga de imágenes para la parte de editores…
Como base de datos utilizamos PostgreSQL. La interfaz para los editores fue desarrollada en Ruby on Rails usando la gema ActiveAdmin. También se escribió en Ruby la importación de estadísticas del proveedor de estadísticas.
Para las pruebas del API utilizamos unittest de Python. Memcached se usa para limitar las solicitudes a la API de pagos, Chef se utiliza para el control de la configuración, Zabbix para la recopilación y monitoreo de datos estadísticos internos del sistema. Graylog2 se utiliza para la recopilación de logs, y Slate es la documentación de la API para los clientes.
Selección del protocolo
El primer problema que enfrentamos fue elegir un protocolo para la interacción del backend con los clientes móviles, considerando los siguientes puntos…
- El requerimiento más importante: los datos en los clientes deben actualizarse en tiempo real. Es decir, todos aquellos que estén viendo la transmisión en ese momento deben recibir actualizaciones prácticamente al instante.
- Para simplificar, asumimos que los datos que se sincronizan con los clientes no se eliminan, sino que se ocultan mediante banderas especiales.
- Todo tipo de consultas raras (como estadísticas, composiciones de equipos, estadísticas de equipos) se obtienen mediante solicitudes GET normales.
- Además, el sistema debería poder manejar cómodamente 100,000 usuarios simultáneamente.
Con base en esto, teníamos dos opciones de protocolo:
- Websockets. Pero no necesitábamos canales del cliente al servidor. Solo necesitábamos enviar actualizaciones del servidor al cliente, por lo que el websocket es una opción excesiva.
- ¡Los Eventos Enviados por el Servidor (SSE) fueron perfectos! Son lo suficientemente simples y satisfacen prácticamente todas nuestras necesidades.
Eventos Enviados por el Servidor
Unas palabras sobre cómo funciona esta cosa...
Funciona sobre una conexión http. El cliente envía una solicitud, el servidor responde con Content-Type: text/event-stream y no cierra la conexión con el cliente, sino que sigue enviando datos a la conexión:
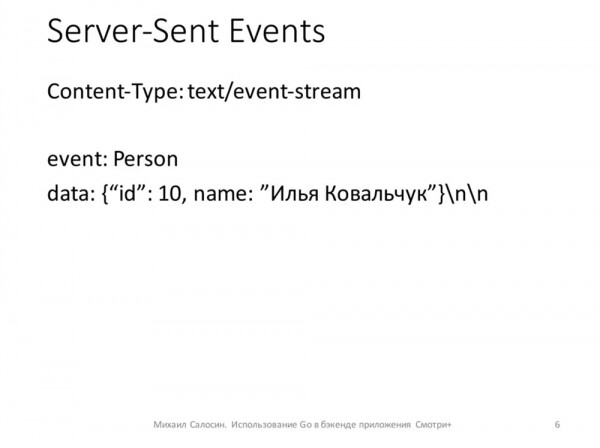
Los datos se pueden enviar en un formato acordado con los clientes. En nuestro caso, enviamos así: en el campo event se enviaba el nombre de la estructura que cambió (persona, jugador), y en el campo data – JSON con los nuevos campos cambiados para el jugador.
Ahora, sobre cómo funciona la interacción misma.
- Primero, el cliente determina cuándo fue la última vez que se sincronizó con el servicio: revisa su base de datos local y determina la fecha del último cambio registrado.
- Envía una solicitud con esa fecha.
- En respuesta, le enviamos todas las actualizaciones que ocurrieron desde esa fecha.
- Después de eso, establece una conexión con el canal en vivo y no la cierra hasta que necesite esas actualizaciones:
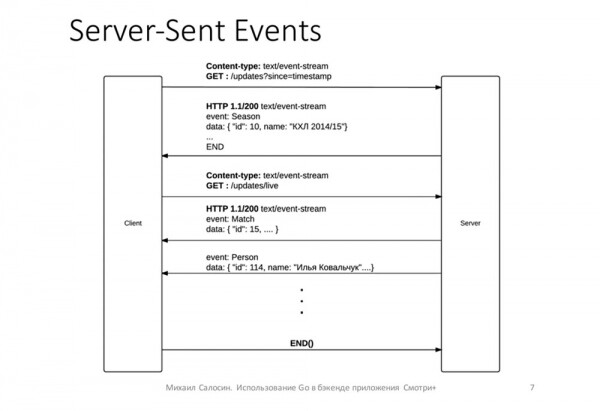
Le enviamos una lista de cambios: si alguien anota un gol – se actualiza el marcador del partido, si alguien se lesiona – también se envía en tiempo real. De esta manera, en el feed de eventos del partido, los clientes reciben datos actualizados instantáneamente. Periódicamente, para que el cliente entienda que el servidor no ha caído, que no ha pasado nada, enviamos cada 15 segundos un timestamp – para que sepa que todo está bien y no necesita reconectarse.
¿Cómo se mantiene la conexión en vivo?
- En primer lugar, creamos un canal en el que llegarán las actualizaciones de un búfer.
- Luego, suscribimos ese canal para recibir actualizaciones.
- Establecemos el encabezado correcto, para que el cliente sepa que todo está bien.
- Enviamos el primer ping. Simplemente registramos el timestamp actual de la conexión.
- Después de esto, leemos del canal en un ciclo hasta que el canal de actualizaciones esté cerrado. Al canal llegan periódicamente ya sea el timestamp actual o los cambios que ya estamos registrando en las conexiones abiertas.
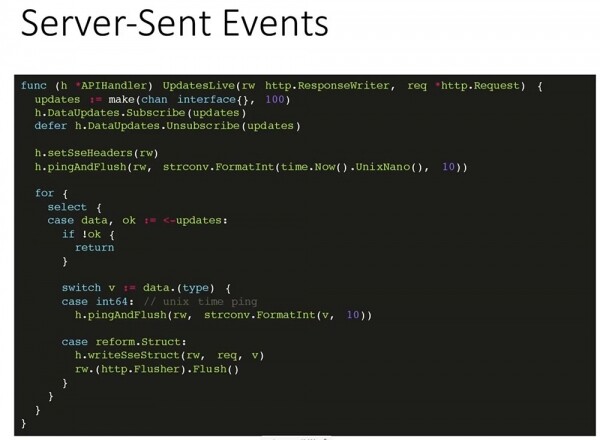
El primer problema al que nos enfrentamos fue el siguiente: para cada conexión abierta con el cliente creábamos un temporizador que sonaba cada 15 segundos; así, si teníamos 6,000 conexiones abiertas con una máquina (con un servidor API), se creaban 6,000 temporizadores. Esto provocaba que la máquina no soportara la carga necesaria. El problema no era tan obvio para nosotros, pero nos dieron un poco de ayuda y lo resolvimos.
Como resultado, ahora el ping proviene del mismo canal que las actualizaciones.
Por lo tanto, solo hay un temporizador que suena cada 15 segundos.
Aquí hay varias funciones auxiliares: enviar el encabezado, el ping y la estructura misma. Es decir, se transmite el nombre de la tabla (persona, partido, temporada) y la información sobre este registro:

El mecanismo de envío de actualizaciones
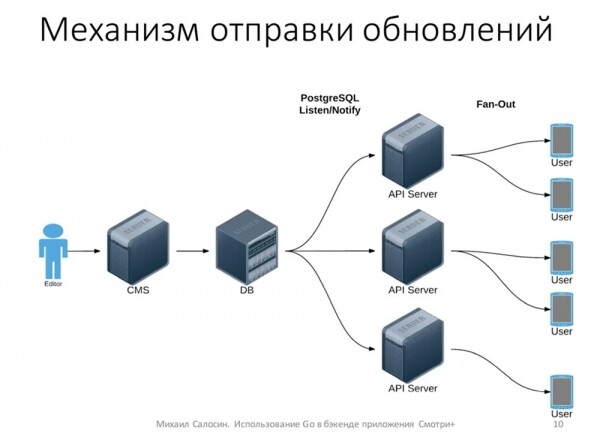
Ahora un poco sobre de dónde provienen los cambios. Tenemos varias personas, editores, que observan la transmisión en tiempo real. Ellos crean todos los eventos: alguien fue expulsado, alguien se lesionó, hay un cambio...
A través del CMS, los datos llegan a la base de datos. Después, la base de datos, con el mecanismo Listen/Notify, notifica a los servidores API sobre esto. Los servidores API ya envían esta información a los clientes. Así, esencialmente, solo hay algunos servidores conectados a la base de datos y no hay una carga especial sobre la base, porque el cliente no interactúa directamente con la base:
PostgreSQL: Listen/Notify
El mecanismo Listen/Notify en PostgreSQL permite notificar a los suscriptores sobre eventos que han cambiado, es decir, que se ha creado un nuevo registro en la base de datos. Para esto, escribimos un simple disparador y función:
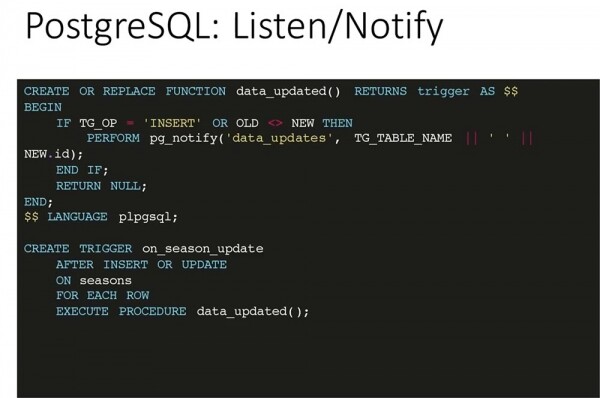
Con cada inserción o cambio de registro, invocamos la función notify en el canal data_updates, pasando el nombre de la tabla y el identificador del registro que fue modificado o insertado.
Para todas las tablas que deben sincronizarse con el cliente, definimos un desencadenador que, después de cambiar o actualizar un registro, invoca la función indicada en la diapositiva de abajo.
¿Cómo se suscribe la API a estos cambios?
Se crea el mecanismo de Fanout, que envía mensajes a los clientes. Recoge todos los canales de los clientes y envía las actualizaciones que ha recibido a través de estos canales:
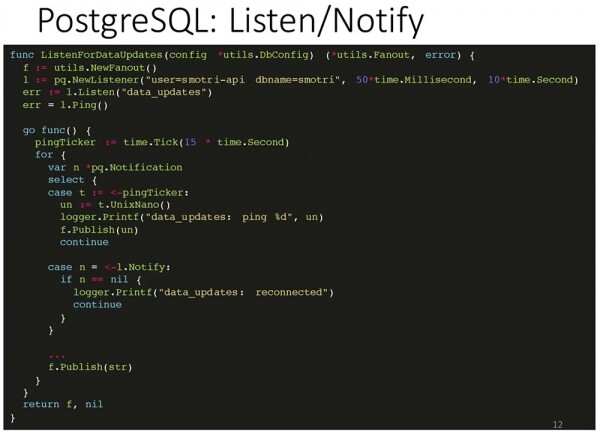
Aquí está la biblioteca estándar pq, que se conecta a la base de datos y dice que quiere escuchar el canal (data_updates), verifica que la conexión esté abierta y que todo esté en orden. Omito la verificación de errores para ahorrar espacio (no verificar puede ser peligroso).
Luego, configuramos asíncronamente un Ticker que enviará un ping cada 15 segundos y comenzamos a escuchar el canal al que nos hemos suscrito. Si recibimos un ping, publicamos este ping. Si recibimos algún registro, lo publicamos a todos los suscriptores de este Fanout.
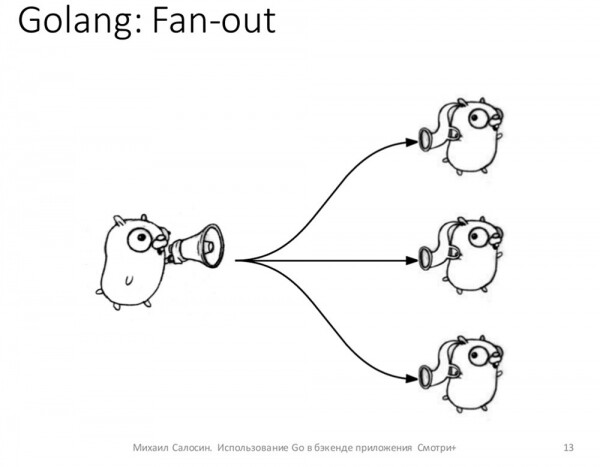
¿Cómo funciona Fan-out?
En ruso se traduce como 'distribuidor'. Tenemos un objeto que registra a los suscriptores que quieren recibir actualizaciones. Y tan pronto como llega una actualización a este objeto, la distribuye a todos los suscriptores existentes. Es bastante simple:
Cómo está implementado en Go:
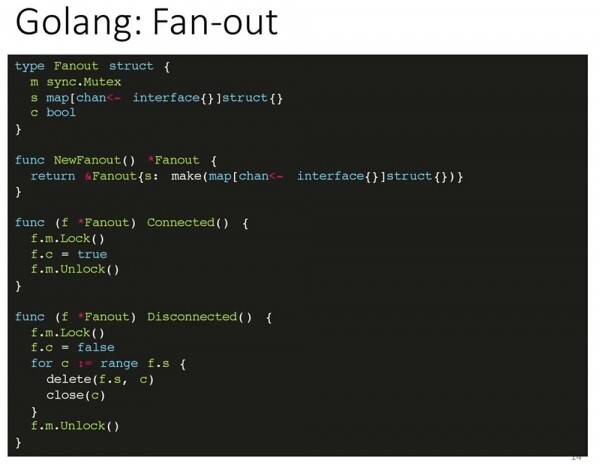
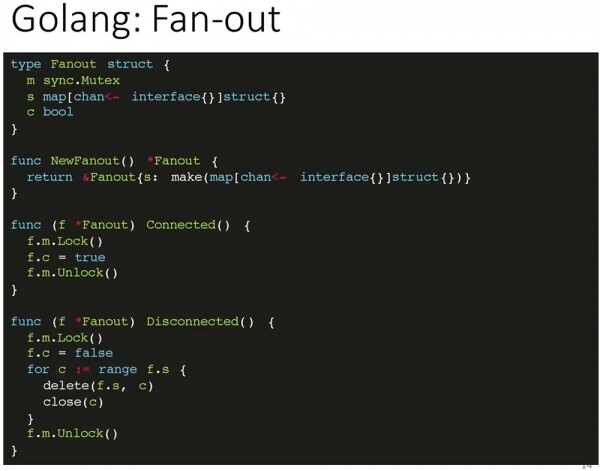
Hay una estructura que se sincroniza con Mutex. Tiene un campo que guarda el estado de la conexión de Fanout con la base de datos, es decir, en este momento está escuchando y recibirá actualizaciones, así como una lista de todos los canales existentes: un mapa, cuya clave es el canal y un struct como valores (en esencia no se utiliza).
Dos métodos: Connected y Disconnected – permiten decirle a Fanout que tenemos conexión con la base, que ha sido establecida y que la conexión con la base se ha interrumpido. En el segundo caso, es necesario desconectar a todos los clientes y notificarles que ya no pueden escuchar nada y que deben reconectarse, ya que la conexión con ellos se ha cerrado.
También hay un método Subscribe que agrega un canal a los 'escuchadores':
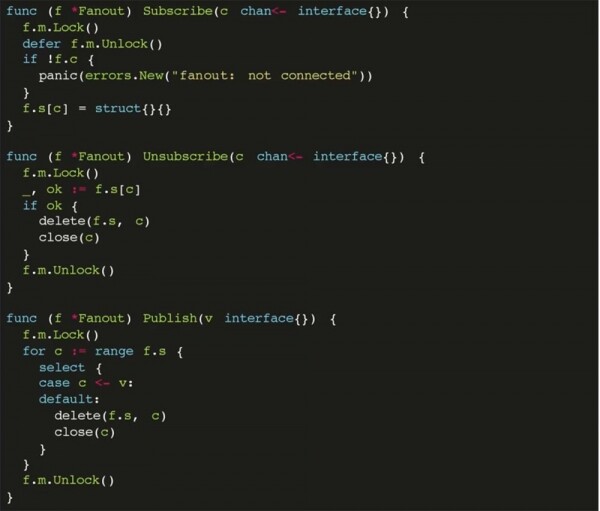
Hay un método Unsubscribe que elimina un canal de los que están escuchando si el cliente se desconectó, así como un método Publish que permite enviar un mensaje a todos los suscriptores.
Pregunta: – ¿Qué se está transmitiendo en este canal?
MC: – Se transmite el modelo que ha cambiado o un ping (en esencia, simplemente un número, entero).
MC: – Se puede enviar cualquier cosa, cualquier estructura – se convierte simplemente en JSON y ya está.
MC: Recibimos una notificación de «Postgres» que contiene el nombre de la tabla y el identificador. Con el nombre de la tabla y el identificador, obtenemos el registro que necesitamos y luego enviamos esa estructura para su publicación.
Infraestructura
¿Cómo se ve esto desde el punto de vista de la infraestructura? Tenemos 7 servidores físicos: uno de ellos está completamente dedicado a la base de datos, y en los otros seis se ejecutan máquinas virtuales. Hay 6 copias de API: cada máquina virtual con API se ejecuta en un servidor físico separado, eso es para mayor fiabilidad.
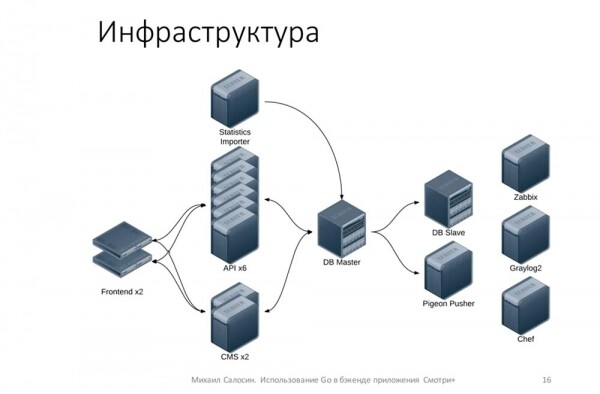
Contamos con dos frontends en los que se ha instalado Keepalived para mejorar la disponibilidad, de modo que, en caso de que sea necesario, un frontend pueda reemplazar al otro. Además, hay dos copias del CMS.
También tenemos un importador de estadísticas. Hay un DB Slave, del cual se realizan copias de seguridad periódicamente. Existe Pigeon Pusher, que es la aplicación que envía notificaciones push a los clientes, así como herramientas de infraestructura: Zabbix, Graylog2 y Chef.
En realidad, esta infraestructura es redundante, ya que 100 mil usuarios se pueden atender con menos servidores. Pero al tener el hardware, lo utilizamos (nos dijeron que se podía, así que ¿por qué no?).
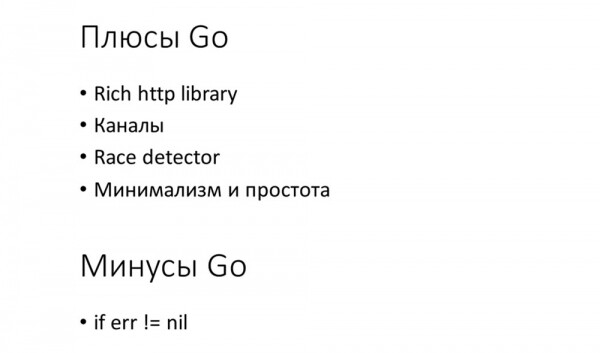
Ventajas de Go
Después de trabajar en esta aplicación, se hicieron evidentes algunas ventajas obvias de Go.
- Una excelente biblioteca http. Con ella, se puede crear mucho más «listo para usar».
- Además, los canales nos permitieron implementar muy fácilmente el mecanismo de envío de notificaciones a los clientes.
- La maravillosa herramienta Race detector nos permitió solucionar varios errores críticos (infraestructura de staging). Todo lo que se ejecuta en staging está compilado con la opción Race; por lo tanto, podemos ver en la infraestructura de staging cuáles son nuestros problemas potenciales.
- Minimalismo y simplicidad del lenguaje.
¡Estamos buscando desarrolladores! Si alguien está interesado, por favor.
Preguntas
Pregunta del público (en adelante - P): – Me parece que pasaste por alto un punto importante relacionado con Fan-out. Entiendo correctamente que cuando envías una respuesta al cliente, te bloqueas si el cliente no quiere leer?
MC: – No, no nos bloqueamos. Primero, todo esto está detrás de nginx, así que no hay problemas con clientes lentos. En segundo lugar, el cliente tiene un canal con búfer; en esencia, podemos enviar hasta cien actualizaciones... Si no podemos escribir en el canal, lo elimina. Si vemos que el canal se bloqueó, simplemente lo cerramos y listo: el cliente se reconectará si hay algún problema. Por lo tanto, en principio no surgen bloqueos.
Q: – ¿No se podía enviar directamente la grabación en Listen/Notify, en lugar de la tabla-identificador?
MC: – Listen/Notify tiene un límite de 8 mil bytes en la precarga que envía. En principio, podríamos enviar, si tratáramos con una pequeña cantidad de datos, pero creo que de la manera que lo hacemos es simplemente más confiable. Las limitaciones están en el mismo "Postgres".
Q: – ¿Los clientes reciben actualizaciones sobre partidos que no les interesan?
MC: – En general, sí. Por regla general, hay 2-3 partidos en paralelo, y eso es bastante raro. Si un cliente está mirando algo, normalmente está viendo el partido que está en curso. Luego, en el cliente hay una base de datos local donde se almacenan todas estas actualizaciones, y incluso sin conexión a Internet, el cliente puede ver todos los partidos pasados sobre los cuales tiene actualizaciones. En esencia, sincronizamos nuestra base de datos en el servidor con la base de datos local del cliente, para que pueda trabajar también en modo offline.
Q: – ¿Por qué hicieron su propia ORM?
Alexey (uno de los desarrolladores de "Smotri+"): – En ese momento (hace un año) había menos ORM que ahora, cuando hay bastante. De la mayoría de las ORM existentes, lo que más me desagrada es que la mayoría de ellas opera con interfaces vacías. Es decir, los métodos en estas ORM están listos para aceptar cualquier cosa: estructura, puntero a una estructura, número, algo que en realidad no tiene nada que ver...
Nuestra ORM genera estructuras basadas en el modelo de datos. Por sí misma. Así que todos los métodos son concretos, no utilizan reflexión, etc. Aceptan estructuras y esperan usar las estructuras que vengan.
Q: – ¿Cuántas personas participaron?
MC: – En la etapa inicial participaron dos personas. Comenzamos en junio, en agosto la mayor parte estaba lista (primera versión). En septiembre hubo un lanzamiento.
Q: – En la parte donde describes SSE, no usas timeout. ¿Por qué es así?
MC: – Si hablamos con sinceridad, SSE es en realidad un protocolo html5: el estándar SSE está diseñado para comunicarse con los navegadores, hasta donde entiendo. Tiene características adicionales para que los navegadores puedan reconectarse (y demás), pero no las necesitamos, porque tuvimos clientes que podían implementar cualquier lógica de conexión y obtención de información. Hicimos más bien algo que no es exactamente SSE, sino algo parecido a SSE. No es el protocolo en sí.
No había necesidad. Hasta donde entiendo, los clientes implementaron el mecanismo de conexión prácticamente desde cero. Les daba igual en principio.
Q: – ¿Qué utilidades adicionales utilizaron?
MC: – Utilizamos principalmente govet y golint para mantener un estilo uniforme, así como gofmt. No usamos nada más.
Q: – ¿Con qué realiaron la depuración?
MC: – La depuración, en gran medida, se llevó a cabo a través de pruebas. No usamos ningún depurador, no utilizamos GOP.
Q: – ¿Podrías volver a la diapositiva donde se implementa la función Publish? ¿No te incomodan los nombres de variables de una sola letra?
MC: – No. Tienen un ámbito bastante "estrecho". No se utilizan en ninguna parte, excepto aquí (salvo en el interior de esta clase), y es muy compacto: solo ocupa 7 líneas.
Q: – Aún así, no es intuitivo...
MC: – No, no, ¡este es un código real! No se trata de estilo. Simplemente es una clase utilitaria, muy pequeña: solo 3 campos dentro de la clase...
MC: – En general, todos los datos que se sincronizan con los clientes (partidos de temporada, jugadores) no cambian. En palabras simples, si estamos haciendo otro deporte en el que se necesite cambiar un partido, simplemente lo tendremos en cuenta en una nueva versión del cliente, y las versiones antiguas del cliente serán bloqueadas.
Q: – ¿Hay algún paquete externo para gestionar dependencias?
MC: – Usamos go dep.
Q: – En el tema de la presentación había algo sobre video, pero en la presentación no hay nada sobre video.
MC: – No, no tengo nada sobre video en mi tema. Se llama "Smetri+" – así es como se llama la aplicación.
Q: – Dijiste que se transmite a los clientes?..
MC: – No nos ocupamos del video en streaming. Eso lo hacía completamente "Megafon". Sí, no mencioné que la aplicación es de Megafon.
MC: – Go – para enviar todos los datos – sobre la cuenta, los eventos del partido, estadísticas… Go – es completamente el backend para la aplicación. El cliente debe encontrar de algún lugar qué enlace usar para el reproductor, para que el usuario pueda ver el partido. Tenemos enlaces para videos y transmisiones que están preparados.
Un poco de publicidad 🙂
Gracias por permanecer con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más contenido interesante? Apóyanos haciendo un pedido o recomendando a tus conocidos, , un análogo único de servidores entry-level que hemos diseñado para Ti: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a mitad de precio en el centro de datos Equinix Tier IV en Ámsterdam? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
