

Cuando tu trabajo es crear algo hermoso, no necesitas hablar mucho de él, porque el resultado está a la vista de todos. Pero si borras las inscripciones de las paredes, tu trabajo pasa desapercibido, hasta que las paredes lucen decentes o hasta que borres algo inapropiado.
Cualquier servicio donde se puede dejar un comentario, reseña, enviar un mensaje o subir imágenes, tarde o temprano enfrenta problemas de spam, fraude y lenguaje ofensivo. Esto es inevitable, pero hay que luchar contra ello.
Me llamo Mijaíl, trabajo en el equipo de Antispam, que protege a los usuarios de los servicios de Yandex de problemas similares. Nuestro trabajo raramente es visible (¡y eso es bueno!), así que hoy les contaré más al respecto. Aprenderán en qué casos la moderación es inútil y por qué la precisión no es el único indicador de su efectividad. También hablaremos de lenguaje ofensivo usando ejemplos de gatos y perros y por qué a veces es útil 'pensar como un grosero'.
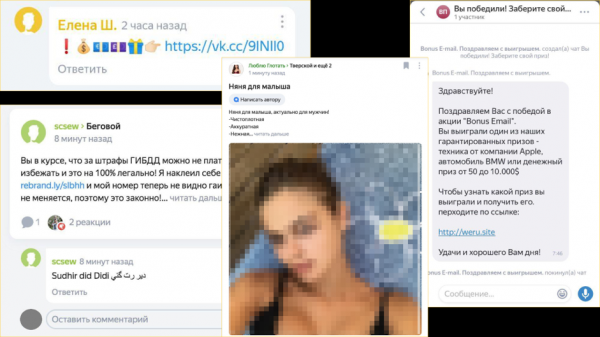
En Yandex, cada vez hay más servicios donde los usuarios publican su contenido. Puedes hacer una pregunta o escribir una respuesta en Yandex.Q, discutir las noticias del vecindario en Yandex.District, compartir la situación del tráfico en los chateos de Yandex.Maps. Pero cuando la audiencia del servicio crece, se vuelve atractiva para los estafadores y spammers. Ellos llegan y llenan los comentarios: ofrecen ganancias fáciles, promocionan remedios milagrosos y prometen pagos sociales. Debido a los spammers, algunos usuarios pierden dinero, mientras que otros pierden el interés en pasar tiempo en un servicio descuidado, lleno de spam.
Y este no es el único problema. Nos esforzamos no solo por proteger a los usuarios de los estafadores, sino también por crear un ambiente cómodo para la comunicación. Si las personas en los comentarios se enfrentan a lenguaje ofensivo y insultos, hay una alta probabilidad de que se vayan y no regresen. Por lo tanto, también hay que saber cómo lidiar con esto.
Internet Limpio
Como suele ocurrir, los primeros desarrollos surgieron en la Búsqueda, en la parte que se ocupa de combatir el spam en los resultados. Hace unos diez años, surgió la tarea de filtrar contenido adulto para búsquedas familiares y para consultas que no debían devolver resultados de la categoría 18+. Así aparecieron los primeros diccionarios de porno y malas palabras, que fueron ampliados por analistas. La tarea principal era clasificar las consultas en aquellas donde se podía mostrar contenido adulto y aquellas donde no. Para esta tarea se recopiló información, se construyeron heurísticas y se entrenaron modelos. Así nacieron los primeros avances en la filtración de contenido no deseado.
Con el tiempo, comenzó a aparecer UGC (contenido generado por el usuario) en Yandex: mensajes escritos por los propios usuarios, y Yandex solo se encargaba de publicarlos. Por las razones mencionadas anteriormente, muchos mensajes no podían ser publicados sin revisión, por lo que se requería moderación. Así que decidieron crear un servicio que proporcionara protección contra spam y atacantes para todos los productos UGC de Yandex y utilizara los avances en la filtración de contenido no deseado en la Búsqueda. El servicio fue llamado "Web Limpio".
Nuevas tareas y ayuda de los trabajadores temporales
Al principio, solo funcionaba una automatización simple: los servicios nos enviaban textos, y nosotros aplicábamos los diccionarios de malas palabras, los diccionarios de porno y expresiones regulares — los analistas lo hacían todo a mano. Pero con el tiempo, el servicio fue utilizado en un número cada vez mayor de productos de Yandex, y tuvimos que aprender a lidiar con nuevos problemas.
A menudo, en lugar de una reseña, los usuarios publican una serie de letras sin sentido, intentando obtener un logro, a veces promocionan su empresa en reseñas sobre la empresa competidora, y otras veces simplemente confunden organizaciones y en una reseña sobre una tienda de mascotas escriben: "¡Pescado perfectamente preparado!". Quizás algún día la inteligencia artificial aprenda a captar perfectamente el sentido de cualquier texto, pero por ahora, la automatización a veces tiene un rendimiento peor que el ser humano.
Se hizo evidente que no podíamos evitar el etiquetado manual aquí, así que añadimos un segundo nivel a nuestro proceso: el envío para revisión manual por parte de un ser humano. Los textos publicados que no presentaban problemas según el clasificador fueron enviados allí. La magnitud de esta tarea es fácil de imaginar, por lo que no solo confiamos en los evaluadores, sino que también recurrimos a la "sabiduría de las multitudes", es decir, pedimos ayuda a los trabajadores de crowdsourcing. Ellos nos ayudan a identificar lo que la máquina ha pasado por alto y así la entrenan.
Caché inteligente y hash LSH
Otro problema que encontramos al trabajar con comentarios fue el spam, más precisamente, el volumen y la velocidad de su propagación. Cuando la audiencia de Yandex.Region comenzó a crecer rápidamente, llegaron los spammers. Aprendieron a eludir las expresiones regulares, modificando ligeramente el texto. Por supuesto, se encontraba y eliminaba spam, pero a la escala de Yandex, un mensaje inaceptable publicado incluso por 5 minutos podía ser visto por cientos de personas.
Esto no nos satisfizo, así que implementamos un caché inteligente de textos basado en LSH (). Funciona de la siguiente manera: normalizábamos el texto, eliminábamos enlaces y lo dividíamos en n-gramas (secuencias de n letras). Luego calculábamos los hashes de los n-gramas, y a partir de ellos construíamos el vector LSH del documento. La idea es que textos similares, incluso si fueron ligeramente modificados, se convertían en vectores similares.
Esta solución permitió reutilizar los veredictos de los clasificadores y evaluadores para textos similares. Durante un ataque de spam, tan pronto como el primer mensaje pasaba la revisión y entraba en la caché con el veredicto de "spam", todos los nuevos mensajes similares, incluso los modificados, recibían el mismo veredicto y se eliminaban automáticamente. Posteriormente, aprendimos a entrenar y reentrenar automáticamente los clasificadores de spam, pero este "caché inteligente" ha permanecido con nosotros y todavía nos ayuda con frecuencia.
Clasificador de buenos textos
Sin tiempo para descansar de la lucha contra el spam, nos dimos cuenta de que el 95% del contenido está moderado manualmente: los clasificados solo reaccionan a las violaciones, y la mayoría de los textos son buenos. Cargamos a los evaluadores, que en el 95% de los casos dan una calificación de 'Todo OK'. Tuvimos que dedicarnos a un trabajo poco habitual: crear clasificadores de contenido bueno, afortunadamente, se había acumulado suficiente anotación durante este tiempo.
El primer clasificador se veía así: lematizamos el texto (convertimos las palabras a su forma básica), eliminamos todas las partes del habla auxiliares y aplicamos un 'diccionario de buenas lemas' preconfigurado. Si en el texto todas las palabras son 'buenas', significa que el texto en su totalidad no contiene violaciones. Este enfoque en diferentes servicios proporcionó automáticamente entre el 25% y el 35% de la automatización de la anotación manual. Por supuesto, este enfoque no es perfecto: no es difícil combinar algunas palabras inocentes y obtener una declaración muy ofensiva, pero nos permitió alcanzar rápidamente un buen nivel de automatización y nos dio tiempo para entrenar modelos más complejos.
Las siguientes versiones de los clasificadores de buenos textos ya incluían modelos lineales, árboles de decisión y sus combinaciones. Para la anotación de groserías y ofensas, por ejemplo, probamos la red neuronal BERT. Aquí es importante captar el significado de la palabra en contexto y la relación de las palabras de diferentes oraciones, y BERT lo hace bastante bien. (Por cierto, recientemente colegas de Noticias , como aplican la tecnología para una tarea no estándar: encontrar errores en los titulares.) En resumen, se logró automatizar hasta el 90% del flujo, dependiendo del servicio.
Precisión, integridad y velocidad
Para desarrollarse, es necesario entender qué beneficios aportan los diferentes clasificadores automáticos, los cambios en ellos, así como si la calidad de las verificaciones manuales no está decreciendo. Para esto utilizamos métricas de precisión e integridad.
La precisión es la proporción de juicios correctos entre todos los juicios sobre contenido inapropiado. Cuanto mayor sea la precisión, menos falsas alarmas habrá. Si no se controla la precisión, teóricamente se puede eliminar todo el spam y el contenido ofensivo, y junto a ellos, la mitad de los buenos mensajes. Por otro lado, si solo confiamos en la precisión, la mejor tecnología será aquella que no atrape a nadie. Por ello, existe otra métrica: la exhaustividad; la proporción de contenido inapropiado detectado entre todo el volumen de contenido malo. Estas dos métricas se equilibran entre sí.
Para medirlo, muestreamos todo el flujo entrante de cada servicio y enviamos muestras de contenido a los evaluadores para su valoración experta y comparación con las decisiones de la máquina.
Pero hay otra métrica importante.
Como mencioné anteriormente, un mensaje inapropiado puede ser visto por cientos de personas incluso dentro de 5 minutos. Por eso contamos cuántas veces hemos podido mostrar contenido malo a las personas antes de ocultarlo. Esto es importante, porque no basta con trabajar con calidad; también hay que trabajar rápido. Y al construir la defensa contra contenido ofensivo, nos dimos cuenta de esto plenamente.
Antisinonimia usando gatos y perros
Una pequeña digresión. Algunos pueden decir que las groserías y los insultos no son tan peligrosos como los enlaces maliciosos, y no son tan molestos como el spam. Pero nos esforzamos por mantener condiciones cómodas para la comunicación de millones de usuarios, y a las personas no les gusta volver a lugares donde son ofendidas. No es en vano que la prohibición de las groserías y los insultos está establecida en las reglas de muchas comunidades, incluida la de Habr. Pero hemos divagado.
Los diccionarios de groserías no abarcan toda la riqueza del idioma ruso. A pesar de que hay solo cuatro raíces básicas de palabras ofensivas, se pueden formar un número incalculable de palabras que no se pueden atrapar con expresiones regulares. Además, se puede escribir parte de la palabra en translit, reemplazar letras con combinaciones similares, reordenar letras, agregar asteriscos, etc. A veces, sin contexto, no se puede determinar claramente a qué palabra ofensiva se refería el usuario. Respetamos las reglas de Habr, así que demostraremos esto no con ejemplos reales, sino con gatos y perros.
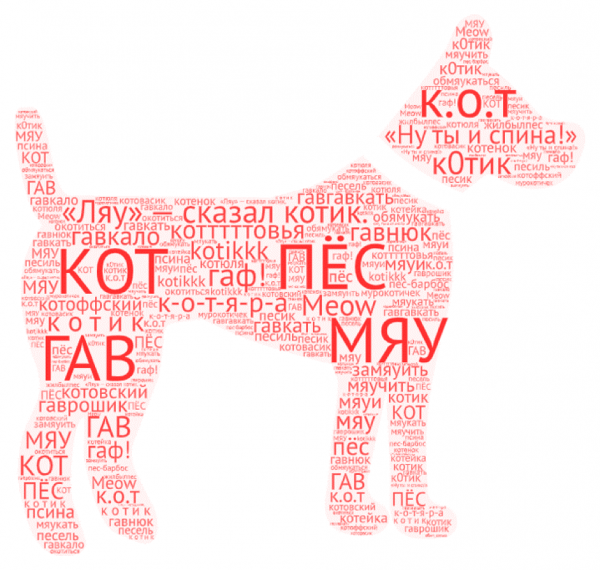
"Meow", dijo el gatito. Pero entendemos que el gatito dijo otra palabra...
Comenzamos a pensar en los algoritmos de "coincidencia difusa" de nuestro diccionario y en un preprocesamiento más inteligente: convertimos a transliteración, unimos espacios y puntuación, buscamos patrones y creamos expresiones regulares específicas para ellos. Este enfoque dio resultados, pero a menudo disminuyó la precisión, sin proporcionar la exhaustividad deseada.
Entonces decidimos "pensar como groseros". Comenzamos a introducir ruido en los datos: reorganizamos las letras, generamos errores tipográficos, sustituimos letras por otras similares, y así sucesivamente. Tomamos las primeras etiquetas aplicando diccionarios de groserías a grandes corpus de texto. Si tomamos una oración y la distorsionamos de varias maneras, ya obtenemos muchas oraciones. Así se puede aumentar el conjunto de entrenamiento decenas de veces. Solo quedaba entrenar algún modelo inteligente que tuviera en cuenta el contexto con el conjunto obtenido.
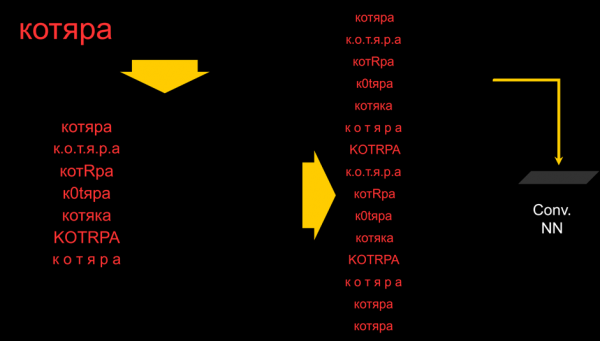
Es demasiado pronto para hablar de la solución final. Aún estamos experimentando con enfoques para este problema, pero ya vemos que una simple red convolucional de caracteres de varias capas supera notablemente a los diccionarios y expresiones regulares: se logra aumentar tanto la precisión como la exhaustividad.
Por supuesto, entendemos que siempre habrá formas de eludir incluso la automatización más avanzada, especialmente cuando se trata de un juego divertido: escribir de tal manera que una máquina tonta no lo entienda. Aquí, como en la lucha contra el spam, no tenemos como objetivo erradicar la posibilidad de escribir algo obsceno, nuestra tarea es hacer que el juego no valga la pena.
Abrir la posibilidad de compartir opiniones, comunicarse y comentar no es difícil. Lo que es mucho más complicado es lograr condiciones seguras, cómodas y un trato respetuoso hacia las personas. Sin esto, no habrá desarrollo de ninguna comunidad.
Fuente: habr.com
