

Condición estándar al implementar CI/CD en Kubernetes: la aplicación debe ser capaz de no aceptar nuevas solicitudes de clientes antes de detenerse por completo y, lo más importante, completar con éxito las solicitudes existentes.
Cumplir esta condición permite lograr un tiempo de inactividad cero durante el despliegue. Sin embargo, incluso al usar combinaciones muy populares (como NGINX y PHP-FPM), se pueden encontrar dificultades que provocarán un aumento de errores en cada despliegue...
Teoría. Cómo vive un pod
Ya hemos publicado en detalle sobre el ciclo de vida de un pod . En el contexto del tema que estamos considerando, nos interesa lo siguiente: en el momento en que el pod pasa al estado Terminating, ya no se envían nuevas solicitudes al mismo (el pod de la lista de endpoints para el servicio). De este modo, para evitar el tiempo de inactividad durante el despliegue, por nuestra parte, es suficiente resolver el problema del apagado controlado de la aplicación.
También hay que recordar que el periodo de gracia por defecto es : después de esto, el pod será terminado y la aplicación debe ser capaz de procesar todas las solicitudes antes de que finalice este periodo. Nota: aunque cualquier solicitud que dure más de 5-10 segundos ya es problemática y el apagado controlado no ayudará...
Para entender mejor qué sucede cuando un pod termina su trabajo, es suficiente estudiar el siguiente esquema:
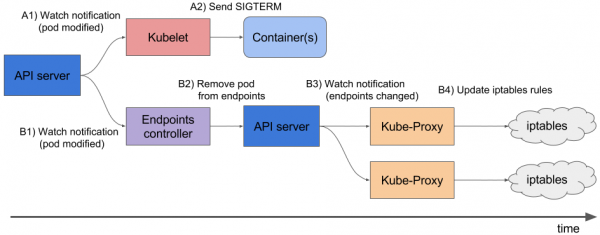
A1, B1 — Recepción de cambios sobre el estado del pod
A2 — Envío de SIGTERM
B2 — Eliminación del pod de los endpoints
B3 — Recepción de cambios (se ha modificado la lista de endpoints)
B4 — Actualización de las reglas de iptables
Tenga en cuenta: la eliminación del endpoint del pod y el envío de SIGTERM no se realizan secuencialmente, sino en paralelo. Y debido a que Ingress no recibe la lista actualizada de Endpoints de inmediato, el pod recibirá nuevas solicitudes de los clientes, lo que provocará errores 500 durante la terminación del pod (más material detallado sobre esta cuestión lo hemos ). Esta problemática debe resolverse de las siguientes maneras:
- Enviar en los encabezados de respuesta Connection: close (si se trata de una aplicación HTTP).
- Si no es posible realizar cambios en el código, el artículo a continuación describe una solución que permitirá procesar solicitudes hasta el final del periodo de gracia.
Teoría. Cómo NGINX y PHP-FPM finalizan sus procesos
NGINX
Comencemos con NGINX, ya que es más o menos obvio. Al sumergirnos en la teoría, aprenderemos que NGINX tiene un proceso maestro y varios "workers" — son procesos secundarios que manejan las solicitudes de los clientes. Hay una opción conveniente: a través del comando nginx -s podemos finalizar los procesos ya sea en modo de apagado rápido o en un apagado elegante. Es evidente que nos interesa la última opción.
Luego, todo es sencillo: se requiere agregar en el el comando que enviará la señal para un apagado elegante. Esto se puede hacer en el Deployment, en el bloque del contenedor:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Ahora, en el momento de finalizar el pod, en los registros del contenedor NGINX veremos lo siguiente:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
Y esto significará lo que necesitamos: NGINX espera a que se completen las solicitudes, después de lo cual termina el proceso. Sin embargo, más adelante se tratará un problema común, que es la razón por la cual, incluso con el comando nginx -s quit el proceso se termina de manera incorrecta.
Y en esta etapa hemos terminado con NGINX: al menos en los registros se puede entender que todo funciona como debería.
¿Cómo van las cosas con PHP-FPM? ¿Cómo maneja el apagado elegante? Vamos a averiguarlo.
PHP-FPM
En el caso de PHP-FPM hay un poco menos de información. Si nos basamos en el de PHP-FPM, se menciona que recibe las siguientes señales POSIX:
-
SIGINT,SIGTERM— apagado rápido; -
SIGQUIT— apagado elegante (lo que necesitamos).
Las demás señales no son necesarias para esta tarea, por lo que omitiré su análisis. Para finalizar el proceso correctamente, será necesario escribir el siguiente preStop-hook:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
A primera vista, eso es todo lo que se requiere para realizar un apagado elegante en ambos contenedores. Sin embargo, la tarea es más complicada de lo que parece. A continuación, se analizan dos casos en los que el apagado elegante no funcionó y causó una breve indisponibilidad del proyecto durante el despliegue.
Práctica. Posibles problemas con el apagado elegante
NGINX
Primero, es útil recordar: además de ejecutar el comando nginx -s quit hay otra etapa a la que vale la pena prestar atención. Hemos enfrentado un problema en el que NGINX, en lugar de enviar la señal SIGQUIT, enviaba SIGTERM, lo que provocaba que las solicitudes no se completaran correctamente. Casos similares se pueden encontrar, por ejemplo, . Desafortunadamente, no pudimos determinar la causa exacta de este comportamiento: había sospechas sobre la versión de NGINX, pero no se confirmaron. La sintomatología consistía en que en los registros del contenedor de NGINX se observaron mensajes "socket abierto #10 dejado en conexión 5", después de lo cual el pod se detenía.
Podemos observar dicho problema, por ejemplo, en las respuestas de nuestro Ingress:
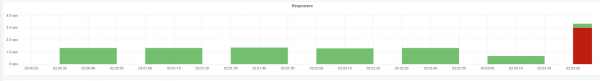
Los indicadores de códigos de estado en el momento del despliegue
En este caso, estamos recibiendo precisamente el código de error 503 del propio Ingress: no puede acceder al contenedor de NGINX, ya que este ya no está disponible. Si miramos los registros del contenedor con NGINX, estos indican lo siguiente:
[alert] 13939#0: *154 socket abierto #3 dejado en conexión 16
[alert] 13939#0: *168 socket abierto #6 dejado en conexión 13
Después de cambiar la señal de detención, el contenedor comienza a detenerse correctamente: esto se confirma por el hecho de que ya no se observa el error 503.
Si te has encontrado con un problema similar, vale la pena averiguar qué señal de detención se utiliza en el contenedor y cómo es exactamente el preStop-hook. Es bastante posible que la causa resida precisamente en esto.
PHP-FPM… y no solo
El problema con PHP-FPM se describe de manera trivial: no espera a que se completen los procesos secundarios, los termina, lo que provoca errores 502 durante el despliegue y otras operaciones. En bugs.php.net desde 2005 hay varios informes de errores (por ejemplo, y ), que describen este problema. Sin embargo, en los registros es probable que no veas nada: PHP-FPM anunciará la finalización de su proceso sin ningún error ni notificaciones externas.
Vale la pena aclarar que el problema en sí puede depender en menor o mayor medida de la propia aplicación y no manifestarse, por ejemplo, en la monitorización. Si te encuentras con él, la primera solución que viene a la mente es un simple workaround: añadir un preStop-hook con sleep(30). Esto permitirá completar todas las solicitudes que se realizaron antes (y no aceptamos nuevas, ya que el pod (envío de datos). está en estado Terminating), y tras 30 segundos el pod se detendrá con la señal SIGTERM.
Resulta que lifecycle para el contenedor se verá de la siguiente manera:
    lifecycle:
      preStop:
        exec:
          command:
          - /bin/sleep
          - "30"
Sin embargo, debido a la indicación de 30 segundos, nos permiten despertar cualquier proceso que necesite el bloqueo que acabamos de liberar: utilizamos significativamente aumentaremos el tiempo de despliegue, ya que cada pod será terminado un mínimo de en 30 segundos, lo cual es malo. ¿Qué se puede hacer al respecto?
Volvamos al lado responsable de la ejecución directa de la aplicación. En nuestro caso, esto es PHP-FPM, quien por defecto, no monitoriza la ejecución de sus procesos secundarios.: el proceso maestro se termina de inmediato. Este comportamiento se puede cambiar a través de la directiva process_control_timeout, que especifica los límites de tiempo para la espera de señales de parte de los procesos secundarios. Si se establece un valor de 20 segundos, esto cubrirá la mayoría de las solicitudes realizadas en el contenedor, y después de que se completen, el proceso maestro será detenido.
Con este conocimiento, volvamos a nuestro último problema. Como se mencionó, Kubernetes no es una plataforma monolítica: la interacción entre sus diferentes componentes requiere cierto tiempo. Esto es especialmente relevante cuando consideramos el funcionamiento de los Ingress y otros componentes relacionados, ya que debido a esta latencia en el momento del despliegue, es fácil experimentar picos de errores 500. Por ejemplo, un error puede ocurrir en la etapa de envío de la solicitud al upstream, pero el 'retraso' en la interacción entre los componentes es bastante corto: menos de un segundo.
Por lo tanto, en conjunto con la ya mencionada directiva, process_control_timeout se puede utilizar la siguiente construcción para lifecycle:
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
En ese caso, compensamos el retraso con el comando nos permiten despertar cualquier proceso que necesite el bloqueo que acabamos de liberar: y no aumentamos significativamente el tiempo de despliegue: ¿acaso no hay una gran diferencia entre 30 segundos y uno?.. De hecho, "el trabajo principal" recae precisamente en process_control_timeout, y lifecycle se utiliza únicamente como "una red de seguridad" en caso de una latencia.
En general, el comportamiento descrito y la solución correspondiente no solo se aplican a PHP-FPM.Una situación similar puede surgir, de una u otra forma, al utilizar otros lenguajes de programación/marcos. Si no se puede resolver el cierre flexible de otra manera —por ejemplo, reescribiendo el código para que la aplicación maneje correctamente las señales de terminación— se puede aplicar el método descrito. Aunque no es el más elegante, funciona.
Práctica. Pruebas de carga para verificar el funcionamiento del pod.
La prueba de carga es una de las formas de comprobar cómo funciona un contenedor, ya que este procedimiento se aproxima a condiciones de operación reales, cuando los usuarios acceden al sitio. Para probar las recomendaciones mencionadas anteriormente, se puede utilizar : cubre todas nuestras necesidades de manera excelente. A continuación se presentan consejos y recomendaciones para llevar a cabo pruebas, acompañadas de ejemplos claros gracias a los gráficos de Grafana y de Yandex.Tank, basados en nuestra experiencia.
Lo más importante aquí es verificar los cambios por etapas. Después de agregar un nuevo ajuste, inicie las pruebas y observe si los resultados han cambiado en comparación con la ejecución anterior. De lo contrario, será difícil identificar soluciones ineficaces, y a largo plazo, incluso podría hacer daño (por ejemplo, aumentar el tiempo de despliegue).
Otro matiz es observar los registros del contenedor durante su terminación. ¿Se registra allí información sobre el cierre ordenado? ¿Hay errores en los registros al acceder a otros recursos (por ejemplo, al contenedor vecino PHP-FPM)? ¿Errores de la propia aplicación (como en el caso mencionado anteriormente con NGINX)? Espero que la información introductoria de este artículo ayude a entender mejor qué ocurre con el contenedor durante su terminación.
Así que, la primera ejecución de la prueba se realizó sin lifecycle y sin directivas adicionales para el servidor de aplicaciones (process_control_timeout en PHP-FPM). El objetivo de esta prueba era identificar el número aproximado de errores (y si existen). También es útil saber que el tiempo medio de despliegue de cada pod era de unos 5-10 segundos hasta alcanzar un estado de plena disponibilidad. Los resultados son los siguientes:
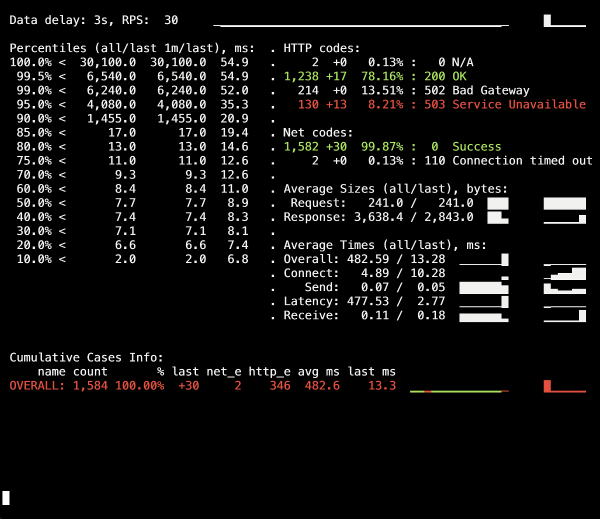
En el panel informativo de Yandex.Tank se observa un pico de errores 502, que ocurrió en el momento del despliegue y duró en promedio hasta 5 segundos. Presumiblemente, esto se debió a que se interrumpieron las solicitudes existentes al antiguo pod durante su terminación. Después de eso, aparecieron errores 503, que fueron el resultado del contenedor NGINX detenido, que también interrumpió las conexiones debido al backend (por lo que Ingress no pudo conectarse).
Veamos cómo process_control_timeout en PHP-FPM nos ayudará a esperar la finalización de los procesos hijos, es decir, a corregir esos errores. Un nuevo despliegue ya utilizando esta directiva:
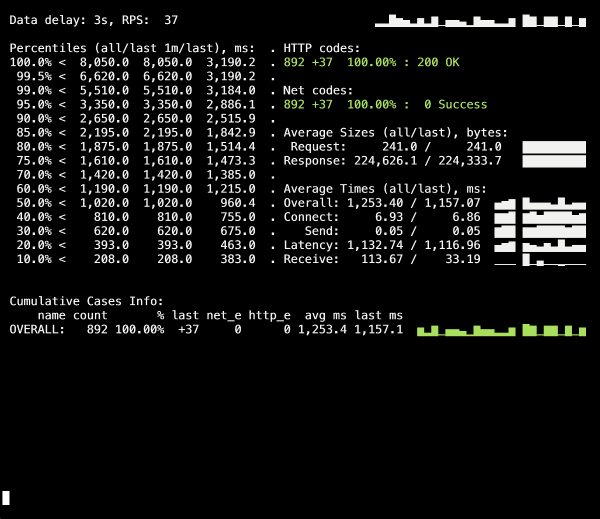
¡Durante el despliegue ya no hay errores 500! El despliegue se realiza correctamente, el apagado ordenado funciona.
Sin embargo, es importante recordar el momento con los contenedores Ingress, un pequeño porcentaje de errores puede surgir debido a retrasos temporales. Para evitarlos, debemos agregar una construcción con nos permiten despertar cualquier proceso que necesite el bloqueo que acabamos de liberar: y repetir el despliegue. Sin embargo, en nuestro caso específico no se observaron cambios (no hay errores nuevamente).
Conclusión
Para concluir correctamente el proceso, esperamos el siguiente comportamiento de la aplicación:
- Esperar unos segundos, después dejar de aceptar nuevas conexiones.
- Esperar a que finalicen todas las solicitudes y cerrar todas las conexiones keepalive que no están procesando solicitudes.
- Finalizar su proceso.
Sin embargo, no todas las aplicaciones saben operar de esta manera. Una de las soluciones al problema en el contexto de Kubernetes es:
- agregar un gancho pre-stop que esperará unos segundos;
- revisar el archivo de configuración de nuestro backend en busca de parámetros relevantes.
El ejemplo con NGINX permite entender que incluso aquella aplicación que originalmente debería manejar señales de finalización correctamente puede no hacerlo, por lo que es crítico verificar la presencia de errores 500 durante el despliegue de la aplicación. Esto también permite abordar el problema de manera más amplia y no centrarse en un solo pod o contenedor, sino observar toda la infraestructura en su conjunto.
Como herramienta de prueba, se puede utilizar Yandex.Tank junto con cualquier sistema de monitoreo (en nuestro caso, los datos se tomaron de Grafana con un backend en forma de Prometheus). Los problemas con el apagado ordenado son evidentes bajo altas cargas que puede generar el benchmark, y el monitoreo ayuda a analizar la situación con mayor detalle durante o después de la prueba.
En respuesta a los comentarios sobre el artículo: hay que señalar que los problemas y las soluciones aquí se describen en relación con NGINX Ingress. Para otros casos, existen soluciones diferentes que, posiblemente, consideraremos en próximos materiales del ciclo.
P.D.
Otra de la serie K8s tips & tricks:
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
