

Las características del funcionamiento de los mecanismos internos de PostgreSQL le permiten ser muy rápido en ciertas situaciones y "no tan rápido" en otras. Hoy nos detendremos en un ejemplo clásico de conflicto entre cómo trabaja el SGBD y lo que hace el desarrollador con él — UPDATE vs principios de MVCC.
Breve resumen de :
Cuando una fila es modificada mediante el comando UPDATE, en realidad se realizan dos operaciones: DELETE e INSERT. En la versión actual de la fila se establece xmax, igual al número de la transacción que realizó el UPDATE. Luego se crea una nueva versión la misma fila; el valor de xmin coincide con el valor de xmax de la versión anterior.
Después de un tiempo, tras la finalización de esta transacción, la vieja o nueva versión, dependiendo de COMMIT/ROLLBACK, serán consideradas "tuplas muertas" (dead tuples) al recorrer VACUUM la tabla y eliminadas.
Pero esto no sucederá de inmediato, y los problemas con los "muertos" pueden acumularse rápidamente — durante una actualización múltiple o en una gran tabla, y poco después enfrentarse a la situación en la que incluso .
#1: I Like To Move It
Supongamos que su método de lógica empresarial está funcionando, y de repente se da cuenta de que sería necesario actualizar el campo X en algún registro:
UPDATE tbl SET X = WHERE pk = $1;Luego, al avanzar en la ejecución, se da cuenta de que también debería actualizar el campo Y:
UPDATE tbl SET Y = WHERE pk = $1;… y luego también Z — ¿por qué no hacer todo?
UPDATE tbl SET Z = WHERE pk = $1;¿Cuántas versiones de este registro tenemos ahora en la base de datos? Ah, 4 en total. De ellas, una es actual, y 3 deberán ser eliminadas por [auto]VACUUM.
¡No lo haga así! Utilice la actualización de todos los campos en una sola consulta — casi siempre se puede modificar la lógica del método de esta manera:
UPDATE tbl SET X = , Y = , Z = WHERE pk = $1;#2: Use IS DISTINCT FROM, Luke!
Entonces, ha decidido (durante la ejecución de un script o convertidor, por ejemplo). Y en el script se introduce algo como esto:
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2;Este tipo de consulta es bastante común y casi siempre no se realiza para llenar un nuevo campo vacío, sino para corregir algún error en los datos. Al hacerlo, la correctitud de los datos ya existentes no se tiene en cuenta — ¡y eso es un error! Es decir, el registro se sobrescribe, incluso si contenía exactamente lo que se quería — ¿y para qué? Corregimos:
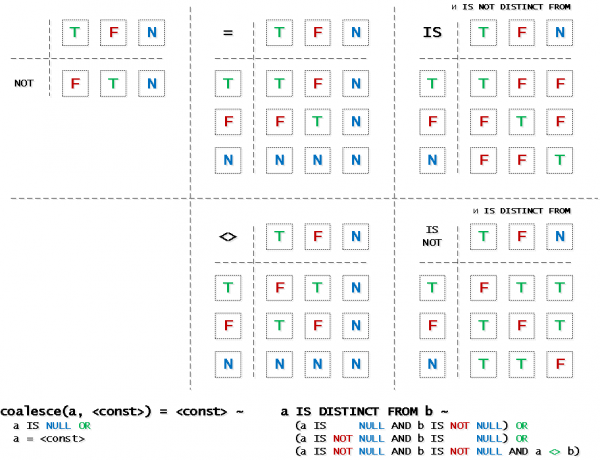
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM ; Muchas personas no son conscientes de la existencia de este maravilloso operador, por lo que aquí hay una guía sobre IS DISTINCT FROM y otros operadores lógicos como ayuda:
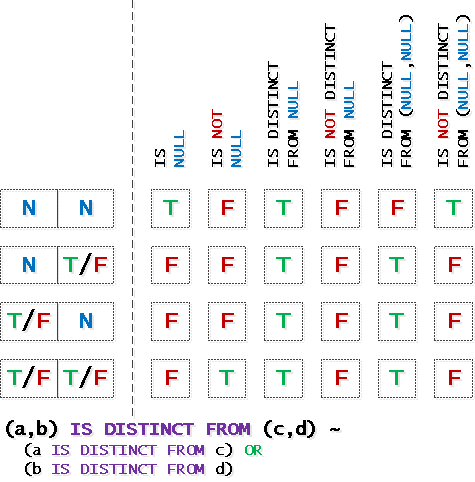
… y un poco sobre operaciones con expresiones complejas: ROW()-expresiones:
#3: А я милого узнаю по… блокировке
Se inician dos procesos paralelos idénticos, cada uno de los cuales intenta marcar el registro como «en proceso»:
UPDATE tbl SET processing = TRUE WHERE pk = $1;Incluso si estos procesos realizan cosas independientes entre sí, pero dentro de un mismo ID, en esta consulta el segundo cliente «se bloqueará» hasta que la primera transacción termine.
Solución nº 1: la tarea se reduce a la anterior
Simplemente añadimos de nuevo IS DISTINCT FROM:
UPDATE tbl SET processing = TRUE WHERE pk = $1 AND processing IS DISTINCT FROM TRUE;De esta manera, la segunda consulta simplemente no cambiará nada en la base de datos, ya que todo ya está «como debería» — por lo que no habrá bloqueo. Luego, el hecho de la «no existencia» del registro se procesará en el algoritmo de aplicación.
Solución nº 2: bloqueos de asesoría
Un tema amplio para un artículo separado, donde se puede leer sobre .
Solución nº 3: llamadas sin sentido
Aquí exactamente debe ocurrir el trabajo simultáneo con el mismo registro? Или вы все-таки накосячили с алгоритмами вызовов бизнес-логики со стороны клиента, например? А если подумать?..
Fuente: habr.com
