

La base de datos analítica ClickHouse procesa una gran variedad de cadenas, consumiendo recursos. Para agilizar el funcionamiento del sistema, se añaden constantemente nuevas optimizaciones. El desarrollador de ClickHouse, Nikolai Kochetov, habla sobre el tipo de datos de cadena, incluido el nuevo tipo, LowCardinality, y explica cómo se puede acelerar el trabajo con cadenas.
— Primero, analicemos cómo se pueden almacenar las cadenas.
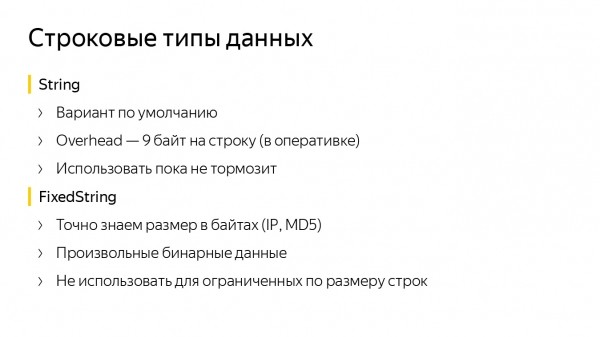
Contamos con tipos de datos de cadena. String es adecuado por defecto y debería usarse casi siempre. Tiene baja sobrecarga: 9 bytes por cada cadena. Si queremos que el tamaño de las cadenas sea fijo y conocido de antemano, es mejor utilizar FixedString. En él, se puede especificar la cantidad de bytes que necesitamos, lo cual es conveniente para datos como direcciones IP o funciones hash.
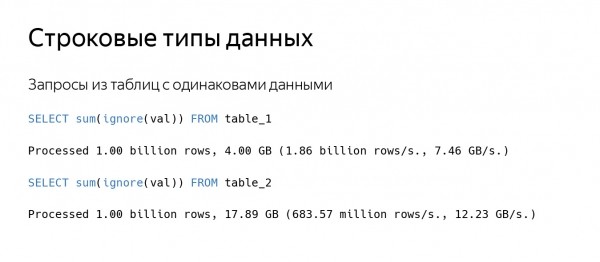
Por supuesto, a veces algo puede ralentizarse. Supongamos que estás haciendo una consulta a una tabla. ClickHouse lee una cantidad bastante grande de datos, digamos, a una velocidad de 100 GB/s, mientras que se procesan pocas cadenas. Tenemos dos tablas que almacenan datos casi idénticos. Desde la segunda tabla, ClickHouse lee datos a una velocidad mayor, pero se leen tres veces menos cadenas por segundo.
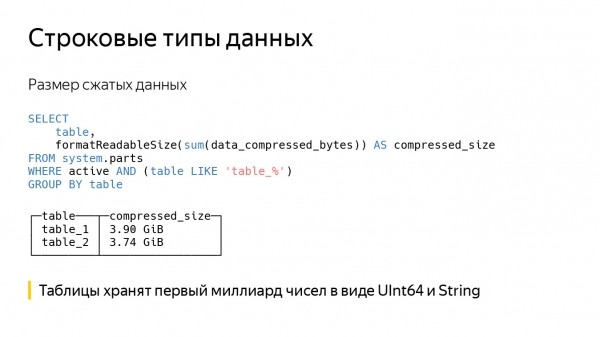
Si observamos el tamaño de los datos comprimidos, resultará ser casi equivalente. De hecho, las tablas contienen los mismos datos: el primer mil millones de números, solo que en la primera columna se almacenan como UInt64 y en la segunda como String. Debido a esto, la segunda consulta tarda más en leer los datos del disco y descomprimirlos.
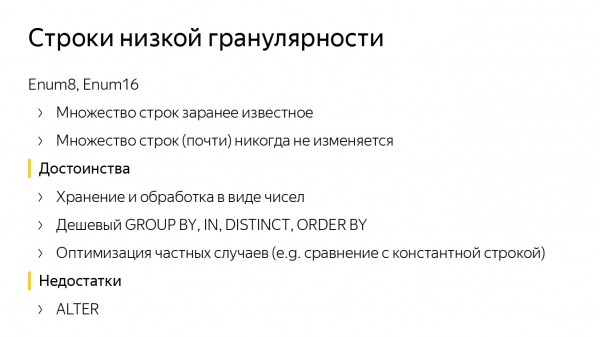
Aquí hay otro ejemplo. Supongamos que hay un conjunto de cadenas conocido de antemano, limitado a una constante de 1000 o 10,000 y que prácticamente nunca cambia. Para este caso, el tipo de datos Enum es adecuado, ya que ClickHouse tiene dos: Enum8 y Enum16. Al almacenar en Enum, procesamos las consultas rápidamente.
En ClickHouse hay optimizaciones para GROUP BY, IN, DISTINCT y mejoras para algunas funciones, como la comparación con una cadena constante. Por supuesto, los números en la cadena no se transforman y, al contrario, la cadena constante se convierte en un valor Enum. Después de eso, todo se compara rápidamente.
Pero también hay desventajas. Incluso si conocemos el conjunto exacto de cadenas, a veces debe ampliarse. Si llega una nueva cadena, debemos hacer ALTER.
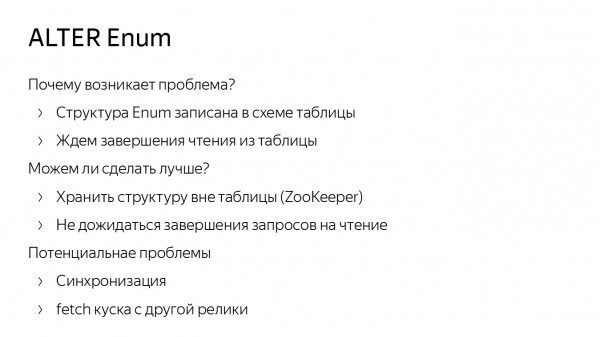
El comando ALTER para Enum en ClickHouse está optimizado. No reescribimos datos en el disco, pero ALTER puede experimentar lentitud debido a que las estructuras Enum se almacenan en el esquema de la tabla misma. Por lo tanto, debemos esperar las consultas de lectura de la tabla, por ejemplo.
Surge la pregunta, ¿se puede hacer mejor? Probablemente sí. Se podría almacenar la estructura Enum no en el esquema de la tabla, sino en ZooKeeper. Sin embargo, pueden surgir problemas relacionados con la sincronización. Por ejemplo, una réplica tiene los datos, la otra no, y si tiene un Enum antiguo, algo puede romperse. (En ClickHouse hemos casi terminado las consultas ALTER no bloqueantes. Cuando las terminemos por completo, no será necesario esperar a las consultas de lectura.)
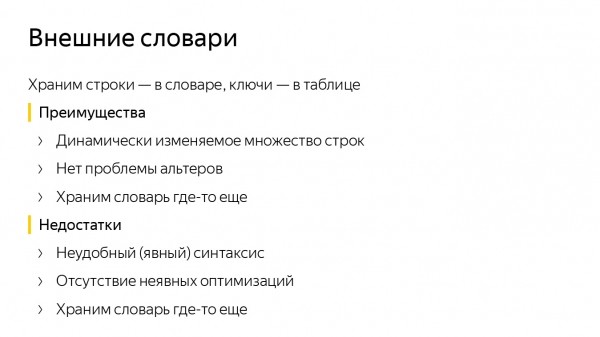
Para evitar lidiar con ALTER Enum, se pueden utilizar diccionarios externos de ClickHouse. Recuerdo que esta es una estructura de datos clave-valor dentro de ClickHouse, a través de la cual se pueden obtener datos de fuentes externas, como tablas MySQL.
En el diccionario de ClickHouse almacenamos muchas cadenas diferentes, y en la tabla, sus identificadores en forma de números. Si necesitamos obtener una cadena, llamamos a la función dictGet y trabajamos con ella. Después de eso, no necesitamos hacer ALTER. Para agregar algo a Enum, lo insertamos en la misma tabla de MySQL.
Pero aquí surgen otros problemas. Primero, la sintaxis incómoda. Si queremos obtener una cadena, debemos llamar a dictGet. En segundo lugar, falta algunas optimizaciones. La comparación con una cadena constante para los diccionarios no se puede hacer tan rápidamente.
También pueden haber problemas con la actualización. Supongamos que solicitamos una cadena en un diccionario en caché, pero no llegó a la caché. Entonces debemos esperar hasta que se carguen los datos de la fuente externa.
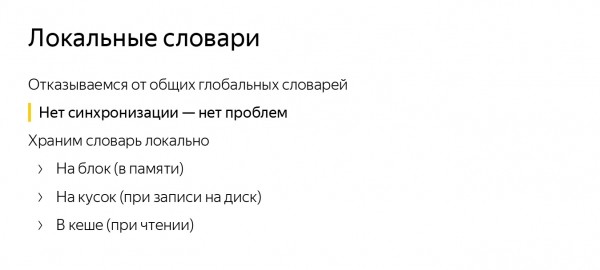
La desventaja común de ambos métodos es que almacenamos todas las claves en un solo lugar y las sincronizamos. Entonces, ¿por qué no almacenar los diccionarios localmente? Sin sincronización, no hay problemas. Se puede almacenar un diccionario localmente en un trozo en el disco. Es decir, hicimos un Insert, grabamos el diccionario. Si trabajamos con datos en memoria, podemos almacenar el diccionario ya sea en un bloque de datos, o en un fragmento de columna, o en algún caché, para acelerar los cálculos.
Codificación de cadenas por diccionario
Así llegamos a la creación de un nuevo tipo de datos en ClickHouse — LowCardinality. Este es un formato de almacenamiento de datos: cómo se escriben en disco y cómo se leen, cómo se representan en memoria y el esquema de su procesamiento.
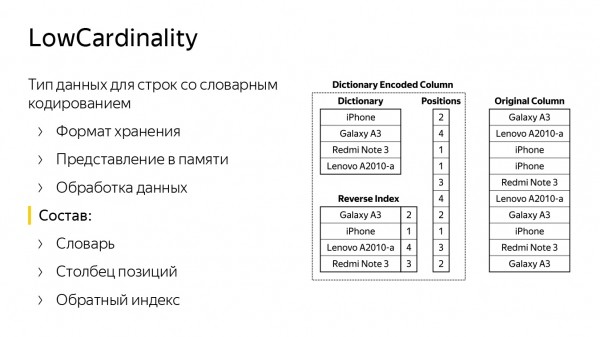
En la diapositiva hay dos columnas. A la derecha, las filas se almacenan de manera estándar, en el tipo String. Se puede ver que son modelos de teléfonos móviles. A la izquierda hay una columna exactamente igual, pero en el tipo LowCardinality. Consiste en un diccionario con muchas cadenas diferentes (cadenas de la columna de la derecha) y una lista de posiciones (números de fila).
Con estas dos estructuras se puede reconstruir la columna original. También hay un índice inverso, una tabla hash que ayuda a encontrar la posición en el diccionario a partir de la cadena. Se necesita para acelerar algunas consultas. Por ejemplo, si queremos comparar, buscar una cadena en nuestra columna o fusionarlas.
LowCardinality es un tipo de dato paramétrico. Puede ser un número, o algo que se almacena como un número, o una cadena, o Nullable de estos.
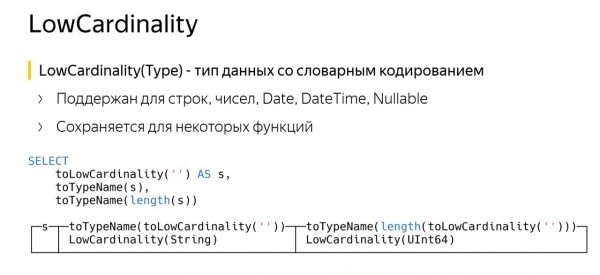
La peculiaridad de LowCardinality es que puede almacenarse para algunas funciones. En la diapositiva se ve un ejemplo de consulta. En la primera línea, creé una columna del tipo LowCardinality de String y la llamé S. Luego pregunté su nombre; ClickHouse dijo que era LowCardinality de String. Todo correcto.
La tercera línea es casi igual, solo que llamamos a la función length. En ClickHouse, la función length devuelve el tipo de dato UInt64. Pero ahora se convirtió en LowCardinality de UInt64. ¿Cuál es el sentido?
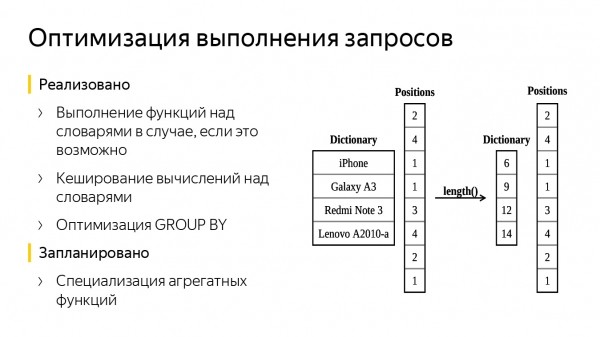
En el diccionario se almacenaban los nombres de teléfonos móviles; aplicamos la función length. Ahora tenemos un diccionario equivalente, compuesto solo de números, que son las longitudes de las cadenas. La columna con posiciones no cambió. Al final, procesamos menos datos, ahorramos tiempo de consulta.
Puede haber otras optimizaciones, como el agregado de una caché simple. Al calcular el valor de una función, se puede recordar y crear uno igual, sin necesidad de recalcularlo.
También se puede optimizar el GROUP BY, porque nuestra columna con el diccionario ya está parcialmente agregada: se pueden calcular más rápidamente los valores de las funciones hash y encontrar aproximadamente el bucket donde colocar la siguiente fila. Además, se pueden especializar algunas funciones agregadas, como uniq, ya que solo se puede enviar un diccionario y dejar las posiciones intactas; así todo funcionará más rápido. Ya hemos agregado las dos primeras optimizaciones en ClickHouse.
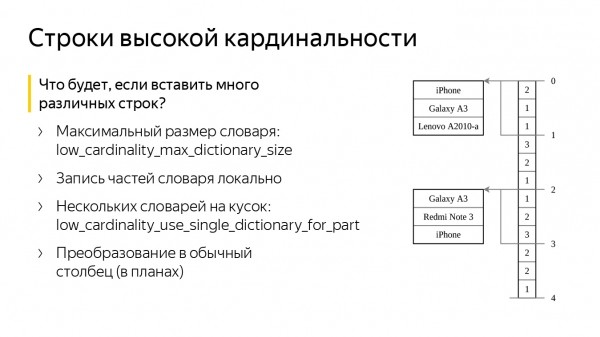
¿Y si creamos una columna con nuestro tipo de datos e insertamos muchas cadenas incorrectas diferentes? ¿No se desbordará nuestra memoria? No, para eso ClickHouse tiene dos configuraciones especiales. La primera es low_cardinality_max_dictionary_size. Este es el tamaño máximo del diccionario que se puede escribir en el disco. La inserción ocurre de la siguiente manera: cuando insertamos datos, recibimos un flujo de cadenas, de las cuales formamos un gran diccionario común. Si el diccionario se vuelve más grande que el valor de la configuración, escribimos el diccionario actual en el disco, y las otras cadenas las dejamos “a un lado”, junto a los índices. Como resultado, nunca volveremos a contar el gran diccionario y no tendremos problemas de memoria.
La segunda configuración se llama low_cardinality_use_single_dictionary_for_part. Imagina que en el esquema anterior, cuando insertamos los datos, nuestro diccionario se desbordó y lo escribimos en el disco. Surge la pregunta, ¿por qué no formar ahora otro diccionario exactamente igual?
Cuando se desborde, lo escribiremos de nuevo en el disco y comenzaremos a formar el tercero. Esta configuración desactiva precisamente esa posibilidad por defecto.
En realidad, tener muchos diccionarios puede ser útil si queremos insertar un conjunto de cadenas, pero accidentalmente insertamos ‘basura’. Digamos que primero insertamos cadenas malas, y luego insertamos buenas. Entonces, el diccionario se dividirá en muchos diccionarios pequeños. Algunos de ellos contendrán ‘basura’, pero los últimos tendrán cadenas buenas. Y si leemos, digamos, solo la última porción, funcionará rápido.
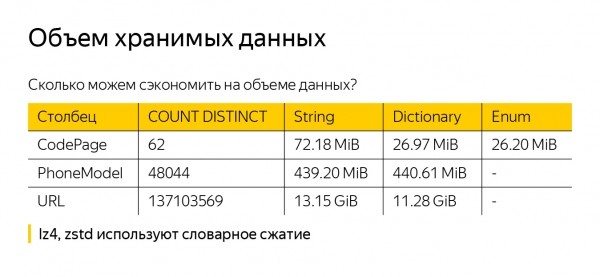
Antes de hablar sobre las ventajas de LowCardinality, debo decir que es poco probable que logremos reducir los datos en el disco (aunque puede suceder), porque ClickHouse comprime los datos. Hay una opción por defecto: LZ4. También se puede hacer la compresión con ZSTD. Pero ambos algoritmos ya implementan la compresión de diccionario, por lo que nuestro diccionario externo en ClickHouse no será de gran ayuda.
Para no quedarme en palabras, tomé algunos datos de la métrica — String, LowCardinality(String) y Enum — y los guardé en diferentes tipos de datos. Resultaron en tres columnas, donde se registraron mil millones de filas. En la primera columna, CodePage, solo hay 62 valores. Y es evidente que en LowCardinality(String) se comprimieron mejor. String un poco peor, pero esto probablemente se debe a que las cadenas son cortas, almacenamos sus longitudes, y ocupan mucho espacio, se comprimen mal.
Si tomamos PhoneModel, hay 48,000 — ya más, y las diferencias entre String y LowCardinality(String) prácticamente no existen. Para URL también solo ahorramos 2 GB — creo que no vale la pena confiar en eso.
Evaluación de la velocidad de trabajo
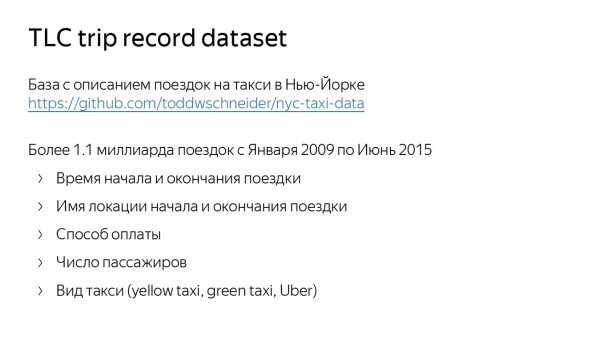
Ahora evaluemos la velocidad de trabajo. Para ello, utilicé un conjunto de datos que describe los viajes en taxi en Nueva York. Este está en GitHub. Contiene poco más de mil millones de viajes. Ahí se reflejan la ubicación, el tiempo de inicio y fin del viaje, el método de pago, el número de pasajeros e incluso el tipo de taxi — verde, amarillo y Uber.
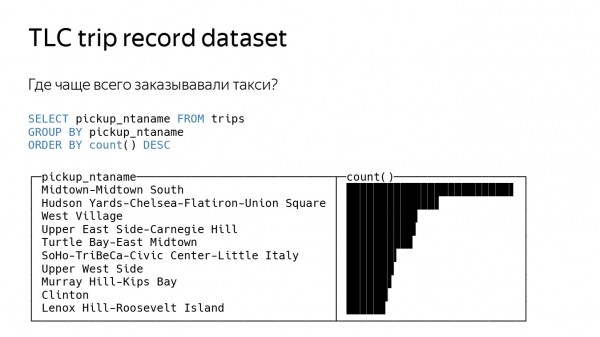
Hice la primera consulta bastante simple — pregunté dónde se solicita más frecuentemente un taxi. Para ello, necesitas tomar la ubicación desde donde se solicitó, hacer un GROUP BY sobre ella y contar usando la función count. Aquí ClickHouse da algún resultado.
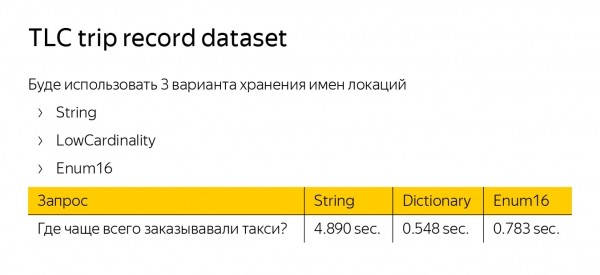
Para medir la velocidad de procesamiento de la consulta, creé tres tablas con los mismos datos, pero utilicé tres tipos de datos diferentes para nuestra ubicación inicial — String, LowCardinality y Enum. LowCardinality y Enum resultaron ser cinco veces más rápidos que String. Enum es más rápido porque trabaja con números. LowCardinality porque implementa una optimización GROUP BY.
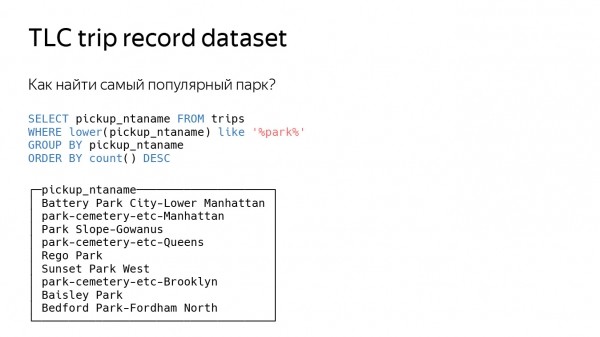
Complicamos aún más la consulta — preguntamos dónde se encuentra el parque más popular en Nueva York. Nuevamente, lo mediremos por dónde se piden más taxis, pero filtraremos solo aquellas ubicaciones que contienen la palabra "parque". También añadiremos la función like.
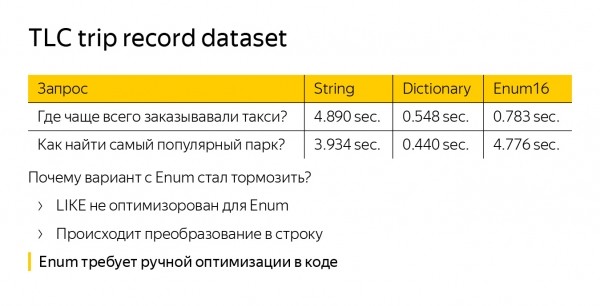
Observamos el tiempo — vemos que Enum de repente comenzó a ralentizarse. Además, funciona aún más lento que el tipo de dato estándar String. Esto ocurre porque la función like no está optimizada para Enum. Nos vemos obligados a convertir nuestras cadenas de Enum a cadenas normales — estamos haciendo más trabajo. LowCardinality(String) tampoco está optimizado por defecto, pero allí like funciona sobre el diccionario, por lo tanto, la consulta se acelera en comparación con String.
Al trabajar con Enum, existe un problema más global. Si queremos optimizarlo, debemos hacerlo en cada parte del código. Supongamos que hemos escrito una nueva función; es necesario pensar en la optimización para Enum. En cambio, en LowCardinality, todo está optimizado por defecto.
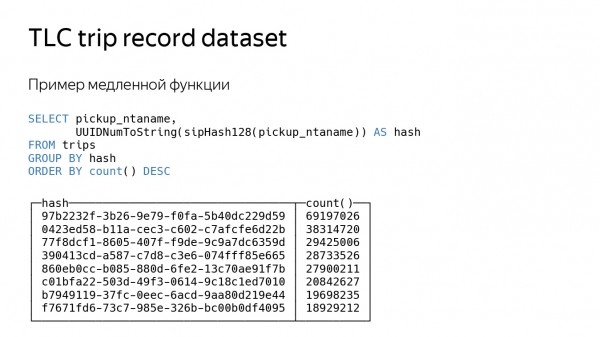
Veamos la última consulta, que es más artificial. Simplemente calcularemos la función hash de nuestra ubicación. La función hash es una consulta bastante lenta y se tarda en procesarse, por lo que todo se retrasará en un factor de tres.
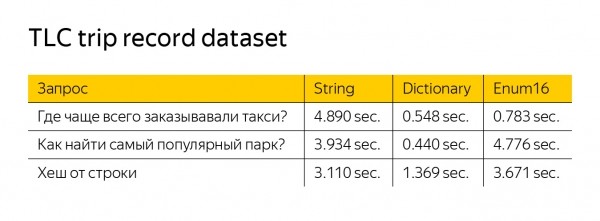
LowCardinality sigue funcionando más rápido, aunque aquí no hay filtrado. Esto se debe a que nuestras funciones trabajan únicamente sobre el diccionario. La función de cálculo de hash tiene un argumento; puede procesar menos datos y también puede devolver LowCardinality.
Nuestro plan global es alcanzar una velocidad de operación no inferior a la de String en todos los casos y mantener las optimizaciones. Y tal vez algún día reemplacemos String por LowCardinality, actualizarás ClickHouse y todo funcionará un poco más rápido.
Fuente: habr.com
