

Esta nota será interesante para quienes utilizan la biblioteca de procesamiento de datos tabulares para R — data.table, y posiblemente se alegren de ver la flexibilidad de su aplicación en diversos ejemplos.
Inspirado por un buen ejemplo , y esperando que ya haya leído su artículo, propongo profundizar en la optimización del código y el rendimiento basado en data.table.
Introducción: ¿de dónde viene data.table?
Lo mejor es comenzar a conocer la biblioteca un poco desde lejos, es decir, desde las estructuras de datos de las cuales puede derivarse un objeto data.table (en adelante, DT).
Arreglo
Código
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Una de estas estructuras es el array (?base::array). Al igual que en otros lenguajes, los arrays aquí son multidimensionales. Sin embargo, lo interesante es que, por ejemplo, un array bidimensional comienza a heredar propiedades de la clase matriz (?base::matrix), mientras que un array unidimensional, lo cual también es importante, no hereda de un vector (?base::vector).
Es necesario entender que el tipo de datos contenidos en algún objeto debe ser verificado con la función base::typeof, que devuelve la descripción interna del tipo de acuerdo a R Internals — el protocolo general del lenguaje relacionado con lo primitivo C.
Otro comando para determinar la clase de un objeto, base::class, devuelve en el caso de vectores el tipo vectorial (que tiene un nombre diferente al interno, pero también permite entender el tipo de datos).
Lista
De un array bidimensional, o sea, una matriz, se puede pasar a una lista (?base::list).
Código
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Al mismo tiempo, ocurren varias cosas a la vez:
- Se colapsa la segunda dimensión de la matriz, es decir, obtenemos simultáneamente tanto una lista como un vector.
- La lista, de este modo, hereda de estas clases. Hay que tener en cuenta que a cada elemento de la lista le corresponderá un único valor (escalar) de la celda de la matriz-array.
Gracias a que la lista también es un vector, se pueden aplicar algunas funciones para vectores.
Dataframe
De una lista, matriz o vector se puede pasar a un dataframe (?base::data.frame).
Código
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Lo interesante de él es que el dataframe hereda de la lista. Las columnas del dataframe son celdas de la lista. Esto será importante más adelante, cuando utilicemos funciones aplicables a listas.
data.table
Obtener DT (?data.table::data.table) es posible desde un dataframe, lista, vector o matriz. Por ejemplo, así (in place).
Código
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Es útil que, al igual que el dataframe, DT hereda propiedades de la lista.
DT y memoria
A diferencia de todos los demás objetos en R base, los DT se pasan por referencia. Si es necesario hacer una copia en un nuevo espacio de memoria, se necesita la función data.table::copy o es necesario hacer una selección del objeto antiguo.
Código
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Con esto, la introducción llega a su fin. Los DT son una continuación del desarrollo de estructuras de datos en R, que se lleva a cabo principalmente mediante la ampliación y aceleración de las operaciones realizadas sobre objetos de clase data.frame. Al mismo tiempo, se mantiene la herencia de otros primitivos.
Algunos ejemplos de uso de las propiedades de data.table
Como lista…
Iterar sobre las filas de un data.frame o DT no es la mejor idea, ya que el código de bucle en el lenguaje R es considerablemente más lento C, pero recorrer en bucle las columnas, que suelen ser mucho menos numerosas, es del todo posible. Al ir por las columnas, recordamos que cada columna es un elemento de la lista, que generalmente contiene un vector. Las operaciones sobre vectores están bien vectorizadas en las funciones básicas del lenguaje. También se pueden utilizar operadores de selección propios de listas y vectores: `[[`, `$`.
Código
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vectorización
Si es necesario recorrer las filas de un gran DT, la mejor solución será escribir una función con vectorización. Pero si eso no es posible, hay que recordar que el ciclo dentro DT sigue siendo más rápido que el ciclo en R, ya que se ejecuta en C.
Probemos con un ejemplo más grande con 100K filas. Extraeremos la primera letra de las palabras que forman la columna vectorial w.
Actualizado
Código
library(magrittr)
library(microbenchmark)

## Ejemplo más grande ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorización

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# segundo

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# tercero

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Primera ejecución con iteración sobre las filas:
Unidad: milisegundos
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
El segundo enfoque, donde la vectorización se lleva a cabo al convertir una lista en una matriz y tomar elementos del corte con un índice de 1 (lo último es realmente la vectorización). Me corregiré: la vectorización a nivel de función strsplit, que puede aceptar un vector como entrada. Resulta que el procedimiento de convertir una lista en una matriz es mucho más pesado que la propia vectorización, pero en este caso también es mucho más rápido que la versión no vectorizada.
Unidad: milisegundos
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Aceleración por mediana en 3 veces.
El tercer enfoque, donde se ha alterado el esquema de conversión a matriz.
Unidad: milisegundos
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Aceleración por mediana en 13 veces.
Es necesario experimentar con esto, cuanto más, mejor será.
Otro ejemplo de vectorización, donde también hay texto, pero se acerca a las condiciones reales: longitud variable de palabras, número variable de palabras. Se requiere extraer las primeras 3 palabras. Así es como:
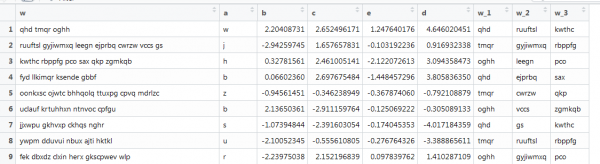
Aquí ya la función anterior no funciona, ya que los vectores son de diferente longitud, y establecimos el tamaño de la matriz. Lo reharé, investigando en internet.
Código
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Unidad: milisegundos
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
El script funcionó a una velocidad promedio de 1 segundo. No está mal.
Conectados en una cadena…
Se puede trabajar con objetos DT utilizando chaining. Se presenta como la adición de la sintaxis de paréntesis a la derecha, en esencia, es un azúcar sintáctico.
Código
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Fluyendo a través de las tuberías…
Las mismas operaciones se pueden realizar a través de piping; se ve similar, pero funcionalmente más rico, ya que se pueden utilizar cualquier método, no solo DT. Mostraremos los coeficientes de regresión logística para nuestros datos sintéticos con una serie de filtros en DT.
Código
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Estadísticas, aprendizaje automático y más dentro de DT
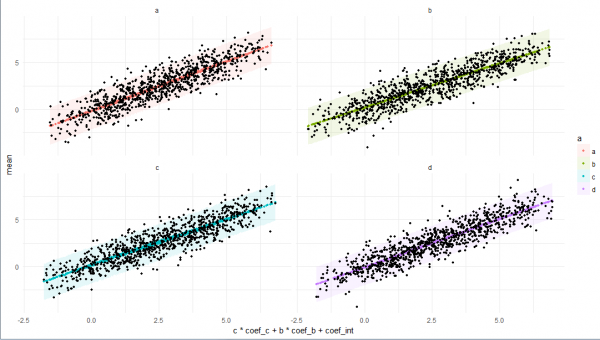
Se pueden usar funciones lambda, pero a veces es mejor crear las por separado, describir todo el pipeline de análisis de datos, y adelante, funcionan dentro de DT. El ejemplo está enriquecido con todas las características mencionadas anteriormente, más algunas cosas útiles del arsenal de DT (como el acceso a DT desde dentro de DT a través de un enlace, insertadas a veces no de manera secuencial, pero para que haya).
Código
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Conclusión
Espero haber creado un panorama completo, aunque por supuesto no exhaustivo, de un objeto como data.table, comenzando por sus propiedades relacionadas con la herencia de las clases de R y terminando con sus propias características y el entorno de los elementos de tidyverse. Espero que esto te ayude a estudiar y aplicar mejor esta biblioteca para trabajo y entretenimiento.
¡Gracias!
Código completo
Código
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Fuente: habr.com
