

En el procesamiento complejo de grandes conjuntos de datos (diferentes : importaciones, conversiones y sincronizaciones con fuentes externas) a menudo surge la necesidad de «recordar» temporalmente y procesar rápidamente algo voluminoso.
Una tarea típica de este tipo suele plantearse de la siguiente manera: «Aquí la los últimos pagos recibidos, hay que cargarlos rápidamente en el sitio y vincularlos a las cuentas»
Sin embargo, cuando el volumen de este «algo» comienza a medirse en cientos de megabytes, y el servicio debe seguir funcionando con la base de datos en modo 24×7, surgen numerosos efectos secundarios que complicarán su vida.
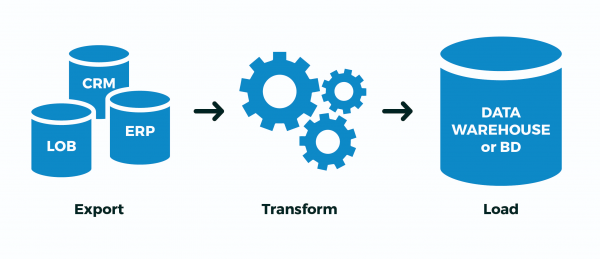
Para hacer frente a ellos en PostgreSQL (y no solo en él), se pueden utilizar algunas funciones de optimización que permitirán procesar todo más rápido y con menos recursos.
1. ¿Dónde cargar?
Primero, determinemos dónde podemos volcar los datos que queremos «procesar».
1.1. Tablas temporales (TEMPORARY TABLE)
En principio, para PostgreSQL, las tablas temporales son iguales a cualquier otra tabla. Por lo tanto, son incorrectos los prejuicios como «allí todo se almacena solo en la memoria, y esta puede agotarse». Pero también hay algunas diferencias importantes.
Su propio «espacio de nombres» para cada conexión a la BD
Si dos conexiones intentan ejecutar simultáneamente CREATE TABLE x, entonces alguien definitivamente obtendrá un error de no unicidad de los objetos de la BD.
Pero si ambos intentan ejecutar CREAR TEMPORARIO TABLA x, entonces ambos lo harán correctamente, y cada uno obtendrá su propia instancia de la tabla. Y no habrá nada en común entre ellas.
«Autodestrucción» al desconectarse
Al cerrar la conexión, todas las tablas temporales se eliminan automáticamente, por lo que no tiene sentido ejecutar manualmente DROP TABLE x , salvo…
Si trabaja a través de pgbouncer en modo de transacción, entonces la base todavía considera que esta conexión sigue activa, y en él, esta tabla temporal sigue existiendo.
Por lo tanto, intentar crearla de nuevo, ya desde otra conexión a pgbouncer, conducirá a un error. Pero se puede eludir esto utilizando CREAR TABLA TEMPORAL SI NO EXISTE x.
Sin embargo, es mejor no hacerlo, porque entonces puede «descubrir repentinamente» datos que quedan de «el propietario anterior». En su lugar, es mucho mejor leer el manual y ver que al crear la tabla hay una opción para añadir EN COMPROMISO ELIMINAR — es decir, al finalizar la transacción, la tabla será eliminada automáticamente.
No-replicación
Debido a que pertenece solo a una conexión específica, las tablas temporales no se replican. Sin embargo, esto elimina la necesidad de escribir dos veces los datos en heap + WAL, por lo que INSERT/UPDATE/DELETE en ella es significativamente más rápido.
Pero dado que la temporal es, al fin y al cabo, una tabla 'casi normal', no se puede crear en la réplica tampoco. Al menos, por ahora, aunque ya hay un parche correspondiente circulando.
1.2. Tablas no registradas (UNLOGGED TABLE)
Pero, ¿qué hacer si, por ejemplo, tiene un proceso ETL voluminoso que no se puede realizar dentro de una única transacción, y usted sigue teniendo pgbouncer en modo de transacción?..
O si el flujo de datos es tan grande que la capacidad de un solo enlace a la base de datos no es suficiente (es decir, un proceso por CPU)?.. ¿O algunas de las operaciones se realizan
de forma asincrónica en diferentes conexiones?.. Aquí solo hay una opción —
crear temporalmente una tabla no temporal . Un juego de palabras, sí. Es decir:creó 'sus' tablas con nombres lo más aleatorios posible para no cruzarse con nadie
- Extract
- : cargué en ellas los datos de una fuente externaTransform
- : transformé, llené los campos de unión clave: vertí los datos preparados en las tablas de destino
- Cargareliminé las 'mis' tablas
- Y ahora — la cucharada de ceniza. De hecho,
toda la escritura en PostgreSQL ocurre dos veces primero en WAL — 'transacciones internas' y COMMIT'transacciones externas'. ROLLBACK¡Pero eso no lo necesitamos! Todo nuestro proceso
o se completó exitosamente o no. . No importa cuántas transacciones intermedias haya; no nos interesa 'continuar el proceso desde la mitad', especialmente cuando no está claro dónde estaba.Para esto, los desarrolladores de PostgreSQL implementaron en la versión 9.1 algo como
tablas no registradas (UNLOGGED) :
funcionen mucho más rápido que las normales. Sin embargo, no están protegidas contra fallos; en caso de fallo o apagado inesperado del servidor, la tabla no registradase corta automáticamente. Además, el contenido de la tabla no registradano se replica. не реплицируется en servidores esclavos. Cualquier índice creado para una tabla no registrada se convierte automáticamente en no registrado.
En resumen, será mucho más rápido, pero si el servidor DB "cae", será un problema. Pero, ¿tan a menudo sucede eso, y puede su proceso ETL ajustarse correctamente "desde el medio" después de la "resurrección" de la DB?..
Si no es así, y el caso anterior se parece al suyo, utilice UNLOGGED, pero nunca active este atributo en tablas reales, cuyos datos le importan.
1.3. ON COMMIT { DELETE ROWS | DROP }
Esta construcción permite al crear la tabla definir un comportamiento automático al finalizar la transacción.
Sobre EN COMPROMISO ELIMINAR ya lo mencioné arriba, genera DROP TABLE, pero con EN COMPROMISO ELIMINAR FILAS la situación es más interesante: aquí se genera TRUNCATE TABLE.
Dado que toda la infraestructura de almacenamiento de la meta descripción de la tabla temporal es exactamente la misma que la de la normal, la creación y eliminación constante de tablas temporales lleva a un "inflado" significativo de las tablas del sistema pg_class, pg_attribute, pg_attrdef, pg_depend,…
Ahora imagine que tiene un trabajador en una conexión directa con la DB, que cada segundo abre una nueva transacción, crea, llena, procesa y elimina una tabla temporal... Habrá acumulación de basura en las tablas del sistema, lo que generará retrasos en cada operación.
En resumen, ¡no haga eso! En este caso, es mucho más eficiente CREATE TEMPORARY TABLE x ... ON COMMIT DELETE ROWS sacar fuera del ciclo de transacciones: así, al inicio de cada nueva transacción, la tabla ya existirá (ahorramos la llamada CREAR), pero estará vacía, gracias a TRUNCATE (también ahorramos su llamada) al finalizar la transacción anterior.
1.4. LIKE… INCLUDING …
Mencioné al principio que uno de los casos de uso típicos para tablas temporales son diversos tipos de importaciones, y el desarrollador está cansado de copiar y pegar la lista de campos de la tabla de destino en la declaración de su temporal...
¡Pero la pereza es el motor del progreso! Por eso crear una nueva tabla "a partir de un patrón" se puede hacer mucho más fácil:
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Dado que se pueden generar muchos datos en esta tabla, las búsquedas en ella no serán rápidas en absoluto. Pero existe una solución tradicional: ¡índices! Y, sí, las tablas temporales también pueden tener índices..
Dado que, a menudo, los índices necesarios coinciden con los índices de la tabla de destino, simplemente se puede escribir COMO target_table INCLUYENDO ÍNDICES.
Si también necesita DEFAULT-valores (por ejemplo, para completar los valores de la clave primaria), se puede utilizar COMO target_table INCLUYENDO LOS VALORES POR DEFECTO. O simplemente — COMO target_table INCLUYENDO TODO — copiará los valores predeterminados, índices, restricciones,…
Pero aquí ya hay que entender que si has creado la tabla de importación directamente con índices, los datos tardarán más en insertarse, que si primero insertas todo y luego aplicas los índices; mira como lo hace .
En general, !
2. ¿Cómo escribir?
Diré simplemente — utiliza -flujo en lugar de "lote" INSERTAR, . Se puede incluso directamente desde un archivo previamente formado.
3. ¿Cómo procesar?
Así que, supongamos que nuestra entrada se ve aproximadamente así:
- tienes en la base una tabla con los datos de los clientes con 1M registros
- cada día el cliente te envía un nuevo "conjunto completo"
- por experiencia sabes que de vez en cuando cambia no más de 10K registros
Un ejemplo clásico de una situación así es — hay muchos direcciones, pero en cada volcado semanal de cambios (cambios de nombres de localidades, fusiones de calles, aparición de nuevos edificios) hay muy pocos incluso a escala nacional.
3.1. Algoritmo de sincronización completa
Para simplificar, supongamos que ni siquiera necesitas reestructurar los datos — solo llevar la tabla al formato adecuado, es decir:
- eliminar todo lo que ya no existe
- Las opciones para procesadores «Elbrus» están disponibles mediante todo lo que ya existía y necesita ser actualizado
- insertar todo lo que aún no existía
¿Por qué exactamente en este orden hay que realizar las operaciones? Porque de esta forma el tamaño de la tabla crecerá de manera mínima ().
DELETE FROM dst
No, por supuesto se puede hacer solo con dos operaciones:
- eliminar (
ELIMINAR) todo - insertar todo del nuevo conjunto
Pero al mismo tiempo, gracias al MVCC, el tamaño de la tabla aumentará exactamente el doble! Obtener +1M de registros en la tabla debido a la actualización de 10K — no es una sobrecarga deseable…
TRUNCATE dst
Un desarrollador más experimentado sabe que se puede limpiar toda la tabla de manera bastante económica:
- clear (
TRUNCATE) toda la tabla - insertar todo del nuevo conjunto
El método es efectivo, , pero hay un problema… Ingresar 1M de registros va a llevar muuuuucho tiempo, así que no podemos permitirnos dejar la tabla vacía todo este tiempo (como sucederá sin envolver en una transacción única).
Así que:
- comenzamos una transacción larga
TRUNCATEimpone AccessExclusive-bloqueo- tardamos en hacer la inserción, y todos los demás en este tiempo no pueden ni siquiera
SELECCIONAR
Algo está saliendo mal…
ALTER TABLE… RENAME… / DROP TABLE …
Una opción es cargar todo en una nueva tabla y luego simplemente renombrarla para reemplazar la antigua. Un par de detalles molestos:
- también AccessExclusive, aunque en un tiempo significativamente menor
- se restablecerán todos los planes de consultas/estadísticas de esta tabla,
- se romperán todas las claves externas (FK) en la tabla
Hubo un parche WIP de Simon Riggs, que proponía hacer ALTER-una operación para reemplazar el cuerpo de la tabla a nivel de archivo, sin tocar la estadística y las FK, pero no logró suficiente apoyo.
DELETE, UPDATE, INSERT
Así que nos quedamos con la opción no bloqueante de tres operaciones. Casi tres... ¿Cómo hacerlo de la manera más eficiente?
-- todo se realiza dentro de una transacción, para que nadie vea "estados intermedios"
BEGIN;

-- creamos una tabla temporal con los datos importados
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- a semejanza, junto con índices
) ON COMMIT DROP; -- fuera de la transacción no la necesitamos

-- rápidamente vertemos la nueva imagen mediante COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- eliminamos los ausentes
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- campos de la clave primaria
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "anti-join"

-- actualizamos los restantes
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- no es necesario actualizar coincidencias

-- insertamos los ausentes
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Postprocesamiento de la importación
En el mismo KLR, todos los registros modificados deben pasar por un postprocesamiento adicional: normalizar, extraer palabras clave, llevar a las estructuras necesarias. Pero, ¿cómo saber — qué exactamente se modificó, sin complicar el código de sincronización, idealmente, sin tocarlo en absoluto?
Si el acceso de escritura en el momento de la sincronización solo está disponible para su proceso, se puede utilizar un trigger que recopile todos los cambios para nosotros:
-- tablas objetivo
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tablas con historial de cambios
CREATE TABLE kladr$log(
  ro kladr, -- aquí están las imágenes completas de los registros antiguos/nuevos
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- función general para registrar cambios
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- verificar la necesidad de registrar al actualizar un registro
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- crear registro del log
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Ahora podemos aplicar (o activar mediante ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
Luego, extraemos tranquilamente todos los cambios que necesitamos de las tablas de log y los procesamos con manejadores adicionales.
3.3. Importación de conjuntos relacionados
Anteriormente, discutimos los casos en los que las estructuras de datos de la fuente y el receptor coinciden. Pero, ¿qué hacer si la descarga desde un sistema externo tiene un formato diferente de la estructura de almacenamiento en nuestra base?
Tomemos como ejemplo el almacenamiento de clientes y sus facturas, un caso clásico de "muchos a uno":
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
Y esta es la extracción de una fuente externa presentada como "todo en uno":
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Es obvio que los datos de los clientes pueden duplicarse en este formato, y el registro principal es "la factura":
0123456789;Vasya;A-01;2020-03-16;1000.00
9876543210;Petya;A-02;2020-03-16;666.00
0123456789;Vasya;B-03;2020-03-16;9999.00
Para el modelo simplemente insertaremos nuestros datos de prueba, pero recordemos — COPY ¡más eficiente!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Vasya', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petya', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Vasya', 'B-03', '2020-03-16', 9999.00);
Primero identificaremos esos "segmentos" a los que nuestros "hechos" hacen referencia. En nuestro caso, las facturas hacen referencia a los clientes:
CREAR UNA TABLA TEMPORAL client_import COMO
SELECCIONAR DISTINTO ON(client_inn)
-- se puede simplemente usar SELECT DISTINCT, si los datos son claramente no contradictorios
  client_inn inn
, client_name "name"
DE
  invoice_import;
Para vincular correctamente las facturas con los ID de los clientes, primero necesitamos conocer o generar esos identificadores. Agregaremos campos para ellos:
ALTER TABLE invoice_import ADD COLUMN client_id integer;
ALTER TABLE client_import ADD COLUMN client_id integer;
Usaremos el método de sincronización de tablas descrito anteriormente con una pequeña modificación: no actualizaremos ni eliminaremos nada en la tabla de destino, ya que la importación de clientes es «append-only»:
-- asignamos en la tabla de importación ID de registros ya existentes
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  client D
WHERE
  T.inn = D.inn; -- clave única

-- insertamos registros faltantes y asignamos sus ID
WITH ins AS (
  INSERT INTO client(
    inn
  , name
  )
  SELECT
    inn
  , name
  FROM
    client_import
  WHERE
    client_id IS NULL -- si no se asignó el ID
  RETURNING *
)
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  ins D
WHERE
  T.inn = D.inn; -- clave única

-- asignamos ID de clientes a los registros de facturas
UPDATE
  invoice_import T
SET
  client_id = D.client_id
FROM
  client_import D
WHERE
  T.client_inn = D.inn; -- clave aplicativa
Eso es todo; en invoice_import ahora tenemos el campo de relación lleno client_id, con el que insertaremos la factura.
Fuente: habr.com
