

Uno de los casos de uso más comunes en todas nuestras aplicaciones habituales es la búsqueda de datos según ciertos criterios y su presentación en un formato legible. Aquí también pueden haber opciones adicionales para ordenamiento, agrupamiento y paginación. La tarea, en teoría, es trivial, pero en su resolución, muchos desarrolladores cometen una serie de errores que luego afectan el rendimiento. Intentaremos examinar varias alternativas para resolver esta tarea y formular recomendaciones sobre la elección de la implementación más eficiente.
Opción de paginación #1
La opción más sencilla que se nos ocurre es la paginación de los resultados de búsqueda en su forma más clásica.
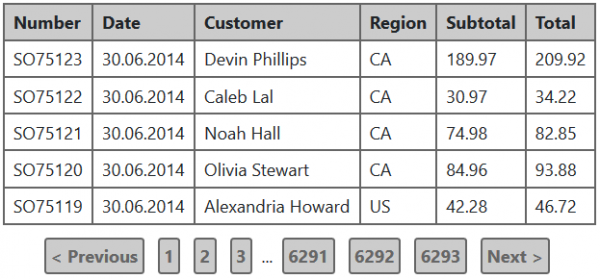
Supongamos que en la aplicación se utiliza una base de datos relacional. En este caso, para mostrar la información de esta manera, será necesario realizar dos consultas SQL:
- Obtener las filas de la página actual.
- Contar el número total de filas que cumplen con los criterios de búsqueda; esto es necesario para mostrar las páginas.
Consideremos la primera consulta utilizando una base de datos de prueba de MS SQL para SQL Server 2016. Para este propósito, utilizaremos la tabla Sales.SalesOrderHeader:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
La consulta anterior mostrará los primeros 50 pedidos de la lista, ordenados por fecha de adición en orden descendente, en otras palabras, los 50 últimos pedidos.
Se ejecuta rápidamente en la base de datos de prueba, pero veamos el plan de ejecución y las estadísticas de entrada/salida:
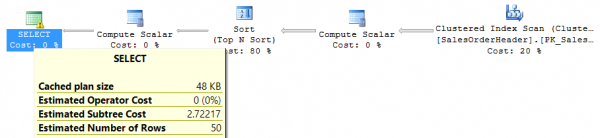
Tabla 'SalesOrderHeader'. Conteo de escaneos 1, lecturas lógicas 698, lecturas físicas 0, lecturas anticipadas 0, lecturas lob lógicas 0, lecturas lob físicas 0, lecturas lob anticipadas 0.Se puede obtener estadísticas de entrada/salida para cada consulta ejecutando en el entorno de ejecución el comando SET STATISTICS IO ON.
Como se puede ver en el plan de ejecución, la operación más intensiva en recursos es la clasificación de todas las filas de la tabla original por fecha de adición. Y el problema es que cuanto más filas haya en la tabla, más 'pesada' será la clasificación. En la práctica, hay que evitar tales situaciones, por lo que agregaremos un índice en la fecha de adición y veremos si ha cambiado el consumo de recursos:
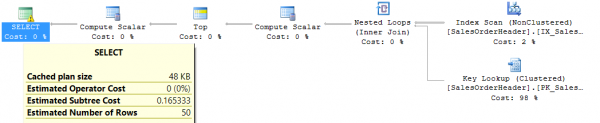
Tabla 'SalesOrderHeader'. Conteo de escaneos 1, lecturas lógicas 165, lecturas físicas 0, lecturas anticipadas 5, lecturas lob lógicas 0, lecturas lob físicas 0, lecturas lob anticipadas 0.
Es evidente que ha mejorado mucho. Pero, ¿se han resuelto todos los problemas? Cambiemos la consulta para buscar pedidos donde el costo total de los productos supere los 100 dólares:
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
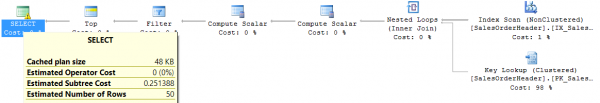
Tabla 'SalesOrderHeader'. Conteo de escaneos 1, lecturas lógicas 1081, lecturas físicas 0, lecturas anticipadas 0, lecturas lógicas lob 0, lecturas físicas lob 0, lecturas anticipadas lob 0.Nos encontramos en una situación curiosa: el plan de consulta no es mucho peor que el anterior, pero el número real de lecturas lógicas es casi el doble que al realizar un escaneo completo de la tabla. Hay una salida: si convertimos el índice existente en uno compuesto y añadimos como segundo campo el precio total de los productos, obtendremos nuevamente 165 lecturas lógicas:
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Esta serie de ejemplos se puede continuar por mucho tiempo, pero hay dos ideas principales que quiero expresar aquí:
- Agregar cualquier nuevo criterio o orden de clasificación a la consulta puede afectar significativamente la velocidad de ejecución.
- Pero si solo necesitamos restar una parte de los datos, y no todos los resultados que cumplen con las condiciones de búsqueda, hay muchas formas de optimizar esa consulta.
Ahora pasemos a la segunda consulta mencionada al principio, aquella que cuenta la cantidad de registros que cumplen con el criterio de búsqueda. Tomemos el mismo ejemplo: buscar pedidos que costen más de 100 dólares:
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
Con el índice compuesto mencionado anteriormente, obtenemos:
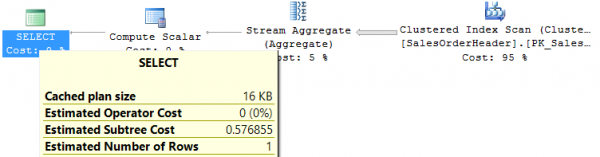
Tabla 'SalesOrderHeader'. Conteo de escaneos 1, lecturas lógicas 698, lecturas físicas 0, lecturas anticipadas 0, lecturas lob lógicas 0, lecturas lob físicas 0, lecturas lob anticipadas 0.Que la consulta recorra todo el índice entero no es sorprendente, ya que el campo SubTotal no está en la primera posición, por lo que la consulta no puede beneficiarse de ello. El problema se resuelve añadiendo otro índice al campo SubTotal, lo que al final da solo 48 lecturas lógicas.
Se pueden dar más ejemplos de consultas para contar cantidades, pero la esencia seguirá siendo la misma: obtener un lote de datos y contar el total son dos consultas esencialmente diferentes, y cada uno requiere sus propias medidas para la optimización. En general, no se puede encontrar una combinación de índices que funcione igual de bien para ambas consultas.
Por lo tanto, uno de los requisitos importantes que debe clarificarse al desarrollar una solución de búsqueda de este tipo es si para el negocio es realmente relevante conocer el número total de objetos encontrados. A menudo no lo es. Y la navegación a través de números de página específicos, en mi opinión, es una solución con un ámbito de aplicación muy limitado, ya que la mayoría de los escenarios de paginación se asemejan a "ir a la siguiente página".
Opción de paginación #2
Supongamos que a los usuarios no les importa conocer el número total de objetos encontrados. Intentemos simplificar la página de búsqueda:
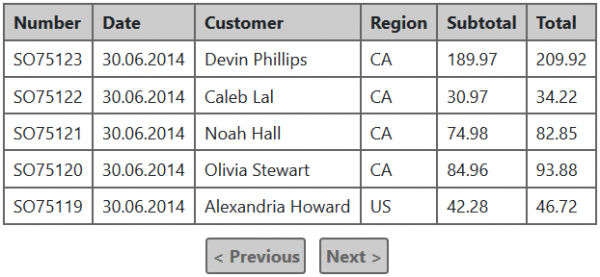
De hecho, solo ha cambiado que no hay posibilidad de navegar a números de página específicos, y ahora esta tabla para mostrar no necesita conocer cuántas en total podría haber. Pero surge la pregunta: ¿cómo sabrá la tabla si hay datos para la siguiente página (para mostrar correctamente el enlace "Siguiente")?
La respuesta es muy simple: se puede leer de la base de datos una entrada más de la que es necesaria para mostrar, y la existencia de esta "entrada adicional" indicará si hay un lote siguiente. Así, para obtener una página de datos, solo se tendrá que realizar una consulta, lo que mejora considerablemente el rendimiento y facilita el mantenimiento de esta funcionalidad. En mi experiencia, hubo un caso en el que renunciar al conteo total de registros aceleró la entrega de resultados entre 4 y 5 veces.
Para este enfoque, existen varias opciones de interfaz de usuario: comandos de "anterior" y "siguiente", como en el ejemplo anterior, un botón de "cargar más", que simplemente añade un nuevo lote a los resultados mostrados, y "desplazamiento infinito", que funciona de manera similar a "cargar más", pero la señal para obtener el siguiente lote es que el usuario desplaza todos los resultados mostrados hasta el final. Cualquiera que sea la solución visual, el principio de muestreo de datos permanece igual.
Matices de la implementación de la paginación
En todos los ejemplos de solicitudes mencionados anteriormente, se utiliza el enfoque de "desplazamiento + cantidad", donde en la propia solicitud se indica desde qué fila del resultado y cuántas filas se deben devolver. Primero, veamos cómo organizar mejor la transmisión de parámetros en este caso. En la práctica, he encontrado varios métodos:
- Número de orden de la página solicitada (pageIndex), tamaño de la página (pageSize).
- Número de orden del primer registro que se debe devolver (startIndex), número máximo de registros en el resultado (count).
- Número de orden del primer registro que se debe devolver (startIndex), número de orden del último registro que se debe devolver (endIndex).
A primera vista, puede parecer tan elemental que no hay diferencia. Pero no es así: la opción más conveniente y universal es la segunda (startIndex, count). Hay varias razones para esto:
- Para el enfoque de leer +1 registro, el primer formato con pageIndex y pageSize es extremadamente incómodo. Por ejemplo, queremos mostrar 50 registros en una página. Según el algoritmo anterior, se debe leer una entrada más de lo necesario. Si este ‘+1’ no está incorporado en el servidor, resulta que para la primera página debemos solicitar registros del 1 al 51, para la segunda del 51 al 101, etc. Si se especifica un tamaño de página de 51 y se incrementa pageIndex, entonces la segunda página devolverá del 52 al 102, y así sucesivamente. Por lo tanto, en el primer formato, la única forma de implementar correctamente el botón de pasar a la siguiente página es incluir la lectura de una ‘línea extra’ en el servidor, lo cual será un matiz muy implícito.
- El tercer formato no tiene sentido en absoluto, ya que para realizar las consultas en la mayoría de las bases de datos, aún se debe pasar la cantidad, no el índice del último registro. Aunque restar startIndex de endIndex es una operación aritmética básica, aquí resulta innecesaria.
Ahora es necesario describir las desventajas de implementar la paginación a través de ‘desplazamiento + cantidad’:
- Obtener cada página siguiente será más costoso y lento que la anterior, porque la base de datos aún necesitará recorrer todos los registros ‘desde el principio’ de acuerdo con los criterios de búsqueda y ordenación, y luego detenerse en el fragmento necesario.
- No todas las bases de datos pueden soportar este enfoque.
Existen alternativas, pero también tienen sus defectos. El primer enfoque de este tipo se llama ‘paginación por conjunto de clave’ o ‘método de búsqueda’ y consiste en lo siguiente: después de obtener un lote, se pueden recordar los valores de los campos en el último registro de la página, y luego usarlos para obtener el siguiente lote. Por ejemplo, realizamos una consulta así:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Y en la última entrada obtuvimos el valor de la fecha del pedido '2014-06-29'. Entonces, para obtener la siguiente página, podríamos intentar realizar lo siguiente:
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
El problema es que OrderDate no es un campo único y la condición mencionada anteriormente es muy probable que omita muchas filas necesarias. Para agregar claridad a esta consulta, es necesario añadir un campo único a la condición (supongamos que 75074 es el último valor de la clave primaria del primer lote):
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Esta opción funcionará correctamente, pero en general será difícil de optimizar, ya que la condición contiene el operador OR. Si con el aumento de OrderDate también aumenta el valor de la clave primaria, entonces la condición se puede simplificar, dejando solo el filtro por SalesOrderID. Pero si no hay una correlación estricta entre los valores de la clave primaria y el campo por el cual se ordena el resultado, en la mayoría de las bases de datos no se podrá evitar este OR. Una excepción conocida para mí es PostgreSQL, que admite completamente la comparación de tuplas, y la condición mencionada anteriormente se puede escribir como 'WHERE (OrderDate, SalesOrderID) < ('2014-06-29', 75074)'. Con una clave compuesta que incluya estos dos campos, tal consulta debería ser bastante ligera.
Un segundo enfoque alternativo puede encontrarse, por ejemplo, en o — cuando la consulta, además de los datos, devuelve un identificador especial, con el cual se puede obtener la siguiente porción de datos. Si este identificador tiene una duración ilimitada (como en Cosmos DB), entonces es una excelente manera de implementar paginación con transición secuencial entre páginas (la opción #2 mencionada anteriormente). Sus posibles desventajas: no se admite en todas las bases de datos; el identificador obtenido para la siguiente porción puede tener una duración limitada, lo que en general no es adecuado para la interacción con el usuario (como en el caso de ElasticSearch scroll API).
Filtración compleja
Complicamos aún más la tarea. Supongamos que surge la necesidad de implementar lo que se conoce como búsqueda facetada, bien conocida por todos en las tiendas en línea. Los ejemplos anteriores basados en la tabla de pedidos no son muy representativos en este caso, así que cambiemos a la tabla Product de la base de datos AdventureWorks:
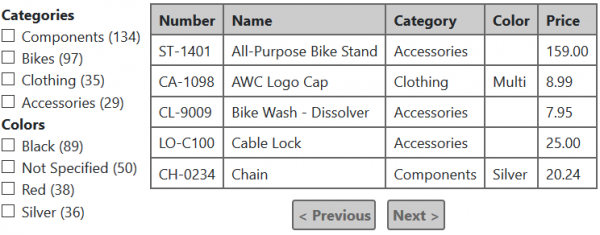
¿Cuál es la idea de la búsqueda facetada? Que para cada elemento del filtro se muestre la cantidad de registros que corresponden a ese criterio. teniendo en cuenta los filtros seleccionados en todas las demás categorías..
Por ejemplo, si elegimos en este caso la categoría Bikes y el color Black, la tabla mostrará solo bicicletas de color negro, pero además:
- Para cada criterio del grupo 'Categories', se mostrará el número de productos de esa categoría de color negro.
- Para cada criterio del grupo 'Colors', se mostrará el número de bicicletas de ese color.
Aquí hay un ejemplo de salida de resultados para tales condiciones:
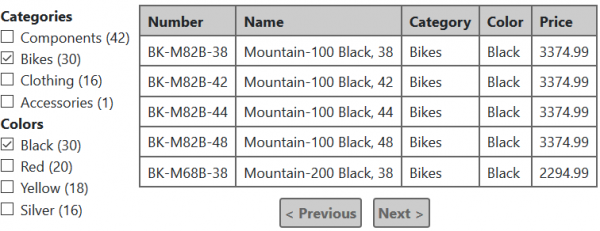
Si además marcamos la categoría 'Clothing', la tabla mostrará también ropa de color negro que está disponible. La cantidad de productos de color negro en la sección 'Color' también se recalculará según las nuevas condiciones, pero nada cambiará en la sección 'Categories'... Espero que estos ejemplos sean suficientes para entender el algoritmo habitual del funcionamiento de la búsqueda facetada.
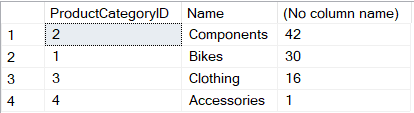
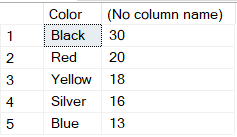
Ahora imaginemos cómo se podría implementar esto en una base de datos relacional. Cada grupo de criterios, como Category y Color, requerirá una consulta separada:
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bikes
GROUP BY Color
ORDER BY COUNT(1) DESC
¿Qué está mal con esta solución? Muy simple: no escala bien. Cada sección del filtro requiere una consulta separada para contar cantidades y estas consultas no son las más ligeras. En las tiendas en línea, algunas categorías pueden tener varias decenas de secciones de filtro, lo que puede convertirse en un problema serio para el rendimiento.
Normalmente, después de estas afirmaciones, me proponen algunas soluciones, a saber:
- Combinar todos los conteos en una sola consulta. Técnicamente, esto es posible con la palabra clave UNION, pero en términos de rendimiento no ayudará mucho; la base de datos aún tendrá que ejecutar cada uno de los fragmentos "desde cero".
- Cachear los conteos. Esto es algo que me sugieren prácticamente cada vez que describo el problema. La cuestión es que esto no es generalmente posible. Supongamos que tenemos 10 "facetas", cada una con 5 valores. Esta es una situación muy "modesta" en comparación con lo que se puede ver en las mismas tiendas en línea. La elección de un elemento de faceta afecta a los conteos en las 9 restantes; en otras palabras, para cada combinación de criterios, los conteos pueden ser diferentes. En total, en nuestro ejemplo hay 50 criterios que el usuario puede seleccionar, lo que significa que habrá 250 combinaciones posibles. No hay suficiente memoria ni tiempo para llenar tal matriz de datos. Aquí se podría argumentar que no todas las combinaciones son reales y que el usuario rara vez selecciona más de 5-10 criterios. Sí, se puede implementar una carga perezosa y caché de conteos solo para lo que alguna vez se ha seleccionado, pero cuanto más opciones haya, menos efectivo será dicho caché y más evidentes serán los problemas de tiempo de respuesta (especialmente si el conjunto de datos cambia regularmente).
Afortunadamente, este tipo de problema ya tiene soluciones bastante efectivas que funcionan de manera predecible en grandes volúmenes de datos. Para cualquiera de estas opciones, tiene sentido dividir el recálculo de facetas y la obtención de la página de resultados en dos llamadas paralelas al servidor y organizar la interfaz de usuario de tal manera que la carga de datos de las facetas "no interfiera" con la visualización de los resultados de búsqueda.
- Llamar al recálculo completo de los "facetas" lo menos posible. Por ejemplo, en lugar de recalcular todo cada vez que se cambian los criterios de búsqueda, se puede encontrar el número total de resultados que cumplen con las condiciones actuales y ofrecer al usuario mostrarlos: "Se encontraron 1425 registros, ¿mostrar?" El usuario puede continuar cambiando los criterios de búsqueda o presionar el botón "mostrar". Solo en este segundo caso se ejecutarán todas las solicitudes para obtener resultados y recalcular las cantidades en todas las "facetas". Como es fácil de notar, esto implica lidiar con la solicitud para obtener el número total de resultados y su optimización. Este método se puede encontrar en muchas pequeñas tiendas en línea. Es evidente que no es una panacea para este problema, pero en casos simples puede ser un buen compromiso.
- Utilizar motores de búsqueda para encontrar resultados y contar facetas, como Solr, ElasticSearch, Sphinx y otros. Todos ellos están diseñados para construir "facetas" y lo hacen de manera bastante eficiente gracias al índice invertido. Cómo están configurados los motores de búsqueda, por qué son más efectivos en estos casos que las bases de datos de propósito general, cuáles son las prácticas y los escollos, es un tema para un artículo aparte. Aquí quiero señalar que el motor de búsqueda no puede reemplazar el almacenamiento de datos principal, se utiliza como complemento: cualquier cambio en la base de datos principal que sea relevante para la búsqueda se sincroniza en el índice de búsqueda; el mecanismo de búsqueda interacciona generalmente solo con el motor de búsqueda y no consulta la base de datos principal. Uno de los puntos más importantes aquí es cómo organizar esta sincronización de manera confiable. Todo depende de los requisitos de "tiempo de respuesta". Si el tiempo entre el cambio en la base de datos principal y su "manifestación" en la búsqueda no es crítico, se puede hacer un servicio que busque registros recientemente cambiados e indexe cada pocos minutos. Si se requiere el tiempo de respuesta más corto posible, se puede implementar algo como para enviar actualizaciones al servicio de búsqueda.
Conclusiones
- La implementación de paginación en el servidor es una complicación seria, y su uso solo tiene sentido para conjuntos de datos que crecen rápidamente o que son simplemente grandes. No hay una receta absolutamente precisa para evaluar si algo es "grande" o "de rápido crecimiento", pero me adheriría a este enfoque:
- Si la obtención de la colección completa de datos, teniendo en cuenta el tiempo del servidor y la transmisión a través de la red, se ajusta a los requisitos de rendimiento, no tiene sentido implementar paginación en el servidor.
- Puede haber situaciones en las que no se prevean problemas de rendimiento en el corto plazo, ya que hay pocos datos, pero la colección de datos está creciendo constantemente. Si algún conjunto de datos puede dejar de cumplir con el punto anterior en el futuro, es mejor implementar la paginación desde el principio.
- Si no hay un requisito estricto del negocio para mostrar el número total de resultados o para mostrar los números de página, y además su sistema no tiene un motor de búsqueda, es mejor no implementar estos aspectos y considerar la opción #2.
- Si existe un requisito claro para la búsqueda facetada, usted tiene dos opciones para no sacrificar el rendimiento:
- No recalcular todas las cantidades en cada cambio de criterio de búsqueda.
- Utilizar motores de búsqueda como Solr, ElasticSearch, Sphinx y otros. Pero debe entenderse que no puede ser un sustituto de la base de datos principal y debe usarse como complemento del almacenamiento principal para resolver tareas de búsqueda.
- Además, en el caso de la búsqueda facetada, tiene sentido dividir la obtención de la página de resultados de búsqueda y el conteo de cantidades en dos solicitudes paralelas. El conteo de cantidades puede llevar más tiempo que la obtención de resultados, mientras que estos últimos son más importantes para el usuario.
- Si utiliza una base de datos SQL para la búsqueda, cualquier cambio de código relacionado con esta parte debe probarse cuidadosamente en relación con el rendimiento en un volumen de datos adecuado (que supere el volumen en la base "en vivo"). También se recomienda usar un monitoreo del tiempo de ejecución de las consultas en todas las instancias de la base de datos, y especialmente en la "en vivo". Incluso si en la fase de desarrollo los planes de consultas funcionaban bien, a medida que aumenta el volumen de datos, la situación puede cambiar notablemente.
Fuente: habr.com
