

Hoy hablaremos de una tecnología interesante implementada en el sistema de almacenamiento Unity/Unity XT: FAST VP. Si es la primera vez que escucha sobre Unity, puede consultar las especificaciones del sistema en el enlace al final del artículo. En el equipo de proyecto de Dell EMC, trabajé en FAST VP durante más de un año. Hoy quiero hablar sobre esta tecnología en detalle y revelar algunos aspectos de su implementación. Por supuesto, solo aquellos que se pueden compartir. Si le interesan cuestiones relacionadas con el almacenamiento eficiente de datos o simplemente no ha comprendido completamente la documentación, este artículo le será muy útil e interesante.
Primero aclararé lo que no se incluirá en este material. No habrá búsqueda de competidores ni comparación con ellos. Además, no planeo hablar sobre tecnologías similares de código abierto, porque el lector curioso ya está al tanto de ellas. Y, por supuesto, no tengo intención de hacer ninguna promoción.
Almacenamiento en capas. Objetivos y tareas de FAST VP
FAST VP se traduce como Fully Automated Storage Tiering for Virtual Pool. ¿Parece complicado? No se preocupe, ahora lo explicaremos. Tiering es una forma de organizar el almacenamiento de datos donde existen varios niveles (tiers) en los que se almacenan los datos. Cada nivel tiene sus propias características. Las más importantes son: rendimiento, capacidad y costo de almacenamiento por unidad de información. Por supuesto, existe una relación entre ellos.
Una característica importante del tiering es que el acceso a los datos se proporciona de manera uniforme sin importar en qué nivel de almacenamiento se encuentren en ese momento, y el tamaño del grupo es igual a la suma de los tamaños de los recursos que lo componen. Aquí es donde se diferencia del caché: el tamaño del caché no se suma al volumen total del recurso (grupo en este caso), y los datos del caché duplican algún fragmento de datos del medio principal (o lo harán si los datos del caché aún no se han grabado). Además, la distribución de datos entre niveles está oculta para el usuario. Es decir, no ve qué datos están en cada nivel, aunque puede influir de manera indirecta al establecer políticas (de las cuales hablaremos más adelante).
Ahora observaremos las características de la implementación del almacenamiento en capas en Unity. En Unity se distinguen 3 niveles o tiers:
- Rendimiento extremo (SSDs)
- Rendimiento (SAS HDD 10k/15k RPM)
- Capacidad (NL-SAS HDD 7200 RPM)
Se presentan en orden descendente de rendimiento y precio. En el Extreme performance solo se incluyen unidades de estado sólido (SSD). En los otros dos niveles, hay discos duros magnéticos que se diferencian por la velocidad de rotación y, en consecuencia, por el rendimiento.
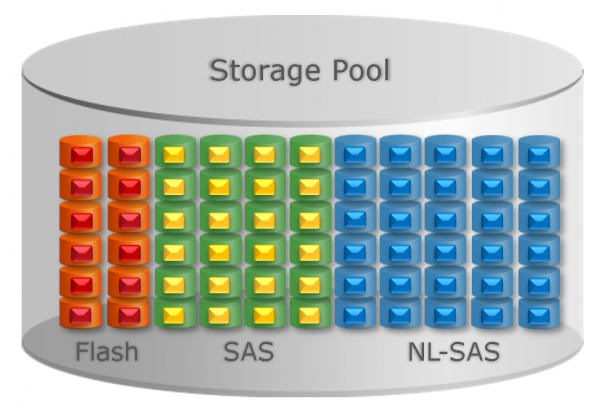
Los dispositivos de un mismo nivel y tamaño se agrupan en un arreglo RAID, formando un grupo RAID (RAID group, abreviado como RG); sobre los niveles RAID disponibles y recomendados, se puede leer en la documentación oficial. A partir de los grupos RAID de uno o varios niveles, se crean grupos de almacenamiento (Storage pool), de los cuales se distribuye el espacio libre. Y del grupo se asigna espacio a los sistemas de archivos y LUNs.
¿Y para qué necesito el Tiering?
En resumen y de manera abstracta: para lograr un mayor resultado utilizando la mínima cantidad de recursos. Si se es más específico, el resultado generalmente se refiere a un conjunto de características de la SAN: velocidad y tiempo de acceso, costo de almacenamiento, entre otros. Por mínima cantidad de recursos se entiende el menor gasto: de dinero, energía, etc. FAST VP implementa precisamente los mecanismos de redistribución de datos a través de diferentes niveles en la SAN Unity/Unity XT. Si me crees, puedes saltar al siguiente párrafo. Para los demás, explicaré un poco más.
La distribución adecuada de datos por niveles de almacenamiento permite ahorrar en el costo total de la SAN, sacrificando la velocidad de acceso a cierta información poco utilizada y aumentando el rendimiento al mover datos de uso frecuente a soportes más rápidos. Aquí alguien podría objetar que incluso sin el tiering un administrador competente sabe dónde colocar qué datos, qué características de la SAN son deseables para su tarea, etc. Sin duda, así es, pero la distribución de datos "manualmente" tiene sus desventajas:
- requiere tiempo y atención del administrador;
- no siempre es posible "reconfigurar" los recursos de la SAN bajo condiciones cambiantes;
- se pierde una ventaja importante: el acceso unificado a recursos que se encuentran en diferentes niveles de almacenamiento.
Para que los administradores de almacenamiento se sientan más seguros sobre su estabilidad laboral, añadiré que una planificación adecuada de los recursos también es necesaria aquí. Ahora que hemos delineado brevemente las tareas de tiering, veamos qué se puede esperar de FAST VP. Es momento de volver a la definición. Las primeras dos palabras – Fully Automated – se traducen como "completamente automatizado" y significan que la distribución por niveles ocurre automáticamente. Y el Virtual Pool es un grupo de datos que incluye recursos de diferentes niveles de almacenamiento. Así es como se ve:
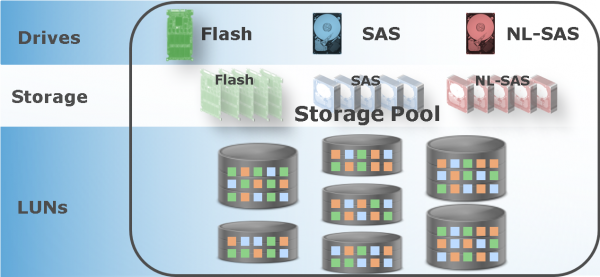
Anticipándome, diré que FAST VP mueve datos solo dentro de un único pool, no entre varios pools.
Tareas que resuelve FAST VP
Primero hablemos de forma abstracta. Tenemos un pool y un mecanismo que puede redistribuir datos dentro de ese pool. Teniendo en cuenta que nuestra tarea es lograr el máximo rendimiento, planteemos la pregunta: ¿de qué maneras se puede lograr? Puede haber varias, y aquí FAST VP tiene mucho que ofrecer al usuario, ya que la tecnología es algo más que solo tiering de almacenamiento. Así es como FAST VP puede aumentar el rendimiento del pool:
- Distribución de datos entre diferentes tipos de discos, niveles
- Distribución de datos entre discos del mismo tipo
- Distribución de datos al expandir el pool
Antes de analizar cómo se resuelven estas tareas, necesitamos conocer algunos hechos necesarios sobre el funcionamiento de FAST VP. FAST VP opera con bloques de un tamaño específico – 256 megabytes. Este es el "trozo" continuo mínimo de datos que puede ser movido. En la documentación, se le llama así: slice. Desde la perspectiva de FAST VP, todos los grupos RAID consisten en un conjunto de tales "trozos". Por lo tanto, todas las estadísticas de entrada y salida se acumulan para estos bloques de datos. ¿Por qué se eligió precisamente este tamaño de bloque y se reducirá? El bloque es lo suficientemente grande, pero es un compromiso entre la granularidad de los datos (un tamaño de bloque más pequeño permite una distribución más precisa) y los recursos computacionales disponibles: con las restricciones vigentes en la memoria RAM y el gran número de bloques, las estadísticas de datos pueden ocupar demasiado, y la cantidad de cálculos aumentará proporcionalmente.
Cómo FAST VP coloca datos en el pool. Políticas
Para gestionar la ubicación de los datos en un grupo con FAST VP habilitado, existen las siguientes políticas:
- Nivel Más Alto Disponible
- Auto-Tier
- Comenzar Alto y luego Auto-Tier (por defecto)
- Nivel Más Bajo Disponible
Afectan tanto la ubicación inicial del bloque (cuando se escriben los datos por primera vez) como la redistribución posterior. Una vez que los datos se han ubicado en los discos, la redistribución se iniciará según un horario o manualmente.
El Nivel Más Alto Disponible intenta colocar un nuevo bloque en el nivel más eficiente. Si no hay suficiente espacio, se ubicará en el siguiente nivel por rendimiento, pero después los datos pueden ser trasladados a un nivel más eficiente (si hay espacio disponible o desplazando otros datos). Auto-Tier coloca nuevos datos en diferentes niveles según el tamaño del espacio disponible, y se redistribuyen según la demanda y el espacio libre. Comenzar Alto y luego Auto-Tier es la política predeterminada y también recomendada. Durante la ubicación inicial, actúa como el Nivel Más Alto Disponible, y luego los datos se trasladan según sus estadísticas de uso. La política de Nivel Más Bajo Disponible busca colocar los datos en el nivel menos eficiente.
El traslado de datos se lleva a cabo con baja prioridad para no interferir con el funcionamiento útil del sistema de almacenamiento, sin embargo, hay una configuración denominada "tasa de reubicación de datos" que cambia la prioridad. Aquí hay una particularidad: no todos los bloques de datos tienen la misma prioridad de redistribución. Por ejemplo, los bloques marcados como metadatos se trasladarán a un nivel más rápido primero. Los metadatos son, por así decirlo, "datos sobre datos", una información adicional que no forma parte de los datos del usuario, pero que almacena su descripción. Por ejemplo, la información en el sistema de archivos sobre en qué bloque se encuentra un archivo específico. Por lo tanto, la velocidad de acceso a los datos depende de la velocidad de acceso a los metadatos. Dado que los metadatos suelen ser mucho más pequeños, se espera un mayor beneficio de trasladarlos a discos más eficientes.
Los criterios que utiliza Fast VP en su funcionamiento
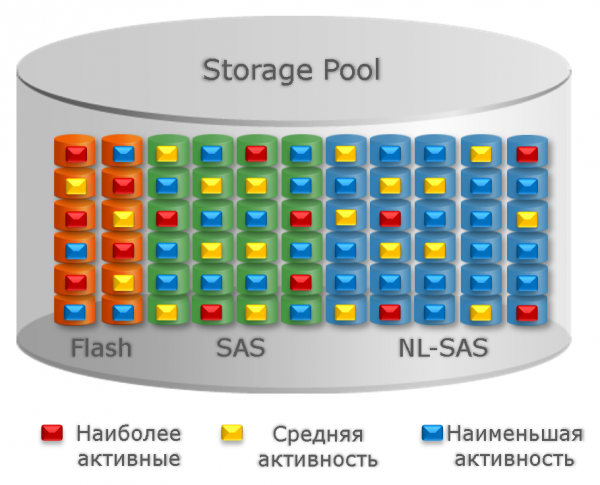
El criterio principal para cada bloque, si se quiere ser muy general, es la característica de «demanda» de los datos, que depende del número de operaciones de lectura y escritura del fragmento de datos. Esta característica la llamamos «Temperatura». Hay datos demandados (hot) que son más «calientes» que los no demandados. Se calcula periódicamente, por defecto con un intervalo de una hora.
La función de cálculo de temperatura tiene las siguientes propiedades:
- En ausencia de entrada y salida, los datos «se enfrían» con el tiempo.
- Con una carga más o menos constante en el tiempo, la temperatura inicialmente aumenta y luego se estabiliza en un rango determinado.
Luego se consideran las políticas descritas anteriormente y el espacio libre en cada nivel. Para ilustrar, aquí hay una imagen de la documentación. Las áreas en rojo, amarillo y azul representan bloques de alta, media y baja temperatura, respectivamente.
Pero volvamos a las tareas. Así que podemos empezar a analizar lo que se está haciendo para resolver las tareas de FAST VP.
A. Distribución de datos en diferentes tipos de discos, niveles
Esta es, en realidad, la tarea principal de FAST VP. Las demás, en cierto sentido, son derivadas de esta. Dependiendo de la política elegida, los datos se distribuirán entre diferentes niveles de almacenamiento. Primero se considera la política de ubicación, luego la temperatura de los bloques y el tamaño/velocidad de los grupos RAID.
Para las políticas Highest/Lowest Available Tier, es bastante sencillo. Para las otras dos, la situación es la siguiente. Datos se distribuyen entre diferentes niveles teniendo en cuenta el tamaño y el rendimiento de los grupos RAID: para que la relación entre la «temperatura» total de los bloques y el «rendimiento máximo condicional» de cada grupo RAID sea aproximadamente igual. Así, la carga se distribuye más o menos uniformemente. Los datos más demandados se mueven a medios más rápidos, mientras que los poco utilizados se trasladan a medios más lentos. En ideal, la distribución debería resultar aproximadamente así:
B. Distribución de datos entre discos del mismo tipo
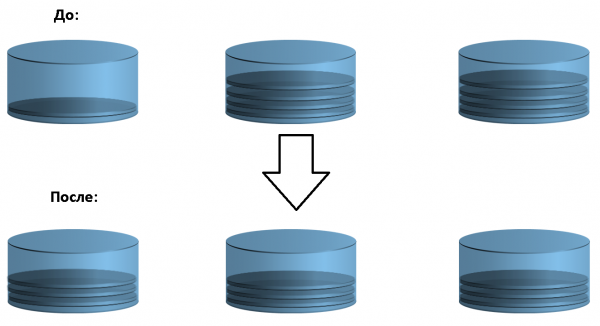
Recuerden, al principio mencioné que los medios de información son de uno o varios ¿Los niveles se combinan en un solo grupo? En el caso de un solo nivel para FAST VP, también hay trabajo. Para que el rendimiento de un nivel sea máximo, es preferible distribuir los datos de manera uniforme entre los discos. Esto permitirá (en teoría) obtener la máxima cantidad de IOPS. Los datos dentro de un grupo RAID se pueden considerar distribuidos uniformemente entre los discos, pero entre grupos RAID esto no siempre es así. En caso de desbalance, FAST VP moverá los datos entre los grupos RAID de manera proporcional a su tamaño y a la "capacidad de rendimiento condicional" (en términos numéricos). Para ilustrarlo, mostraré el esquema de reequilibrio entre tres grupos RAID:
B. Distribución de datos al expandir el grupo
Esta tarea es un caso particular de la anterior y se realiza cuando se añade un grupo RAID al grupo. Para que el grupo RAID recién añadido no esté inactivo, parte de los datos se trasladará a él, lo que significará que la carga en todos los grupos RAID se redistribuirá.
Igualación del desgaste de SSD
Mediante la igualación del desgaste, FAST VP puede prolongar la vida útil de los SSD, aunque esta función no está directamente relacionada con el almacenamiento jerárquico. Dado que ya hay datos sobre la temperatura, también se considera el número de operaciones de escritura. Sabemos mover bloques de datos, por lo que sería lógico que FAST VP también resolviera esta tarea.
En caso de que la cantidad de escrituras en un grupo RAID supere significativamente la cantidad de escrituras en otro, FAST VP redistribuirá los datos de acuerdo con el número de operaciones de escritura. Por un lado, esto reduce la carga y preserva el recurso de algunos discos; por otro lado, agrega "trabajo" a los menos cargados, aumentando el rendimiento general.
Así, FAST VP asume las tareas tradicionales del almacenamiento jerárquico y hace un poco más que eso. Todo esto permite almacenar datos de manera bastante eficiente en los sistemas de almacenamiento de la familia Unity.
Algunos consejos
- No descuides la lectura de la documentación. Hay mejores prácticas, y funcionan bastante bien. Si se siguen, por lo general no surgen problemas graves. Los otros consejos básicamente repiten o complementan estas.
- Si has configurado y activado FAST VP, es mejor dejarlo encendido. Deja que gestione los datos en el tiempo que le corresponde y poco a poco, en vez de hacerlo una vez al año, lo que podría afectar seriamente el rendimiento de otras tareas. En tales casos, la redistribución de datos puede alargarse mucho.
- Presta atención a la elección de la ventana de reubicación. Aunque es obvio, intenta seleccionar un momento con la menor carga en Unity y reserva suficiente tiempo.
- Planifica la expansión del almacenamiento, hazlo a tiempo. Esta es una recomendación general que también es importante para FAST VP. Si el espacio libre es muy escaso, la movilidad de los datos se ralentizará o se volverá imposible. Especialmente si has ignorado el punto 2.
- Al ampliar el pool con FAST VP activado, no debes comenzar con los discos más lentos. Es decir, o añadimos todos los grupos RAID planificados a la vez, o primero añadimos los discos más rápidos. En este caso, la redistribución de datos a los nuevos discos "rápidos" aumentará la velocidad general del pool. De lo contrario, si empiezas con discos "lentos", podrías enfrentarte a una situación muy desagradable. Primero se llevará a cabo la transferencia de datos a los nuevos discos relativamente lentos, y después, al añadir discos más rápidos, en la dirección opuesta. Aquí hay matices relacionados con las diferentes políticas de FAST VP, pero en general, esta situación es posible.
Si estás considerando este producto, puedes probar Unity en acción de forma gratuita descargando el appliance virtual Unity VSA.
Al finalizar este material, comparto algunos enlaces útiles:
- Página
- – descripción breve de la función
- , formato pdf
Conclusión
Quiero escribir sobre muchas cosas, pero entiendo que no todos los detalles serán interesantes para el lector. Por ejemplo, se podría hablar más sobre los criterios que FAST VP utiliza para decidir sobre la transferencia de datos, sobre los procesos de análisis de estadísticas de entrada-salida. También se ha mencionado muy poco sobre la interacción con , lo que podría dar lugar a un artículo separado. Incluso se podría especular sobre el desarrollo de esta tecnología. Espero que no haya sido aburrido y que no te haya cansado. ¡Hasta la próxima!
Fuente: habr.com
