

La pregunta clásica que un desarrollador plantea a su DBA o al propietario del negocio — al consultor de PostgreSQL — casi siempre suena igual: «¿Por qué las consultas se ejecutan en la base de datos tan lentamente?»
Conjunto tradicional de razones:
- algoritmo ineficiente
cuando decidiste hacer un JOIN de varios CTE con decenas de miles de registros - estadísticas obsoletas
si la distribución real de los datos en la tabla ya difiere significativamente de la recopilada por ANALYZE la última vez - cuello de botella en recursos
y ya no hay suficiente capacidad de procesamiento de CPU, mientras que se están consumiendo varios gigabytes de memoria o el disco no puede seguir el ritmo de todas las «demandas» de la base de datos - el bloqueo por procesos competidores
Y si las bloqueos son bastante difíciles de capturar y analizar, para todo lo demás solo necesitamos el plan de consulta, que se puede obtener mediante (mejor, por supuesto, EXPLAIN (ANALYZE, BUFFERS) …) o .
Pero, como se menciona en la misma documentación,
«Entender el plan es un arte, y para dominarlo se necesita cierta experiencia, …»
Pero se puede prescindir de él si se utiliza la herramienta adecuada.
¿Cómo se ve normalmente un plan de consulta? Algo así:
Index Scan using pg_class_relname_nsp_index on pg_class (actual time=0.049..0.050 rows=1 loops=1)
  Index Cond: (relname = $1)
  Filter: (oid = $0)
  Buffers: shared hit=4
  InitPlan 1 (returns $0,$1)
    ->  Limit (actual time=0.019..0.020 rows=1 loops=1)
          Buffers: shared hit=1
          ->  Seq Scan on pg_class pg_class_1 (actual time=0.015..0.015 rows=1 loops=1)
                Filter: (relkind = 'r'::"char")
                Rows Removed by Filter: 5
                Buffers: shared hit=1
o así:
"Append  (cost=868.60..878.95 rows=2 width=233) (actual time=0.024..0.144 rows=2 loops=1)"
"  Buffers: shared hit=3"
"  CTE cl"
"    ->  Seq Scan on pg_class  (cost=0.00..868.60 rows=9972 width=537) (actual time=0.016..0.042 rows=101 loops=1)"
"          Buffers: shared hit=3"
"  ->  Limit  (cost=0.00..0.10 rows=1 width=233) (actual time=0.023..0.024 rows=1 loops=1)"
"        Buffers: shared hit=1"
"        ->  CTE Scan on cl  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.021..0.021 rows=1 loops=1)"
"              Buffers: shared hit=1"
"  ->  Limit  (cost=10.00..10.10 rows=1 width=233) (actual time=0.117..0.118 rows=1 loops=1)"
"        Buffers: shared hit=2"
"        ->  CTE Scan on cl cl_1  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.001..0.104 rows=101 loops=1)"
"              Buffers: shared hit=2"
"Planning Time: 0.634 ms"
"Execution Time: 0.248 ms"
Pero leer el plan en texto «de hoja» es muy difícil y poco claro:
- en el nodo se muestra la suma de recursos del subárbol
es decir, para entender cuánto tiempo tomó ejecutar un nodo específico, o cuánto exactamente esta lectura de la tabla trajo datos del disco, es necesario restar una cosa de la otra - es necesario el tiempo del nodo multiplicar por loops
sí, la resta no es la operación más difícil que hay que hacer "mentalmente" -- ya que el tiempo de ejecución se indica como un promedio para una ejecución del nodo, y pueden ser cientos - bueno, y todo esto junto impide responder a la pregunta principal -- entonces, ¿quién es? "el eslabón más débil"?
Cuando intentamos explicar todo esto a varios cientos de nuestros desarrolladores, nos dimos cuenta de que desde fuera se veía más o menos así:
Ah, entonces, necesitamos...
Herramienta
En él tratamos de reunir todas las mecánicas clave que ayudan según el plan y la consulta a entender "quién es el culpable y qué hacer". Bueno, y compartir parte de nuestra experiencia con la comunidad.
Conózcanlo y utilícenlo --
Claridad de los planes
¿Es fácil entender un plan cuando se ve así?
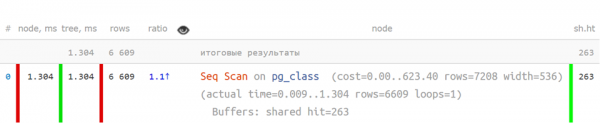
Seq Scan en pg_class (tiempo real=0.009..1.304 filas=6609 loops=1)
  Buffers: shared hit=263
Tiempo de planificación: 0.108 ms
Tiempo de ejecución: 1.800 ms
No muy claro.
Pero así, en forma resumida, cuando los indicadores clave están separados, es mucho más comprensible:
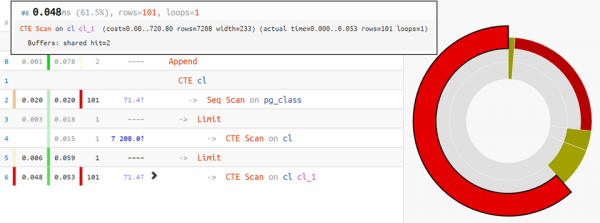
Pero si el plan es más complicado, entonces ayudará el gráfico de distribución del tiempo por nodos:
Bueno, y para las situaciones más complejas, se apresura a ayudar el diagrama de ejecución:
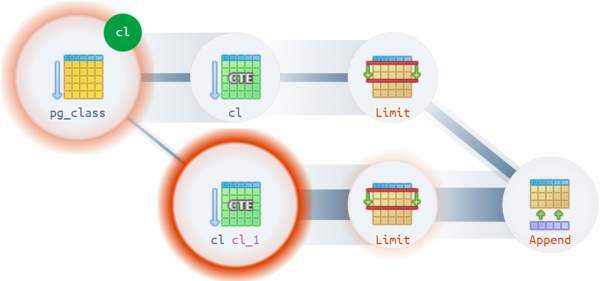
Por ejemplo, hay situaciones bastante no triviales, cuando el plan puede tener más de una raíz real:
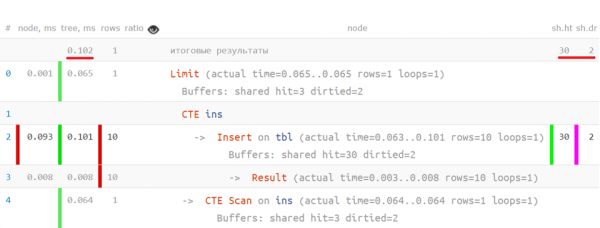
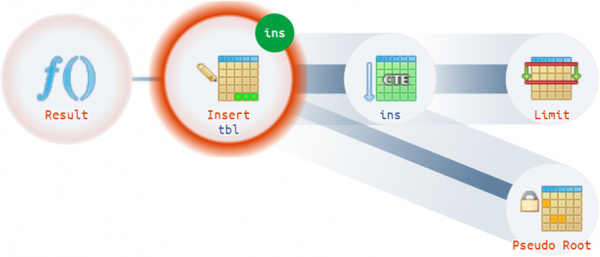
Sugerencias estructurales
Bueno, y si toda la estructura del plan y sus puntos problemáticos ya están desglosados y visibles, ¿por qué no resaltarlos para el desarrollador y explicar "en lenguaje sencillo"?
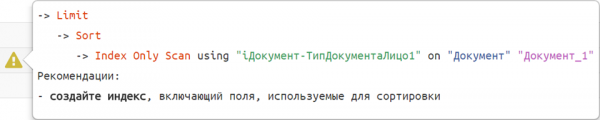 Hemos recopilado ya un par de docenas de tales plantillas de recomendaciones.
Perfilador de consulta línea por línea
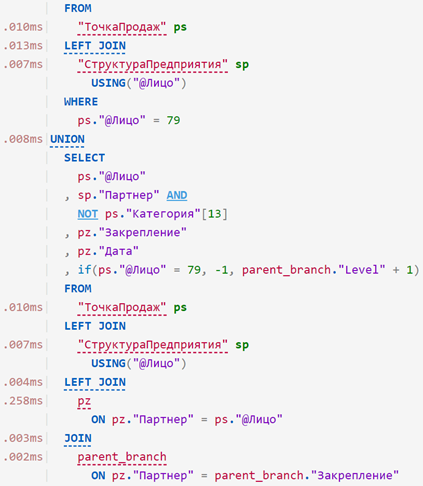
Ahora, si superponemos la consulta original al plan analizado, se puede ver cuánto tiempo tomó cada operador individual -- más o menos así:
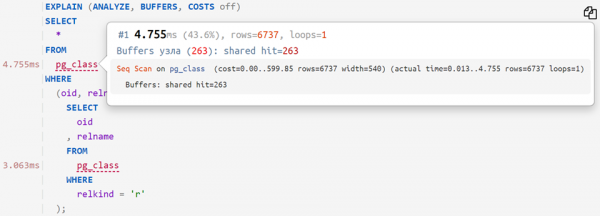
… o incluso así:
Sustitución de parámetros en la consulta
Si "adjuntaste" al plan no solo la consulta, sino también sus parámetros de la línea DETAIL del registro, podrás copiarlo adicionalmente en una de las variantes:
- con sustitución de valores en la consulta
para su ejecución directa en su base y posterior perfiladoSELECT 'const', 'param'::text; - con sustitución de valores a través de PREPARE/EXECUTE
para emular el funcionamiento del planificador, cuando se puede ignorar la parte paramétrica — por ejemplo, al trabajar con tablas particionadasDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Archivo de planes
¡Inserta, analiza y comparte con tus colegas! Los planes permanecerán en el archivo, y podrás volver a ellos más tarde:
Pero si no quieres que otros vean tu plan, no olvides marcar la opción "no publicar en el archivo".
En los próximos artículos, hablaré sobre las complejidades y soluciones que surgen al analizar un plan.
Fuente: habr.com
