

Hace unos meses — un servicio público para PostgreSQL.
En el tiempo transcurrido, ya lo has utilizado más de 6000 veces, pero una de las funciones convenientes podría haber pasado desapercibida: se trata de sugerencias estructurales, que lucen aproximadamente así:
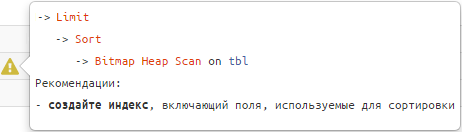
Escucha estas sugerencias y tus consultas "serán suaves como la seda". 🙂
Y en serio, muchas situaciones que hacen que una consulta sea lenta y "hambrienta" de recursos, son típicas y pueden ser reconocidas por la estructura y los datos del plan.
En este caso, cada desarrollador individual no tendrá que buscar una opción de optimización por sí solo, basándose únicamente en su experiencia; podemos sugerirle qué está sucediendo, cuál podría ser la causa y cómo se puede abordar la solución. Lo que hicimos.
Veamos estos casos con más detalle: cómo se determinan y a qué recomendaciones conducen.
Para una mejor comprensión del tema, primero se puede escuchar el bloque correspondiente de , y luego pasar al análisis detallado de cada ejemplo:
#1: индексная «недосортировка»
Cuando surge
Mostrar la última factura del cliente «ООО Колокольчик».
Cómo identificar
-> Limit
   -> Sort
      -> Index [Only] Scan [Backward] | Bitmap Heap Scan
Recomendaciones
Índice utilizado ampliar con campos de ordenación.
Ejemplo:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "hechos"
, (random() * 1000)::integer fk_cli; -- 1K diferentes claves externas

CREATE INDEX ON tbl(fk_cli); -- índice para clave foránea

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- selección por relación específica
ORDER BY
  pk DESC -- queremos solo un "último" registro
LIMIT 1; 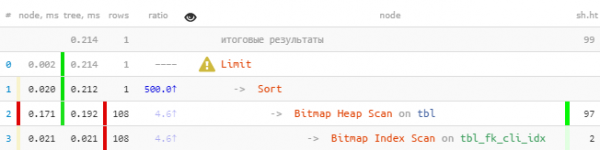
Se puede notar de inmediato que se leyeron más de 100 registros por índice, los cuales luego fueron ordenados, y después se dejó solo uno.
Corregimos:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- se agregó la clave de ordenación
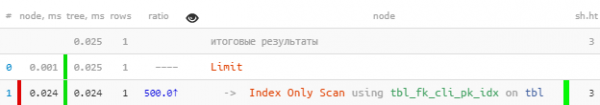
Incluso en esta selección primitiva — 8.5 veces más rápida y con 33 veces menos lecturas. El efecto será aún más evidente cuantas más "hechos" tengas por cada valor fk.
Cabe señalar que tal índice funcionará como "prefijo" tan bien como el anterior y en otras consultas con fk, donde no había y no hay ordenamientos por pk No se puede y está (se puede leer más sobre esto ). Además, asegurará un soporte adecuado para la clave foránea explícita en este campo. por este campo.
#2: пересечение индексов (BitmapAnd)
Cuando surge
Mostrar todos los contratos del cliente «ООО Колокольчик», celebrados en nombre de «НАО Лютик».
Cómo identificar
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Recomendaciones
Crear índice compuesto por campos de ambos orígenes o ampliar uno de los existentes con campos del segundo.
Ejemplo:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "hechos"
, (random() *  100)::integer fk_org  -- 100 claves externas diferentes
, (random() * 1000)::integer fk_cli; -- 1K claves externas diferentes

CREATE INDEX ON tbl(fk_org); -- índice para la clave externa
CREATE INDEX ON tbl(fk_cli); -- índice para la clave externa

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- filtrado por un par específico 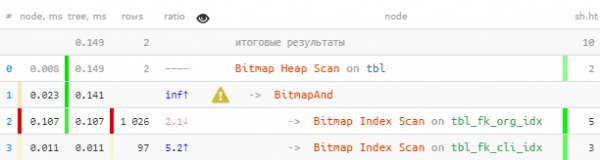
Corregimos:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
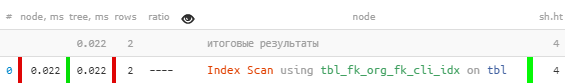
Aquí la mejora es menor, ya que el Bitmap Heap Scan es bastante eficiente por sí mismo. Sin embargo, es 7 veces más rápido y tiene 2.5 veces menos lecturas.
#3: объединение индексов (BitmapOr)
Cuando surge
Mostrar las primeras 20 solicitudes «propias» o no asignadas para procesamiento, priorizando las propias.
Cómo identificar
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Recomendaciones
Usar UNION [ALL] para combinar subconsultas de cada uno de los bloques de condiciones OR.
Ejemplo:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "hechos"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- con 1:16 de probabilidad la entrada es "nula"
    ELSE (random() * 100)::integer -- 100 claves externas diferentes
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- índice con un orden "aparentemente adecuado"

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- propias
  fk_own IS NULL -- ... o "nulas"
ORDER BY
  pk
, (fk_own = 1) DESC -- primero "propias"
LIMIT 20;
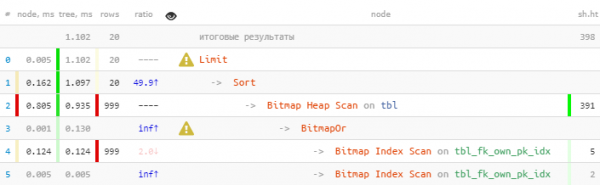
Corregimos:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- primero "propias" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- luego "nulas" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- pero en total - 20, no más es necesario 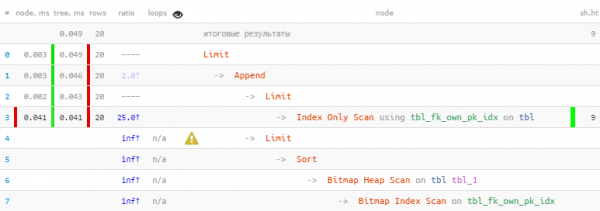
Aprovechamos que los 20 registros necesarios se obtuvieron de inmediato en el primer bloque, por lo que el segundo, con un Bitmap Heap Scan más "costoso", ni siquiera se ejecutó; en resultado es 22 veces más rápido, con 44 veces menos lecturas!
Una descripción más detallada de este método de optimización con ejemplos concretos se puede leer en los artículos y .
Una versión generalizada de la selección ordenada por múltiples claves (y no solo por un par const/NULL) se analiza en el artículo .
#4: читаем много лишнего
Cuando surge
Generalmente, surge al querer «agregar otro filtro» a una consulta existente.
«¿No tienes algo así, pero con botones de nácar?» película «La mano de diamante»
Por ejemplo, al modificar la tarea anterior, mostrar las primeras 20 solicitudes 'críticas' más antiguas para su procesamiento, independientemente de su destino.
Cómo identificar
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rows < RRbF -- filtrado >80% leído
   && loops × RRbF > 100 -- y además más de 100 registros en total
Recomendaciones
Crear [más] especializado índice con condición WHERE o incluir en el índice campos adicionales.
Si la condición de filtrado es 'estática' para sus tareas, es decir, no implica expansión de la lista de valores en el futuro, es mejor usar un índice WHERE. Esta categoría incluye bien diferentes estados booleanos/enum.
Si la condición de filtrado puede aceptar diferentes valores, es mejor expandir el índice con estos campos, como en la situación con BitmapAnd arriba.
Ejemplo:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K 'hechos'
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 diferentes claves externas
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, que la solicitud es 'crítica'

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 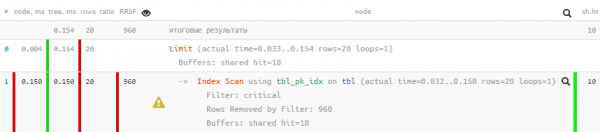
Corregimos:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- añadimos 'condición de filtrado' 'estática'
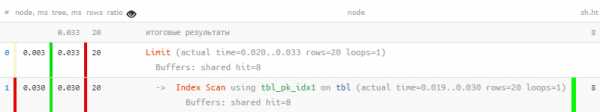
Como podemos ver, la filtración del plan ha desaparecido por completo, y la consulta se ha vuelto 5 veces más rápida.
#5: разреженная таблица
Cuando surge
Diversos intentos de crear colas de procesamiento de tareas propias, cuando un gran número de actualizaciones/eliminaciones de registros en la tabla conduce a una situación de gran cantidad de registros 'muertos'.
Cómo identificar
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && loops × (rows + RRbF) < (shared hit + shared read) × 8
      -- se ha leído más de 1KB por cada registro
   && shared hit + shared read > 64
Recomendaciones
Realizar regularmente de forma manual VACUUM [FULL] o lograr una ejecución adecuadamente frecuente ajustando sus parámetros, incluyendo .
En la mayoría de los casos, estos problemas resultan de una mala composición de consultas en llamadas de lógica empresarial como las que se han revisado en .
Pero hay que entender que incluso VACUUM FULL puede no ayudar siempre. Para tales casos, vale la pena familiarizarse con el algoritmo del artículo .
#6: чтение с «середины» индекса
Cuando surge
Parece que se ha leído un poco, y todo por índice, y no se ha filtrado a nadie extra, pero aun así se han leído considerablemente más páginas de las que se hubiera querido.
Cómo identificar
-> Índice [Solo] Escanear [Hacia atrás]
   && bucles × (filas + RRbF)  64
Recomendaciones
Revisar detenidamente la estructura del índice utilizado y los campos clave especificados en la consulta — probablemente, parte del índice no está definida. Es probable que tenga que crear un índice similar, pero sin campos de prefijo o .
Ejemplo:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "hechos"
, (random() *  100)::integer fk_org  -- 100 claves externas diferentes
, (random() * 1000)::integer fk_cli; -- 1K claves externas diferentes

CREATE INDEX ON tbl(fk_org, fk_cli); -- todo casi como en #2
-- solo que el índice separado por fk_cli ya lo hemos considerado innecesario y lo hemos eliminado

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- y fk_org no está especificada, aunque está en el índice antes
LIMIT 20; 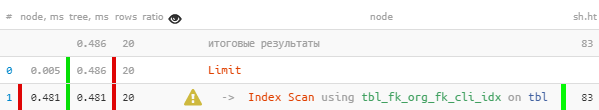
Parece que todo está bien, incluso por el índice, pero es un poco sospechoso — para cada uno de los 20 registros leídos, se tuvieron que leer 4 páginas de datos, 32KB por registro — ¿no es demasiado? Y el nombre del índice tbl_fk_org_fk_cli_idx provoca reflexión.
Corregimos:
CREATE INDEX ON tbl(fk_cli); 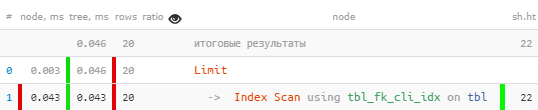
De repente — 10 veces más rápido, y 4 veces menos lectura!
Otros ejemplos de situaciones de uso ineficiente de índices se pueden ver en el artículo .
#7: CTE × CTE
Cuando surge
En la consulta se utilizaron CTE "gordos" de diferentes tablas, y luego decidieron hacer entre ellas JOIN.
El caso es relevante para versiones anteriores a v12 o consultas con WITH MATERIALIZED.
Cómo identificar
-> CTE Escanear
   && bucles > 10
   && bucles × (filas + RRbF) > 10000
      -- producto cartesiano de CTE demasiado grande
Recomendaciones
Analizar cuidadosamente la consulta — ¿son realmente necesarios los CTE aquí? ? Если все-таки да, то según el modelo descrito en PostgreSQL Antipatterns: golpeamos el diccionario contra un JOIN pesado .
#8: swap на диск (temp written)
Cuando surge
-> * && temp written > 0
Cómo identificar
Si la cantidad de memoria utilizada por la operación no excede significativamente el valor establecido del parámetroRecomendaciones
work_mem SET [LOCAL] para una consulta/transacción específica. SHOW work_mem; -- "16MB"SELECT random() FROM generate_series(1, 1000000) ORDER BY 1;
Ejemplo:
SET work_mem = '128MB'; -- antes de ejecutar la consulta 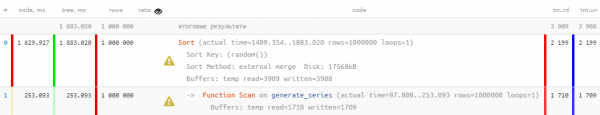
Corregimos:
Por razones comprensibles, si solo se utiliza la memoria y no el disco, entonces la consulta se ejecutará mucho más rápido. Además, parte de la carga se elimina del HDD. 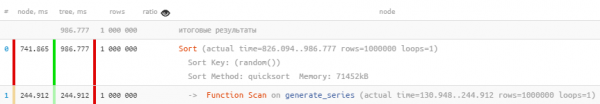
Por razones evidentes, si se utiliza solo memoria y no disco, la consulta se ejecutará mucho más rápido. Además, parte de la carga se elimina del HDD.
Pero hay que entender que no siempre se puede asignar una cantidad enorme de memoria; simplemente no habrá suficiente para todos.
#9: неактуальная статистика
Cuando surge
Se inyectó mucho en la base de datos de inmediato, pero no se logró procesar. ANALIZAR.
Cómo identificar
-> Escaneo Secuencial | Escaneo de Bitmap | Escaneo de Índice [Solo] [Invertido]
   && ratio >> 10
Recomendaciones
Realizarlo ANALIZAR.
Más detalles sobre esta situación se describen en .
#10: «что-то пошло не так»
Cuando surge
Ocurrió una espera por bloqueo impuesta por una consulta competidora, o no había suficientes recursos de hardware CPU/hipervisor.
Cómo identificar
-> *
   && (acierto compartido / 8K) + (lectura compartida / 1K) < tiempo / 1000
      -- acierto de RAM = 64MB/s, lectura de HDD = 8MB/s
   && tiempo > 100ms -- leímos poco, pero demasiado lento
Recomendaciones
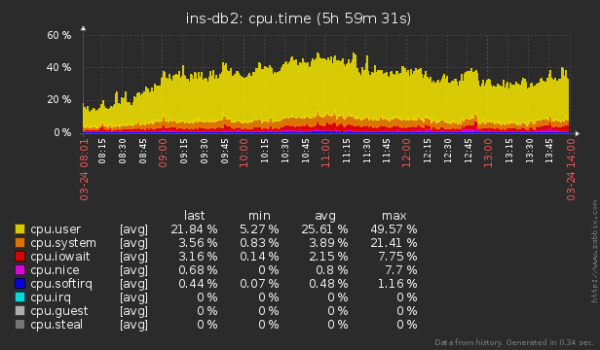
Utilice un sistema externo para monitorizar servidores en busca de bloqueos o consumo anómalo de recursos. Ya hemos hablado de nuestra manera de organizar este proceso para cientos de servidores. y .
Fuente: habr.com
