

¡Hola, Habr! Les presento una traducción autoral del artículo .
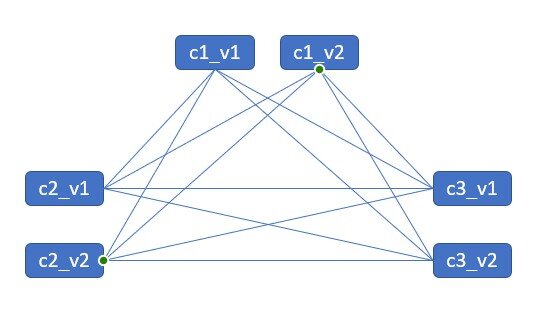
En la época en que el mundo de TI está gradualmente transitando hacia microservicios y herramientas como Kubernetes, un problema se vuelve cada vez más evidente. Este problema es de versiones de microservicios. Sin embargo, la comunidad de TI considera que la situación actual es significativamente mejor que la de de la generación anterior de tecnologías. Sin embargo, la gestión de versiones de microservicios es un problema bastante complejo. Una de las pruebas de esto puede ser artículos como .
Si leyendo este texto aún no entienden el problema, permítanme explicarlo. Supongamos que su producto consiste en 10 microservicios. Ahora supongamos que cada uno de estos microservicios lanza 1 nueva versión. Solo 1 versión: espero que todos estemos de acuerdo en que este es un hecho trivial y poco significativo. Pero ahora miremos nuevamente nuestro producto. Con solo una nueva versión de cada componente, ahora tenemos 2^10 — o 1024 permutaciones sobre cómo se puede componer nuestro producto.
Si aún queda confusión, permítanme desglosar las matemáticas. Entonces, tenemos 10 microservicios, cada uno recibe una actualización. Es decir, obtenemos 2 versiones posibles para cada microservicio (o la antigua o la nueva). Ahora, para cada uno de los componentes del producto podemos usar cualquiera de estas dos versiones. Matemáticamente, esto es lo mismo que tener un número binario de 10 dígitos. Por ejemplo, supongamos que 1 es la nueva versión y 0 es la versión antigua — entonces una posible permutación podría ser representada como 1001000000 — donde el primer y el cuarto componente han sido actualizados, mientras que todos los demás no. Desde las matemáticas sabemos que un número binario de 10 dígitos puede tener 2^10 o 1024 valores. Es decir, hemos confirmado la magnitud del número con el que estamos tratando.
Continuemos con la reflexión — ¿qué pasaría si tuviéramos 100 microservicios y cada uno tuviera 10 versiones posibles? La situación se vuelve bastante desagradable — ahora tenemos 10^100 permutaciones — y es un número enorme. Sin embargo, prefiero describir esta situación de esta manera, porque ahora no nos escondemos detrás de palabras como «kubernetes», sino que enfrentamos el problema tal como es.
¿Por qué me fascina tanto este problema? En parte porque, trabajando anteriormente en el mundo de NLP e IA, discutimos mucho sobre el problema de la explosión combinatoria hace unos 5-6 años. Solo que en lugar de versiones, teníamos palabras individuales y, en lugar de productos, teníamos oraciones y párrafos. Y aunque los problemas de NLP e IA siguen en gran medida sin resolver, hay que reconocer que en los últimos años se ha hecho un progreso significativo. (en mi opinión, el progreso podría haber sido mayor si la gente en la industria prestara un poco menos de atención al aprendizaje automático y un poco más a otras técnicas — pero eso ya es un tema off-topic).mayor audiencia.Volviendo al mundo de DevOps y microservicios. Nos enfrentamos a un gran problema, disfrazado como un elefante en una habitación de curiosidades — porque lo que a menudo escucho es: “¡solo toma Kubernetes y Helm y todo estará bien!” Pero no, no estará bien si dejamos todo como está. Más aún, la solución analítica a este problema no parece aceptable debido a su complejidad. Al igual que en NLP, debemos abordar este problema reduciendo el ámbito de búsqueda — en este caso, excluyendo las permutaciones obsoletas.
Una de las cosas que puede ayudar — escribí el año pasado
sobre la necesidad de mantener un mínimo de variación entre las versiones entregadas a los clientes. Lo que necesitamos es un sistema de experimentación en la etapa de integración, donde podamos determinar el factor de riesgo por cada componente, así como tener un proceso automatizado de actualización de diferentes componentes y pruebas sin la intervención del operador — para ver qué funciona y qué no.
Un sistema de experimentación podría verse de la siguiente manera:
Los desarrolladores escriben pruebas (este es un paso crítico — porque de lo contrario no tenemos criterios de evaluación — es como la anotación de datos en el aprendizaje automático).
- Cada componente (proyecto) tiene su propio sistema CI — este proceso está bien desarrollado hoy en día, y la cuestión de crear un sistema CI para un solo componente está en gran medida resuelta.
- Каждый компонент (проект) получает свою собственную CI систему — этот процесс на сегодняшний день хорошо проработан, и вопрос создания CI системы для единичного компонента во многом решен
- El "Sistema de Integración Inteligente" recoge los resultados de diversos sistemas de CI y compila los proyectos-componentes en un producto final, realiza pruebas y, finalmente, calcula el camino más corto para obtener la funcionalidad deseada del producto, considerando los componentes existentes y los factores de riesgo. Si una actualización no es posible, este sistema notifica a los desarrolladores sobre los componentes disponibles y en cuál de ellos ocurre el error. Una vez más, repito que el sistema de pruebas aquí es de vital importancia, ya que el sistema de integración utiliza las pruebas como criterio de evaluación.
- Sistema CD, que luego obtiene datos del "Sistema de Integración Inteligente" y realiza directamente la actualización. Esta etapa concluye el ciclo.
En resumen, para mí, uno de los mayores problemas en la actualidad es la ausencia de un "Sistema de Integración Inteligente" que conecte diversos componentes en un producto y, de este modo, permita rastrear cómo se compone el producto en su totalidad. Me interesan las opiniones de la comunidad al respecto (spoiler: actualmente estoy trabajando en un proyecto , que puede convertirse en tal sistema de integración inteligente).
Una última cosa que quiero mencionar: para mí, un monolito no es aceptable para ningún proyecto de tamaño medio. Soy muy escéptico ante los intentos de acelerar el tiempo de implementación y la calidad del desarrollo volviendo al monolito. En primer lugar, el monolito presenta un problema de gestión de componentes similar, entre las diversas bibliotecas de las que está compuesto; sin embargo, todo esto no es tan evidente y se manifiesta principalmente en el tiempo que dedican los desarrolladores. Como consecuencia del problema del monolito, está la imposibilidad real de realizar cambios en el código y la velocidad de desarrollo extremadamente lenta.
Los microservicios mejoran la situación, aunque luego la arquitectura de microservicios enfrenta el problema de la explosión combinatoria en la etapa de integración. Sí, en general, hemos trasladado el mismo problema de la etapa de desarrollo a la etapa de integración. Sin embargo, en mi opinión, el enfoque de microservicios sigue dando mejores resultados, y los equipos logran resultados más rápido (probablemente, principalmente debido a la reducción del tamaño de la unidad de desarrollo — o batch size). Sin embargo, la transición de un monolito a microservicios aún no ha proporcionado una mejora suficiente en el proceso; la explosión combinatoria de versiones de microservicios es un gran problema, y tenemos un gran potencial para mejorar la situación a medida que se resuelva.
Fuente: habr.com
