

El kube-scheduler es un componente esencial de Kubernetes, encargado de programar pods en nodos de acuerdo a políticas específicas. A menudo, durante la operación de un clúster de Kubernetes, no debemos preocuparnos por las políticas bajo las cuales se programa un pod, ya que el conjunto de políticas del kube-scheduler por defecto es adecuado para la mayoría de las tareas cotidianas. Sin embargo, hay situaciones en las que es importante gestionar finamente el proceso de asignación de pods, y para abordar esta tarea existen dos caminos:
- Crear un kube-scheduler con un conjunto de reglas personalizadas
- Escribir su propio scheduler y enseñarle a interactuar con las solicitudes del servidor API
En este artículo, describiré la implementación del primer punto para solucionar el problema de la programación desigual de pods en uno de nuestros proyectos.
Introducción breve sobre el funcionamiento del kube-scheduler
Es importante señalar que el kube-scheduler no se encarga de la programación directa de pods; su función es únicamente determinar el nodo en el que debe colocarse el pod. En otras palabras, el resultado del trabajo del kube-scheduler es el nombre del nodo que devuelve al servidor API en respuesta a una solicitud de programación, y ahí termina su tarea.
Primero, el kube-scheduler genera una lista de nodos donde un pod puede ser programado de acuerdo a las políticas de predicados. Luego, cada nodo de esta lista recibe una cantidad de puntos según las políticas de prioridades. Como resultado, se selecciona el nodo que ha acumulado la mayor cantidad de puntos. Si hay nodos que han obtenido la misma puntuación máxima, se elige uno al azar. Puede consultar la lista y la descripción de las políticas de predicados (filtrado) y prioridades (puntuación) en .
Descripción del cuerpo del problema
A pesar de la gran cantidad de diferentes clústeres Kubernetes en mantenimiento en Nixys, solo recientemente nos hemos encontrado con un problema de planificación de pods, cuando para uno de nuestros proyectos surgió la necesidad de ejecutar una gran cantidad de tareas periódicas (~100 entidades CronJob). Para simplificar al máximo la descripción del problema, tomemos como ejemplo un microservicio, en el cual cada minuto se ejecuta una tarea cron que genera cierta carga en la CPU. Para esta tarea cron, se asignaron tres nodos absolutamente idénticos en características (24 vCPU en cada uno).
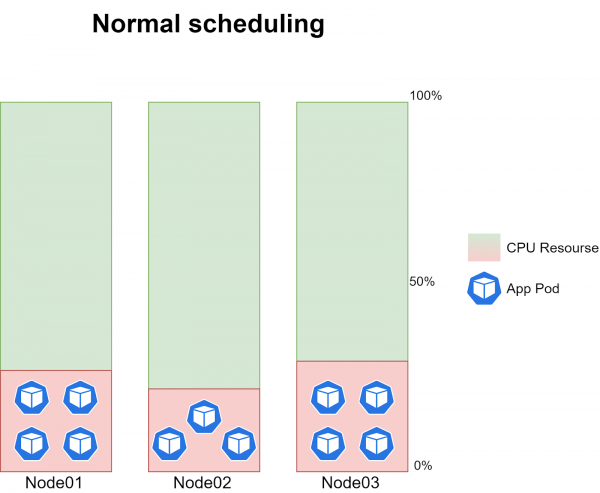
Sin embargo, no se puede decir con precisión cuánto tiempo llevará ejecutar el CronJob, ya que el volumen de datos de entrada cambia constantemente. En promedio, con un funcionamiento normal del kube-scheduler, en cada nodo funcionan de 3 a 4 instancias de la tarea, que crean alrededor del 20-30% de la carga en la CPU de cada nodo:
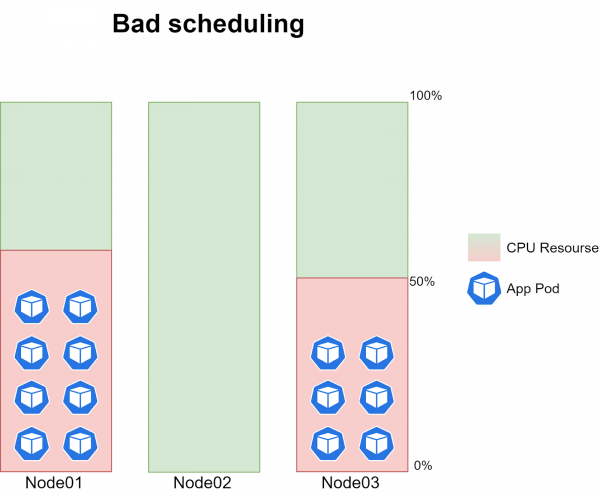
El problema en sí consiste en que a veces los pods de las tareas cron dejaban de programarse en uno de los tres nodos. Es decir, en algún momento, no se programaba ningún pod en uno de los nodos, mientras que en los otros dos nodos funcionaban de 6 a 8 instancias de la tarea, creando alrededor del 40-60% de carga en la CPU:
El problema se repetía con una periodicidad absolutamente aleatoria y a veces correlacionaba con el momento del lanzamiento de una nueva versión del código.
Al aumentar el nivel de registro del kube-scheduler a 10 (-v=10), comenzamos a registrar cuántos puntos acumulaba cada uno de los nodos durante el proceso de evaluación. En condiciones normales de planificación, se podía ver la siguiente información en los registros:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 1387 milicores 4161694720 bytes de memoria, puntaje 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 1347 milicores 4444810240 bytes de memoria, puntaje 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 1387 milicores 4161694720 bytes de memoria, puntaje 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 1687 milicores 4790840320 bytes de memoria, puntaje 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 1347 milicores 4444810240 bytes de memoria, puntaje 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 1687 milicores 4790840320 bytes de memoria, puntaje 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Puntaje: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Puntaje: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Puntaje: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Puntaje: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Puntaje: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Puntaje: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Puntaje: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Puntaje: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Puntaje: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Puntaje: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Puntaje: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Puntaje: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Puntaje: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Puntaje: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Puntaje: (10)
generic_scheduler.go:781] Host Node01 -> Puntaje 100043
generic_scheduler.go:781] Host Node02 -> Puntaje 100043
generic_scheduler.go:781] Host Node03 -> Puntaje 100043
Es decir, según la información obtenida de los registros, cada uno de los nodos acumulaba la misma cantidad de puntos finales y se seleccionaba uno al azar para la planificación. En el momento de la planificación problemática, los registros se veían de la siguiente manera:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 1587 milicores 4581125120 bytes de memoria, puntuación 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 1087 milicores 3532549120 bytes de memoria, puntuación 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 1587 milicores 4581125120 bytes de memoria, puntuación 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 987 milicores 3322833920 bytes de memoria, puntuación 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 987 milicores 3322833920 bytes de memoria, puntuación 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, capacidad 23900 milicores 67167186944 bytes de memoria, solicitud total 1087 milicores 3532549120 bytes de memoria, puntuación 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Puntuación: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Puntuación: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Puntuación: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Puntuación: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Puntuación: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Puntuación: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Puntuación: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Puntuación: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Puntuación: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Puntuación: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Puntuación: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Puntuación: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Puntuación: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Puntuación: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Puntuación: (10)
generic_scheduler.go:781] Host Node03 -> Puntuación 100041
generic_scheduler.go:781] Host Node02 -> Puntuación 100041
generic_scheduler.go:781] Host Node01 -> Puntuación 100038
De las cuales se observa que uno de los nodos acumuló menos puntos totales que los demás, y por lo tanto, la planificación se realizó solo en los dos nodos que obtuvieron la máxima puntuación. Así, nos aseguramos de que el problema reside precisamente en la planificación de los pods.
El siguiente algoritmo para resolver el problema nos pareció obvio: analizar los registros, entender por qué motivo el nodo no obtuvo puntos y, si es necesario, ajustar las políticas del kube-scheduler por defecto. Sin embargo, aquí nos enfrentamos a dos dificultades significativas:
- En el nivel máximo de registro (10), se refleja un conjunto de puntos solo para algunos prioridades. En el fragmento de registros anterior, se puede notar que para todas las prioridades reflejadas en los registros, los nodos obtienen la misma cantidad de puntos tanto en la planificación normal como en la problemática, sin embargo, el resultado final en caso de planificación problemática es diferente. De este modo, se puede concluir que para algunas prioridades el conteo de puntos sucede “tras bambalinas”, y no tenemos forma de entender por qué prioridad en particular el nodo no obtuvo puntos. Este problema lo describimos en detalle en el repositorio de Kubernetes en Github. En el momento de redactar este artículo, recibimos respuesta de los desarrolladores indicando que el soporte para el registro se añadirá en las actualizaciones de Kubernetes v1.15, 1.16 y 1.17.
- No hay una forma sencilla de entender con qué conjunto específico de políticas está trabajando actualmente el kube-scheduler. Sí, en esta lista se enumera, pero no contiene información sobre qué pesos específicos se asignan a cada una de las políticas de prioridades. Ver los pesos o editar las políticas del kube-scheduler por defecto solo es posible en .
Cabe señalar que, en una ocasión, logramos registrar que el nodo no obtuvo puntos por la política ImageLocalityPriority, que asigna puntos al nodo si ya tiene la imagen necesaria para ejecutar la aplicación. Es decir, en el momento del despliegue de una nueva versión de la aplicación, la tarea cron lograba ejecutarse en dos nodos, obteniendo en ellos una nueva imagen del registro de docker, y así, esos dos nodos recibían una puntuación final mayor en comparación con el tercero.
Como mencioné anteriormente, en los registros no vemos información sobre la evaluación de la política ImageLocalityPriority, por lo que, para verificar mi suposición, implementamos una imagen con una nueva versión de la aplicación en el tercer nodo, después de lo cual la programación funcionó correctamente. Precisamente debido a la política ImageLocalityPriority, el problema de la programación era bastante raro, y a menudo estaba relacionado con algo diferente. Dado que no pudimos depurar adecuadamente cada una de las políticas en la lista de prioridades del kube-scheduler por defecto, tuvimos que gestionar las políticas de programación de pods de manera flexible.
Planteamiento del problema
Queríamos que la solución al problema fuera lo más puntual posible, es decir, las entidades principales de Kubernetes (refiriéndonos al kube-scheduler por defecto) deben permanecer sin cambios. No queríamos resolver un problema en un lugar y generarlo en otro. Así, llegamos a dos opciones de solución al problema, que fueron mencionadas en la introducción del artículo: crear un scheduler adicional o escribir el nuestro. El requisito principal para la programación de tareas cron es la distribución equitativa de la carga entre los tres nodos. Este requisito se puede cumplir con las políticas existentes del kube-scheduler, por lo que no tiene sentido crear nuestro propio scheduler para resolver nuestra tarea.
La instrucción para crear y desplegar un kube-scheduler adicional se describe en . Sin embargo, nos pareció que las entidades de Deployment eran insuficientes para garantizar la alta disponibilidad de un servicio tan crítico como kube-scheduler, por lo que decidimos desplegar un nuevo kube-scheduler como Pod Estático, el cual será monitoreado directamente por Kubelet. Así, establecimos los siguientes requisitos para el nuevo kube-scheduler:
- El servicio debe desplegarse como un Pod Estático en todos los maestros del clúster.
- Se debe prever alta disponibilidad en caso de que el pod activo con kube-scheduler no esté disponible.
- El principal criterio al programar debe ser la cantidad de recursos disponibles en el nodo (LeastRequestedPriority).
Implementación de la solución
Cabe destacar que todas las operaciones se llevarán a cabo en Kubernetes v1.14.7, ya que esta versión fue la que se utilizó en el proyecto. Comenzaremos escribiendo el manifiesto para nuestro nuevo kube-scheduler. Tomaremos como base el manifiesto por defecto (/etc/kubernetes/manifests/kube-scheduler.yaml) y lo ajustaremos a la siguiente forma:
tipo: Pod
metadata:
  etiquetas:
    componente: scheduler
    nivel: control-plane
  nombre: kube-scheduler-cron
  namespace: kube-system
spec:
      contenedores:
      - comando:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        imagen: gcr.io/google-containers/kube-scheduler:v1.14.7
        imagePullPolicy: IfNotPresent
        livenessProbe:
          failureThreshold: 8
          httpGet:
            host: 127.0.0.1
            path: /healthz
            port: 10151
            scheme: HTTP
          initialDelaySeconds: 15
          timeoutSeconds: 15
        nombre: kube-scheduler-cron-container
        recursos:
          requests:
            cpu: '0.1'
        volúmenesMontados:
        - mountPath: /etc/kubernetes/scheduler.conf
          name: kube-config
          readOnly: true
        - mountPath: /etc/localtime
          name: localtime
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          name: scheduler-config
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          name: policy-config
          readOnly: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volúmenes:
      - hostPath:
          path: /etc/kubernetes/scheduler.conf
          type: FileOrCreate
        name: kube-config
      - hostPath:
          path: /etc/localtime
        name: localtime
      - hostPath:
          path: /etc/kubernetes/scheduler-custom.conf
          type: FileOrCreate
        name: scheduler-config
      - hostPath:
          path: /etc/kubernetes/scheduler-custom-policy-config.json
          type: FileOrCreate
        name: policy-config
Resumen de los cambios principales:
- Se cambió el nombre del pod y del contenedor a kube-scheduler-cron
- Se especificó el uso de los puertos 10151 y 10159 ya que se definió la opción
hostNetwork: truey no podemos usar los mismos puertos que el kube-scheduler predeterminado (10251 y 10259) - Con el parámetro --config se especificó el archivo de configuración con el cual debe iniciarse el servicio
- Se configuró el montaje del archivo de configuración (scheduler-custom.conf) y del archivo de políticas de programación (scheduler-custom-policy-config.json) desde el host
No olvidemos que nuestro kube-scheduler requerirá permisos similares al predeterminado. Editamos su rol de clúster:
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Ahora hablemos sobre el contenido que debe tener el archivo de configuración y el archivo de políticas de programación:
- Archivo de configuración (scheduler-custom.conf)
Para obtener la configuración del kube-scheduler predeterminado, es necesario usar el parámetro--write-config-tode . Colocaremos la configuración obtenida en el archivo /etc/kubernetes/scheduler-custom.conf y la ajustaremos de la siguiente manera:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Resumen de los cambios principales:
- Se estableció en schedulerName el nombre de nuestro servicio kube-scheduler-cron.
- En el parámetro
lockObjectNametambién es necesario establecer el nombre de nuestro servicio y asegurarse de que el parámetroleaderElectesté establecido en true (en caso de que tenga un solo nodo maestro, puede establecer el valor en false). - Se indicó la ruta al archivo con la descripción de las políticas de programación en el parámetro
algorithmSource.
Vale la pena detenerse con más detalle en el segundo punto, donde editamos los parámetros para la clave leaderElection. Para garantizar la alta disponibilidad, activamos (leaderElect) el proceso de elección de líder (maestro) entre los pods de nuestro kube-scheduler utilizando un endpoint común para ellos (resourceLock) llamado kube-scheduler-cron (lockObjectName) en el espacio de nombres kube-system (lockObjectNamespace). Sobre cómo se asegura la alta disponibilidad de los componentes principales en Kubernetes (incluido kube-scheduler), se puede consultar en .
- El archivo de políticas de programación (scheduler-custom-policy-config.json)
Como mencioné anteriormente, para saber con qué políticas específicas trabaja el kube-scheduler predeterminado, solo podemos analizar su código. Es decir, no podemos obtener un archivo con las políticas de programación del kube-scheduler predeterminado, a diferencia del archivo de configuración. Describiremos las políticas de programación que nos interesan en el archivo /etc/kubernetes/scheduler-custom-policy-config.json de la siguiente manera:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Así, kube-scheduler primero elabora una lista de nodos en los que se puede programar un pod de acuerdo con la política GeneralPredicates (que incluye un conjunto de políticas como PodFitsResources, PodFitsHostPorts, HostName y MatchNodeSelector). Luego se evalúa cada nodo de acuerdo con un conjunto de políticas en el arreglo de prioridades. Para cumplir con los requisitos de nuestra tarea, consideramos que este conjunto de políticas sería la solución óptima. Recuerdo que el conjunto de políticas con su descripción detallada está disponible en . Para llevar a cabo su tarea, puede simplemente cambiar el conjunto de políticas utilizadas y asignarles los pesos correspondientes.
El manifiesto del nuevo kube-scheduler que creamos al principio del capítulo lo llamaremos kube-scheduler-custom.yaml y lo ubicaremos en la siguiente ruta /etc/kubernetes/manifests en los tres nodos maestro. Si todo se hizo correctamente, Kubelet en cada nodo iniciará el pod y en los registros de nuestro nuevo kube-scheduler veremos información sobre que nuestro archivo de políticas se aplicó exitosamente:
Creando scheduler a partir de la configuración: {{ } [{GeneralPredicates } ] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } ] [] 10 false}
Registrando predicado: GeneralPredicates
El tipo de predicado GeneralPredicates ya está registrado, reutilizándolo.
Registrando prioridad: ServiceSpreadingPriority
El tipo de prioridad ServiceSpreadingPriority ya está registrado, reutilizándolo.
Registrando prioridad: EqualPriority
El tipo de prioridad EqualPriority ya está registrado, reutilizándolo.
Registrando prioridad: LeastRequestedPriority
El tipo de prioridad LeastRequestedPriority ya está registrado, reutilizándolo.
Registrando prioridad: NodePreferAvoidPodsPriority
El tipo de prioridad NodePreferAvoidPodsPriority ya está registrado, reutilizándolo.
Registrando prioridad: NodeAffinityPriority
El tipo de prioridad NodeAffinityPriority ya está registrado, reutilizándolo.
Creando scheduler con predicados que se ajustan 'map[GeneralPredicates:{}]' y funciones de prioridad 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Ahora solo queda especificar en el spec de nuestro CronJob que todas las solicitudes para programar sus pods deben ser gestionadas por nuestro nuevo kube-scheduler:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Conclusión
Al final, hemos obtenido un kube-scheduler adicional con un conjunto único de políticas de programación, cuya operación es supervisada directamente por kubelet. Además, configuramos las elecciones de un nuevo líder entre los pods de nuestro kube-scheduler en caso de que el antiguo líder se vuelva inaccesible por alguna razón.
Las aplicaciones y servicios normales continúan programándose a través del kube-scheduler predeterminado, y todas las tareas cron se han trasladado por completo al nuevo. La carga generada por las tareas cron ahora se distribuye uniformemente entre todos los nodos. Dado que la mayoría de las tareas cron se ejecutan en los mismos nodos que las aplicaciones principales del proyecto, esto ha permitido reducir significativamente el riesgo de migración de pods debido a la falta de recursos. Después de implementar un kube-scheduler adicional, ya no se han presentado problemas de programación desigual de tareas cron.
También lee otros artículos en nuestro blog:
Fuente: habr.com
