

Buenos días, en artículos anteriores nos familiarizamos con el funcionamiento de ELK Stack. Ahora discutiremos las posibilidades que un especialista en seguridad informática puede implementar utilizando estos sistemas. ¿Qué registros se pueden y deben almacenar en Elasticsearch? Veremos qué estadísticas se pueden obtener al configurar dashboards y si hay algún beneficio en ello. ¿Cómo se puede implementar la automatización de procesos de seguridad informática utilizando el stack ELK? Vamos a elaborar la arquitectura de trabajo del sistema. En total, la implementación de todas las funcionalidades es una tarea muy grande y compleja, por lo que hemos separado la solución en un nombre distinto: TS Total Sight.
Actualmente, están ganando popularidad las soluciones que consolidan y analizan incidentes de seguridad informática en un solo lugar lógico, lo que permite al especialista obtener estadísticas y un plan de acción para mejorar el estado de la seguridad informática en la organización. Este es el objetivo que nos hemos planteado al utilizar el stack ELK, resultando en la separación de la funcionalidad principal en 4 secciones:
- Estadísticas y visualización;
- Detección de incidentes de seguridad informática;
- Priorización de incidentes;
- Automatización de procesos de seguridad informática.
A continuación, examinaremos más detalladamente cada uno por separado.
Detección de incidentes de seguridad informática
La tarea principal al utilizar Elasticsearch en nuestro caso es la recopilación exclusivamente de incidentes de seguridad informática. Se pueden recopilar incidentes de seguridad informática de cualquier medio de protección, siempre que soporten al menos algunos modos de envío de logs, siendo lo estándar syslog o mediante SCP para guardar en un archivo.
Se pueden dar ejemplos estándar de medios de protección y no solo, de donde se debe configurar el envío de logs:
- Cualquier medio NGFW (Check Point, Fortinet);
- Cualquier escáner de vulnerabilidades (PT Scanner, OpenVas);
- Web Application Firewall (PT AF);
- Analizadores de netflow (Flowmon, Cisco StealthWatch);
- Servidor AD.
Después de haber configurado el envío de logs y los archivos de configuración en Logstash, se pueden correlacionar y comparar con los incidentes que provienen de diversos medios de seguridad. Para ello, resulta conveniente utilizar índices en los que almacenaremos todos los incidentes relacionados con un dispositivo concreto. En otras palabras, un índice es todos los incidentes para un solo dispositivo. Esta distribución puede implementarse de dos maneras.
La primera opción esto configura el archivo de Logstash. Para esto, es necesario duplicar el log por ciertos campos en una unidad separada con otro tipo. Y luego, en el futuro, usar este tipo. En el ejemplo, se clonarán los logs por el blade IPS del cortafuegos Check Point.
filter {
    if [product] == "SmartDefense" {
        clone {
	    clones => ["CloneSmartDefense"]
	    add_field => {"system" => "checkpoint"}
	}
    }
}
Para guardar eventos en un índice separado dependiendo de los campos de los logs, por ejemplo, como la IP de destino de la firma del ataque. Se puede usar una construcción como esta:
output {
    if [type] == "CloneSmartDefense"{
    {
         elasticsearch {
    	 hosts => [",:9200"]
    	 index => "smartdefense-%{dst}"
    	 user => "admin"
    	 password => "password"
  	 }
    }
}
Y de esta manera se puede hacer la conservación en un índice de todos los incidentes, por ejemplo, por dirección IP o por el nombre de dominio de la máquina. En este caso, se guarda en el índice «smartdefense-%{dst}», por la dirección IP de la firma.
Sin embargo, diferentes productos tendrán diferentes campos para los logs, lo que llevará al caos y al consumo innecesario de memoria. Aquí será necesario o reemplazar cuidadosamente en la configuración de Logstash los campos por otros predefinidos que sean iguales para todos los tipos de incidentes, lo cual también es una tarea complicada.
La segunda opción de implementación — es escribir un script o proceso que acceda en tiempo real a la base de datos de Elasticsearch, extraiga los incidentes necesarios y los guarde en un nuevo índice. Esto es una tarea difícil, pero permite trabajar con los logs como desee y correlacionar directamente con incidentes de otros medios de seguridad. Esta opción permite configurar el trabajo con los logs de la manera más útil para su caso con la máxima flexibilidad, pero aquí surge el problema de encontrar a un especialista que pueda implementarlo.
Y, por supuesto, la pregunta más importante, ¿qué se puede correlacionar y detectar en realidad??
Aquí puede haber varias opciones, y depende de qué medios de seguridad se utilizan en su infraestructura, algunos ejemplos:
- La opción más obvia y, desde mi punto de vista, la más interesante para aquellos que tienen una solución NGFW y un escáner de vulnerabilidades. Esta es la comparación de los registros de IPS y los resultados del escaneo de vulnerabilidades. Si se ha detectado un ataque (no bloqueado) por el sistema IPS y dicha vulnerabilidad no está cerrada en la máquina final según los resultados del escaneo, es necesario avisar de inmediato, ya que existe una gran probabilidad de que la vulnerabilidad haya sido explotada.
- Muchas intentos de inicio de sesión desde una máquina en diferentes lugares pueden simbolizar actividad maliciosa.
- Descarga de archivos maliciosos por parte del usuario debido a la visita a un gran número de sitios potencialmente peligrosos.
Estadísticas y visualización
Lo más obvio y comprensible para lo que se necesita un ELK Stack es para el almacenamiento y la visualización de registros, se mostró cómo se pueden recopilar registros de varios dispositivos utilizando Logstash. Una vez que los registros van a Elasticsearch, se pueden configurar paneles, de los cuales también se habló , con la información y estadísticas necesarias para usted a través de la visualización.
Ejemplos:
- Panel de eventos de Prevención de Amenazas con los eventos más críticos. Aquí se pueden reflejar qué firmas de IPS han sido detectadas y desde dónde territorialmente se originan.
- Panel sobre el uso de aplicaciones más críticas, desde donde puede filtrarse información.
- Resultados del escaneo de cualquier escáner de seguridad.
- Registros de Active Directory por usuarios.
- Panel sobre conexiones VPN.
En este caso, si se configuran los paneles para actualizarse cada pocos segundos, se puede obtener un sistema bastante conveniente para monitorear eventos en tiempo real, que luego se puede utilizar para una respuesta más rápida a incidentes de ciberseguridad, si se coloca el panel en una pantalla separada.
Priorización de incidentes
En una infraestructura grande, la cantidad de incidentes puede ser abrumadora y los especialistas no podrán abordar todos los incidentes a tiempo. En este caso, es necesario priorizar aquellos incidentes que representen una mayor amenaza. Por lo tanto, el sistema debe clasificar los incidentes según su peligrosidad en relación con su infraestructura. Es recomendable configurar alertas por correo electrónico o Telegram para estos eventos. La priorización se puede realizar con las herramientas nativas de Kibana, mediante la configuración de visualización. Sin embargo, la notificación es más complicada, ya que por defecto esta funcionalidad no se incluye en la versión básica de Elasticsearch, solo en la de pago. Por lo tanto, hay que optar por comprar la versión de pago o, nuevamente, desarrollar un proceso que notifique en tiempo real a los especialistas por correo electrónico o Telegram.
Automatización de procesos de seguridad de la información
Una de las partes más interesantes es la automatización de acciones ante incidentes de seguridad de la información. Anteriormente implementamos esta funcionalidad para Splunk, y puedes leer más al respecto en este . La idea principal es que la política de IPS nunca se verifica ni se optimiza, aunque en algunos casos es una parte crucial de los procesos de seguridad de la información. Por ejemplo, un año después de implementar un NGFW y sin acciones de optimización de IPS, acumularás una gran cantidad de firmas con la acción Detect que no serán bloqueadas, lo que disminuirá significativamente la seguridad de la información en la organización. A continuación, algunos ejemplos de lo que se puede automatizar:
- Cambiar la firma de IPS de Detect a Prevent. Si las firmas críticas no están siendo bloqueadas por Prevent, esto es un problema y representa una grave brecha en el sistema de protección. Cambiamos la acción en la política para dichas firmas. Esta funcionalidad se puede implementar si el dispositivo NGFW tiene la funcionalidad de REST API. Esto es posible solo al poseer habilidades de programación, ya que necesitas extraer la información necesaria de Elasticsearch y ejecutar llamadas API en el servidor de gestión de NGFW.
- Si desde una dirección IP en el tráfico de red se han detectado o bloqueado múltiples firmas, tiene sentido bloquear temporalmente esta dirección IP en la política del Firewall. La implementación también consiste en usar REST API.
- Iniciar la verificación del host con un escáner de vulnerabilidades si este host presenta un gran número de firmas en el IPS u otros medios de seguridad; en el caso de OpenVas, se puede escribir un script que se conecte por SSH al escáner de seguridad y ejecute el escaneo.
TS Total Sight
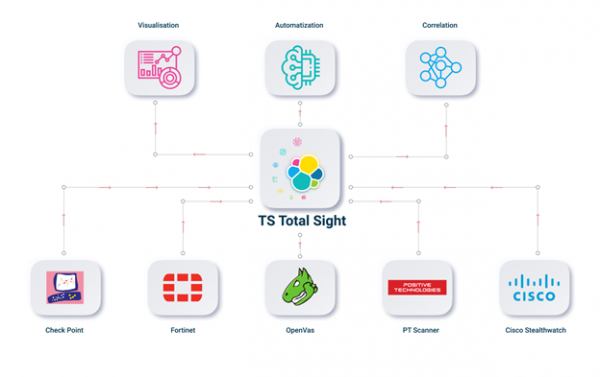
En conjunto, implementar toda la funcionalidad es una tarea muy grande y pesada. Sin habilidades de programación, es posible configurar una funcionalidad mínima que podría ser suficiente para su uso en producción. Pero si le interesa toda la funcionalidad, puede prestar atención a TS Total Sight. Puede conocer más detalles en nuestro . Como resultado, todo el esquema de trabajo y la arquitectura se verán de la siguiente manera:
Conclusión
Hemos examinado lo que se puede implementar utilizando ELK Stack. En los próximos artículos, trataremos más en detalle la funcionalidad de TS Total Sight.
Así que estén atentos a las actualizaciones (, , , ), .
Fuente: habr.com
