

Las profesiones de Data Scientist y Data Engineer a menudo se confunden. Cada empresa tiene su propia especificidad en el manejo de datos, diferentes objetivos de análisis y distintas percepciones sobre quién debe encargarse de qué parte del trabajo, por lo que cada una establece sus propios requisitos.
Vamos a aclarar cuál es la diferencia entre estos especialistas, qué tareas empresariales resuelven, qué habilidades poseen y cuánto ganan. El material resultó extenso, por lo que lo dividimos en dos publicaciones.
En el primer artículo, Elena Gerasimova, jefa de la facultad de "" en Netology, explica cuál es la diferencia entre Data Scientist y Data Engineer y con qué herramientas trabajan.
Cómo se diferencian los roles de ingenieros y científicos de datos
El ingeniero de datos es un especialista que, por un lado, desarrolla, prueba y mantiene la infraestructura para el manejo de datos: bases de datos, almacenamiento y sistemas de procesamiento masivo. Por otro lado, es quien limpia y 'peina' los datos para ser utilizados por analistas y científicos de datos, es decir, que crea tuberías de procesamiento de datos.
El Data Scientist crea y entrena modelos predictivos (y no solo) utilizando algoritmos de aprendizaje automático y redes neuronales, ayudando a las empresas a encontrar patrones ocultos, prever el desarrollo de eventos y optimizar procesos empresariales clave.
La principal diferencia entre Data Scientist y Data Engineer radica en que generalmente tienen objetivos diferentes. Ambos trabajan para que los datos sean accesibles y de calidad. Pero el Data Scientist busca respuestas a sus preguntas y verifica hipótesis en el ecosistema de datos (por ejemplo, sobre Hadoop), mientras que el Data Engineer crea el pipeline para el mantenimiento del algoritmo de aprendizaje automático desarrollado por el científico de datos, en un clúster Spark dentro del mismo ecosistema.
El ingeniero de datos aporta valor al negocio trabajando en equipo. Su tarea es ser un vínculo importante entre los diversos participantes: desde desarrolladores hasta consumidores de informes empresariales, y aumentar la productividad de los analistas — desde marketing y productos hasta BI.
El Data Scientist, por el contrario, participa activamente en la estrategia de la empresa, en la extracción de insights, en la toma de decisiones e implementación de algoritmos de automatización, modelado y generación de valor a partir de datos.
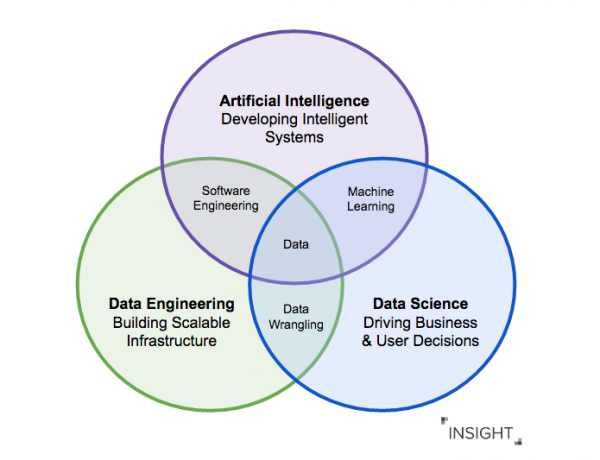
El trabajo con datos se rige por el principio GIGO (garbage in — garbage out): si los analistas y científicos de datos manejan datos no preparados y potencialmente incorrectos, los resultados incluso con los algoritmos de análisis más sofisticados serán incorrectos.
Los ingenieros de datos abordan este problema construyendo pipelines para el procesamiento, limpieza y transformación de datos, permitiendo que los científicos de datos trabajen ya con datos de calidad.
En el mercado hay muchas herramientas para trabajar con datos que cubren cada una de las etapas: desde la aparición de los datos hasta la visualización en un dashboard para el consejo de administración. Y es importante que la decisión sobre su uso sea tomada por el ingeniero, no porque esté de moda, sino porque realmente ayudará a los demás participantes del proceso.
Condicionalmente: si a la empresa le necesita integrar BI y ETL — carga de datos y actualizaciones de informes, aquí hay una infraestructura heredada típica con la que tendrá que lidiar un ingeniero de datos (será bueno si en el equipo además de él hay un arquitecto).
Responsabilidades del Ingeniero de Datos
- Desarrollo, construcción y mantenimiento de la infraestructura para el trabajo con datos.
- Manejo de errores y creación de pipelines de procesamiento de datos confiables.
- Conversión de datos no estructurados de diversas fuentes dinámicas a un formato necesario para el trabajo de los analistas.
- Proporcionar recomendaciones para mejorar la consistencia y calidad de los datos.
- Asegurar y mantener la arquitectura de datos utilizada por los científicos de datos y analistas de datos.
- Procesar y almacenar datos de manera consistente y eficiente en un clúster distribuido de decenas o cientos de servidores.
- Evaluar los compromisos técnicos de las herramientas para crear arquitecturas simples pero robustas que puedan soportar fallos.
- Control y soporte de flujos de datos y sistemas relacionados (configuración de monitoreo y alertas).
Hay otra especialización dentro de la trayectoria de Ingeniero de Datos: ingeniero de ML. En resumen, estos ingenieros se especializan en llevar modelos de aprendizaje automático a implementación y uso industrial. A menudo, el modelo que proviene del científico de datos es parte de una investigación y puede no funcionar en condiciones reales.
Responsabilidades del Científico de Datos
- Extracción de características de los datos para la aplicación de algoritmos de aprendizaje automático.
- Uso de diversas herramientas de aprendizaje automático para predecir y clasificar patrones en los datos.
- Mejora del rendimiento y la precisión de los algoritmos de aprendizaje automático mediante la sintonización y optimización de los mismos.
- Formulación de hipótesis 'fuertes' de acuerdo con la estrategia de la empresa, que deben ser verificadas.
Tanto el Data Engineer como el Data Scientist comparten una contribución significativa al desarrollo de una cultura de trabajo con datos, a través de la cual la empresa puede obtener ingresos adicionales o reducir costos.
¿Con qué lenguajes y herramientas trabajan los ingenieros y científicos de datos?
Hoy en día, las expectativas de los especialistas en procesamiento de datos han cambiado. Antes, los ingenieros recopilaban grandes consultas SQL, escribían manualmente MapReduce y procesaban datos utilizando herramientas como Informatica ETL, Pentaho ETL, Talend.
En 2020, un especialista no puede prescindir del conocimiento de Python y de herramientas modernas para realizar cálculos (como Airflow), así como de entender los principios del trabajo con plataformas en la nube (utilizándolas para ahorrar en hardware, mientras se cumplen los principios de seguridad).
SAP, Oracle, MySQL, Redis son herramientas tradicionales para un ingeniero de datos en grandes empresas. Son buenas, pero el costo de las licencias es tan alto que vale la pena adquirir habilidades en ellas solo en proyectos industriales. Al mismo tiempo, hay una alternativa gratuita en forma de Postgres: es gratuito y apto no solo para la formación.
Históricamente, a menudo se ha requerido conocimiento de Java y Scala, aunque a medida que las tecnologías y enfoques evolucionan, estos lenguajes han quedado en un segundo plano.
Sin embargo, el hardcore BigData: Hadoop, Spark y el resto del zoológico ya no son condiciones obligatorias para un ingeniero de datos, sino más bien una variedad de herramientas para resolver problemas que no se pueden resolver con ETL tradicional.
Está en auge el uso de servicios que permiten utilizar herramientas sin necesidad de conocer el lenguaje en el que están escritas (por ejemplo, Hadoop sin saber Java), así como la provisión de servicios listos para el procesamiento de datos en tiempo real (reconocimiento de voz o imágenes en video).
Las soluciones industriales de SAS y SPSS son populares, mientras que Tableau, Rapidminer, Stata y Julia también son ampliamente utilizadas por los data scientists para tareas locales.
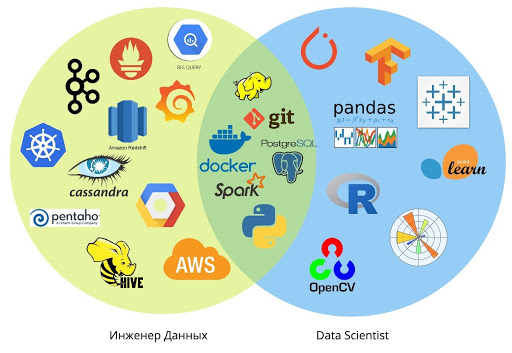
La posibilidad de que los analistas y los científicos de datos construyan sus propios pipelines apareció solo hace un par de años: por ejemplo, ya se pueden dirigir datos a un almacenamiento basado en PostgreSQL con scripts relativamente sencillos.
Normalmente, el uso de pipelines y estructuras de datos integradas queda en manos de los ingenieros de datos. Pero hoy en día, el tendencia hacia especialistas en forma de T, con amplias competencias en áreas relacionadas, es más fuerte que nunca, ya que las herramientas se simplifican constantemente.
Por qué el Data Engineer y el Data Scientist deben trabajar juntos
Al trabajar en estrecha colaboración con los ingenieros, los Data Scientists pueden concentrarse en la parte de investigación, creando algoritmos de aprendizaje automático listos para usar.
Y los ingenieros pueden enfocarse en la escalabilidad, la reutilización de datos y garantizar que los pipelines de entrada y salida de datos en cada proyecto individual cumplan con la arquitectura global.
Esta división de responsabilidades asegura la coherencia de las acciones entre los grupos de especialistas que trabajan en diferentes proyectos de aprendizaje automático.
La colaboración ayuda a crear nuevos productos de manera efectiva. La velocidad y la calidad se logran gracias al equilibrio entre la creación de servicios para todos (almacenamiento global o integración de paneles de control) y la implementación de cada necesidad o proyecto específico (pipeline especializado, conexión de fuentes externas).
Trabajar estrechamente con científicos de datos y analistas ayuda a los ingenieros a desarrollar habilidades analíticas y de investigación para escribir código de mayor calidad. Se mejora el intercambio de conocimientos entre los usuarios de almacenes y lagos de datos, lo que hace que los proyectos sean más flexibles y logran resultados sostenibles a largo plazo.
En las empresas que tienen como objetivo desarrollar una cultura de trabajo con datos y construir procesos de negocio sobre esta base, los Data Scientists y los Data Engineers se complementan y crean un sistema completo de análisis de datos.
En el siguiente artículo, hablaremos sobre la formación que deben tener los Data Engineers y Data Scientists, qué habilidades deben desarrollar y cómo está organizado el mercado.
De la redacción de Netology
Si estás interesado en la profesión de Data Engineer o Data Scientist, te invitamos a explorar los programas de nuestros cursos:
- La profesión de “».
- La profesión de “».
Fuente: habr.com
