

Hola a todos, me llamo Alexander y soy ingeniero de Calidad de Datos, encargado de verificar la calidad de los datos. En este artículo hablaré sobre cómo llegué aquí y por qué, en 2020, esta área de pruebas estuvo en la cresta de la ola.
Tendencia mundial
El mundo de hoy está experimentando otra revolución tecnológica, uno de cuyos aspectos es el uso de datos acumulados por diversas empresas para impulsar su ciclo de ventas, ganancias y relaciones públicas. Se considera que la disponibilidad de buenos (calidad) datos, así como de mentes expertas capaces de convertirlos en dinero (procesamiento correcto, visualización, creación de modelos de aprendizaje automático, etc.), se ha convertido en la clave del éxito para muchos. Si hace 15-20 años el trabajo intensivo con datos y su monetización era el dominio de las grandes empresas, hoy en día es una preocupación de casi todas las que piensan con claridad.
Debido a esto, hace varios años todos los portales dedicados a la búsqueda de empleo en todo el mundo empezaron a verse inundados de ofertas para Científicos de Datos, ya que todos estaban convencidos de que al contratar a un especialista de este tipo podrían construir un supermodelo de aprendizaje automático, predecir el futuro y dar un "salto cuántico" a la empresa. Con el tiempo, las personas se dieron cuenta de que este enfoque casi no funcionaba en ningún lugar, ya que no todos los datos que caen en manos de este tipo de especialistas son adecuados para entrenar modelos.
Y comenzaron las solicitudes de los Científicos de Datos: «Compremos más datos de estos y aquellos...», «Nos faltan datos...», «Necesitamos un poco más de datos y, preferiblemente, de calidad...». Basándose en estas solicitudes, se empezaron a establecer numerosas interacciones entre las empresas que poseen diversos conjuntos de datos. Naturalmente, esto requirió una organización técnica del proceso: conectarse a la fuente de datos, extraerlos, verificar que se hayan cargado en su totalidad, etc. La cantidad de estos procesos ha ido en aumento, y hoy en día hemos llegado a tener una gran demanda de otro tipo de especialistas: ingenieros de Calidad de Datos, que estén encargados de supervisar el flujo de datos en el sistema (data pipelines), de la calidad de los datos en la entrada y en la salida, y que realicen conclusiones acerca de su suficiencia, integridad y otras características.
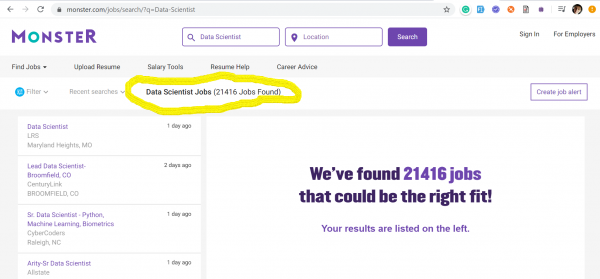
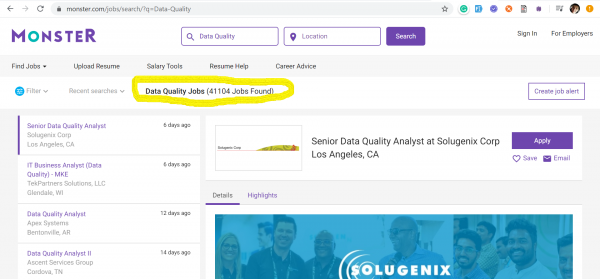
La tendencia hacia los ingenieros de Calidad de Datos nos llegó de Estados Unidos, donde en medio de la era capitalista en plena ebullición, nadie está dispuesto a perder la batalla por los datos. A continuación, presento capturas de pantalla de dos de los sitios de búsqueda de trabajo más populares en Estados Unidos: y — en las que se muestran los datos correspondientes al 17 de marzo de 2020 sobre la cantidad de ofertas de trabajo publicadas, obtenidas por palabras clave: Calidad de Datos y Científico de Datos.
Científicos de Datos – 21416 vacantes
Calidad de Datos – 41104 vacantes
Científicos de Datos – 404 vacantes
Calidad de Datos – 2020 vacantes
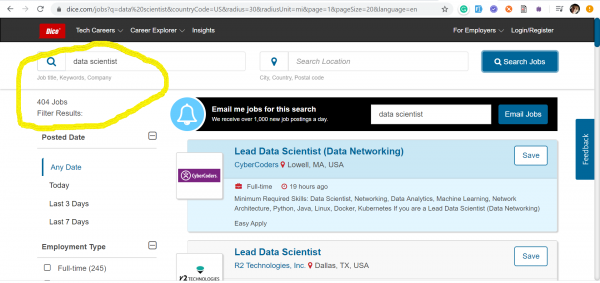
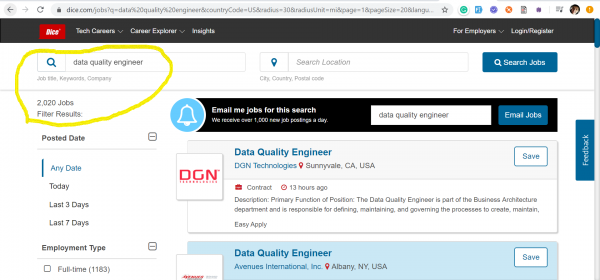
Es evidente que estas profesiones de ninguna manera compiten entre sí. Con las capturas de pantalla quería simplemente ilustrar la situación actual en el mercado laboral en cuanto a la demanda de ingenieros de Calidad de Datos, que actualmente son considerablemente más requeridos que los Científicos de Datos.
En junio de 2019, EPAM, respondiendo a las necesidades del moderno mercado de TI, separó el campo de Calidad de Datos en una práctica independiente. Los ingenieros de Calidad de Datos, en el curso de su trabajo diario, gestionan los datos, verifican su comportamiento en nuevas condiciones y sistemas, y controlan la relevancia de los datos, su suficiencia y actualidad. A pesar de todo esto, en un sentido práctico, los ingenieros de Calidad de Datos realmente dedican poco tiempo a las pruebas funcionales clásicas, PERO esto depende mucho del proyecto (daré un ejemplo más adelante).
Las responsabilidades de un ingeniero de Calidad de Datos no se limitan únicamente a revisiones manuales/automáticas rutinarias sobre "nulls, conteos y sumas" en las tablas de la base de datos, sino que requieren una comprensión profunda de las necesidades comerciales del cliente y, en consecuencia, la capacidad de transformar los datos disponibles en información útil para el negocio.
Teoría de la Calidad de Datos
Para comprender completamente el papel de dicho ingeniero, analicemos qué es la Calidad de Datos en teoría.
Calidad de Datos es uno de los pasos de la Gestión de Datos (un mundo entero que dejaremos para que lo explore usted mismo) y se encarga del análisis de los datos según los siguientes criterios:
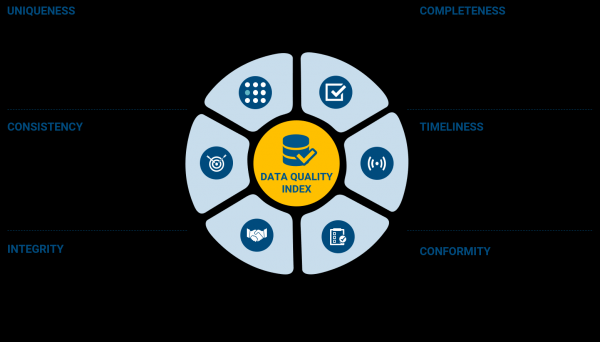
Creo que no es necesario desglosar cada uno de los puntos (en teoría se llaman "dimensiones de datos"), ya que están bien descritos en la imagen. Sin embargo, el proceso de prueba no implica copiar estrictamente estas características en los casos de prueba y verificarlas. En Calidad de Datos, como en cualquier otro tipo de prueba, es fundamental basarse primero en los requisitos de calidad de datos acordados con los participantes del proyecto que toman decisiones comerciales.
Dependiendo del proyecto, un ingeniero de Calidad de Datos puede desempeñar diferentes funciones: desde un simple probador automatizador con una evaluación superficial de la calidad de los datos, hasta una persona que realiza un perfilado profundo basándose en las características mencionadas anteriormente.
Una descripción muy detallada de los procesos de Gestión de Datos, Calidad de Datos y relacionados está excelentemente descrita en el libro titulado "DAMA-DMBOK: Cuerpo de Conocimientos sobre Gestión de Datos: 2ª Edición". Recomiendo mucho este libro como introducción al tema (encontrará el enlace al final del artículo).
Mi historia
En la industria de TI, he recorrido el camino desde probador Junior en empresas de productos hasta Ingeniero Principal de Calidad de Datos en la empresa EPAM. Después de aproximadamente dos años trabajando como probador, tenía la firme convicción de que había realizado absolutamente todos los tipos de pruebas: regresión, funcional, de estrés, de estabilidad, de seguridad, de UI, etc. — y había probado una gran cantidad de herramientas de prueba, trabajando en tres lenguajes de programación: Java, Scala, Python.
Al mirar hacia atrás, entiendo por qué mi conjunto de habilidades profesionales es tan diverso: he participado en proyectos relacionados con el manejo de datos, grandes y pequeños. Esto me llevó a un mundo lleno de herramientas y oportunidades de crecimiento.
Para apreciar la variedad de herramientas y oportunidades de adquirir nuevos conocimientos y habilidades, basta con echar un vistazo a la imagen a continuación, que muestra las más populares en el mundo de "Data & AI".
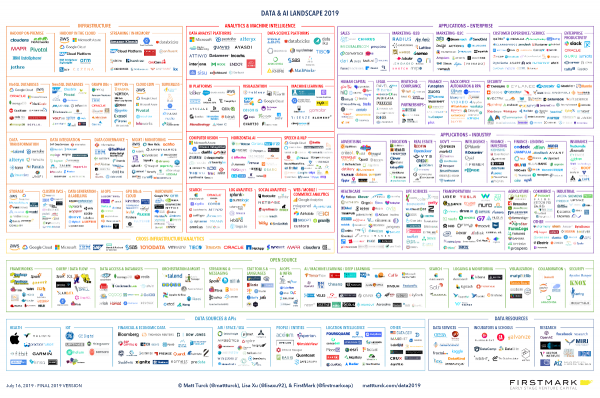
Este tipo de ilustraciones es producido anualmente por uno de los conocidos capitalistas de riesgo, Matt Turck, proveniente del desarrollo de software. Aquí está a su blog y , donde trabaja como socio.
Crecí profesionalmente especialmente rápido cuando era el único tester en el proyecto, o al menos al comienzo del mismo. En ese momento, tienes que ser responsable de todo el proceso de pruebas, sin posibilidad de retroceder, solo avanzar. Al principio, esto asustaba, pero ahora veo claramente todas las ventajas de esta experiencia:
- Comienzas a comunicarte con todo el equipo como nunca antes, ya que no hay ningún intermediario: ni un gerente de pruebas, ni compañeros testers.
- La inmersión en el proyecto se vuelve increíblemente profunda y tienes información sobre todos los componentes tanto en general como en detalle.
- Los desarrolladores no te ven como "el chico de pruebas que no está claro en qué está trabajando", sino más bien como un igual que aporta un valor increíble al equipo con tus pruebas automatizadas y la capacidad de anticipar la aparición de errores en partes específicas del producto.
- Como resultado, eres más eficiente, más cualificado y más demandado.
A medida que el proyecto crecía, en el 100% de los casos me convertía en mentor para los nuevos testers que se unían, les enseñaba y les transmitía los conocimientos que había adquirido. Sin embargo, dependiendo del proyecto, no siempre recibía del liderazgo a especialistas en automatización de pruebas de altísimo nivel, lo que requería ya sea entrenarlos en automatización (para quienes lo deseaban) o crear herramientas para su uso en actividades cotidianas (herramientas para la generación de datos y su carga en el sistema, herramienta para realizar pruebas de carga/pruebas de estabilidad "de manera rápida", etc.).
Ejemplo de un proyecto específico
Desafortunadamente, debido a compromisos de confidencialidad, no puedo hablar detalladamente sobre los proyectos en los que he trabajado, pero presentaré ejemplos de tareas típicas de un Data Quality Engineer en uno de los proyectos.
La esencia del proyecto era implementar una plataforma para preparar datos para entrenar modelos de aprendizaje automático. El cliente era una gran compañía farmacéutica de EE. UU. Técnicamente, era un clúster , desplegado en instancias, con varios microservicios y con un proyecto Open Source de la empresa EPAM como base — , adaptado a las necesidades del cliente específico (actualmente el proyecto ha renacido como ). Los procesos ETL fueron organizados mediante y movían datos desde del sistema del cliente a Buckets. Luego, se desplegaba en la plataforma una imagen de Docker del modelo de aprendizaje automático, que se entrenaba con datos recientes y, a través de una interfaz REST API, proporcionaba predicciones relevantes para el negocio y que resolvían tareas específicas.
Visualmente, todo se veía aproximadamente así:
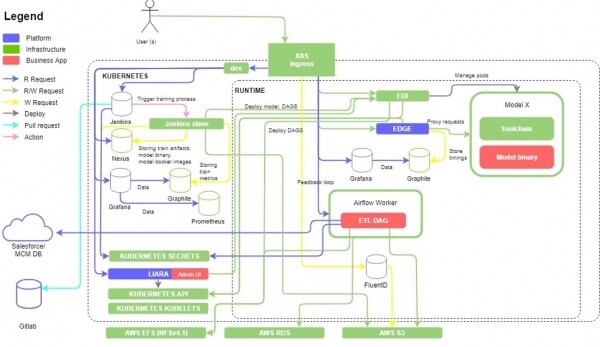
Había suficientes pruebas funcionales en este proyecto, y dada la velocidad de desarrollo de características y la necesidad de mantener el ritmo del ciclo de lanzamientos (sprints de dos semanas), era necesario comenzar a pensar de inmediato en la automatización de las pruebas de los nodos más críticos del sistema. La mayor parte de la propia plataforma con base en Kubernetes estaba cubierta por pruebas automatizadas, implementadas en + Python, pero también era necesario mantener y expandirlos. Además, para la comodidad del cliente, se creó una interfaz gráfica para gestionar los modelos de aprendizaje automático desplegados en el clúster, así como la posibilidad de especificar de dónde y a dónde era necesario trasladar los datos para el entrenamiento de los modelos. Esta amplia adición llevó a la expansión de las verificaciones funcionales automatizadas, que en su mayoría se realizaban a través de llamadas a la API REST y un pequeño número de pruebas UI end-to-end. Aproximadamente a mitad de todo este proceso, se unió a nosotros un tester manual, quien realizó muy bien las pruebas de aceptación de las versiones del producto y se comunicó con el cliente sobre la aceptación de la próxima versión. Además, gracias a la llegada de este nuevo especialista, pudimos documentar nuestro trabajo y añadir algunas verificaciones manuales muy importantes, que eran difíciles de automatizar de inmediato.
Y finalmente, después de lograr estabilidad en la plataforma y la interfaz gráfica sobre ella, comenzamos a construir pipelines ETL utilizando DAGs de Apache Airflow. La verificación automática de la calidad de los datos se llevaba a cabo mediante la creación de DAGs de Airflow especializados que verificaban los datos según los resultados del proceso ETL. En el marco de este proyecto tuvimos suerte, y el cliente nos proporcionó acceso a conjuntos de datos despersonalizados, sobre los cuales hicimos nuestras pruebas. Verificamos los datos línea por línea para cumplir con los tipos, la presencia de datos corruptos, el recuento total de registros antes y después, la comparación de las transformaciones realizadas por el proceso ETL en agregaciones, cambios en los nombres de columnas y más. Además, estas verificaciones se escalaron a diferentes fuentes de datos, como además de SalesForce también a MySQL.
Las comprobaciones de la calidad final de los datos se realizaban ya a nivel de S3, donde se almacenaban y estaban en estado listo para usar para el entrenamiento de los modelos de aprendizaje automático. Para obtener datos del archivo CSV final, que se encontraba en el Bucket S3 y su validación, se escribió código utilizando .
Además, por parte del cliente había un requerimiento de almacenar parte de los datos en un Bucket S3, y parte en otro. Para esto también fue necesario escribir verificaciones adicionales que controlaran la validez de tal clasificación.
Experiencia general en otros proyectos
Ejemplo de la lista más general de actividades de un ingeniero de Calidad de Datos:
- Preparar datos de prueba (válidos, no válidos, grandes y pequeños) a través de una herramienta automatizada.
- Cargar el conjunto de datos preparado en la fuente original y verificar su disponibilidad para su uso.
- Ejecutar procesos ETL para el procesamiento del conjunto de datos desde el almacenamiento original al final o intermedio utilizando un conjunto definido de configuraciones (en caso de que sea posible establecer parámetros configurables para la tarea ETL).
- Verificar los datos procesados por el proceso ETL en cuanto a su calidad y cumplimiento de los requisitos comerciales.
En este caso, el enfoque principal de las verificaciones debe recaer no solo en que el flujo de datos en el sistema haya funcionado correctamente y haya llegado al final (lo cual es parte de las pruebas funcionales), sino en su mayor parte en la verificación y validación de los datos en cuanto a su cumplimiento con los requisitos esperados, identificación de anomalías, entre otros.
Herramientas
Una de las técnicas para este control de datos puede ser la organización de controles en cadena en cada etapa del procesamiento de datos, conocido en la literatura como "cadena de datos" — control de datos desde la fuente hasta el punto de uso final. Este tipo de controles se implementan más comúnmente mediante consultas SQL de verificación. Es evidente que tales consultas deben ser lo más ligeras posible y que verifiquen secciones específicas de la calidad de los datos (metadatos de tablas, líneas en blanco, NULLs, errores de sintaxis — otros atributos de verificación requeridos).
En caso de pruebas de regresión, en las que se utilizan conjuntos de datos ya preparados (inmutables o ligeramente modificados), en el código de las pruebas automatizadas pueden almacenarse plantillas de verificación de datos ya listas para probar su calidad (descripciones de los metadatos de las tablas; objetos de selección aleatoria que pueden elegirse durante la prueba, entre otros).
También durante la prueba es necesario escribir procesos ETL de prueba, utilizando marcos como Apache Airflow, o herramientas tipo black-box en la nube como , y otros. Esta circunstancia lleva al ingeniero de pruebas a profundizar en los principios de funcionamiento de las herramientas mencionadas y a realizar más eficazmente tanto las pruebas funcionales (por ejemplo, de los procesos ETL existentes en el proyecto) como a utilizarlas para la verificación de datos. En particular, para Apache Airflow ya existen operadores listos para trabajar con bases de datos analíticas populares, por ejemplo . El ejemplo más básico de su uso ya ha sido expuesto , por lo que no me repetiré.
Además de las soluciones listas, nadie le prohíbe implementar sus propias técnicas y herramientas. Esto no solo será beneficioso para el proyecto, sino también para el propio ingeniero de calidad de datos, quien de este modo ampliará su horizonte técnico y habilidades de programación.
Cómo funciona en un proyecto real
Una buena ilustración de los últimos párrafos sobre 'cadena de datos', ETL y verificaciones omnipresentes es el siguiente proceso de uno de los proyectos reales:
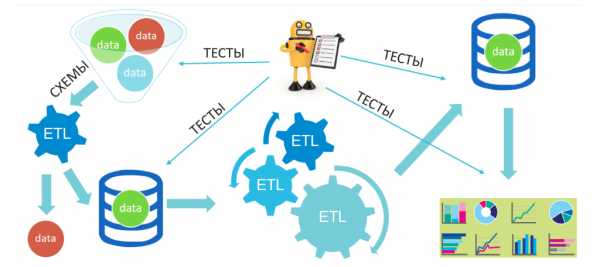
Aquí, en la 'embudo' de entrada de nuestro sistema, llegan diferentes datos (preparados por nosotros, naturalmente): válidos, no válidos, mezclados, etc., luego se filtran y llegan a un almacenamiento intermedio, después de lo cual los datos esperan una serie de transformaciones y se colocan en un almacenamiento final, desde donde se realizará el análisis, la construcción de vitrinas de datos y la búsqueda de insights comerciales. En tal sistema, sin verificar funcionalmente el trabajo de los procesos ETL, nos enfocamos en la calidad de los datos antes y después de las transformaciones, así como en la salida hacia el análisis.
Resumiendo lo anterior, independientemente de los lugares donde he trabajado, siempre estuve involucrado en proyectos de datos que compartían las siguientes características:
- Solo a través de la automatización se pueden verificar algunos casos y alcanzar un ciclo de lanzamiento aceptable para el negocio.
- El evaluador en tal proyecto es uno de los miembros más respetados del equipo, ya que aporta un gran beneficio a cada uno de los participantes (aceleración de las pruebas, buenos datos para el Data Scientist, detección de defectos en las primeras etapas).
- No importa si trabajas en tu propio hardware o en la nube: todos los recursos están abstraídos en clústeres como Hortonworks, Cloudera, Mesos, Kubernetes, etc.
- Los proyectos se construyen sobre un enfoque de microservicios, predominan los cálculos distribuidos y paralelos.
Cabe destacar que, al realizar pruebas en el ámbito de la Calidad de Datos, el especialista en pruebas centra su enfoque profesional en el código del producto y las herramientas utilizadas.
Características distintivas de las pruebas de Calidad de Datos
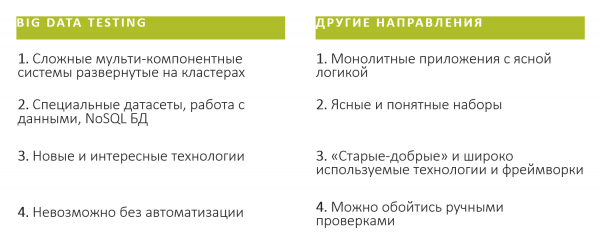
Además, para mí, he destacado las siguientes características (de antemano aclaro que son MUY generales y exclusivamente subjetivas) de las pruebas en proyectos (sistemas) de Datos (Big Data) y otros ámbitos:
Enlaces útiles
- Teoría: .
- EPAM
- Materiales recomendados para un ingeniero de Calidad de Datos principiante:
- Curso gratuito en Stepik: .
- Curso en LinkedIn Learning: .
- Artículos:
- ;
- ;
- ;
- Video:
- ;
- ;
Conclusión
Calidad de Datos — es un campo muy joven y prometedor, ser parte de él significa ser parte de una especie de startup. Al ingresar en la Calidad de Datos, se sumergirá en una gran cantidad de tecnologías modernas y demandadas, pero lo más importante es que se abrirán enormes oportunidades para generar y realizar sus ideas. Podrá aplicar el enfoque de mejora continua no solo en el proyecto, sino también para usted mismo, desarrollándose continuamente como especialista.
Fuente: habr.com
