

Precisamente este tipo de quejas escuché de nuestros desarrolladores. Lo más interesante es que resultó ser verdad, lo que dio inicio a una larga investigación. Hablaremos de los servidores SQL que operan en nuestra VMware.
De hecho, es fácil hacer que el servidor de producción se quede muy atrás en comparación con un laptop. Ejecute (no en tempdb y no en la base con Delayed Durability habilitado) el siguiente código:
set nocount on
create table _t (v varchar(100))
declare @n int=300000
while @n>0 begin
  insert into _t select '¡Qué lentitud!'
  delete from _t
  set @n=@n-1
  end
GO
drop table _t
En mi escritorio, se ejecuta en 5 segundos, mientras que en el servidor de producción — en 28 segundos. Porque SQL debe esperar la finalización física de la escritura en el registro de transacciones, y aquí estamos haciendo transacciones muy cortas. En otras palabras, hemos metido un gran camión potente en el tráfico urbano, y observamos cómo los repartidores de pizza en scooters lo adelantan con facilidad: aquí no importa el throughput, solo la latencia. Y ningún almacenamiento en la red, por mucho que cueste, podrá superar la latencia de un SSD local.
(en los comentarios descubrí que mentí — en ambos lugares había un retraso en la durabilidad. Sin retraso en la durabilidad obtenemos:
Escritorio — 39 segundos, 15K tr/sec, 0.065ms /io roundtrip
PROD — 360 segundos, 1600 tr/sec, 0.6ms
Debí haber prestado atención, que era demasiado rápido)
Sin embargo, en este caso, estamos tratando con ceros triviales de la función de Riemann con un ejemplo trivial. En el ejemplo que me trajeron los desarrolladores, había algo diferente. Me aseguré de que tenían razón y comencé a eliminar toda su especificidad relacionada con la lógica de negocios. En algún momento me di cuenta de que podía descartar completamente su código y escribir el mío, que demuestra el mismo problema — en producción se ejecuta de 3 a 4 veces más lento:
create function dbo.isPrime (@n bigint)
returns int
as
  begin
  if @n = 1 return 0
  if @n = 2 return 1
  if @n = 3 return 1
  if @n % 2 = 0 return 0
  declare @sq int
  set @sq = sqrt(@n)+1 -- check odds up to sqrt
  declare @dv int = 1
  while @dv < @sq
    begin
	set @dv=@dv+2
	if @n % @dv = 0 return 0
	end
  return 1
  end
GO
declare @dt datetime set @dt=getdate()
select dbo.isPrime(1000000000000037)
select datediff(ms,@dt,getdate()) as ms
GO
Si todo va bien, la verificación de primalidad de un número tomará de 6 a 7 a 8 segundos. Así fue en varios servidores. Pero en algunos casos la verificación tomó de 25 a 40 segundos. Lo interesante es que no hubo servidores donde la ejecución tomara, digamos, 14 segundos — el código funcionaba ya sea muy rápido o completamente lento, es decir, el problema era, por así decirlo, blanco y negro.
¿Qué hice? Me metí en las métricas de VMware. Todo estaba bien: los recursos eran abundantes, el tiempo de preparación = 0, había suficiente de todo, durante la prueba, tanto en servidores rápidos como en lentos, CPU=100 en un vCPU. Tomé una prueba de cálculo de Pi: la prueba arrojó resultados idénticos en cualquier servidor. Cada vez comenzaba a oler más a magia negra.
Al salir a la granja de DESARROLLO, empecé a jugar con los servidores. Resultó que vMotion de un host a otro puede "curar" un servidor, pero también puede, por el contrario, convertir un servidor "rápido" en "lento". Parece que la cuestión es que algunos hosts tienen un problema... pero... no. Alguna máquina virtual estaba rezagada en el host A pero funcionaba rápido en el host B. Y otra máquina virtual, al contrario, funcionaba rápido en A y se ralentizaba en B. ¡En el host a menudo giraban tanto máquinas "rápidas" como "lentas"!
Desde ese momento, el aire olía claramente a azufre. Porque el problema no podía ser atribuido a ninguna máquina virtual (actualizaciones de Windows, por ejemplo) — ya que se convertía en "rápida" con vMotion. Pero el problema tampoco podía atribuirse al host — ya que en él podían existir tanto máquinas "rápidas" como "lentas". Además, no estaba relacionado con la carga: logré obtener una máquina "lenta" en un host donde no había nada más.
Desesperado, ejecuté Process Explorer de Sysinternals y revisé el stack SQL. En las máquinas lentas, me llamó la atención de inmediato la línea:
ntoskrnl.exe!KeSynchronizeExecution+0x5bf6
ntoskrnl.exe!KeWaitForMultipleObjects+0x109d
ntoskrnl.exe!KeWaitForMultipleObjects+0xb3f
ntoskrnl.exe!KeWaitForSingleObject+0x377
ntoskrnl.exe!KeQuerySystemTimePrecise+0x881 < — !!!
ntoskrnl.exe!ObDereferenceObjectDeferDelete+0x28a
ntoskrnl.exe!KeSynchronizeExecution+0x2de2
sqllang.dll!CDiagThreadSafe::PxlvlReplace+0x1a20
… omitido
sqldk.dll!SystemThread::MakeMiniSOSThread+0xa54
KERNEL32.DLL!BaseThreadInitThunk+0x14
ntdll.dll!RtlUserThreadStart+0x21
Eso ya era algo. Se escribió un programa:
    class Program
    {
        [DllImport("kernel32.dll")]
        static extern void GetSystemTimePreciseAsFileTime(out FILE_TIME lpSystemTimeAsFileTime);

        [StructLayout(LayoutKind.Sequential)]
        struct FILE_TIME
        {
            public int ftTimeLow;
            public int ftTimeHigh;
        }

        static void Main(string[] args)
        {
            for (int i = 0; i < 16; i++)
            {
                int counter = 0;

                var stopwatch = Stopwatch.StartNew();

                while (stopwatch.ElapsedMilliseconds  0)
                {
                    Console.WriteLine("{0}", counter);
                }
            }
        }
    }
Este programa mostró una desaceleración aún más notable: en las máquinas "rápidas" alcanza de 16 a 18 millones de ciclos por segundo, mientras que en las lentas solo un millón y hasta 700 mil. Es decir, la diferencia es de 10 a 20 veces (!!!). Esto ya fue una pequeña victoria: al menos, no había riesgo de quedar atrapado entre el soporte de Microsoft y VMware echándose la culpa mutuamente.
Luego, el progreso se detuvo: vacaciones, asuntos importantes, histeria viral y un aumento drástico de la carga. A menudo mencionaba el problema mágico a mis colegas, pero a veces parecía que ni siquiera me creían — era demasiado monstruoso el comentario de que VMware ralentiza el código de 10 a 20 veces.
Intenté descubrir por mí mismo qué estaba causando la lentitud. A veces creía haber encontrado una solución: activar y desactivar Hot plugs, cambiar la memoria o el número de procesadores a menudo convertía la máquina en "rápida". Pero no de forma permanente. Lo que resultó ser cierto fue que, bastaba con salir y golpear la rueda — es decir, cambiar cualquier parámetro de la máquina virtual
Finalmente, mis colegas americanos de repente encontraron la causa raíz.
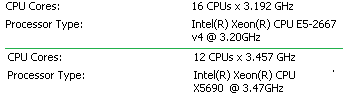
¡Los hosts diferían en su frecuencia!
- En general, esto no es grave. Pero: al migrar de un host 'nativo' a uno con una frecuencia 'diferente', VMware debe ajustar el resultado de GetTimePrecise.
- Por lo general, esto no es crítico, a menos que se trate de una aplicación que solicita la hora precisa millones de veces por segundo, como SQL Server.
- Pero esto tampoco es grave, ya que SQL Server no lo hace todo el tiempo (ver Conclusión)
Sin embargo, hay casos en los que estos tropiezos resultan dolorosos. Y sí, al golpear la rueda (cambiando algo en la configuración de la VM) obligué a VMware a 'recalcular' la configuración, y la frecuencia del host actual se convertía en la 'frecuencia nativa' de la máquina.
Solución
Cuando desactivas la virtualización del TSC, leer el TSC desde dentro de la máquina virtual retorna el valor del TSC de la máquina física, y modificar el TSC desde dentro de la máquina virtual no tiene efecto. Migrar la máquina virtual a otro host, reanudarla desde un estado suspendido o volver a una instantánea causa que el TSC salte de forma discontinua. Algunos sistemas operativos invitados pueden fallar al arrancar o presentar otros problemas de temporización, cuando la virtualización del TSC está desactivada. En el pasado, esta función a veces se recomendaba para mejorar el rendimiento de las aplicaciones que leen el TSC con frecuencia, pero el rendimiento del TSC virtual se ha mejorado sustancialmente en los productos actuales. La función también se recomienda para realizar mediciones que requieren una fuente precisa de tiempo real en la máquina virtual.
En resumen, es necesario agregar el parámetro
monitor_control.virtual_rdtsc = FALSE
Conclusión
Seguramente te has preguntado: ¿por qué se llama a GetTimePrecise tan a menudo en SQL?
No tengo el código fuente del servidor SQL, pero la lógica indica lo siguiente. SQL es casi un sistema operativo con concurrencia cooperativa, donde cada hilo debe ceder de vez en cuando. ¿Y dónde es mejor hacer esto? En aquellos lugares donde hay una espera natural: bloqueo o IO. Bien, ¿qué pasaría si estamos en un bucle de cálculos? Entonces, el lugar obvio y casi único sería en el intérprete (no es exactamente un intérprete), después de ejecutar la siguiente instrucción.
Por lo general, el servidor SQL no se utiliza para clavar clavos de cálculos puros y eso no es un problema. Pero los bucles que trabajan con tablas temporales (que se almacenan en caché de inmediato) convierten el código en una secuencia de instrucciones que se ejecutan muy rápidamente.
Por cierto, si envuelves la función en NATIVELY COMPILED, deja de solicitar tiempo y su velocidad aumenta diez veces. ¿Y qué pasa con el multitasking cooperativo? Pues para el código natively compiled, en SQL se implementó el PREEMPTIVE MULTITASKING.
Fuente: habr.com
