

El informe presenta algunos enfoques que permiten monitorear el rendimiento de las consultas SQL, cuando hay millones al día, y servidores PostgreSQL bajo control, que son cientos.
¿Qué soluciones técnicas nos permiten procesar eficazmente tal volumen de información, y cómo facilita eso la vida del desarrollador común?
A quién le interesa analizar problemas específicos y diversas técnicas de optimización de consultas SQL y resolver tareas típicas de DBA en PostgreSQL — también se puede sobre este tema.
Me llamo Kirill Borovikov, represento a . Específicamente, me especializo en trabajar con bases de datos en nuestra empresa.
Hoy les contaré cómo optimizamos las consultas, cuando no se trata de 'desenterrar' el rendimiento de una única consulta, sino de resolver el problema de manera masiva. Cuando hay millones de consultas, y necesitas encontrar algunas enfoques para resolver este gran problema.
En general, 'Tensor' para un millón de nuestros clientes es : una red social corporativa, soluciones para videoconferencias, para el manejo de documentos internos y externos, sistemas de contabilidad y gestión de inventarios,… Es decir, un 'megacombinador' para la gestión integral de negocios, con más de 100 proyectos internos diferentes.
Para que todos ellos funcionen y se desarrollen adecuadamente — tenemos 10 centros de desarrollo en todo el país, donde hay más de 1000 desarrolladores.
Hemos trabajado con PostgreSQL desde 2008 y hemos acumulado una gran cantidad de información que procesamos — son datos de clientes, datos estadísticos, analíticos, datos de sistemas de información externos — más de 400 TB. Solo 'en producción' hay alrededor de 250 servidores, y en total los servidores de bases de datos que monitoreamos son cerca de 1000.
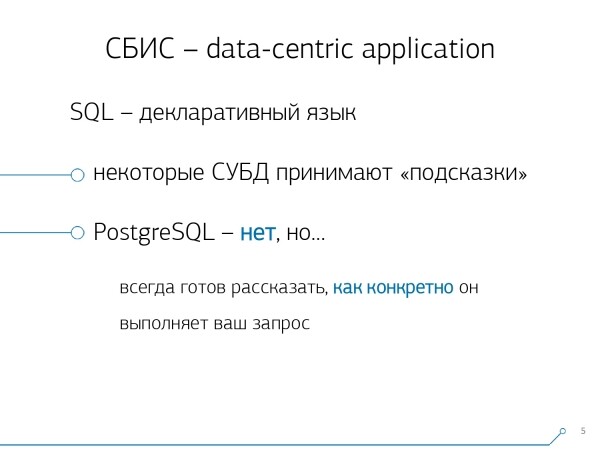
SQL es un lenguaje declarativo. Describe no 'cómo' debe funcionar algo, sino 'qué' quieres obtener. La base de datos sabe mejor cómo hacer un JOIN — cómo unir tus tablas, qué condiciones aplicar, qué irá por índice, qué no...
Algunas bases de datos aceptan sugerencias: 'No, une estas dos tablas en tal orden', pero PostgreSQL no puede hacerlo. Esta es la posición consciente de los principales desarrolladores: 'Es mejor que refine el optimizador de consultas que permitir que los desarrolladores usen sugerencias de este tipo'.
Sin embargo, a pesar de que PostgreSQL no permite la gestión desde "fuera", sí ofrece una excelente manera de ver lo que sucede "dentro" de él, cuando ejecutas tu consulta, y dónde surgen sus problemas.
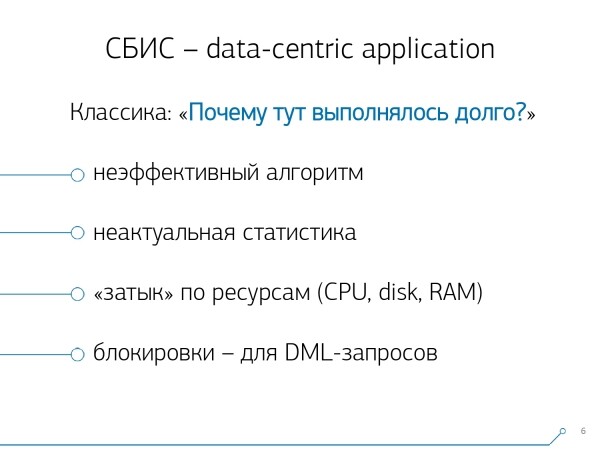
En general, ¿con qué problemas clásicos suele enfrentarse un desarrollador [a DBA]? "Hemos ejecutado la consulta y todo es lento, se ha bloqueado, algo está sucediendo... ¡Es un desastre!"
Las causas son casi siempre las mismas:
- un algoritmo de consulta ineficiente.
Desarrollador: "En SQL tengo 10 tablas a través de JOIN..." y espera que sus condiciones mágicamente se resuelvan de manera eficiente, y obtenga todo rápidamente. Pero no hay milagros, y cualquier sistema con tal variabilidad (10 tablas en un solo FROM) siempre da algún margen de error. [] - estadísticas obsoletas
Este momento es especialmente relevante para PostgreSQL, cuando has "subido" un gran conjunto de datos al servidor, haces una consulta y él está "escaneando" la tabla. Porque ayer tenía 10 registros, y hoy 10 millones, pero PostgreSQL aún no está al tanto de esto, y hay que indicárselo. [] - cuello de botella en recursos
Has instalado una base de datos grande y pesada en un servidor débil, que no tiene suficiente espacio en disco, memoria o rendimiento del propio procesador. Y eso es todo... Hay un límite de rendimiento más allá del cual ya no puedes saltar. - el bloqueo
Es un momento complejo, pero son los más relevantes para diversas consultas modificadoras (INSERT, UPDATE, DELETE) — este es un tema importante por sí mismo.
Obtención del plan
… Y para todo lo demás necesitamos un plan! Necesitamos ver lo que sucede dentro del servidor.
El plan de ejecución de una consulta para PostgreSQL es un árbol que representa el algoritmo de ejecución de la consulta en una forma textual. Es precisamente ese algoritmo que, como resultado del análisis del planificador, fue considerado el más eficiente.
Cada nodo del árbol es una operación: recuperación de datos de una tabla o índice, construcción de un mapa de bits, combinación de dos tablas, unión, intersección o exclusión de selecciones. La ejecución de la consulta implica recorrer los nodos de este árbol.
Para obtener el plan de consulta, la forma más sencilla es ejecutar la sentencia EXPLAIN. Para obtener todos los atributos reales, es decir, ejecutar realmente la consulta en la base — EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Un momento problemático: cuando lo ejecutas, esto sucede «aquí y ahora», por lo que solo es adecuado para depuración local. Si tomas un servidor de alta carga, que está bajo un fuerte flujo de cambios de datos, y ves: «¡Ay! Aquí tenemos una solicitud lenta.se la solicitud.» Media hora, una hora atrás — mientras buscabas y recuperabas esta solicitud de los registros, llevándola nuevamente al servidor, todo tu conjunto de datos y estadísticas cambiaron. Lo ejecutas para depurar — ¡y se ejecuta rápido! Y no puedes entender «por qué», por qué tenga es lento.
Para entender qué estaba sucediendo exactamente en el momento en que la solicitud se ejecuta en el servidor, personas inteligentes escribieron . Está presente en prácticamente todas las distribuciones más comunes de PostgreSQL, y se puede activar fácilmente en el archivo de configuración.
Si entiende que alguna solicitud está tardando más de lo que le indicaste, hace una «foto» del plan de esta solicitud y la escribe junto con el registro..
Parece que todo está bien, vamos al registro y vemos allí… [un montón de texto]. Pero no podemos decir nada sobre él, aparte del hecho de que es un gran plan, porque se ejecutó en 11 ms.
Parece que todo está bien — pero nada está claro sobre lo que realmente sucedió. Porque al observar tal «latido» en texto plano, no se puede entender en absoluto.
Pero incluso aunque no se vea bien, no sea conveniente, hay problemas más graves:
- En el nodo se indica la suma de recursos de todo el subárbol debajo de él. Es decir, simplemente no se puede saber cuánto tiempo se gastó concretamente en este Index Scan — a menos que haya alguna condición anidada debajo. Debemos mirar dinámicamente si hay «hijos» y variables condicionales dentro, CTE — y restar todo esto «en la mente».
- El segundo punto: el tiempo que se indica en el nodo es el tiempo de ejecución único del nodo.Si este nodo se ejecutó como resultado, por ejemplo, de un ciclo a través de los registros de la tabla, varias veces, en el plan se incrementa la cantidad de loops — ciclos de este nodo. Pero el tiempo de ejecución atómico permanece en el plan como antes. Es decir, para entender cuánto se ejecutó este nodo en total, hay que multiplicar uno por el otro — de nuevo, «en la mente».
Con tales circunstancias, entender "¿Quién es el eslabón más débil?" es prácticamente imposible. Por lo tanto, incluso los propios desarrolladores escriben en el "manual" que "Comprender el plan es un arte, que debe aprenderse, la experiencia...".
Pero tenemos 1000 desarrolladores, y no se puede transmitir esta experiencia a cada uno. Yo, tú, él — lo saben, pero alguien por allá — ya no. Tal vez aprenda, tal vez no, pero ya tiene que trabajar — ¿de dónde va a sacar esa experiencia?
Visualización del plan
Por lo tanto, entendimos que para abordar estos problemas necesitamos una buena visualización del plan.
Primero fuimos "por el mercado" — busquemos en Internet qué existe realmente.
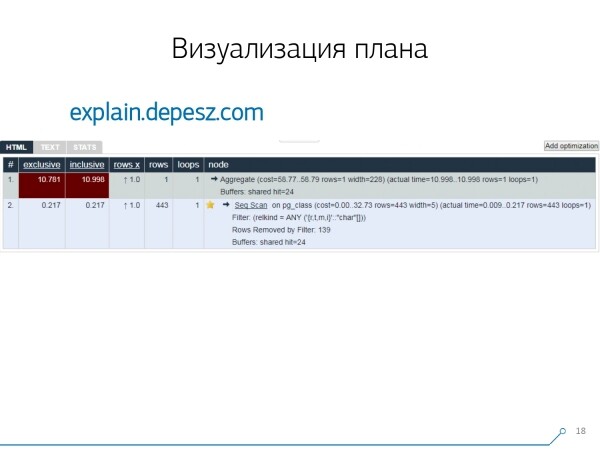
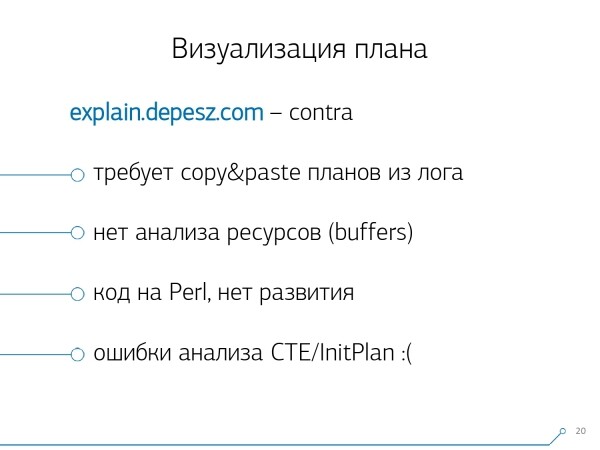
Sin embargo, resultó que hay muy pocas soluciones "vivas" que se desarrollan más o menos, literalmente, una: de Hubert Lubaczewski. Introduces un texto representativo del plan, y él te muestra una tabla con los datos desglosados:
- el tiempo propio de procesamiento del nodo
- el tiempo total de todo el subárbol
- la cantidad de registros que se extrajeron y que se esperaban estadísticamente
- el propio cuerpo del nodo
Además, este servicio tiene la posibilidad de compartir un archivo de enlaces. Echas allí tu plan y dices: "Oye, Vasya, aquí tienes el enlace, hay algo mal ahí."
Pero también hay algunos problemas menores.
En primer lugar, una gran cantidad de "copypaste". Tomas un fragmento del log, lo pones allí, y otra vez, y otra vez.
En segundo lugar, no hay análisis de la cantidad de datos leídos — esos buffers que muestra EXPLAIN (ANALYZE, BUFFERS), aquí no los vemos. Simplemente no sabe cómo desglosarlos, entenderlos y trabajar con ellos. Cuando lees muchos datos y entiendes que puedes equivocarte al "distribuirte" en el disco y en la caché de memoria, esta información es muy importante.
Un tercer punto negativo es el muy bajo desarrollo de este proyecto. Los commits son muy pequeños, bien si uno cada seis meses, y el código está en Perl.
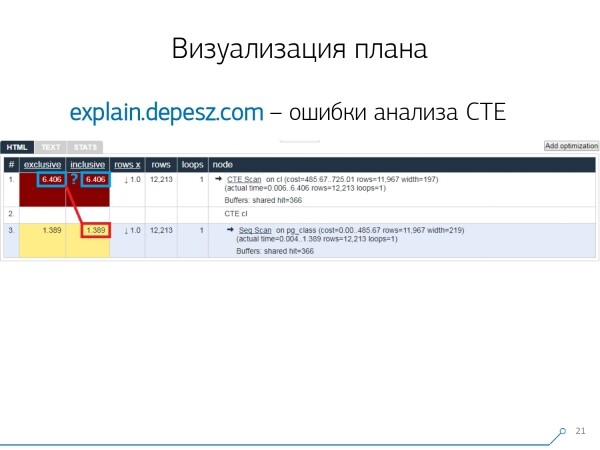
Pero esa es toda "poética", con eso se podría vivir de alguna manera, pero hay una cosa que nos alejó significativamente de este servicio. Son los errores en el análisis de Common Table Expression (CTE) y diferentes nodos dinámicos como InitPlan/SubPlan.
Si creemos en esta imagen, nuestro tiempo total de ejecución de cada nodo individual es mayor que el tiempo total de ejecución de toda la consulta. Es simple — no se restó el tiempo de generación de este CTE del nodo CTE Scan.Por lo tanto, ya no sabemos la respuesta correcta de cuánto duró el escaneo de CTE.
Aquí entendimos que era hora de escribir lo nuestro — ¡hurra! Cada desarrollador dice: “Ahora escribiremos lo nuestro, será súper fácil!”
Tomamos un stack típico para servicios web: núcleo en Node.js + Express, añadimos Bootstrap y para diagramas bonitos — D3.js. Y nuestras expectativas se cumplieron perfectamente: obtuvimos el primer prototipo en 2 semanas:
- un parser de planes propio
Es decir, ahora podemos analizar cualquier plan de los que genera PostgreSQL. - un análisis correcto de nodos dinámicos — CTE Scan, InitPlan, SubPlan
- análisis de la distribución de buffers — donde se leen las páginas de datos desde la memoria, donde desde la caché local, donde desde el disco
- obtenemos claridad
Para no tener que ‘excavar’ todo esto en el registro, sino ver ‘el eslabón más débil’ de inmediato en la imagen.
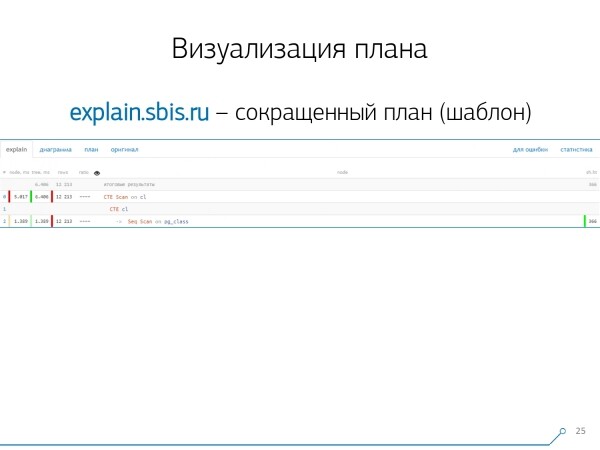
Recibimos una imagen más o menos así — inmediatamente con resaltado de sintaxis. Pero generalmente nuestros desarrolladores trabajan ya no con la representación completa del plan, sino con algo más breve. Después de todo, ya hemos analizado todos los números y los hemos dejado a la izquierda y a la derecha, mientras que en el centro dejamos solo la primera línea, indicando qué nodo es: CTE Scan, generación de CTE o Seq Scan en alguna tabla.
Esta representación reducida la llamamos plantilla de plan.
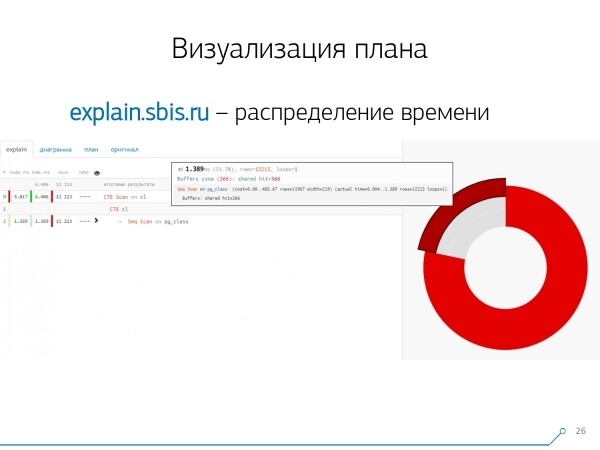
¿Qué más sería conveniente? Sería útil ver qué proporción de tiempo se asigna a cada nodo del tiempo total y simplemente ‘pegarlo’ al lado gráfico de pastel.
Apuntamos al nodo y vemos — resulta que Seq Scan ocupó menos de una cuarta parte del tiempo total, mientras que las otras 3/4 fueron ocupadas por CTE Scan. ¡Horrible! Esto es un pequeño comentario sobre la ‘velocidad’ de CTE Scan, si los usas activamente en tus consultas. No son muy rápidos — incluso pierden frente a un escaneo de tabla normal.
Pero generalmente, estos diagramas son más interesantes, más complejos, cuando apuntamos a un segmento y vemos, por ejemplo, que más de la mitad del tiempo fue ‘devorado’ por un Seq Scan. Además, dentro había algún Filter, se desecharon un montón de registros por él... Esta imagen se puede enviar directamente al desarrollador y decir: ‘Vasiliy, ¡aquí todo está mal! Investiga, mira — algo no está bien!’
Por supuesto, no faltaron las ‘trampas’.
Lo primero en lo que "tropiezamos" fue el problema de redondeo. El tiempo de nodo de cada parte del plan se indica con una precisión de hasta 1 μs. Y cuando el número de ciclos de nodo supera, por ejemplo, 1000, después de ejecutar PostgreSQL se redondea «a la precisión de», entonces al hacer el cálculo inverso obtenemos un tiempo total «en algún lugar entre 0.95 ms y 1.05 ms». Cuando se cuenta en microsegundos, no hay problema, pero cuando ya se trata de [mil]isegundos, hay que tener en cuenta esta información al "deshacer" los recursos por los nodos del plan, "quién consumió cuántos".
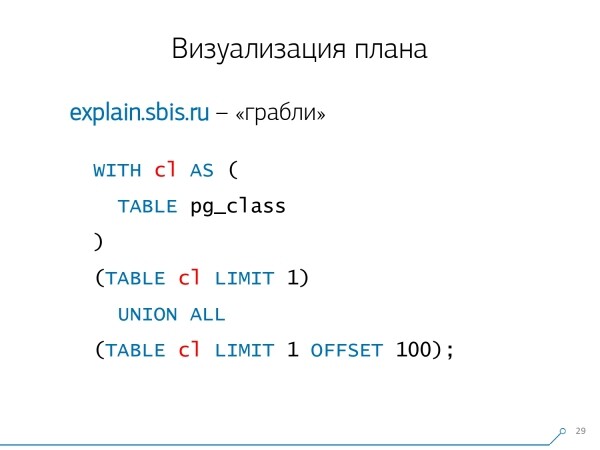
El segundo punto, más complejo, es la distribución de recursos (esos mismos buffers) entre nodos dinámicos. Esto nos costó, las primeras 2 semanas en el prototipo, 4 semanas más.
Obtener un problema así es bastante sencillo: hacemos CTE y en ella supuestamente leemos algo. En realidad, PostgreSQL es "inteligente" y no va a leer nada directamente allí. Luego tomamos el primer registro de ella, y a él le asignamos el centésimo primero del mismo CTE.
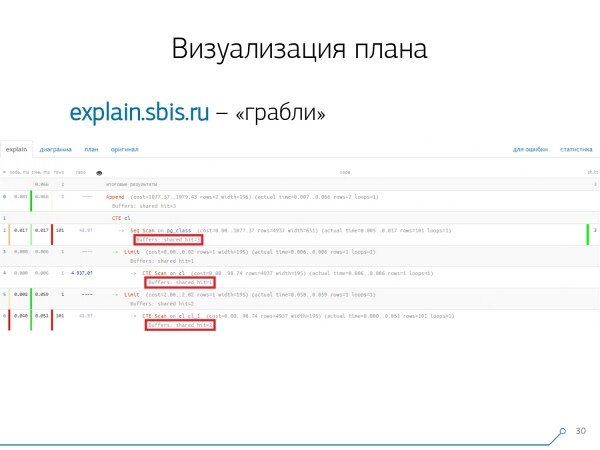
Vemos el plan y entendemos: es extraño, hemos "consumido" 3 buffers (páginas de datos) en Seq Scan, 1 en CTE Scan, y 2 en el segundo CTE Scan. Es decir, si simplemente sumamos, obtendremos 6, pero de la tabla solo leímos 3. El CTE Scan en realidad no lee nada de ningún lado; trabaja directamente con la memoria del proceso. Así que aquí claramente hay algo que no encaja.
De hecho, resulta que estas 3 páginas de datos, que fueron solicitadas en Seq Scan, primero fueron pedidas por el primer CTE Scan, y luego por el segundo, y se le leyeron 2 más. Es decir, realmente se leyeron 3 páginas de datos, no 6.
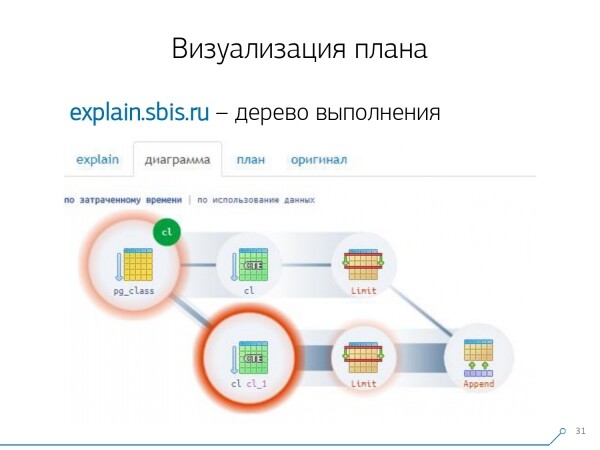
Y esta imagen nos llevó a comprender que la ejecución del plan ya no es un árbol, sino simplemente algún tipo de gráfico acíclico. Y nos resultó un diagrama más o menos así, para que entendamos "qué vino de dónde". Así que aquí creamos CTE a partir de pg_class, y la solicitamos dos veces, y prácticamente todo nuestro tiempo se gastó en la rama cuando la solicitamos por segunda vez. Es evidente que leer el registro 101 es mucho más costoso que simplemente leer el primero de la tabla.

Respiramos aliviados por un tiempo. Dijimos: "Ahora, Neo, ¡sabes kung-fu! Ahora tu experiencia está directamente en tu pantalla. Ahora puedes usarlo."
Consolidación de logs
Nuestros 1000 desarrolladores respiraron aliviados. Pero nosotros entendíamos que solo teníamos cientos de servidores 'en producción', y todo este 'copia y pega' por parte de los desarrolladores no era nada conveniente. Nos dimos cuenta de que teníamos que construir esto nosotros mismos.
De hecho, hay un módulo incorporado que sabe recopilar estadísticas, pero también necesita ser activado en la configuración — este es . Pero no nos satisfizo.
En primer lugar, asigna diferentes QueryId a las mismas consultas en diferentes esquemas dentro de la misma base de datos. Es decir, si primero ejecutamosSET search_path = '01'; SELECT * FROM user LIMIT 1; , y luegoSET search_path = '02'; y hacemos la misma consulta, entonces en las estadísticas de este módulo habrá diferentes entradas, y no podré recopilar estadísticas generales específicamente en ese perfil de consulta, sin tener en cuenta los esquemas. El segundo punto que nos impidió usarlo fue la
falta de planes . Es decir, no hay un plan — solo hay la consulta misma. Vemos qué estaba causando el retraso, pero no entendemos por qué. Y aquí regresamos al problema del conjunto de datos de rápida modificación.Y el último punto —
falta de 'hechos' . Es decir, no se puede hacer referencia a una instancia específica de la ejecución de la consulta — no existe, solo hay estadísticas agregadas. Aunque se puede trabajar con esto, es muy complicado.Por eso decidimos luchar contra el 'copia y pega' y comenzamos a escribir
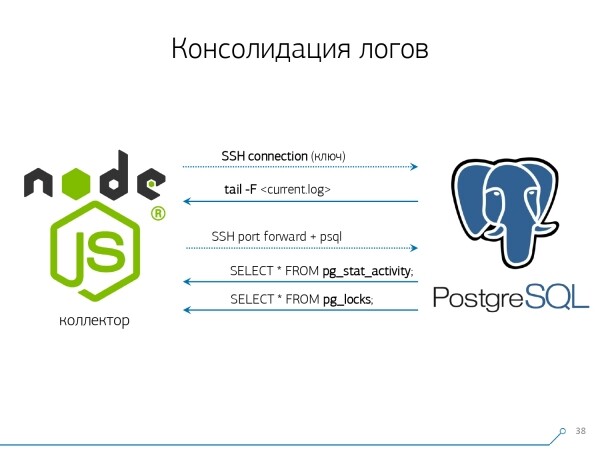
un recolector El recolector se conecta por SSH, 'estira' mediante un certificado una conexión segura hasta el servidor con la base de datos y.
tail -F se 'enganchas' al archivo de registro. Así, en esta sesión obtenemos el 'espejo' completo de todo el archivo de registro , que genera el servidor. La carga en el servidor es mínima, ya que no estamos procesando nada, simplemente estamos reflejando el tráfico.Dado que ya comenzamos a escribir la interfaz en Node.js, continuamos escribiendo el recolector en él. Y esta tecnología ha demostrado su valor, porque trabajar con datos textuales poco estructurados, que es lo que es un registro, es muy conveniente utilizando JavaScript. Además, la infraestructura de Node.js como plataforma backend permite trabajar de manera fácil y cómoda con conexiones de red, y en general con flujos de datos.
Dado que ya comenzamos a escribir la interfaz en Node.js, también continuamos escribiendo el colector en esta misma tecnología. Y esta tecnología se ha justificado, porque para trabajar con datos textuales poco estructurados, que es precisamente lo que son los logs, es muy conveniente utilizar JavaScript. Además, la infraestructura de Node.js, como plataforma de backend, permite trabajar de forma fácil y cómoda con conexiones de red y, en general, con cualquier tipo de flujo de datos.
Por lo tanto, «estiramos» dos conexiones: la primera, para «escuchar» el log y recogerlo, y la segunda, para preguntar periódicamente a la base de datos. «Y en el log llegó la notificación de que la tabla con oid 123 está bloqueada», pero eso no significa nada para el desarrollador, y sería útil preguntar a la base de datos «¿Qué es exactamente el OID = 123?» Y así, preguntamos periódicamente a la base de datos sobre lo que aún no conocemos.
«Solo hay una cosa que no consideraste, ¡hay una especie de abejas semejantes a elefantes!..» Comenzamos a desarrollar este sistema cuando queríamos monitorear 10 servidores. Los más críticos según nuestra opinión, en los cuales surgieron problemas complicados de resolver. Pero en el primer trimestre recibimos un centenar para monitorear — porque el sistema «tomó fuerza», todos lo quisieron, a todos les resultó conveniente.
Todo esto debe ser reunido, hay un gran flujo de datos, activo. En esencia, lo que monitoreamos y con lo que sabemos lidiar, es lo que usamos. También utilizamos PostgreSQL como almacenamiento de datos. No hay nada más rápido para «verter» datos en él que el operador. COPY aún no hay.
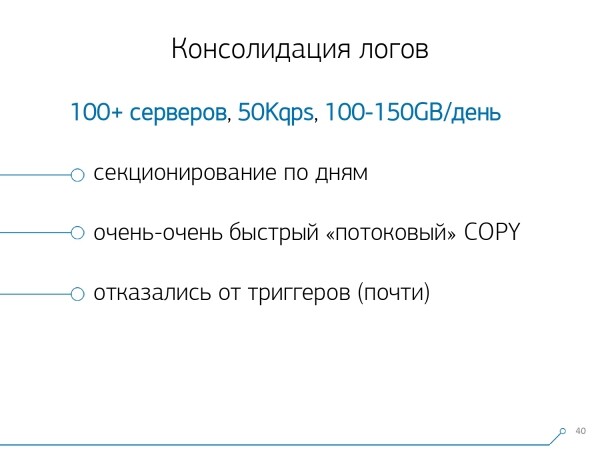
Pero simplemente «verter» datos no es del todo nuestra tecnología. Porque si tienes alrededor de 50 mil solicitudes por segundo en cien servidores, eso genera de 100 a 150 GB de logs al día. Por lo tanto, tuvimos que «desmenuzar» cuidadosamente la base de datos.
Primero, hicimos particionamiento por días, porque, en resumen, a nadie le interesa la correlación entre días. ¿Qué diferencia hay en lo que ocurrió ayer si esta noche lanzaste una nueva versión de la aplicación — y ya hay nueva estadística?
En segundo lugar, aprendimos (tuvimos que) escribir muy, muy rápido con la ayuda de COPY. Es decir, no solo COPY, porque es más rápido que INSERTAR, sino aún más rápido.
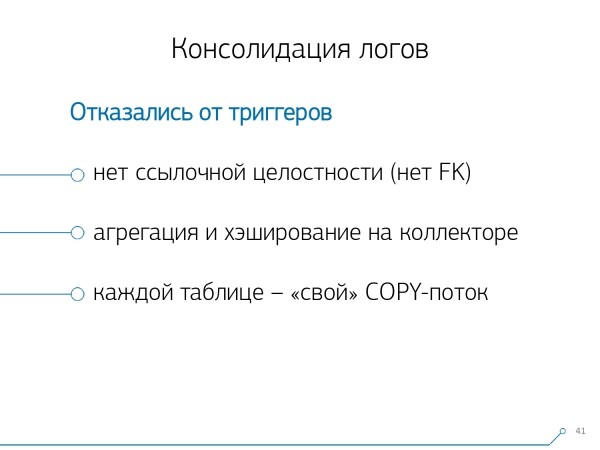
El tercer punto — tuvimos que renunciar a los triggers, y por lo tanto, a las Claves Foráneas. Es decir, no tenemos integridad referencial en absoluto. Porque si tienes una tabla con un par de FK, y dices en la estructura de la base de datos que «este registro del log se refiere por FK, por ejemplo, a un grupo de registros», entonces cuando lo insertas, PostgreSQL no tiene otra opción que tomar y ejecutar honestamente SELECT 1 FROM master_fk1_table WHERE ... con el identificador que estás intentando insertar — simplemente para verificar que ese registro está presente, que no estás «rompiendo» la clave foránea con tu inserción.
En lugar de una entrada en la tabla de destino y sus índices, obtenemos también lecturas de todas las tablas a las que se refiere. Y eso no es lo que queremos: nuestra tarea es escribir la mayor cantidad posible y lo más rápido posible con la menor carga. Así que, ¡fuera las FK!
El siguiente punto es la agregación y el hashing. Inicialmente, los teníamos implementados en la base de datos, ya que es conveniente procesar una entrada en alguna tabla al instante. un «más uno» directamente en el trigger. Bien, es conveniente, pero malo para lo mismo: insertas una entrada y te ves obligado a leer y escribir algo más de otra tabla. Y no solo leer y escribir, sino también hacerlo cada vez.
Y ahora imagina que tienes una tabla en la que simplemente cuentas la cantidad de solicitudes que han pasado por un host específico: +1, +1, +1, ..., +1. Y eso no es realmente necesario, puedes sumarlo en la memoria del colector y enviarlo a la base de datos de una vez +10.
Sí, en caso de algunos problemas lógicos podría “romperse” la integridad, pero es un caso prácticamente irreal — porque tienes un servidor normal, con batería en el controlador, tienes un registro de transacciones, registro en el sistema de archivos... En general, no vale la pena. No merece la pérdida de rendimiento que obtienes por trabajar con triggers/FK, los costos que incurres en ello.
Lo mismo pasa con el hashing. Te llega una solicitud, calculas un identificador en la base de datos, lo escribes en la base y luego se lo comunicas a todos. Todo va bien, hasta que, en el momento de la escritura, te llegue un segundo que quiere escribir el mismo, y se producirá un bloqueo, lo cual es malo. Por lo tanto, si puedes llevar la generación de ciertos ID al cliente (en relación a la base), es mejor hacerlo.
Nos resultó ideal utilizar MD5 del texto: la consulta, el plan, la plantilla,... Lo calculamos en el lado del colector y enviamos a la base un ID ya listo. La longitud de MD5 y la partición diaria nos permiten no preocuparnos por posibles colisiones.
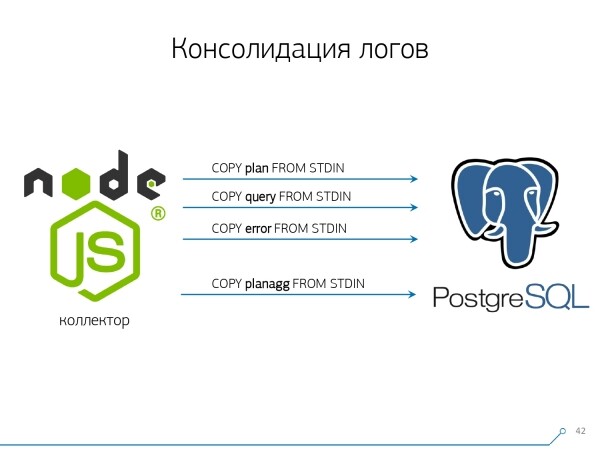
Pero para registrar todo esto rápidamente, necesitamos modificar el propio procedimiento de escritura.
¿Cómo se suelen escribir los datos? Tenemos un conjunto de datos, lo desglosamos en varias tablas y luego usamos COPY: primero en una, luego en otra, en la tercera… Es incómodo, porque parece que estamos escribiendo un flujo de datos en tres pasos de forma secuencial. No es ideal. ¿Se puede hacer más rápido? ¡Se puede!
Para ello, basta con desglosar estos flujos de manera paralela entre sí. Así, tenemos errores, solicitudes, plantillas, bloqueos… fluyendo en diferentes corrientes, y escribimos todo esto en paralelo. Para esto solo es necesario mantener constantemente abierto un canal COPY para cada tabla de destino individual.
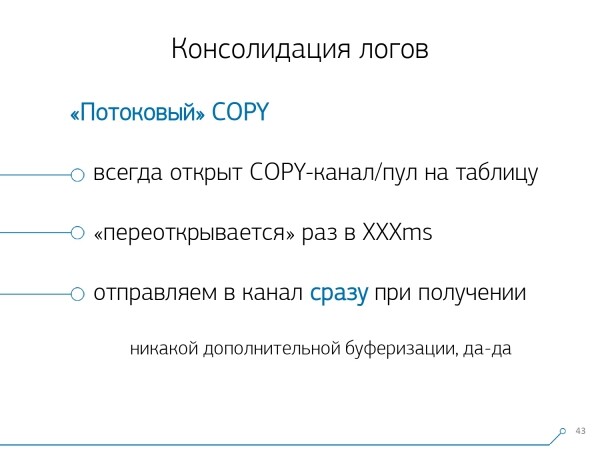
Es decir, el colector siempre tiene un stream, en el que puedo escribir los datos que necesito. Pero para que la base de datos vea estos datos y que nadie esté bloqueado esperando que se escriban, COPY debe interrumpirse con cierta periodicidad. Para nosotros, el período más eficiente resultó ser de aproximadamente 100 ms: cerramos y luego inmediatamente abrimos de nuevo para la misma tabla. Y si un solo flujo no es suficiente en ciertos picos, hacemos pooling hasta un cierto límite.
Además, descubrimos que para este perfil de carga, cualquier agregación, cuando los registros se recopilan en lotes, es un error. El clásico error es INSERT ... VALUES y luego 1000 registros. Porque en ese momento surge un pico de escritura en el medio y todos los demás que intentan escribir en el disco tendrán que esperar.
Para evitar tales anomalías, simplemente no agregues nada, no buffers nada en absoluto. Y si la escritura en disco se produce (afortunadamente, el Stream API en Node.js permite esto), retrasa esa conexión. Cuando recibas el evento de que está libre de nuevo, escribe en él desde la cola acumulada. Mientras esté ocupado, toma el siguiente que esté libre del pool y escribe en él.
Antes de implementar este enfoque para escribir datos, teníamos alrededor de 4K operaciones de escritura; de esta manera, redujimos la carga en 4 veces. Ahora hemos crecido 6 veces más gracias a nuevas bases observables, hasta 100 MB/s. Y ahora almacenamos registros de los últimos 3 meses en un volumen de aproximadamente 10-15 TB, esperando que, en tres meses, cualquier problema pueda ser resuelto por cualquier desarrollador.
Entendemos los problemas
Pero simplemente recopilar todos estos datos es bueno, útil y relevante, pero insuficiente: hay que entenderlos. Porque son millones de diferentes planes por día.
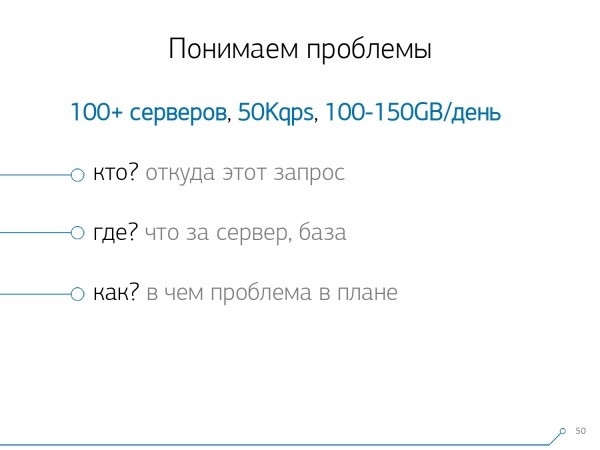
Pero millones son incontrolables, primero hay que hacerlos más "pequeños". Y, en primer lugar, hay que decidir cómo organizar ese "pequeño".
Hemos identificado tres puntos clave:
- quién esta solicitud fue enviada por
Es decir, desde qué aplicación "vino": interfaz web, backend, sistema de pago o algo más. - donde esto ocurrió
En qué servidor específico. Porque si tienes varios servidores bajo una misma aplicación y de repente uno "se ralentiza" (porque "el disco falló", "la memoria falló", alguna otra calamidad), entonces hay que dirigirse específicamente al servidor. - cómo el problema se manifestaba en uno u otro plan
Para entender "quién" nos envió la solicitud, utilizamos un método estándar: establecer una variable de sesión: SET application_name = '{bl-host}:{bl-method}'; — capturamos el nombre del host de la lógica de negocio desde el cual se hizo la solicitud y el nombre del método o aplicación que la inició.
Después de haber pasado el "dueño" de la solicitud, hay que registrarlo en el log; para esto configuramos la variable log_line_prefix = ' %m [%p:%v] [%d] %r %a'. A quien le interese, puede , para ver qué significa todo esto. Por lo tanto, en el log vemos:
- el tiempo
- identificadores de proceso y transacción
- nombre de la base de datos
- IP de quien envió esta solicitud
- y nombre del método
Luego nos dimos cuenta de que no es muy interesante observar la correlación de una sola solicitud entre diferentes servidores. No es común que una misma aplicación falle de la misma manera aquí y allá. Pero incluso si es así, observa cualquiera de estos servidores.
Así que, el desglose "un servidor - un día" resultó ser suficiente para cualquier análisis.
El primer desglose analítico es el mismo "patrón" — una forma abreviada de presentar el plan, depurada de todos los indicadores numéricos. El segundo desglose es la aplicación o método, y el tercero es el nodo específico del plan que nos causó problemas.
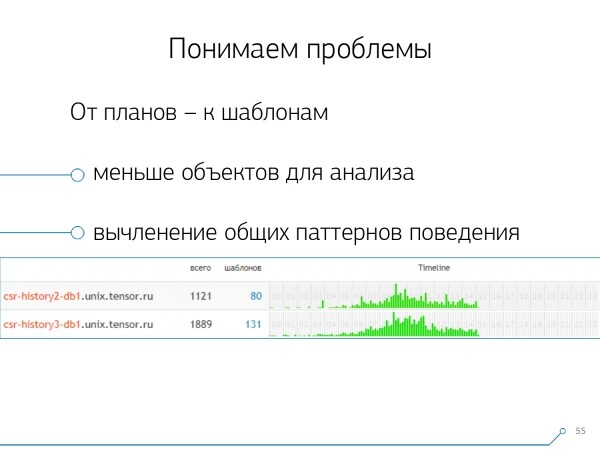
Cuando pasamos de instancias concretas a patrones, obtuvimos de inmediato dos ventajas:
- una reducción drástica en la cantidad de objetos para analizar
Ahora tenemos que analizar el problema no por miles de solicitudes o planes, sino por decenas de patrones. - línea de tiempo
Es decir, al resumir los "hechos" en el marco de algún aspecto, se puede mostrar su aparición a lo largo del día. Y aquí puedes entender que si tienes un patrón que ocurre, por ejemplo, cada hora, cuando debería ser una vez al día, vale la pena reflexionar sobre lo que salió mal: quién lo provocó y por qué, tal vez no debería estar aquí. Este es otro método no numérico, puramente visual, de análisis.
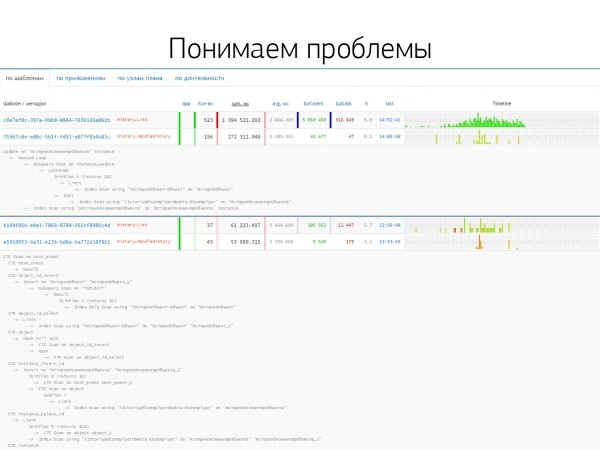
Los otros métodos se basan en los indicadores que extraemos del plan: cuántas veces ocurrió ese patrón, el tiempo total y promedio, cuántos datos se leyeron del disco y cuántos de la memoria...
Porque, por ejemplo, entras a la página de análisis del host, miras y ves que hay un exceso de lecturas del disco. El disco en el servidor no está lidiando bien, ¿y quién está leyendo de él?
Y puedes ordenar por cualquier columna y decidir con qué vas a lidiar ahora mismo: si con la carga del procesador o del disco, o con el total de solicitudes... Ordenas, miras los "top", corriges y lanzas una nueva versión de la aplicación.
Y de inmediato puedes ver diferentes aplicaciones que utilizan el mismo patrón de solicitud tipo SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, procesamiento... Y te cuestionas por qué el procesamiento leería al usuario si no está interactuando con él.
La forma inversa es ver inmediatamente lo que hace la aplicación. Por ejemplo, el frontend es esto, esto, y también esto una vez por hora (justo el timeline ayuda). Y surge la pregunta: parece que no es tarea del frontend hacer algo una vez por hora...
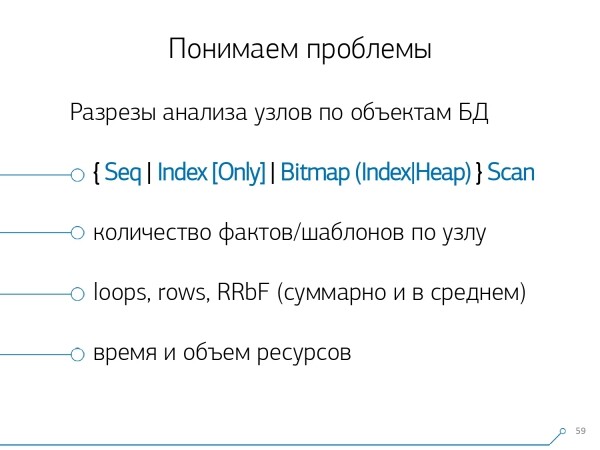
Después de un tiempo, nos dimos cuenta de que nos faltaba estadística agregada en el desglose de nodos del plan.. Extrajimos de los planes solo aquellos nodos que realizan alguna acción con los datos de las tablas (si leen/escriben por índice o no). En esencia, en relación con la imagen anterior, se agrega solo un aspecto más — cuántos registros nos trajo este nodo, y cuántos descartó (Filas Eliminadas por Filtro).
No tienes un índice adecuado en la tabla, haces una solicitud a ella, pasa por alto el índice, cae en Seq Scan... has filtrado todas las entradas excepto una. ¿Por qué necesitarías 100 millones de registros filtrados en un día, no sería mejor tener un índice?
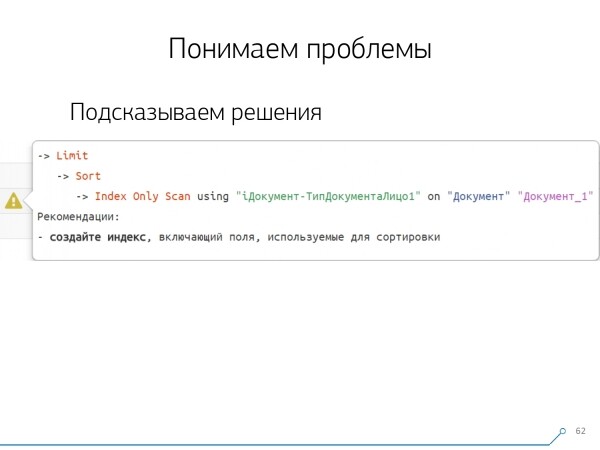
Al analizar todos los planes por nodos, nos dimos cuenta de que hay algunas estructuras típicas en los planes que probablemente parecen sospechosas. Y no estaría de más sugerir al desarrollador: "Amigo, aquí primero lees por índice, luego ordenas y después cortas"; por lo general, hay un solo registro allí.
Todos los que han hecho consultas con ese patrón seguramente se han encontrado con esto: "Dame el último pedido de Vasya, su fecha". Y si no tienes un índice por fecha, o en el índice utilizado no hay fecha, entonces caerás exactamente en esos "palos".
Pero sabemos que son "palos"; ¿por qué no sugerirle al desarrollador desde el principio lo que debe hacer? Por lo tanto, al abrir ahora el plan, nuestro desarrollador ve de inmediato una imagen clara con sugerencias, donde se le dice inmediatamente: "Tienes problemas aquí y aquí, y se resuelven así y así."
Como resultado, la cantidad de experiencia necesaria para resolver problemas al principio y en la actualidad ha disminuido drásticamente. Así que tenemos esta herramienta.
Fuente: habr.com
