

Les propongo revisar la transcripción de la presentación de Nikolay Samokhvalov "Enfoque industrial para la optimización de PostgreSQL: experimentos con bases de datos"
¿Shared_buffers = 25% es mucho o poco? ¿O es justo lo correcto? ¿Cómo entender si esta recomendación, bastante desactualizada, se aplica a su caso específico?
Ha llegado el momento de abordar la selección de parámetros de postgresql.conf de manera "profesional". No a través de "autotuners" ciegos o consejos obsoletos de artículos y blogs, sino basado en:
- experimentos estrictamente controlados en la base de datos, realizados automáticamente, en grandes cantidades y en condiciones lo más cercanas posibles a las "reales".
- una comprensión profunda de las características del funcionamiento del SGBD y del SO.
Utilizando Nancy CLI (), veremos un caso concreto: los famosos shared_buffers, en diferentes situaciones y proyectos y trataremos de entender cómo elegir la configuración óptima para nuestra infraestructura, base de datos y carga.
Vamos a hablar sobre experimentos con bases de datos. Esta es una historia que ha estado en desarrollo durante poco más de seis meses.
Un poco sobre mí. Tengo más de 14 años de experiencia con Postgres. He fundado varias empresas de redes sociales. En todas se ha utilizado Postgres.
También el grupo RuPostgres en Meetup, en segundo lugar en el mundo. Poco a poco nos acercamos a los 2000 miembros. RuPostgres.org.
Y en varios conferencias de PC, incluida Highload, he estado a cargo de bases de datos, especialmente de Postgres desde el principio.
En los últimos años, he reiniciado mi práctica de consultoría de Postgres a 11 zonas horarias desde aquí.
Y cuando lo hice hace algunos años, había tenido un cierto descanso del trabajo manual activo con Postgres, probablemente desde 2010. Me sorprendió lo poco que habían cambiado las rutinas laborales de DBA, cuánta necesidad seguía habiendo de trabajo manual. Y pensé de inmediato que algo no estaba bien, que había que automatizar mucho más.
Y dado que todo esto fue remoto, la mayoría de los clientes estaba en la nube. Y ya se había automatizado mucho, claramente. Hablaremos más de esto más adelante. Es decir, todo esto condujo a la idea de que debería haber una serie de herramientas, es decir, una plataforma que automatice prácticamente todas las acciones de un DBA, para poder gestionar un gran número de bases de datos.
En esta presentación no habrá:
- «Balas de plata» ni afirmaciones como – ponga 8 GB o 25 % de shared_buffers y estará bien. No hablaremos tanto sobre shared_buffers.
- Componentes de hardcore.
¿Y qué pasará?
- Habrá principios de optimización que aplicamos y desarrollamos. Habrá diversas ideas que surgen en nuestro camino y distintas herramientas que creamos en su mayor parte en Open Source, es decir, basamos lo fundamental en Open Source. Además, tenemos tickets, casi toda la comunicación se lleva a cabo en Open Source. Puedes ver lo que estamos haciendo ahora, lo que habrá en la próxima versión, etc.
- También habrá cierta experiencia en el uso de estos principios y herramientas en una variedad de empresas: desde pequeñas startups hasta grandes corporaciones.
¿Cómo se desarrolla todo esto?
Primero, la tarea principal de un DBA, además de asegurar la creación de instancias, la implementación de copias de seguridad, etc., es identificar cuellos de botella y optimizar el rendimiento.
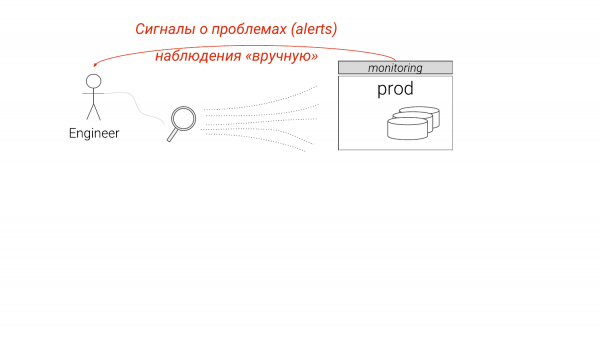
Actualmente, está organizado de esta manera. Miramos el monitoreo, vemos algo, pero nos faltan algunos detalles. Comenzamos a investigar más a fondo, generalmente manualmente, y entendemos qué hacer con ello.
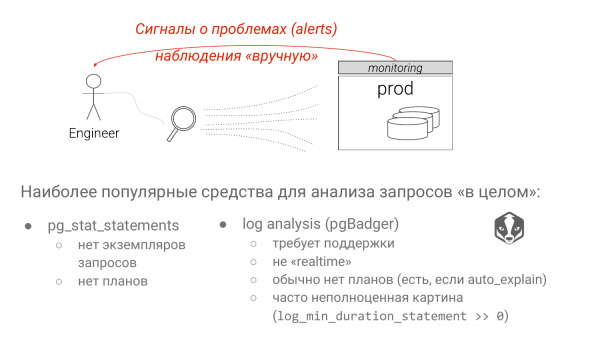
Y hay dos enfoques. Pg_stat_statements es la solución estándar por defecto para identificar consultas lentas. Y el análisis de logs de Postgres utilizando pgBadger.
Cada uno de los enfoques tiene serias desventajas. En el primer enfoque, se descartan todos los parámetros. Si vemos grupos SELECT * FROM table where columna es igual a "?" o "$" a partir de Postgres versión 10, no sabemos si es un escaneo por índice o un escaneo secuencial. Depende mucho del parámetro. Si pones un valor poco frecuente, será un escaneo por índice. Si pones un valor que ocupa el 90 % de la tabla, será un escaneo secuencial, porque Postgres conoce la estadística. Y esta es una gran desventaja de pg_stat_statements, aunque se están realizando algunas mejoras.
El principal inconveniente del análisis de logs es que no puedes permitirte "log_min_duration_statement = 0", por lo general. Y sobre esto también hablaremos. En consecuencia, no ves toda la imagen. Y una consulta que es muy rápida puede consumir una gran cantidad de recursos, pero no la verás porque está por debajo de tu umbral.
¿Cómo resuelven los DBA los problemas encontrados?
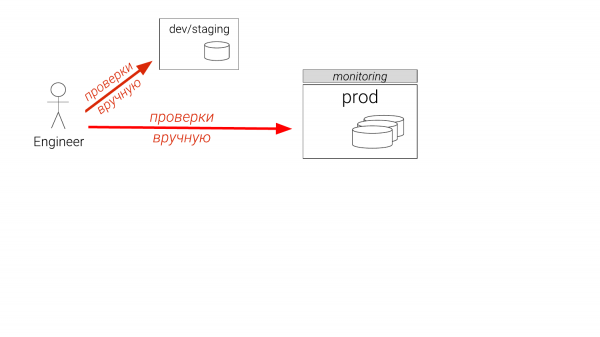
Por ejemplo, encontramos algún problema. ¿Qué se suele hacer? Si eres desarrollador, harás algo en alguna instancia que no es de ese tamaño. Si eres DBA, tienes un staging. Y solo puede haber uno. Y ha estado desactualizado por seis meses. Y piensas en ir a producción. Incluso los DBA experimentados revisan luego en producción, en la réplica. A veces crean un índice temporal, se aseguran de que ayuda, lo eliminan y lo entregan a los desarrolladores para que lo incluyan en los archivos de migración. Este tipo de locura sucede ahora. Y es un problema.
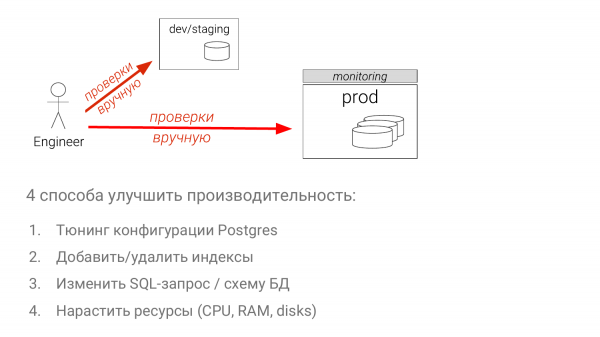
- Ajustar configuraciones.
- Optimizar el conjunto de índices.
- Modificar la propia consulta SQL (este es el método más complicado).
- Aumentar los recursos (el método más sencillo en la mayoría de los casos).
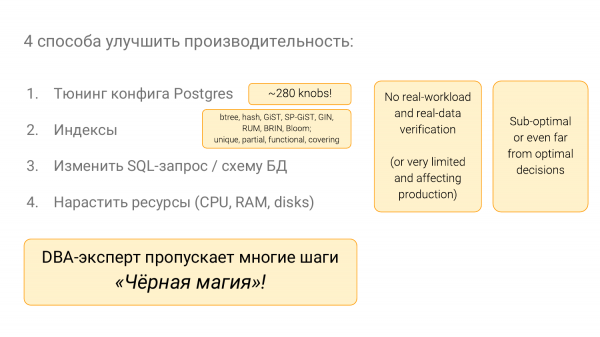
Con estas cosas hay mucho. Hay muchas consideraciones en Postgres. Se necesita saber mucho. Hay muchos índices en Postgres, gracias en parte a los organizadores de esta conferencia. Todo esto hay que conocer, y es precisamente esto lo que provoca en los no DBA la sensación de que los DBA practican magia negra. Es decir, se necesita dedicar unos 10 años para empezar a entender todo esto correctamente.
Y yo soy un luchador contra esta magia negra. Quiero hacer todo de tal manera que haya tecnología y no solo intuición en todo esto.
Ejemplos de la vida real
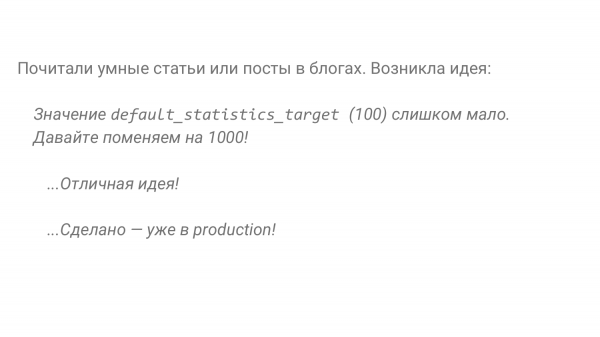
Esto lo he observado en al menos dos proyectos, incluido el mío. Otro post en el blog nos dice que el valor 1,000 para default_statistic_target es bueno. Bien, intentémoslo en producción.
Y aquí estamos, utilizando nuestra herramienta dos años después, con experimentos sobre las bases de datos de las que hablamos hoy, podemos comparar lo que era y lo que es ahora.
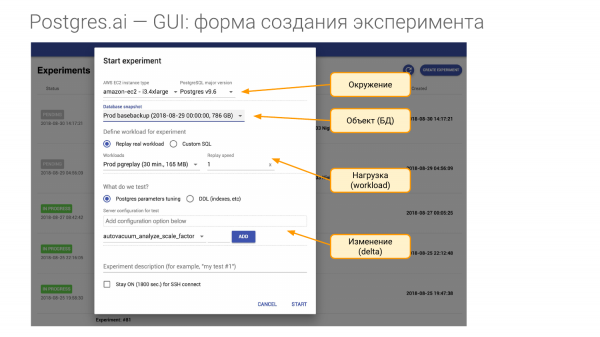
Y para esto necesitamos crear un experimento. Consiste en cuatro partes.
- La primera es el entorno. Necesitamos hardware. Y cuando llego a alguna empresa y firmo un contrato, digo que me den un hardware igual al de producción. Para cada uno de sus Maestros necesito al menos un hardware igual. Ya sea una máquina virtual en Amazon o en Google, o necesito exactamente el mismo hardware. Es decir, quiero recrear el entorno. Y en el concepto de entorno incluimos la versión mayor de Postgres.
- La segunda parte es el objeto de nuestra investigación. Es la base de datos. Se puede crear de varias maneras. Mostraré cómo.
- La tercera parte es la carga. Este es el momento más complicado.
- Y la cuarta parte es lo que comprobamos, es decir, con qué vamos a comparar. Supongamos que podemos cambiar uno o varios parámetros en la configuración, o podemos crear un índice, etc.
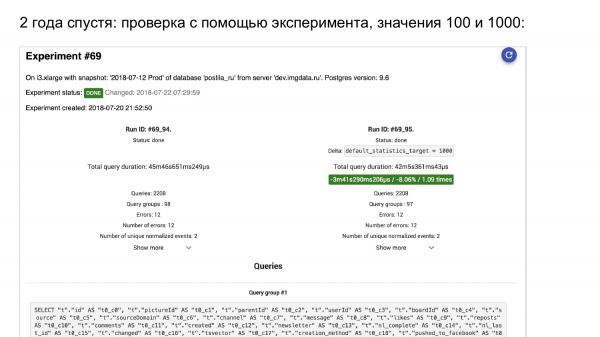
Iniciamos el experimento. Aquí está pg_stat_statements. A la izquierda está lo que había. A la derecha está lo que se ha convertido.
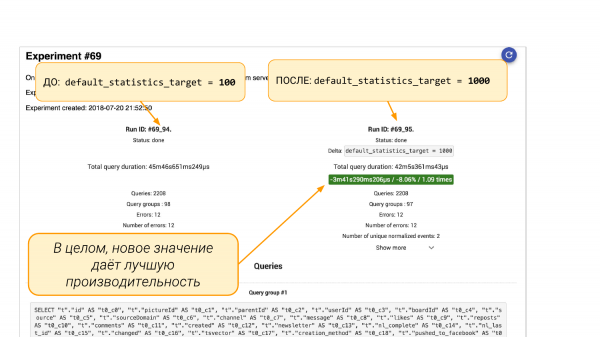
A la izquierda default_statistics_target = 100, y a la derecha = 1 000. Vemos que esto nos ha ayudado. En general, ha mejorado un 8 %.
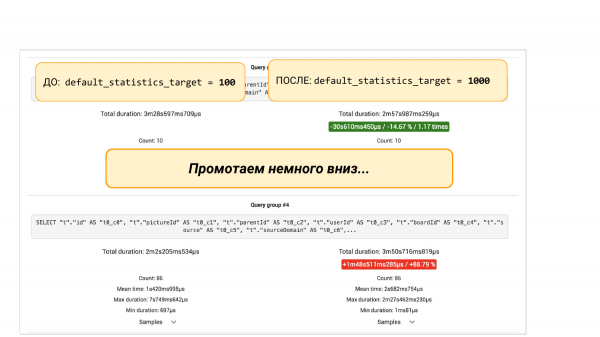
Pero si bajamos un poco, veremos grupos de consultas de pgBadger o de pg_stat_statements. Aquí hay dos opciones. Veremos que alguna consulta ha disminuido un 88 %. Y aquí entra el enfoque ingenieril. Podemos investigar más a fondo porque es interesante saber por qué ha disminuido. Necesitamos entender qué había en la estadística. Por qué más buckets en la estadística conducen a un peor resultado.
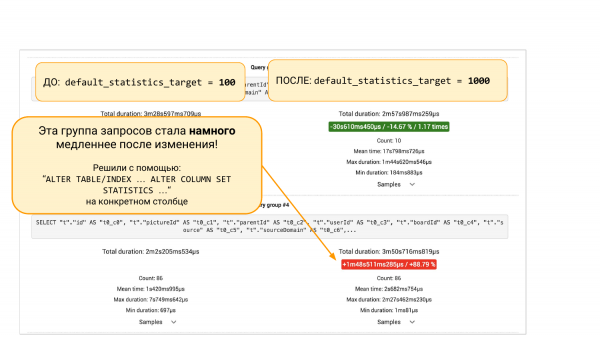
O podemos no investigar y hacer "ALTER TABLE … ALTER COLUMN" y devolver a esta columna 100 buckets en la estadística. Y luego, mediante otros experimentos, podemos asegurarnos de que este parche ha ayudado. Eso es todo. Este es el enfoque ingenieril que nos ayuda a ver el panorama y tomar decisiones basadas en datos, no en intuiciones.
Un par de ejemplos de otras áreas. En las pruebas, existen pruebas de CI desde hace muchos años. Y ningún proyecto en su sano juicio viviría sin pruebas automáticas.
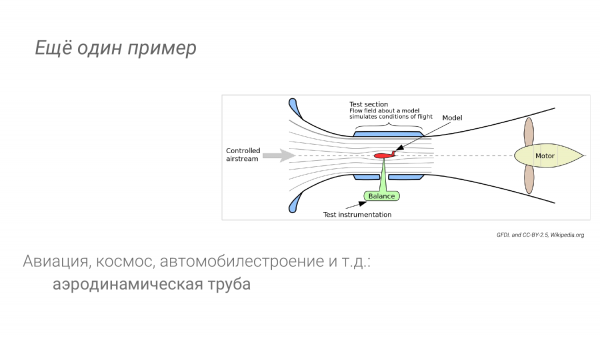
En otras industrias: en la aviación, en la automoción, cuando probamos la aerodinámica, también tenemos la oportunidad de realizar experimentos. No lanzaremos algo del plano directamente al espacio ni sacaremos un coche a la carretera de inmediato. Por ejemplo, existe un túnel de viento.
A partir de las observaciones de otras industrias, podemos sacar conclusiones.
En primer lugar, tenemos un entorno específico. Está cerca de la producción, pero no del todo. Su principal característica es que debe ser económico, repetible y completamente automatizado. Y también deben existir herramientas especiales para realizar un análisis detallado.
Probablemente, cuando lanzamos un avión y volamos, tenemos menos oportunidades de estudiar cada milímetro de la superficie del ala que en un túnel de viento. Tenemos más recursos para el diagnóstico. Podemos permitirnos agregar más cosas pesadas, que no podemos permitirnos en un avión en el aire. Lo mismo pasa con Postgres. En algunos casos, podemos habilitar el registro completo de consultas durante los experimentos. Y no queremos hacer eso en producción. Tal vez incluso lo habilitemos con el uso de auto_explain en los planes.
Y como ya mencioné, un alto nivel de automatización significa que presionamos un botón y repetimos. Así es como debe ser, para tener muchos experimentos, para que sea continuo.
Nancy CLI - la base del "laboratorio de bases de datos"
Y aquí tenemos algo. Es decir, he hablado de estas ideas en junio, hace casi un año. Y ya tenemos en Open Source lo que llamamos Nancy CLI. Esta es la base para construir un laboratorio de bases de datos.
— Esto está en Open Source, en Gitlab. Pueden decirlo, pueden probarlo. He dejado un enlace en las diapositivas. Se puede hacer clic y allí estará en todos los parámetros.
Por supuesto, hay muchas cosas aún en desarrollo. Muchas ideas en cantidad. Pero ya es algo que utilizamos prácticamente a diario. Y cuando se nos ocurre una idea - ¿qué pasa si al borrar 40,000,000 de filas nos encontramos con un problema de IO? Podemos realizar un experimento y observar más de cerca para entender qué está pasando y luego intentar solucionarlo sobre la marcha. Es decir, hacemos un experimento. Por ejemplo, ajustamos algo y vemos cuál es el resultado. Y lo hacemos no en producción. Esa es la esencia de la idea.
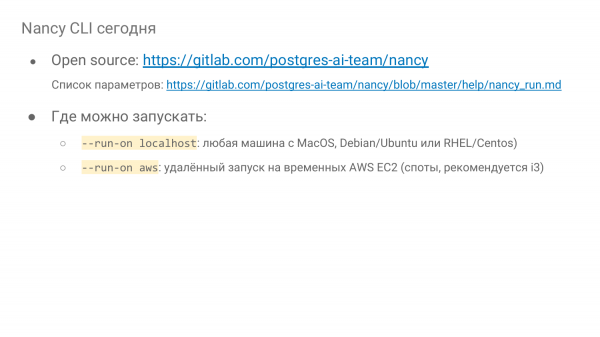
¿Dónde puede funcionar esto? Puede funcionar localmente, es decir, se puede hacer en cualquier lugar, incluso se puede ejecutar en un MacBook. Se necesita Docker, y listo. Se puede ejecutar en algún instance en hardware, o en una máquina virtual, donde sea.
Y también existe la posibilidad de ejecutarlo de forma remota en Amazon EC2 Instance, en instancias spot. Y es una oportunidad realmente excelente. Por ejemplo, ayer realizamos más de 500 experimentos en una instancia i3, comenzando desde la más pequeña hasta la i3-16-xlarge. Y esos 500 experimentos nos costaron 64 dólares. Cada uno duró 15 minutos. Es decir, gracias a que se utilizan instancias spot, es muy barato: un descuento del 70%, con la facturación por segundo de Amazon. Puedes hacer muchísimas cosas. Puedes llevar a cabo una investigación real.
Y se admiten tres versiones principales de Postgres. No es tan difícil adaptar algunas versiones antiguas y la nueva versión 12 también.
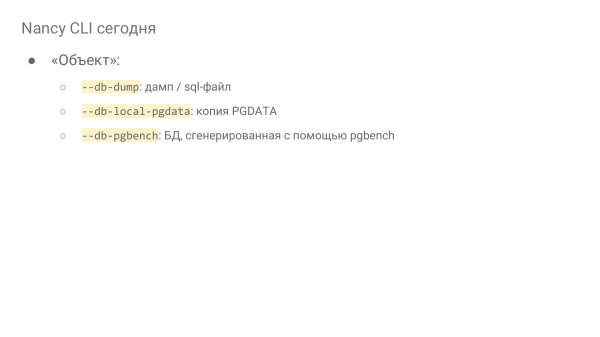
Podemos definir el objeto de tres maneras. Estas son:
- Archivo Dump/sql.
- El método principal es clonar el directorio PGDATA. Normalmente se toma del servidor de respaldo. Si tienes copias de seguridad binarias en buen estado, desde allí puedes hacer clones. Si tienes soluciones en la nube, entonces una empresa de nube como Amazon o Google se encargará de ello por ti. Este es el método principal para los clones de producción real. Así es como justamente hacemos nuestro despliegue.
- Y el último método es adecuado para investigaciones, cuando se quiere entender cómo funciona algo en Postgres. Esto es pgbench. Puedes generar utilizando pgbench. Simplemente hay una opción llamada «db-pgbench». Le dices cuál es el scale. Y todo será generado en la nube, como se indica.
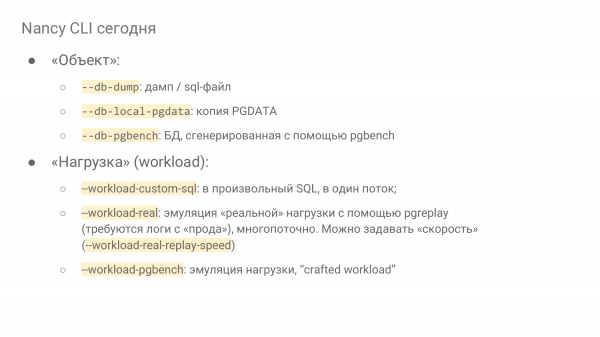
Y la carga:
- Podemos ejecutar la carga en un solo hilo de SQL. Este es el método más primitivo.
- O podemos emular la carga. Y es algo que podemos emular de la siguiente manera. Necesitamos recopilar todos los logs. Y eso puede ser complicado. Te mostraré por qué. Y utilizamos pgreplay, que está integrado en Nancy.
- Otra opción. La llamada carga artesanal, que hacemos con cierto esfuerzo. Analizando nuestra carga actual en el sistema en producción, extraemos los grupos de consultas más importantes. Y con pgbench podemos emular esa carga en el laboratorio.
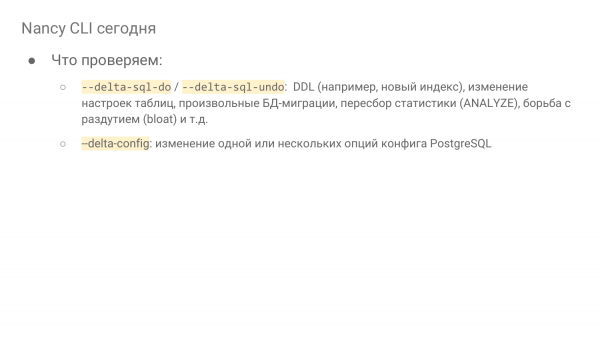
- O tenemos que ejecutar alguna SQL, es decir, verificamos alguna migración, creamos un índice, ejecutamos ANALYZE. Y observamos lo que ocurrió antes y después de un vacuum. En resumen, cualquier SQL.
- O podemos cambiar uno o varios parámetros en la configuración. Podemos pedir que revisen, por ejemplo, 100 valores en Amazon para nuestra base de un terabyte. Y en unas pocas horas tendrás el resultado. Generalmente, la base de un terabyte se desplegará en unas horas. Pero en desarrollo hay un parche, tenemos la posibilidad de hacer una serie, es decir, puedes usar el mismo pgdata en el mismo servidor y hacer verificaciones. Postgres se reiniciará, se borrarán los cachés. Y puedes generar carga.
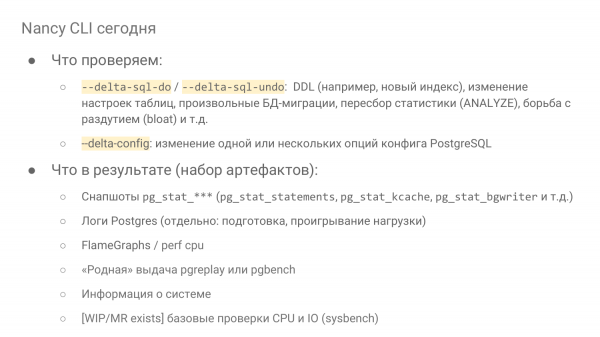
- Llega un directorio que contiene un montón de archivos, comenzando por los snapshots de pg.stat***. Y lo más interesante ahí es pg_stat_statements, pg_stat_kcache. Estos son dos extensiones que analizan las consultas. Y pg_stat_bgwriter contiene no solo la estadística de pgwriter, sino también sobre los checkpoints y cómo los propios backend expulsan los buffers sucios. Y es interesante ver todo esto. Por ejemplo, cuando configuramos shared_buffers, es muy interesante ver cuánto ha sido expulsado.
- También llegan los logs de Postgres. Dos logs: el log de preparación y el log de reproducción de carga.
- Una característica relativamente nueva son los FlameGraphs.
- Además, si has utilizado pgreplay o los variantes de pgbench para la reproducción de carga, tendrás su salida nativa. Y podrás ver la latencia y TPS. Se podrá entender cómo lo vieron.
- Información sobre el sistema.
- Verificaciones básicas de CPU e IO. Esto es más para las instancias de EC2 en Amazon, cuando deseas lanzar 100 instancias iguales en paralelo y hacer 100 diferentes pruebas, tendrás 10,000 experimentos. Y debes asegurarte de que no has obtenido una instancia defectuosa, que ya está sufriendo por otra. En este hardware, otros están activiando y te quedan pocos recursos. Es mejor descartar tales resultados. Justamente con sysbench de Alexey Kopytov hacemos algunas breves verificaciones, que llegarán y se pueden comparar con otras, es decir, entenderás cómo se comporta el CPU y cómo se comporta el IO.
¿Cuáles son las dificultades técnicas a través de diferentes empresas?
Supongamos que queremos reproducir una carga real utilizando logs. Es una excelente idea, si está escrito en Open Source pgreplay. Lo usamos. Pero para que funcione bien, debes habilitar el logging completo de consultas con parámetros y tiempos.
Hay algunas complejidades con respecto a la duración y la marca de tiempo. Vamos a dejar de lado toda esta parte. La pregunta principal es: ¿puede permitírselo o no?
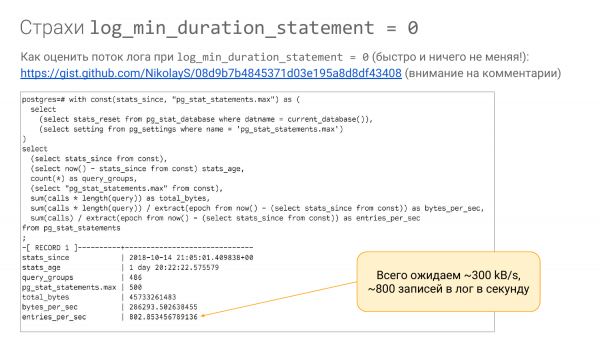
El problema es que esto puede no estar disponible. Primero debe comprender qué flujo se registrará en el log. Si tiene pg_stat_statements, puede utilizar esta consulta (el enlace estará disponible en las diapositivas) para entender cuántos bytes se escribirán por segundo.
Estamos mirando la longitud de la consulta. Ignoramos el hecho de que no hay parámetros, pero conocemos la longitud de la consulta y sabemos cuántas veces se ejecutó por segundo. Así, podemos estimar cuántos bytes aproximadamente por segundo. Podemos equivocarnos en el doble, pero definitivamente entenderemos el orden de magnitud de esta manera.
Podemos ver que esta consulta se ejecuta 802 veces por segundo. Y vemos que se escriben aproximadamente 300 kB/s. Y, por lo general, podemos permitirnos tal flujo.
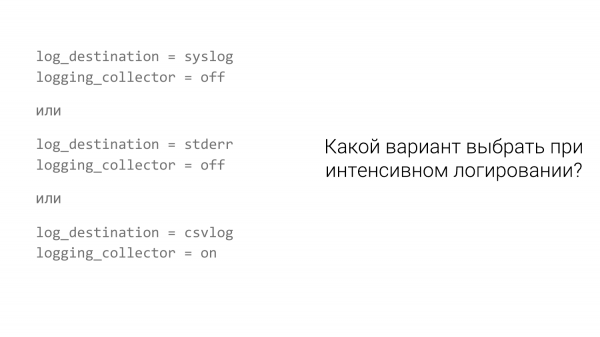
¡Pero! El hecho es que existen diferentes sistemas de registro. Y por defecto, la mayoría de la gente utiliza 'syslog'.
Y si tiene syslog, entonces puede tener una imagen como esta. Tomaremos pgbench, activaremos el registro de consultas y veremos qué sucede.
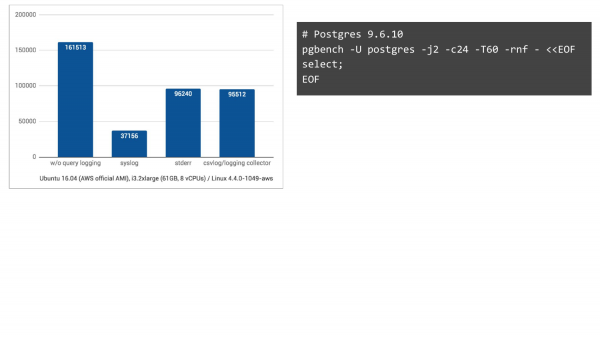
Sin registro, este es el primer columna izquierda. Logramos 161 000 TPS. Con syslog, en Ubuntu 16.04 en Amazon logramos 37 000 TPS. Pero si cambiamos a dos otros métodos de registro, la situación mejora considerablemente. Es decir, esperábamos que disminuiría, pero no tanto.
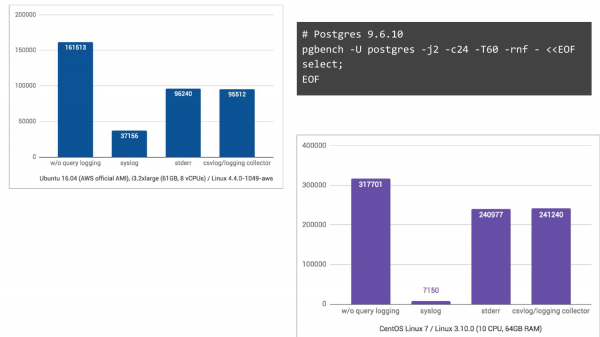
Y en CentOS 7, donde journald también participa, transformando logs en un formato binario para búsqueda conveniente, la situación es un desastre, caemos 44 veces en TPS.
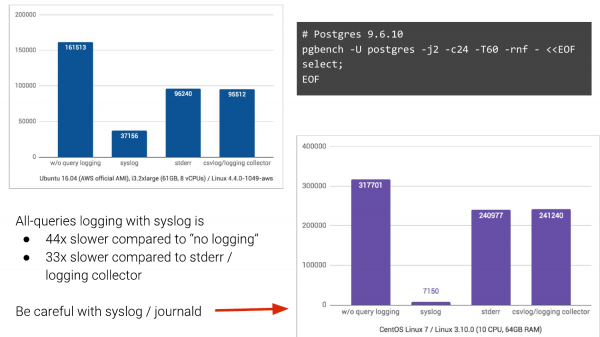
Y con esto viven las personas. Y a menudo en las empresas, especialmente en las grandes, es muy difícil cambiar. Si puede alejarse de syslog, hágalo.
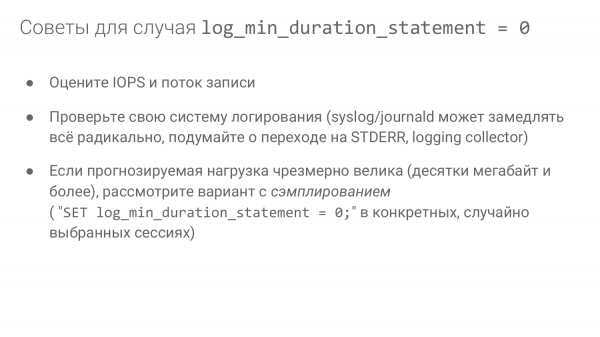
- Evalúe los IOPS y el flujo de escritura.
- Verifique su sistema de registro.
- Si la carga prevista es excesivamente alta, considere la opción de muestreo.
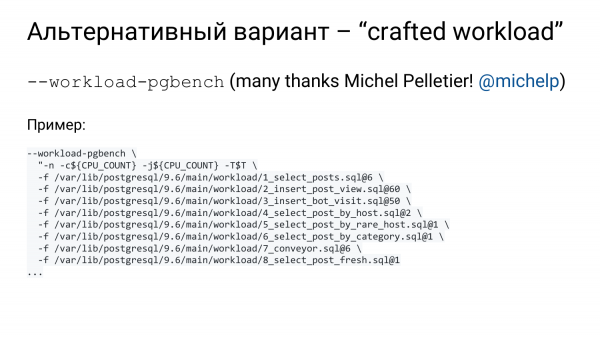
Tenemos pg_stat_statements. Como dije, debe estar incluido. Y podemos tomar y describir cada grupo de consultas de manera especial en un archivo. Y luego podemos utilizar una característica muy conveniente en pgbench: la opción de pasar varios archivos usando la opción '-f'.
Él entiende mucho el «-f». Y se puede decir con «@» al final, qué proporción debería tener cada archivo. O sea, podemos decir que este se ejecute en el 10 % de los casos, y este en el 20 %. Y esto nos acercará a lo que vemos en producción.
¿Y cómo sabremos qué tenemos en producción? ¿Qué proporción y de qué? Aquí hay un pequeño desvío. Tenemos otro producto. . También es una base en Open Source. Y ahora la estamos desarrollando activamente.
Nació un poco por otras razones. Debido a que la monitorización no es suficiente. Es decir, llegas, miras la base, observas los problemas que hay. Y, como regla general, realizas un health_check. Si eres un DBA experimentado, haces un health_check. Observas el uso de índices, etc. Si tienes OKmeter, genial. Es una excelente monitorización para Postgres. OKmeter.io – por favor, instálalo, está todo muy bien hecho. Es de pago.
Si no lo tienes, por regla general, no tienes mucho. En la monitorización normalmente solo hay CPU, IO y eso con explicaciones, y ya está. Y necesitamos más. Necesitamos ver cómo funciona el autovacuum, cómo funciona el checkpoint, y en IO necesitamos separar el checkpoint del bgwriter y de los backend, etc.
El problema es que cuando ayudas a una gran empresa, no pueden implementar algo rápidamente. No pueden comprar OKmeter rápidamente. Quizás lo compren en seis meses. No pueden instalar algunos paquetes rápidamente.
Y se nos ocurrió que necesitamos una herramienta especial que no requiera nada de instalación, es decir, no debes instalar nada en producción. La instalas en tu laptop, o en un servidor de observación, desde donde ejecutarás. Y va a analizar muchas cosas: tanto el sistema operativo, como el sistema de archivos, y Postgres mismo, haciendo algunas consultas ligeras que se pueden ejecutar directamente en producción y no afectarán nada.
La llamamos Postgres-checkup. Si lo miramos médicamente, es un chequeo de salud regular. Si lo relacionamos con el automóvil, es como el mantenimiento. Haces el mantenimiento del coche cada seis meses o un año, dependiendo de la marca. ¿Pero haces mantenimiento para tu base de datos? Es decir, ¿realizas investigaciones profundas regularmente? Se debe hacer. Si haces copias de seguridad, también haz el checkup, es igualmente importante.
Y tenemos una herramienta así. Comenzó a desarrollarse activamente hace solo tres meses. Es aún joven, pero ya tiene muchas características.
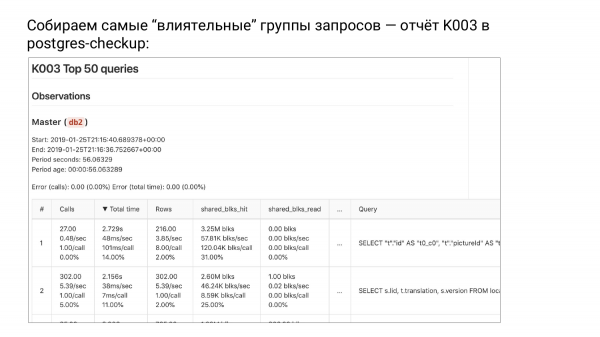
Recopilamos los grupos de consultas más "influyentes" - informe K003 en Postgres-checkup
Y allí hay un grupo de informes K. Por ahora, hay tres informes. Y hay un informe K003. Allí se encuentra la parte superior de pg_stat_statements, ordenada por total_time.
Cuando ordenamos los grupos de consultas por total_time, en la parte superior vemos un grupo que carga nuestra sistema de la manera más intensa, es decir, consume más recursos. ¿Por qué llamo grupos de consultas? Porque hemos eliminado los parámetros. Esto ya no son consultas, sino grupos de consultas, es decir, están abstraídos.
Y si optimizamos de arriba hacia abajo, facilitamos nuestros recursos y retrasamos el momento en que necesitaremos hacer una actualización. Esta es una muy buena forma de ahorrar dinero.
Puede que no sea la mejor forma en términos de atención al usuario, porque tal vez no veamos casos raros, pero muy molestos, en los que una persona esperó 15 segundos. En total, estos son tan raros que no los vemos, pero estamos tratando con los recursos.
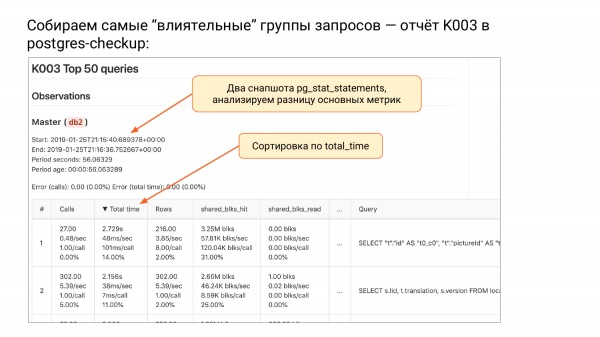
¿Qué ocurrió en esta tabla? Hicimos dos instantáneas. Postgres_checkup te hará una delta por cada métrica: por total-time, calls, rows, shared_blks_read, etc. Todo, ha calculado la delta. El gran problema de pg_stat_statements es que no recuerda cuándo se reinició. Si pg_stat_database recuerda, pg_stat_statements no. Ves que hay un número de 1,000,000, pero no sabemos de dónde se calculó.
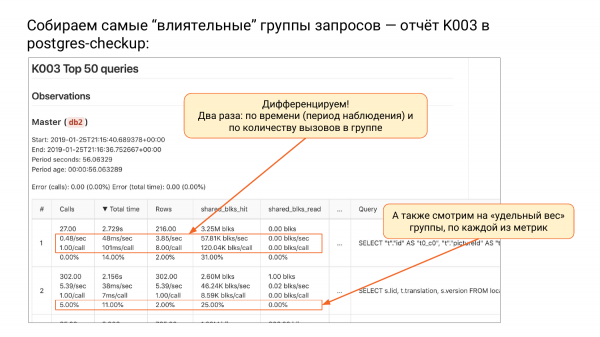
Aquí sabemos, tenemos dos instantáneas. Sabemos que la delta en este caso fue de 56 segundos. Un intervalo muy pequeño. Se ordenó por total_time. Y luego podemos diferenciar, es decir, dividimos todas las métricas por duration. Si dividimos cada métrica por duration, obtendremos el número de llamadas por segundo.
A continuación, total_time por segundo – esta es mi métrica favorita. Se mide en segundos, por segundo, es decir, cuántos segundos le tomó a nuestro sistema ejecutar este grupo de consultas por segundo. Si ves más de un segundo por segundo, significa que necesitabas más de un núcleo. Esta es una muy buena métrica. Puedes entender que esta persona, por ejemplo, necesita un mínimo de tres núcleos.
Esa es nuestra novedad, no he visto algo así en ninguna parte. Fíjate – es algo muy simple – un segundo por segundo. A veces, cuando tienes CPU al 100%, son media hora por segundo, es decir, estuviste media hora solo con estas consultas.
A continuación, vemos filas por segundo. Sabemos cuántas filas por segundo se devolvieron.
Y después también hay algo interesante. Cuántos shared_buffers leímos por segundo desde los propios shared_buffers. Ya hubo aciertos allí, y las filas las tomamos del caché del sistema operativo o del disco. La primera opción es rápida, y la segunda puede ser rápida o no, dependiendo de la situación.
Y la segunda forma de diferenciación es dividir la cantidad de consultas en este grupo. En la segunda columna siempre habrá una consulta dividida por la consulta. Y luego es interesante saber cuántos milisegundos tomó esta consulta. Sabemos cómo se comporta esta consulta en promedio. Requería 101 milisegundos en cada solicitud. Esta es una métrica tradicional que necesitamos para entender.
Cuántas filas devolvió cada consulta en promedio. Vemos que este grupo devuelve 8. Cuántas se tomaron y leyeron del caché en promedio. Vemos que todo está cacheado de maravilla. Son solo aciertos para el primer grupo.
Y la cuarta subcadena en cada fila es cuántos por cientos del total. Tenemos llamadas, supongamos, en 1,000,000. Y podemos entender qué contribución hace este grupo. Vemos que en este caso, el primer grupo contribuye con menos del 0.01%. Es tan lento que no lo vemos en el panorama general. Y el segundo grupo – 5% en las llamadas. Es decir, el 5% de todas las llamadas son del segundo grupo.
También es interesante en cuanto a total_time. En el primer grupo de consultas gastamos el 14% de todo el tiempo de trabajo. En el segundo, el 11%, etc.
No profundizaré en los detalles, pero hay sutilezas. Aquí mostramos un error porque, al comparar, los snapshots pueden variar, es decir, algunas consultas pueden caer y no estar presentes en el segundo, mientras que otras pueden aparecer nuevas. Y allí calculamos el error. Si ves 0, eso es bueno. No hay errores. Si la tasa de error es del 20%, está bien.
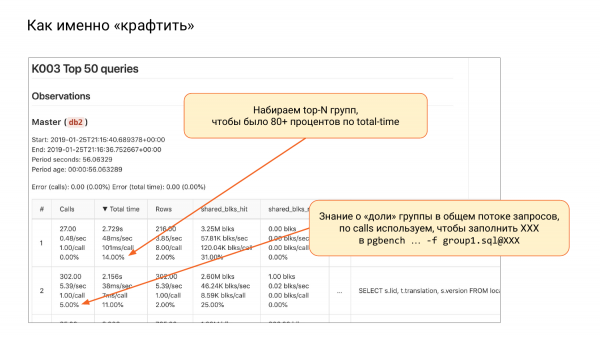
A continuación, volvemos a nuestro tema. Necesitamos elaborar la carga de trabajo. Vamos de arriba hacia abajo, hasta que alcancemos el 80% o 90%. Normalmente son de 10 a 20 grupos. Y hacemos archivos para pgbench. Allí usamos el aleatorio. A veces, desafortunadamente, eso no funciona. Y en Postgres 12 habrá más oportunidades para usar ese enfoque.
Y así es como alcanzamos el 80-90 % del total_time. ¿Qué debemos poner después de «@»? Observamos las llamadas, vemos cuántos porcentajes y entendemos que aquí debemos tener cierto porcentaje. A partir de estos porcentajes, podemos determinar cómo equilibrar cada uno de los archivos. Después de eso, usamos pgbench y comenzamos a trabajar.
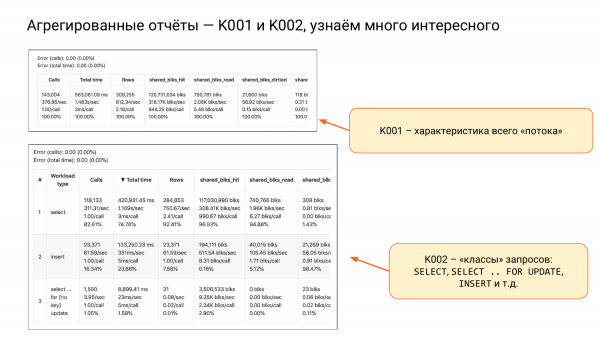
También tenemos K001 y K002.
K001 es una cadena grande con cuatro subcadenas. Esta es la característica de nuestra carga total. Mire la segunda columna y la segunda subcadena. Vemos que son aproximadamente una y media segundos por segundo, es decir, si tuviéramos dos núcleos, estaría bien. Habrá aproximadamente un 75 % de carga. Y funcionará así. Si tuviéramos 10 núcleos, estaríamos completamente tranquilos. De esta manera, podemos evaluar los recursos.
K002 – es lo que llamo clases de consultas, es decir, SELECT, INSERT, UPDATE, DELETE. Y por separado SELECT FOR UPDATE, porque bloquea.
Y aquí podemos concluir que los SELECT normales – 82 % de todas las llamadas, pero a la vez – 74 % del total_time. Es decir, se llaman muchas veces, pero consumen menos recursos.
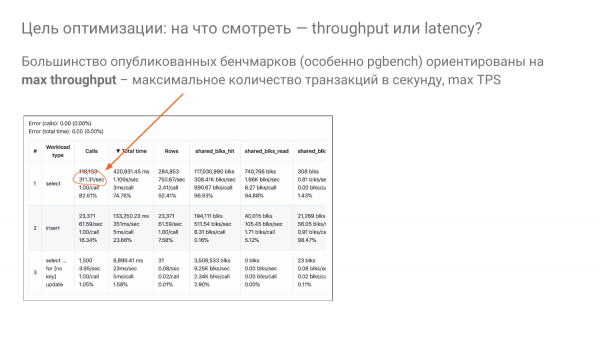
Y volvamos a la pregunta: «¿Cómo ajustamos correctamente el shared_buffers?». Observo que la mayoría de los benchmarks se basan en la idea de – veamos qué throughput habrá, es decir, cuál será la capacidad de procesamiento. Generalmente se mide en TPS o QPS.
Y tratamos de exprimir de la máquina, a través de parámetros de ajuste, la mayor cantidad de transacciones por segundo. Aquí hay justo 311 por segundo para SELECT.
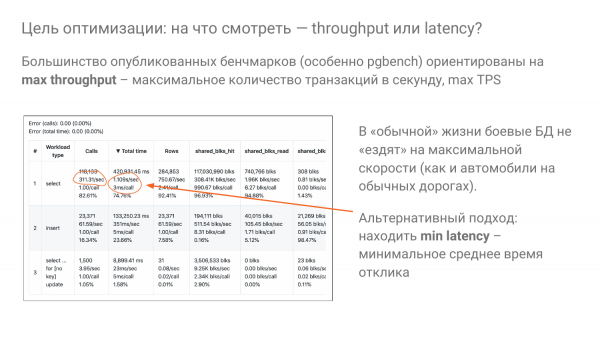
Pero nadie conduce al trabajo y de regreso a casa en su automóvil a toda velocidad. Eso es absurdo. Lo mismo ocurre con las bases de datos. No debemos ir a máxima velocidad, y nadie lo hace. Nadie vive en producción con 100 % de CPU. Aunque, puede que alguien lo haga, pero no es bueno.
La idea es que normalmente funcionamos al 20 % de la capacidad, idealmente no más del 50 %. Y nos esforzamos por optimizar el tiempo de respuesta para nuestros usuarios en primer lugar. Es decir, debemos ajustar nuestras configuraciones para tener la latencia mínima a una velocidad del 20 %, de forma condicional. Esta es una idea que también tratamos de aplicar en nuestros experimentos.
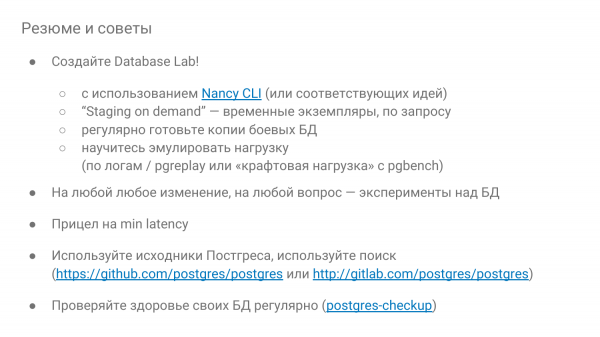
Y para concluir recomendaciones:
- Asegúrese de hacer un Database Lab.
- Si es posible, haga que sea on demand, para que se despliegue por un tiempo – juegue y luego lo elimine. Si tiene nubes, esto es natural, es decir, tenga muchos standing.
- Sé curioso. Y si algo no está bien, haz experimentos para comprobar cómo se comporta. Puedes usar Nancy para formarte y verificar cómo funciona la base.
- Y apunta a un tiempo de respuesta mínimo.
- Y no temas a los códigos fuente de Postgres. Cuando trabajas con los fuentes, debes saber inglés. Hay muchos comentarios, todo está explicado allí.
- Y verifica la salud de la base de manera regular, al menos una vez cada tres meses manualmente o con Postgres-checkup.
Preguntas
¡Muchas gracias! Es una cosa muy interesante.
Dos cosas.
Sí, dos cosas. Solo que no entendí del todo. Cuando trabajamos con Nancy, ¿podemos ajustar solo un parámetro o todo un grupo?
Tenemos el parámetro de configuración delta. Puedes ajustar tantos como quieras al mismo tiempo. Pero hay que entender que, si modificas muchas cosas, puedes llegar a conclusiones erróneas.
Sí. ¿Por qué lo pregunté? Porque es difícil realizar experimentos cuando solo tienes un parámetro. Ajustas uno, miras cómo funciona. Lo estableces. Luego comienzas con el siguiente.
Se puede ajustar simultáneamente, pero depende de la situación, por supuesto. Pero es mejor probar una idea a la vez. Ayer tuvimos una idea. Teníamos una situación muy similar. Había dos configuraciones. Y no podíamos entender por qué había tanta diferencia. Y surgió la idea de que necesitábamos usar dicotomía para entender secuencialmente y encontrar cuál era la diferencia. Puedes hacer la mitad de los parámetros iguales, luego una cuarta parte, etc. Todo es flexible.
Y tengo otra pregunta. El proyecto es joven, está en desarrollo. ¿La documentación ya está lista, hay una descripción detallada?
Hice un enlace a la descripción de los parámetros. Eso existe. Pero aún falta mucho. Busco personas afines. Y las encuentro cuando hablo. Es muy genial. Algunas personas ya están trabajando conmigo, algunas ayudaron y hicieron algo. Y si te interesa este tema, dame tu opinión: ¿qué falta?
Cuando tengamos el laboratorio, tal vez habrá retroalimentación. Veremos. ¡Gracias!
¡Hola! ¡Gracias por la presentación! Vi que hay soporte para Amazon. ¿Está planeado el soporte para GSP?
Buena pregunta. Hemos comenzado a trabajar en ello. Y mientras tanto, lo hemos congelado porque queremos ahorrar. Es decir, hay soporte a través de la ejecución en localhost. Puedes crear tu propia instancia y trabajar localmente. Por cierto, así lo hacemos. En Getlab lo hago así, allí en GSP. Pero no vemos sentido en hacer exactamente esa orquestación por ahora, porque Google no tiene instancias de spot baratas. Hay instancias ???, pero tienen limitaciones. Primero, siempre tienen un descuento del 70 % y no se puede jugar con el precio. En los spots aumentamos el precio entre un 5 y un 10 % para reducir la probabilidad de que te eliminen. Es decir, ahorras en los spots, pero te pueden quitar en cualquier momento. Si estableces tu precio un poco más alto que el de los demás, serás eliminado más tarde. Google tiene una especificidad totalmente diferente. Y hay otra limitación muy desagradable: solo viven 24 horas. Y a veces queremos ejecutar un experimento durante 5 días. Pero en los spots eso se puede hacer, a veces viven meses.
¡Hola! ¡Gracias por la presentación! Mencionaste el checkup. ¿Cómo calculas los errores de stat_statements?
Muy buena pregunta. Puedo mostrar y explicar esto en detalle. En resumen: observamos cómo ha variado un conjunto de grupos de consultas: cuántas se han eliminado y cuántas nuevas han aparecido. Luego miramos dos métricas: total_time y calls, por lo que ahí hay dos errores. Y vemos cuál es la contribución de los grupos que han variado. Hay dos subgrupos: el que se ha ido y el que ha llegado. Observamos cuál es su contribución al panorama general.
¿No temes que se vuelva a procesar dos o tres veces entre los snapshots?
Es decir, ¿se registraron de nuevo o cómo?
Por ejemplo, esta consulta ya fue eliminada una vez, luego llegó y nuevamente fue eliminada, y volvió a llegar y de nuevo fue eliminada. Y aquí has calculado algo, ¿y dónde está todo esto?
Buena pregunta, hay que observar.
Hice algo similar. Por supuesto, fue más simple, lo hice solo. Pero tuve que resetear stat_statements y orientarme en el momento del snapshot, asegurándome de que hubiera menos de cierta proporción, que aún no había llegado al límite de cuántos stat_statements puede acumular. Y me oriento en que, probablemente, no se ha eliminado nada.
Sí, sí.
Pero no entiendo cómo hacerlo de manera confiable de otra forma.
Lamentablemente, no recuerdo con certeza si usamos el texto de la consulta o queryid de pg_stat_statements y nos basamos en eso. Si nos basamos en queryid, entonces, en teoría, estamos comparando cosas comparables.
No, puede ser reemplazado varias veces entre los snapshots y volver otra vez.
¿Con este mismo id?
Sí.
Vamos a estudiarlo. Buena pregunta. Hay que investigar. Pero por ahora, lo que vemos es que tenemos o se escribe un 0...
Esto, por supuesto, es un caso raro, pero me sorprendió cuando supe que stat_statements podría ser reemplazado.
En Pg_stat_statements puede haber muchas cosas. Hemos encontrado que si tienes track_utility = on, entonces también se rastrean las sentencias.
Sí, claro.
Y si tienes java hibernate, que es aleatorio, entonces se bloquea la tabla hash. Y tan pronto como apagas una aplicación muy cargada, tienes de 50 a 100 grupos. Y ahí todo es más o menos estable. Uno de los métodos para combatir esto es aumentar pg_stat_statements.max.
Sí, pero hay que saber cuánto. Y de alguna manera hay que monitorearlo. Así lo hago. Es decir, tengo pg_stat_statements.max. Y veo que en el momento del snapshot no he alcanzado el 70%. Bien, eso significa que no hemos perdido nada. Hacemos un reset. Y acumulamos de nuevo. Si en el siguiente snapshot es menos del 70, significa que probablemente no hemos perdido nada otra vez.
Sí. Por defecto ahora es 5,000. Y a muchos les es suficiente.
Normalmente, sí.
Video:
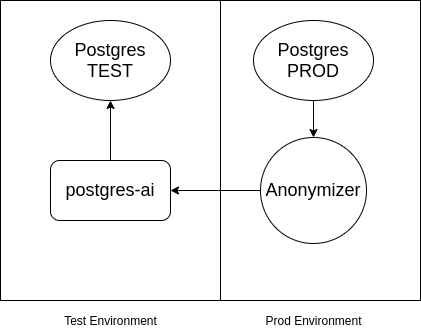
P.S. Agregaré que si en Postgres hay datos confidenciales que no deben ir al entorno de pruebas, se puede utilizar . El esquema es aproximadamente el siguiente:
Fuente: habr.com
