

Les propongo que vean la transcripción de la presentación de principios de 2020 de Georgy Rylov "WAL-G: nuevas oportunidades y expansión de la comunidad"
Los mantenedores de open-source enfrentan muchos problemas a medida que crecen. ¿Cómo escribir cada vez más funciones requeridas, solucionar más problemas y seguir el ritmo de más pull requests? Tomando como ejemplo WAL-G (herramienta de backup para PostgreSQL), les contaré cómo resolvimos estos problemas al lanzar un curso de desarrollo open-source en la universidad, lo que logramos y hacia dónde vamos a continuar.
¡Hola a todos nuevamente! Soy desarrollador en Yandex de Yekaterinburg. Y hoy les hablaré de WAL-G.
En el título de la presentación no se mencionó que se trataba de backups. ¿Alguien no sabe qué es WAL-G? O ¿todos saben? Levante la mano quien no lo sepa. Vaya, vinieron a la charla y no saben de qué trata.
Déjenme contarles qué vamos a hacer hoy. Resulta que nuestro equipo ha estado trabajando en backups desde hace bastante tiempo. Y esta es otra presentación en una serie donde contamos cómo almacenamos datos de manera segura, confiable, conveniente y eficiente.
En episodios anteriores, hubo muchas presentaciones de Andrey Borodin, Vladimir Leskov. Éramos muchos. Y todos hemos estado hablando sobre WAL-G durante muchos años.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Esta presentación será un poco diferente de las demás en que las anteriores se centraban más en la parte técnica, mientras que aquí hablaré sobre cómo enfrentamos los problemas relacionados con el crecimiento de la comunidad. Y cómo ideamos una pequeña idea que nos ayuda a lidiar con ello.
Hace varios años, WAL-G era un proyecto bastante pequeño que heredamos de Citus Data. Solo lo tomamos. Y lo desarrollaba una sola persona.
Y lo que no había en WAL-G era:
- Backup desde una réplica.
- No había backups incrementales.
- No había backups WAL-Delta.
- Y había muchas cosas más que faltaban.
En estos pocos años, WAL-G ha crecido considerablemente.
Y para el año 2020, ya existía todo lo mencionado anteriormente. Y además, ahora tenemos:
- Más de 1 000 estrellas en GitHub.
- 150 forks.
- Alrededor de 15 PR abiertos.
- Y muchos más contribuidores.
- Y issues abiertos constantemente. Y eso a pesar de que entramos allí literal todos los días y hacemos algo al respecto.
Y llegamos a la conclusión de que este proyecto requiere más de nuestra atención, incluso cuando no necesitamos implementar algo para nuestro servicio de Bases de Datos Administradas en Yandex.
Y en algún momento del otoño de 2018 se nos ocurrió una idea. Normalmente, el equipo tiene varias formas de desarrollar características o corregir errores si no hay suficientes manos. Por ejemplo, puedes contratar a otro desarrollador y pagarle. O puedes tomar un pasante por un tiempo y también pagarle un salario. Pero hay un grupo bastante grande de personas, algunas de las cuales ya saben escribir código. Simplemente no siempre sabes qué calidad tiene ese código.
Pensamos y decidimos intentar atraer a estudiantes. Pero los estudiantes no participarán en todo. Solo harán una parte del trabajo. Por ejemplo, escribirán pruebas, corregirán errores y desarrollarán características que no afectan la funcionalidad principal. La funcionalidad principal es la creación de copias de seguridad y la recuperación de copias de seguridad. Si se permite un error en la creación de una copia de seguridad, perderemos datos. Y, por supuesto, nadie quiere eso. Todos quieren que todo sea muy confiable. Por lo tanto, el código en el que confiamos menos que en el nuestro, por supuesto, no queremos permitirlo. Es decir, cualquier código no crítico es lo que nos gustaría recibir de nuestras manos adicionales.
Bajo qué condiciones se acepta un PR de estudiantes
- Deben cubrir su código con pruebas. Todo debe pasar por CI.
- Y también pasamos por 2 revisiones. Una de Andrey Borodin y otra mía.
- Y adicionalmente, para comprobar que esto no romperá nada en nuestro servicio, subo por separado una compilación con este commit. Y comprobamos en las pruebas end-to-end que nada falla.
Curso especial sobre Open Source
Un poco sobre por qué es necesario y por qué creo que es una buena idea.
Para nosotros, el beneficio es obvio:
- Obtenemos manos adicionales.
- Y buscamos candidatos para el equipo entre estudiantes competentes que escriben buen código.
¿Cuál es el beneficio para los estudiantes?
Pueden ser menos obvios, porque los estudiantes, al menos, no reciben dinero por el código que escriben, solo obtienen calificaciones en su registro académico.
Les pregunté sobre esto. Y según sus palabras:
- Experiencia como contribuyente en Open Source.
- Obtener una línea en el CV.
- Demostrarse y pasar la entrevista en Yandex.
- Conviértete en participante de GSoC.
- +1 curso especial para aquellos que quieren escribir código.
No voy a hablar sobre cómo se estructuró el curso. Solo diré que WAL-G fue el proyecto principal. Además, incluimos proyectos como Odyssey, PostgreSQL y ClickHouse en este curso.
Y no solo dábamos tareas en este curso, sino que también otorgábamos diplomas y trabajos de curso.
¿Y cuál es el beneficio para los usuarios?
Ahora pasemos a la parte que probablemente les interesa más. ¿Qué ganan con esto? La ventaja es que los estudiantes repararon muchos errores. Y realizaron solicitudes de funciones que ustedes nos pidieron.
Y déjenme contarles sobre las cosas que ustedes han querido durante mucho tiempo y que se han implementado.
Soporte para tablespaces. Los tablespaces en WAL-G se esperaban, probablemente, desde el lanzamiento de WAL-G, porque WAL-G es el sucesor de otra herramienta de copia de seguridad, WAL-E, donde se admitían copias de seguridad de bases de datos con tablespaces.
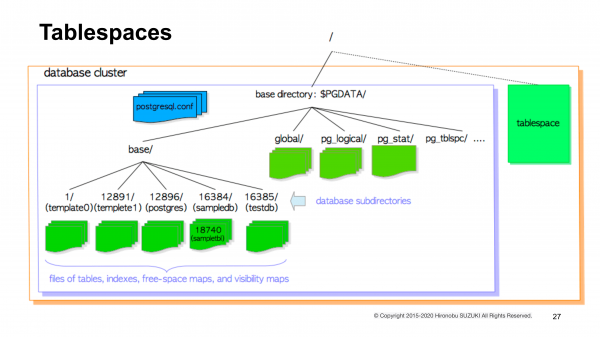
Déjenme recordar brevemente qué son y para qué sirven. Por lo general, todos sus datos de Postgres ocupan un directorio en el sistema de archivos, que se llama base. Y este directorio ya contiene todos los archivos y subdirectorios necesarios para Postgres.
Los tablespaces son directorios que contienen datos de Postgres, pero no están fuera del directorio base. En la diapositiva se puede ver que los tablespaces están fuera del directorio base.
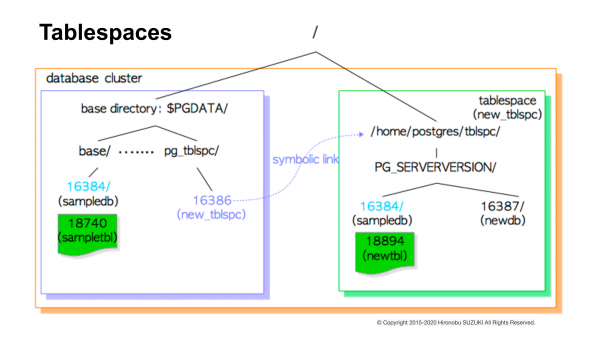
¿Cómo se ve esto para Postgres mismo? En el directorio base hay un subdirectorio separado llamado pg_tblspc. Y en él hay enlaces simbólicos a los directorios donde realmente están los datos de Postgres fuera del directorio base.
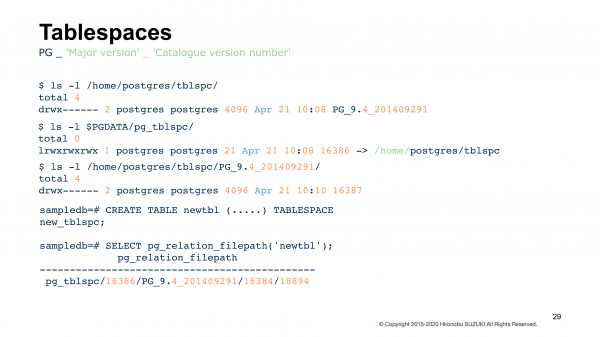
Cuando usen todo esto, para ustedes estos comandos pueden verse de la siguiente manera. Es decir, crean una tabla en algún tablespace especificado y ven dónde está ahora. Estas dos últimas líneas, los dos últimos comandos llamados. Y se puede ver que hay alguna ruta. Pero en realidad, esa no es la ruta real. Es una ruta con un prefijo del directorio base al tablespace. Y desde allí se filtra a través de un enlace simbólico que conduce a sus datos reales.
No usamos todo esto en nuestro equipo, pero muchos otros usuarios de WAL-E lo usaron, quienes nos dijeron que querían migrar a WAL-G, pero esto les obstaculizaba. Ahora eso se admite.
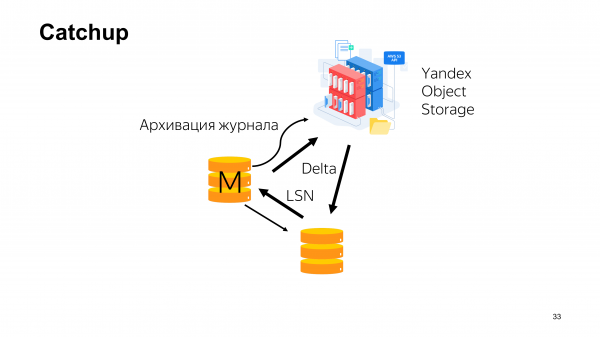
Otra característica que nos trajo nuestro curso especial es el catchup. La gente que ha trabajado más con Oracle que con Postgres seguramente conoce el catchup.
Resumen de qué es esto. Así es como podría verse normalmente la topología del clúster en nuestro servicio. Tenemos un maestro. Hay una réplica que transmite desde él el registro de avance de escritura. Y la réplica le dice al maestro en qué LSN se encuentra actualmente. Y, en paralelo, se puede archivar el registro. Además de la archivación del registro, se envían copias de seguridad a la nube. Y se envían copias de seguridad delta.
¿Cuál puede ser el problema? Cuando tienes una base de datos bastante grande, puede suceder que tu réplica comience a atrasarse considerablemente respecto al maestro. Y se retrasa tanto que nunca podrá alcanzarlo. Este problema normalmente necesita resolverse de alguna manera.
Y la forma más sencilla es eliminar la réplica y volver a cargarla desde cero, porque nunca alcanzará al maestro, y debemos lidiar con el problema. Pero esto lleva bastante tiempo, ya que restaurar una copia de seguridad completa de una base de 10 TB es muy, muy largo. Y queremos hacerlo tan rápido como sea posible, si surgen tales problemas. Y para eso está diseñado catchup.
Catchup permite utilizar copias de seguridad delta, que se guardan en la nube de esta manera. Indicas en qué LSN se encuentra actualmente la réplica atrasada y lo especificas en el comando catchup para crear una copia de seguridad delta entre ese LSN y el LSN en el que se encuentra actualmente tu clúster. Y después de eso, restauras esa copia de seguridad en la réplica que estaba atrasada.
Otras bases
Además, los estudiantes nos trajeron muchas características de inmediato. Como no solo trabajamos con Postgres en Yandex, también tenemos MySQL, MongoDB, Redis, ClickHouse, en algún momento necesitamos poder hacer copias de seguridad con recuperación a un punto en el tiempo para MySQL, y que haya la posibilidad de cargarlas en la nube.
Queríamos hacerlo de una manera similar a como lo hace WAL-G. Y decidimos experimentar y ver cómo se vería todo esto.
Y al principio, sin dividir esta lógica, escribimos el código en un fork. Vimos que había algún modelo funcional y podía funcionar. Luego pensamos que nuestra comunidad principal son los postgresqlistas, ellos utilizan WAL-G. Por lo tanto, necesitamos separar esas partes. Es decir, cuando se corrige el código para Postgres no rompemos MySQL, y cuando corregimos MySQL, no rompemos Postgres.
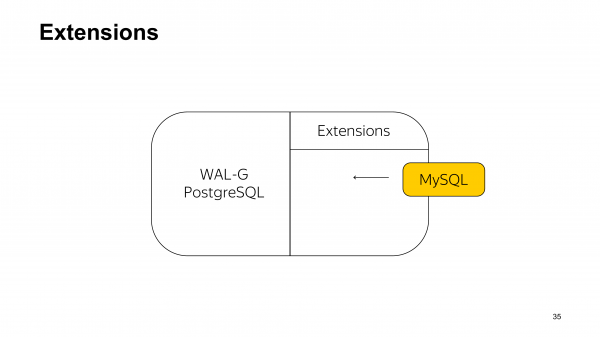
La primera idea sobre cómo dividir esto fue usar el mismo enfoque que se utiliza en las extensiones de PostgreSQL. Y, de hecho, para hacer una copia de seguridad de MySQL, tenías que instalar alguna biblioteca dinámica.
Pero aquí inmediatamente se ve la asimetría de este enfoque. Cuando haces una copia de seguridad de Postgres, simplemente instalas una herramienta de copia de seguridad normal para Postgres y todo está bien. En cambio, para MySQL parece que instalas una herramienta de copia de seguridad para Postgres y además necesitas instalar una biblioteca dinámica para MySQL. Suena algo extraño. También pensamos eso y decidimos que no era la solución que necesitábamos.
Diferentes construcciones para Postgres, MySQL, MongoDB, Redis
Pero esto nos permitió, creemos, llegar a la solución correcta: separar diferentes construcciones para diferentes bases de datos. Esto permitía aislar la lógica relacionada con las copias de seguridad de distintas bases de datos, las cuales accederían a una API común implementada por WAL-G.
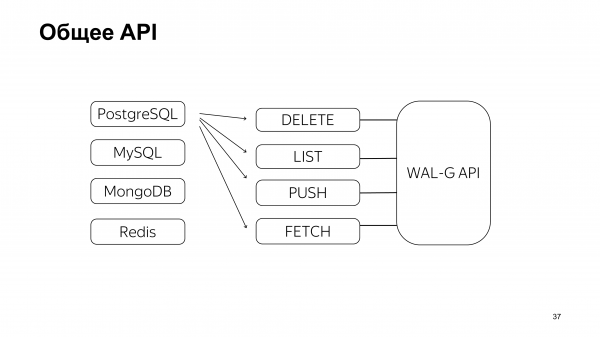
Esta es la parte que escribimos nosotros mismos, antes de dar a los estudiantes las tareas. Es decir, esta es exactamente la parte donde podrían hacer algo incorrecto, por lo que decidimos que era mejor que nosotros hiciéramos algo correcto y todo funcionaría perfectamente.
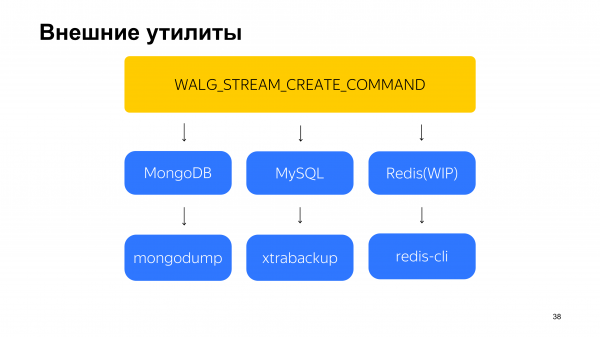
Después de esto, dimos las tareas. Fueron rápidamente asumidas. Se requería que los estudiantes dieran soporte a tres bases de datos.
Esta es MySQL, de la que hemos estado haciendo copias de seguridad con WAL-G de esta manera durante más de un año.
Y ahora MongoDB se acerca a producción, donde lo están ajustando. En esencia, nosotros escribimos el esqueleto para todo esto. Luego, los estudiantes escribieron algunas cosas que funcionan. Y después las llevamos a un estado que podemos aceptar en producción.
Estas tareas no parecían requerir que los estudiantes escribieran herramientas de copia de seguridad completas para cada una de estas bases. No tuvimos ese problema. Nuestro problema era que queríamos recuperación en el tiempo y queríamos hacer copias de seguridad en la nube. Y pedimos a los estudiantes que escribieran algún código que resolviera esto. Los estudiantes utilizaron herramientas de copia de seguridad que ya existían, las cuales de alguna manera realizaban copias y luego integraron todo esto con WAL-G, que lo enviaba a la nube. También añadieron recuperación en el tiempo.
¿Qué más trajeron los estudiantes? Trajeron al WAL-G soporte de cifrado de Libsodium.
Además, tenemos políticas de almacenamiento de copias de seguridad. Ahora las copias de seguridad se pueden marcar como permanentes. Y es más conveniente para tu servicio automatizar el proceso de almacenamiento.
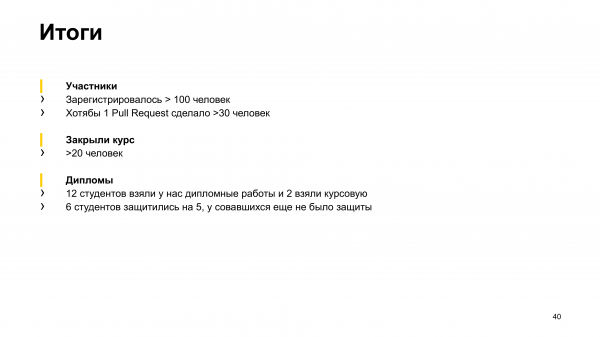
¿Qué resultados obtuvimos de este experimento?
Más de 100 personas se registraron inicialmente en el curso. Al principio no mencioné que la universidad en Ekaterimburgo es la Universidad Federal de los Urales. Allí anunciamos todo. Se registraron 100 personas. En realidad, mucho menos comenzó a hacer algo, aproximadamente 30 personas.
Aún menos personas completaron el curso, porque había que escribir pruebas para los códigos que ya existen. También había que arreglar un error o implementar alguna característica. Sin embargo, algunos estudiantes sí completaron el curso.
Hasta el momento, los estudiantes han arreglado alrededor de 14 problemas en este curso y han realizado 10 características de diferentes tamaños. Y, en mi opinión, esto es un reemplazo completo de uno o dos desarrolladores.
Además de todo, otorgamos diplomas y trabajos de curso. 12 recibieron diplomas. 6 de ellos ya se defendieron con un '5'. Los demás aún no han defendido, pero creo que a ellos también les irá bien.
Planes futuros
¿Cuáles son nuestros planes para el futuro?
Al menos las solicitudes de características que ya hemos escuchado de los usuarios y que queremos implementar. Esto es:
- Seguimiento de la corrección del seguimiento de la línea de tiempo en el archivo de copias de seguridad del clúster HA. Con WAL-G se puede hacer esto. Y creo que encontraremos estudiantes dispuestos a encargarse de ello.
- Ya tenemos una persona responsable por la transferencia de copias de seguridad y WAL entre nubes.
- Y recientemente publicamos la idea de que podemos acelerar aún más WAL-G mediante la descompresión de copias de seguridad incrementales sin sobrescribir páginas y optimizando los archivos que enviamos allí.
Puedes compartirlos aquí
¿Cuál fue el propósito de esta presentación? Que ahora, además de nosotros cuatro que mantenemos este proyecto, hay manos adicionales, y son bastante numerosas. Especialmente si se les escribe en privado. Y si haces copias de seguridad de tus datos y lo haces con WAL-G o si deseas migrar a WAL-G, podemos tener en cuenta tus deseos con bastante facilidad.
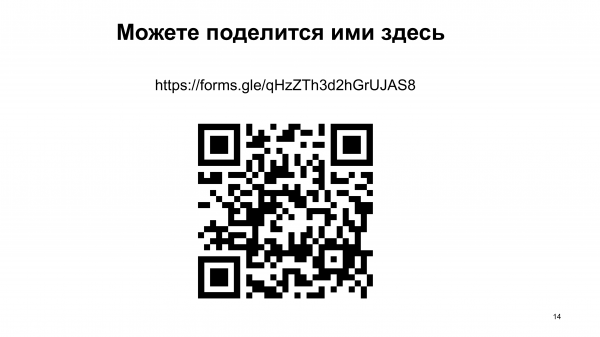
Este es el código QR y el enlace. Puedes usarlos para ir y escribir todas tus solicitudes. Por ejemplo, hay un error que no estamos solucionando. O alguna característica que realmente deseas, pero que aún no está en ninguna herramienta de copia de seguridad, incluida la nuestra. Asegúrate de mencionarlo.
Preguntas
¡Hola! ¡Gracias por la presentación! Tengo una pregunta sobre WAL-G, pero no sobre Postgres. WAL-G hace copias de seguridad de MySQL y llama a la copia de seguridad extra. Si tomamos instalaciones modernas en CentOS y si haces un yum install MySQL, se instalará MariaDB. Desde la versión 10.3, la copia de seguridad extra no es compatible, solo se admite la copia de seguridad de MariaDB. ¿Cómo les va con esto?
Actualmente no hemos intentado hacer copias de seguridad de MariaDB. Hemos recibido solicitudes para soportar FoundationDB, pero en general, si hay una solicitud, podemos encontrar personas que lo hagan. No es tan largo ni complicado, como me parece.
¡Buen día! ¡Gracias por la presentación! Tengo una pregunta sobre posibles nuevas características. ¿Están listos para hacer que WAL-G funcione con cintas, para que se pueda hacer una copia de seguridad en cintas?
¿Se refiere a la copia de seguridad en almacenamiento en cintas?
Sí.
Allí está Andrey Borodin, quien puede responder mejor a esta pregunta que yo.
(Andrey) Sí, gracias por la pregunta. Hemos recibido una solicitud para transferir la copia de seguridad a cinta desde el almacenamiento en la nube. Y para esto la transferencia entre nubes. Porque la transferencia entre nubes es una versión generalizada de la transferencia a cinta. Además, tenemos una arquitectura escalable en cuanto a los Almacenamientos. Por cierto, muchos Almacenamientos fueron escritos por estudiantes. Y si escribes un Almacenamiento para cintas, por supuesto, será apoyado. Estamos dispuestos a considerar un pull request. Solo tienes que escribir un archivo, leer un archivo. Si estas cosas se hacen en Go, normalmente son unas 50 líneas de código. Y entonces en WAL-G se apoyará la cinta.
¡Gracias por la presentación! Un proceso de desarrollo interesante. La copia de seguridad es una parte importante de la funcionalidad que debe estar bien cubierta por pruebas. Cuando implementaron la funcionalidad para nuevas bases de datos, ¿las pruebas también las escribieron estudiantes o ustedes escribieron las pruebas primero y luego pasaron la implementación a los estudiantes?
Las pruebas también las escribieron estudiantes. Pero los estudiantes escribieron más para características como nuevas bases de datos. Ellos escribieron pruebas de integración. Y escribieron pruebas unitarias. Si las integraciones pasan, es decir, en este momento, es un escenario que ejecutas manualmente o lo hace cron, por ejemplo. Es decir, el escenario es bastante comprensible.
Los estudiantes no tienen mucha experiencia. ¿Cuánto tiempo se dedica a la revisión?
Sí, la revisión lleva bastante tiempo. Es decir, generalmente, cuando llegan varios programadores y dicen que yo hice esto, hice aquello, se necesita pensar y dedicar alrededor de medio día para entender lo que han escrito. Porque el código tiene que leerse cuidadosamente. Ellos no pasaron entrevistas. No los conocemos muy bien, por eso lleva un tiempo considerable.
¡Gracias por la presentación! Anteriormente, Andrey Borodin mencionó que el archive_command en WAL-G debe ser llamado directamente. Pero en el caso de algún clúster patron, necesitamos lógica adicional para determinar de qué nodo enviar los wals. ¿Cómo resuelven ustedes este problema?
¿Cuál es el problema que tienen aquí? Supongamos que tienen una réplica síncrona de la que están haciendo una copia de seguridad, ¿o qué?
(Andrey) La cuestión es que realmente WAL-G se supone que debe usarse sin envolturas en scripts de shell. Si falta algo, entonces escribamos la lógica que debe estar dentro de WAL-G. En cuanto a dónde debe hacerse la archivación, consideramos que la archivación debe hacerse desde el maestro actual en el clúster. Archivarlo desde la réplica es una mala idea. Allí pueden ocurrir varios escenarios con problemas. En particular, problemas con la archivación de líneas de tiempo y otra información adicional. ¡Gracias por la pregunta!
(Aclaración: Se deshicieron de la envoltura con scripts de shell) )
¡Buenas tardes! ¡Gracias por la presentación! Me interesó la función catchup de la que hablaste. Me he encontrado con situaciones en las que una réplica se rezaga y no puede alcanzar. Y no encontré una descripción de esta función en la documentación de WAL-G.
Catchup apareció literalmente a finales de enero de 2020. Puede que la documentación necesite mejorarse. Nosotros la redactamos y no lo hacemos de manera excepcional. Y tal vez deberíamos comenzar a exigir a los estudiantes que la escriban.
¿Ya está en la versión?
La solicitud de extracción ya está fusionada, es decir, la revisé. Lo probé en un clúster de prueba. Hasta ahora no hemos tenido ninguna situación en la que podríamos comprobarlo en un ejemplo en producción.
¿Cuándo se puede esperar?
No lo sé. Esperen un mes, con seguridad lo verificaremos.
Fuente: habr.com
