

Recientemente hablé sobre cómo aumentar el rendimiento de las consultas SQL "de lectura" hacer la grabación en la base de datos sin usar ningún tipo de "ajustes" en la configuración, simplemente organizando correctamente los flujos de datos. Este artículo trata sobre cómo y por qué se debe organizar el
#1. Секционирование
aplicativo particionado "en teoría" servicio de monitoreo de cientos de servidores PostgreSQL. .
Al igual que cualquier MVP, nuestro proyecto comenzó bajo una carga bastante baja: el monitoreo solo se realizaba para una docena de servidores críticos, todas las tablas eran relativamente compactas... Pero con el tiempo, el número de hosts monitoreados aumentó y, al intentar hacer algo nuevamente con una de las
tablas de 1.5TB, nos dimos cuenta de que vivir así era posible, pero muy incómodo.Los tiempos eran casi legendarios, diferentes versiones de PostgreSQL 9.x eran relevantes, por lo que toda la partición tuvo que hacerse "manualmente" — a través de
herencia de tablas y disparadores de enrutamiento dinámico. EXECUTE El resultado fue una solución bastante universal que se podía trasladar a todas las tablas:.
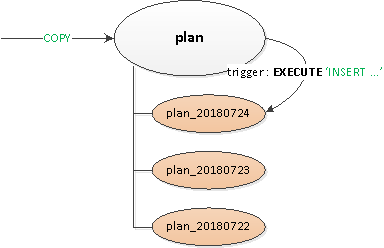
Se declaró una tabla vacía "padre" en la que se describían todos los
- índices y disparadores necesarios. Los registros desde la perspectiva del cliente se realizaban en la tabla "raíz", y dentro, mediante.
- el disparador de enrutamiento BEFORE INSERT,
el registro se insertaba "físicamente" en la sección correcta. Si esta no existía aún, capturamos la excepción y...... a través de - CREATE TABLE ... (LIKE ... INCLUDING ...) sección con una restricción a la fecha deseada, para que al extraer datos, la lectura se realizara solo en ella.PG10: primer intento
Pero la partición a través de herencia históricamente no estaba bien adaptada para trabajar con flujos activos de escritura o un gran número de secciones descendientes. Por ejemplo, se puede recordar que el algoritmo para elegir la sección correcta tenía
una complejidad cuadrática, lo que con 100+ secciones funciona, como pueden imaginar...En PG10, esta situación se optimizó significativamente, implementando el soporte para
particionamiento nativo. . Por lo tanto, lo intentamos de inmediato después de la migración del almacenamiento, pero…
Como descubrimos tras revisar el manual, la tabla seccionada de forma nativa en esta versión:
- no admite la descripción de índices
- no admite triggers
- no puede ser en sí misma un «descendiente»
- no admite
INSERT ... ON CONFLICT - no puede generar secciones automáticamente
Después de recibir un golpe en la frente con los rastrillos, entendimos que sería imposible evitar modificaciones en la aplicación y pospusimos más investigaciones durante seis meses.
PG10: segunda oportunidad
Así que comenzamos a resolver los problemas que surgieron uno por uno:
- Dado que los triggers y
ON CONFLICTresultaron ser necesarios en algunas situaciones, creamos una tabla intermedia. - Eliminamos el «enrutamiento» en los triggers — es decir, de
El resultado fue una solución bastante universal que se podía trasladar a todas las tablas:. - Lo separamos en una tabla plantilla con todos los índices, para que ni siquiera estuvieran presentes en la tabla intermedia.
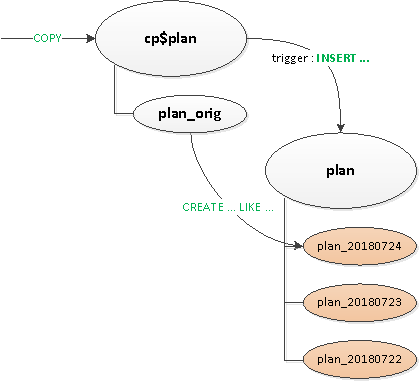
Finalmente, después de todo esto, seccionamos la tabla principal de forma nativa. La creación de una nueva sección aún quedó a cargo de la aplicación.
Estamos «desarrollando» diccionarios
Como en cualquier sistema analítico, también teníamos «hechos» y «dimensiones» (diccionarios). En nuestro caso, como tal, actuaban, por ejemplo, de consultas lentas similares o el texto de la propia consulta.
Los «hechos» habían sido seccionados por días desde hace tiempo, por lo que eliminábamos tranquilamente las secciones obsoletas y no nos molestaban (¡son solo logs!). Pero tuvimos problemas con los diccionarios…
No diría que eran excesivamente numerosos, pero aproximadamente por cada 100TB de «hechos» había un diccionario de 2.5TB.Con tal tabla, no puedes eliminar fácilmente nada, ni comprimirla en un tiempo razonable, y además, las escrituras se volvían gradualmente más lentas.
Parece un diccionario… cada registro debe estar representado exactamente una vez… y eso es correcto, ¡pero!... Nadie impide que tengamos un diccionario separado para cada día! Sí, esto trae cierta redundancia, pero permite:
- escribir/leer más rápido gracias al menor tamaño de la sección
- consumir menos memoria gracias a trabajar con índices más compactos
- almacenar menos datos gracias a la posibilidad de eliminar rápidamente lo obsoleto
Como resultado de todas estas medidas la carga de la CPU se redujo en ~30%, y en el disco — en ~50%:
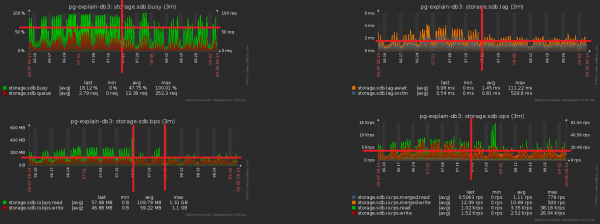
Mientras tanto, continuamos escribiendo en la base de datos exactamente lo mismo, solo que con menos carga.
#2. Эволюция и рефакторинг БД
Así que, nos quedamos en que tenemos una sección para cada día con datos. En realidad, CHECK (dt = '2018-10-12'::date) — y es la clave de partición y la condición para que un registro caiga en una sección específica.
Dado que todos los informes en nuestro servicio se construyen en función de una fecha específica, los índices desde los “tiempos no particionados” también eran de tipo (Servidor, Fecha, Plantilla del plan), (Servidor, Fecha, Nodo del plan), (Fecha, Clase de error, Servidor),…
Pero ahora en cada sección viven sus propias instancias de cada uno de esos índices... Y dentro de cada sección la fecha es una constante… Resulta que ahora estamos escribiendo una constante simplemente como uno de los campos en cada índice, lo que aumenta tanto su tamaño como el tiempo de búsqueda, pero no aporta ningún resultado. Nos hemos dejado las trampas, ups... La dirección de optimización es obvia: simplemente
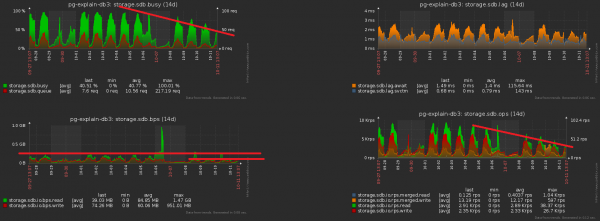
eliminar el campo de fecha de todos los índices en las tablas particionadas. Con nuestros volúmenes, el ahorro es del orden de 1TB/semana Y ahora notemos que este terabyte aún ha tenido que ser registrado de alguna manera. Es decir, ahora también tenemos que!
cargar menos el disco ! En esta imagen se puede ver bien el efecto obtenido de la limpieza realizada, a la que dedicamos una semana:Uno de los grandes problemas de los sistemas sobrecargados es la
#3. «Размазываем» пиковую нагрузку
sincronización excesiva de algunas operaciones que no lo requieren. A veces “porque no lo notaron”, otras “porque era más fácil”, pero tarde o temprano hay que deshacerse de ella. Acercamos la imagen anterior y vemos que el disco está
“cargando” con una carga de amplitud doble entre las mediciones adyacentes, lo cual claramente “estadísticamente” no debería ocurrir con tal cantidad de operaciones: Lograr esto es bastante sencillo. Ya teníamos en monitoreo cerca de
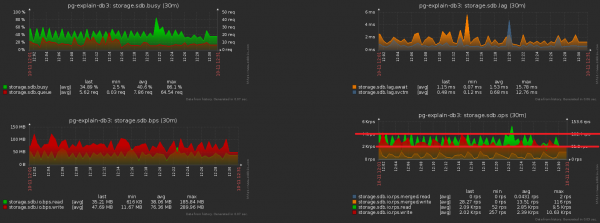
1000 servidores , cada uno procesándose en un flujo lógico separado, y cada flujo descarga la información acumulada para enviarla a la base de datos con una periodicidad determinada, aproximadamente así:setInterval(sendToDB, interval)
El problema aquí radica exactamente en quetodos los flujos comienzan aproximadamente al mismo tiempo , por lo que los momentos de envío casi siempre coinciden “hasta el último punto”. Ups nº 2...Afortunadamente, esto se puede corregir bastante fácil,
agregando un “desfase” aleatorio en el tiempo: setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))
El tercer problema tradicional de alta carga es la#4. Кэшируем, что нужно можно
ausencia de caché donde podría estar. haber ser.
Por ejemplo, hemos habilitado el análisis según los nodos del plan (todos estos Seq Scan en usuarios), pero pensar de inmediato que son, en su mayoría, iguales — se olvidaron.
No, por supuesto, en la base no se escriben datos nuevamente, esto anula el disparador con INSERT ... ON CONFLICT DO NOTHING. Pero esos datos, de todos modos, llegan a la base, y hay una lectura adicional para verificar el conflicto que hay que hacer. Ups Nº 3…
La diferencia en la cantidad de registros enviados a la base antes/después de activar la caché es evidente:
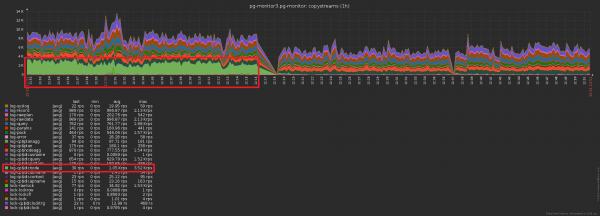
Y esto es — una caída relacionada en la carga del almacenamiento:
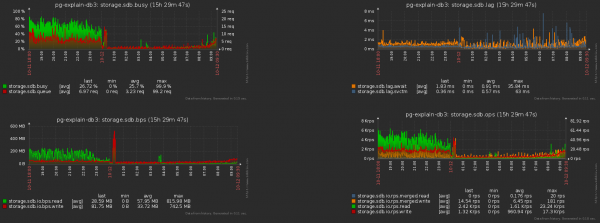
Total
«Terabyte-por-día» suena aterrador. Si haces todo correctamente, en realidad esto es solo 2^40 bytes / 86400 segundos = ~12.5MB/s, que incluso los discos duros IDE de escritorio podían soportar. 🙂
Y si hablamos en serio, incluso con un «desbalance» de carga diez veces mayor durante un día, puedes estar tranquilo en las capacidades de los SSD modernos.
Fuente: habr.com
