

El material del artículo fue tomado de mi .
Mecanismo de movimiento de datos
- Bloque de datos dblk_t
- Mensaje mblk_t
- Funciones para trabajar con mensajes mblk_t
- Cola queue_t
- Funciones para trabajar con colas queue_t
- Conexión de filtros
- Punto de señal en el grafo de procesamiento de datos
- Actividad detrás de escena del ticker
- MSBufferizer
- Funciones para trabajar con MSBufferizer
En el anterior Hemos desarrollado nuestro propio filtro. En este artículo dedicaremos atención al dispositivo del mecanismo interno de movimiento de datos entre filtros del mediastreamer. Esto permitirá, en adelante, escribir filtros complejos con menos esfuerzo.
Mecanismo de movimiento de datos
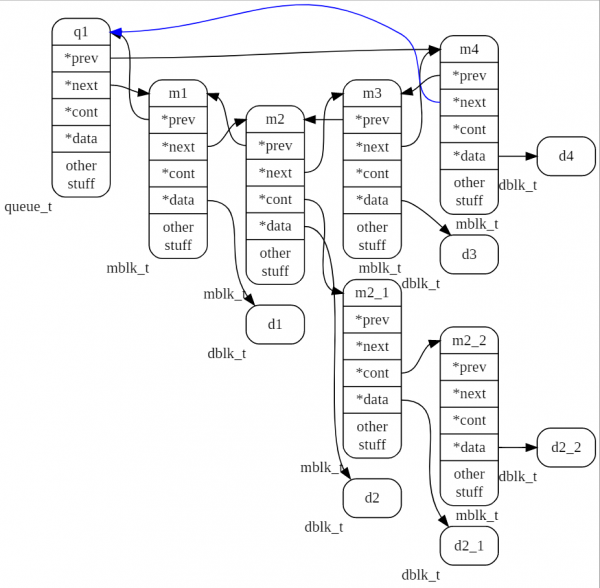
El movimiento de datos en el mediastreamer se realiza a través de colas descritas por la estructura queue_t. A través de las colas se mueven cadenas de mensajes del tipo mblk_t, que en sí mismas no contienen datos de señal, sino solo referencias al mensaje anterior, siguiente y al bloque de datos. Además, quiero destacar que hay un campo para una referencia a un mensaje de igual tipo, lo que permite organizar una lista enlazada de mensajes. Llamaremos a un grupo de mensajes unidos de esta manera un tuple. Así, cualquier elemento de la cola puede ser un mensaje único mblk_t, o puede ser la cabeza de un tuple de mensajes mblk_t. Cada mensaje del tuple puede tener su propio bloque de datos subyacente. La utilidad de los tuples la discutiremos un poco más adelante.
Como se mencionó anteriormente, el mensaje en sí no contiene un bloque de datos, en su lugar solo contiene un puntero a la zona de memoria donde se almacena el bloque. En esta parte, la imagen general del funcionamiento del mediastreamer recuerda a un almacén de puertas de la película "Monsters, Inc.", donde las puertas (referencias a datos — habitaciones) se mueven a gran velocidad por cintas transportadoras en suspensión, mientras que las habitaciones mismas permanecen inmóviles.
Ahora, subiendo por la jerarquía, examinemos en detalle las entidades mencionadas del mecanismo de transmisión de datos en el mediastreamer.
Bloque de datos dblk_t
Un bloque de datos consiste en un encabezado y un búfer de datos. El encabezado se describe mediante la siguiente estructura,
typedef struct datab
{
unsigned char *db_base; // Puntero al inicio del búfer de datos.
unsigned char *db_lim;  // Puntero al final del búfer de datos.
void (*db_freefn)(void*); // Función para liberar memoria al eliminar el bloque.
int db_ref; // Contador de referencias.
} dblk_t;
Los campos de la estructura contienen punteros al inicio del búfer, al final del búfer y a la función de eliminación del búfer de datos. El último elemento en el encabezado db_ref — contador de referencias, si llega a cero, esto sirve como señal para eliminar este bloque de la memoria. Si el bloque de datos fue creado por la función datab_alloc() , entonces el búfer de datos se colocará en la memoria inmediatamente después del encabezado. En todos los demás casos, el búfer puede estar ubicado en otro lugar. En el búfer de datos se encuentran las muestras de señal u otros datos que queremos procesar con filtros.
Una nueva instancia del bloque de datos se crea con la función:
dblk_t *datab_alloc(int size);Se le pasa como parámetro de entrada el tamaño de los datos que almacenará el bloque. Se asigna más memoria para que al principio de la memoria asignada se coloque el encabezado — la estructura datab. Pero al utilizar otras funciones, esto no siempre ocurre, en algunos casos el búfer de datos puede estar separado del encabezado del bloque de datos. Los campos de la estructura se configuran al crearla de forma que su campo db_base apunte al inicio del área de datos y db_lim al final. El contador de referencias db_ref se establece en uno. El puntero a la función de limpieza de datos se establece en cero.
Mensaje mblk_t
Como se mencionó, los elementos de la cola tienen el tipo mblk_t, se define de la siguiente manera:
typedef struct msgb
{
  struct msgb *b_prev;   \/\/ Puntero al elemento anterior de la lista.
  struct msgb *b_next;   \/\/ Puntero al siguiente elemento de la lista.
  struct msgb *b_cont;   \/\/ Puntero para adjuntar otros mensajes a un mensaje, para crear una tupla de mensajes.
  struct datab *b_datap; \/\/ Puntero a la estructura del bloque de datos.
  unsigned char *b_rptr; \/\/ Puntero al inicio del área de datos para leer los datos del búfer b_datap.
  unsigned char *b_wptr; \/\/ Puntero al inicio del área de datos para escribir los datos del búfer b_datap.
  uint32_t reserved1;    \/\/ Campo reservado 1, el mediastreamer coloca ahí información técnica.
  uint32_t reserved2;    \/\/ Campo reservado 2, el mediastreamer coloca ahí información técnica.
  #if defined(ORTP_TIMESTAMP)
  struct timeval timestamp;
  #endif
  ortp_recv_addr_t recv_addr;
} mblk_t;
Estructura mblk_t al principio contiene punteros b_prev, b_next, que son necesarios para organizar una lista doblemente enlazada (que es la cola queue_t).
Luego sigue el puntero b_cont, que se utiliza solo cuando el mensaje entra en la tupla. Para el último mensaje en la tupla, este puntero permanece nulo.
A continuación, vemos un puntero al bloque de datos b_datap, para el cual existe el mensaje. Después vienen punteros a la área dentro del búfer de datos del bloque. El campo b_rptr indica el lugar desde donde se leerán los datos del búfer. El campo b_wptr indica el lugar desde donde se realizará la escritura en el búfer.
Los campos restantes son de carácter auxiliar y no están relacionados con el funcionamiento del mecanismo de transmisión de datos.
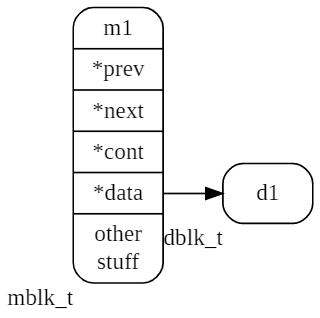
A continuación se muestra un único mensaje llamado m1 y un bloque de datos d1.
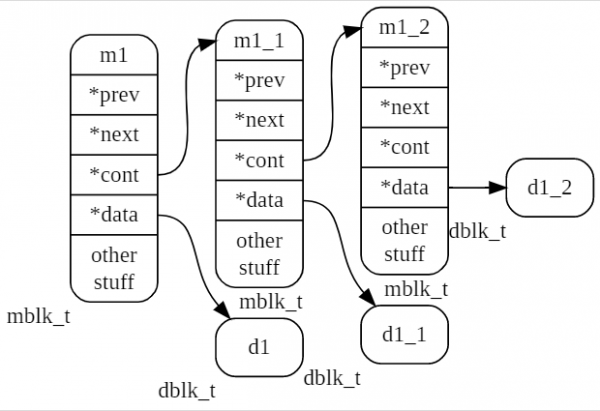
En la siguiente figura se muestra una tupla de tres mensajes m1, m1_1, m1_2.
Funciones para trabajar con mensajes mblk_t
Un nuevo mensaje mblk_t se crea mediante la función:
mblk_t *allocb(int size, int pri); ella asigna en memoria un nuevo mensaje mblk_t con un bloque de datos de tamaño especificado tamaño, el segundo argumento — pri no se utiliza en la versión de la biblioteca considerada. Debe permanecer nulo. Durante la operación de la función se asignará memoria para la estructura del nuevo mensaje y se llamará a la función mblk_init(), que pondrá a cero todos los campos de la instancia creada de la estructura y luego, utilizando lo mencionado anteriormente, datab_alloc()creará el búfer de datos. Después se configurarán los campos en la estructura:
mp->b_datap=datab;
mp->b_rptr=mp->b_wptr=datab->db_base;
mp->b_next=mp->b_prev=mp->b_cont=NULL;
Como resultado, obtenemos un nuevo mensaje con los campos inicializados y un búfer de datos vacío. Para agregar datos al mensaje, es necesario copiarlos al búfer del bloque de datos:
memcpy(msg->b_rptr, data, size);donde data — puntero a la fuente de datos, y tamaño — su tamaño.
Luego, se debe actualizar el puntero a la posición de escritura para que apunte nuevamente al comienzo del área libre en el búfer:
msg->b_wptr = msg->b_wptr + sizeSi se requiere crear un mensaje a partir de un búfer que ya existe, sin copiar, se utiliza la función:
mblk_t *esballoc(uint8_t *buf, int size, int pri, void (*freefn)(void*)); La función, después de crear el mensaje y la estructura del bloque de datos, configurará sus punteros a los datos en la dirección buf. Es decir, en este caso, el búfer de datos no está ubicado después de los campos del encabezado del bloque de datos, como sucedió al crear el bloque de datos con la función. datab_alloc()El búfer de datos pasado a la función permanecerá donde estaba, pero mediante punteros se apuntará al recién creado encabezado del bloque de datos, y este, a su vez, al mensaje.
A un mensaje mblk_t se pueden acoplar varios bloques de datos de manera consecutiva. Esto se hace con la función:
mblk_t * appendb(mblk_t *mp, const char *data, int size, bool_t pad); mp — mensaje al que se añadirá otro bloque de datos;
data — puntero al bloque, que será copiado al mensaje;
tamaño — tamaño de los datos;
pad — indicador de que el tamaño del espacio asignado debe estar alineado a 4 bytes (el relleno se realizará con ceros).
Si en el búfer de datos del mensaje hay suficiente espacio, los nuevos datos se concatenarán a los que ya están allí. Si el espacio libre en el búfer de datos del mensaje es menor que tamaño, se crea un nuevo mensaje con un tamaño de búfer suficiente y los datos se copian en su búfer. Este nuevo mensaje se acopla al original a través del puntero b_cont. En este caso, el mensaje se convierte en una tupla.
Si se requiere agregar otro bloque de datos a la tupla, se debe usar la función:
void msgappend(mblk_t *mp, const char *data, int size, bool_t pad);esta buscará el último mensaje en la tupla (tendrá b_cont cero) y llamará a la función appendb().
Para conocer el tamaño de los datos en el mensaje o en la tupla, se puede usar la función:
int msgdsize(const mblk_t *mp);esta recorrerá todos los mensajes de la tupla y devolverá el total de datos en los búferes de datos de esos mensajes. Para cada mensaje, la cantidad de datos se calcula así:
mp->b_wptr - mp->b_rptrPara combinar dos tuplas se aplica la función:
mblk_t *concatb(mblk_t *mp, mblk_t *newm);esta une la tupla newm al final de la tupla mp y devuelve un puntero al último mensaje de la nueva tupla.
Si es necesario, se puede convertir la tupla en un solo mensaje con un único bloque de datos, esto se hace con la función:
void msgpullup(mblk_t *mp,int len);si el argumento len es igual a -1, el tamaño del búfer asignado se determina automáticamente. Si len si el número es positivo, se creará un búfer de este tamaño y se copiarán los datos de los mensajes de la tupla. Si se acaba el búfer, la copia se detendrá allí. El primer mensaje de la tupla recibirá un búfer de nuevo tamaño con los datos copiados. Los restantes mensajes serán eliminados y la memoria será devuelta al montón.
Al eliminar la estructura mblk_t se considera el contador de referencias del bloque de datos, si al invocar freeb() resulta ser cero, el búfer de datos se elimina junto con la instancia mblk_t, a la que apunta.
Inicialización de los campos del nuevo mensaje:
void mblk_init(mblk_t *mp);Adición de otro conjunto de datos al mensaje:
mblk_t * appendb(mblk_t *mp, const char *data, size_t size, bool_t pad);Si los nuevos datos no caben en el espacio libre del búfer de datos del mensaje, se adjunta al mensaje un mensaje creado por separado con un búfer del tamaño necesario (en el primer mensaje se establece un puntero al mensaje añadido) el mensaje se convierte en la tupla.
Adición de un conjunto de datos a la tupla:
void msgappend(mblk_t *mp, const char *data, size_t size, bool_t pad); La función llama a appendb() en un ciclo.
Unificación de dos tuplas en una:
mblk_t *concatb(mblk_t *mp, mblk_t *newm);Mensaje newm se adjuntará a mp.
Creación de una copia de un solo mensaje:
mblk_t *copyb(const mblk_t *mp);Copia completa de la tupla con todos los bloques de datos:
mblk_t *copymsg(const mblk_t *mp);Los elementos de la tupla se copian mediante la función copyb().
Creación de una copia ligera del mensaje. mblk_tEn este caso, el bloque de datos no se copia, sino que se incrementa su contador de referencias. db_ref:
mblk_t *dupb(mblk_t *mp);Creación de una copia ligera de la tupla. Los bloques de datos no se copian, solo se incrementan sus contadores de referencias. db_ref:
mblk_t *dupmsg(mblk_t* m);Consolidación de todos los mensajes de la tupla en un solo mensaje:
void msgpullup(mblk_t *mp,size_t len);Si el argumento len es igual a -1, el tamaño del búfer asignado se determina automáticamente.
Eliminación de un mensaje, tupla:
void freemsg(mblk_t *mp);El contador de referencias del bloque de datos se reduce en uno. Si llega a cero, el bloque de datos también se elimina.
Cálculo del tamaño total de los datos en un mensaje o tupla.
size_t msgdsize(const mblk_t *mp);Extracción de un mensaje de la cola:
mblk_t *ms_queue_peek_last (q);Copia del contenido de los campos reservados de un mensaje a otro mensaje (en realidad, en estos campos se encuentran banderas que utiliza el transmisor de medios):
mblk_meta_copy(const mblk_t *source, mblk *dest);Cola queue_t
La cola de mensajes en el mediastreamer está implementada como una lista doblemente enlazada circular. Cada elemento de la lista contiene un puntero a un bloque de datos con las muestras de señal. Así, solo se mueven los punteros al bloque de datos, mientras que los propios datos permanecen estáticos. Es decir, solo se mueven las referencias a ellos.
Estructura que describe la cola queue_t, se muestra a continuación:
typedef struct _queue
{
   mblk_t _q_stopper;
   /* "Elemento vacío" de la cola, no apunta a datos, se utiliza solo para controlar la cola. Al inicializar la cola (qinit()), sus punteros se configuran para que apunten a sí mismo. */
   int q_mcount;        /* Número de elementos en la cola. */
} queue_t;
La estructura contiene un campo - un puntero _q_stopper de tipo *mblk_t, que apunta al primer elemento (mensaje) en la cola. El segundo campo de la estructura es el contador de mensajes en la cola.
En la figura a continuación se muestra la cola con el nombre q1, que contiene 4 mensajes m1, m2, m3, m4.
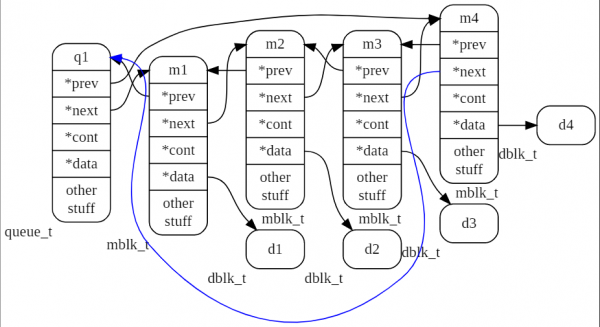
En la siguiente figura se muestra la cola con el nombre q1, que contiene 4 mensajes m1, m2, m3, m4. El mensaje m2 es la cabeza de una tupla, que contiene dos mensajes más, m2_1 y m2_2.
Funciones para trabajar con colas queue_t
Inicialización de la cola:
void qinit(queue_t *q);Campo _q_stopper (más adelante lo llamaremos "detenedor") se inicializa con la función mblk_init(), su puntero al elemento anterior y al siguiente se configuran para que apunten a sí mismo. Se inicializa el contador de elementos en la cola.
Adición de un nuevo elemento (mensaje):
void putq(queue_t *q, mblk_t *m);Un nuevo elemento m se agrega al final de la lista, configurando los punteros del elemento para que el detenedor sea su siguiente elemento, y él sea el anterior para el detenedor. Se incrementa el contador de elementos en la cola.
Extracción de un elemento de la cola:
mblk_t * getq(queue_t *q); se extrae el mensaje que está después del detenedor, y el contador de elementos se decrementa. Si no hay otros elementos en la cola además del detenedor, retorna 0.
Inserción de un mensaje en la cola:
void insq(queue_t *q, mblk_t *emp, mblk_t *mp); El elemento mp se inserta antes del elemento emp. Si emp=0, por lo que el mensaje se añade al final de la cola.
Extracción del mensaje de la cabeza de la cola:
void remq(queue_t *q, mblk_t *mp); El contador de elementos se decrementa.
Lectura del puntero al primer elemento en la cola:
mblk_t * peekq(queue_t *q); Eliminación de todos los elementos de la cola con la eliminación de los mismos elementos:
void flushq(queue_t *q, int how);El argumento how no se utiliza. El contador de elementos de la cola se establece en cero.
Macro para leer el puntero al último elemento de la cola:
mblk_t * qlast(queue_t *q);Al trabajar con colas de mensajes, hay que tener en cuenta que al llamar a ms_queue_put(q, m) con un puntero nulo al mensaje, la función entra en un bucle infinito. Su programa se bloqueará. Se comporta de manera similar ms_queue_next(q, m).
Conexión de filtros
La cola descrita anteriormente se utiliza para la transmisión de mensajes de un filtro a otro o de un filtro a varios filtros. Los filtros y sus conexiones entre sí forman un gráfico dirigido. La entrada o salida de un filtro se denomina generalmente "pin". Para describir el orden de las conexiones entre filtros, se utiliza en el mediastreamer el concepto de "punto de señal". Un punto de señal es una estructura _MSCPoint, que contiene un puntero al filtro y el número de uno de sus pines, describiendo así la conexión de una de las entradas o salidas del filtro.
Punto de señal en el grafo de procesamiento de datos
typedef struct _MSCPoint{
struct _MSFilter *filter; // Puntero al filtro del mediastreamer.
int pin;                        // Número de una de las entradas o salidas del filtro, es decir, pin.
} MSCPoint;
Los pines de los filtros se numeran comenzando desde cero.
La conexión de dos pines a través de una cola de mensajes se describe mediante la estructura _MSQueue, que contiene la cola de mensajes y punteros a dos puntos de señal que conecta:
typedef struct _MSQueue
{
queue_t q;
MSCPoint prev;
MSCPoint next;
}MSQueue;
Llamaremos a esta estructura enlace de señal. Cada filtro del mediastreamer contiene una tabla de enlaces de entrada y una tabla de enlaces de salida (MSQueue). El tamaño de las tablas se establece al crear el filtro, ya lo hicimos con la variable exportada de tipo MSFilterDesc, cuando desarrollamos nuestro propio filtro. A continuación se muestra la estructura que describe cualquier filtro en el mediastreamer, MSFilter:
struct _MSFilter{
    MSFilterDesc *desc;
    /* Puntero al descriptor del filtro. */
    /* Atributos protegidos, no se pueden mover ni eliminar, de lo contrario, se interrumpirá el trabajo con los plugins. */
    ms_mutex_t lock;      /* Semáforo. */
    MSQueue **inputs;     /* Tabla de enlaces de entrada. */
    MSQueue **outputs;    /* Tabla de enlaces de salida. */
    struct _MSFactory *factory; /* Puntero a la fábrica que creó esta instancia del filtro. */
    void *padding;              /* No se utiliza, se utilizará si se añaden campos protegidos. */
    void *data;                 /* Puntero a una estructura arbitraria para el almacenamiento de datos del estado interno del filtro y cálculos intermedios. */
    struct _MSTicker *ticker;   /* Puntero al objeto ticker, que no debe ser nulo cuando se llama a la función process(). */
    /* atributos privados, pueden moverse y cambiarse en cualquier momento */
    MSList *notify_callbacks; /* Lista de callbacks utilizados para manejar eventos del filtro. */
    uint32_t last_tick;       /* Número del último pulso en que se llamó a process(). */
    MSFilterStats *stats;     /* Estadísticas del funcionamiento del filtro. */
    int postponed_task; /* Número de tareas aplazadas. Algunos filtros pueden aplazar el procesamiento de datos (llamada a process()) durante varios pulsos. */
    bool_t seen;  /* Bandera que utiliza el ticker para marcar que esta instancia del filtro ya ha sido atendida en este pulso. */
};
typedef struct _MSFilter MSFilter;
Después de que hemos conectado los filtros en el programa en C según nuestra intención (pero sin conectar el ticker), hemos creado así un gráfico dirigido, cuyos nodos son instancias de la estructura MSFilter, y las aristas son instancias de enlaces MSQueue.
Actividad detrás de escena del ticker
Cuando les dije que el ticker es un filtro fuente de pulsos, no era toda la verdad sobre él. El ticker es un objeto que ejecuta funciones en ciclos process() de todos los filtros del esquema (gráfico) al que está conectado. Cuando conectamos el ticker al filtro del gráfico en el programa en C, le mostramos al ticker el gráfico que a partir de ese momento gestionará, hasta que lo desconectemos. Después de la conexión, el ticker comienza a inspeccionar el gráfico que se le ha encomendado, compilando una lista de filtros que incluye. Para no "contar" el mismo filtro dos veces, marca los filtros detectados estableciendo un flag seen. La búsqueda se realiza a través de las tablas de enlaces que tiene cada filtro.
Durante su recorrido informativo por el gráfico, el ticker verifica si hay al menos uno de los filtros que actúe como fuente de bloques de datos. Si no se encuentra ninguno, el gráfico se considera incorrecto y el ticker finaliza su operación de manera forzada.
Si el gráfico resulta "correcto", se llama a la función de inicialización para cada uno de los filtros encontrados. preprocess(). En el momento correspondiente para el siguiente ciclo de procesamiento (de manera predeterminada cada 10 milisegundos), el ticker llama a la función process() para todos los filtros de fuente encontrados previamente, y luego para los demás filtros de la lista. Si el filtro tiene enlaces de entrada, el inicio de la función process() se repite hasta que las colas de enlaces de entrada estén vacías. Después de eso, pasa al siguiente filtro de la lista y 'rodea' hasta liberar los enlaces de entrada de los mensajes. El ticker pasa de filtro en filtro hasta que la lista se agota. Así finaliza el ciclo de procesamiento.
Ahora volvamos a las tuplas y hablemos sobre por qué se agregó tal entidad en el streamer de medios. En general, el volumen de datos necesario para el algoritmo que opera dentro del filtro no coincide ni es múltiplo del tamaño de los buffers de datos que llegan a la entrada. Por ejemplo, estamos escribiendo un filtro que realiza una rápida transformación de Fourier, que por definición solo puede procesar bloques de datos cuyo tamaño sea una potencia de dos. Supongamos que son 512 muestras. Si los datos se generan a través de un canal telefónico, el buffer de datos de cada mensaje en la entrada nos proporcionará 160 muestras de señal. Existe la tentación de no extraer los datos de la entrada hasta que haya suficiente cantidad de datos. Pero en este caso, habrá una colisión con el ticker, que intentará sin éxito rodear el filtro hasta vaciar el enlace de entrada. Anteriormente, denominamos a esta regla como el tercer principio de funcionamiento del filtro. De acuerdo con este principio, la función process() del filtro debe extraer todos los datos de las colas de entrada.
Además, no se podrán extraer solo 512 muestras desde la entrada, ya que solo se pueden obtener en bloques completos, es decir, el filtro deberá obtener 640 muestras y al usar 512 de ellas, el resto se acumulará hasta que haya una nueva porción de datos. Así, nuestro filtro, además de su función principal, debe realizar acciones auxiliares para el almacenamiento intermedio de los datos de entrada. Los desarrolladores del mediastreamer y de esta tarea general han creado un objeto especial: MSBufferizer (bufferizador), que soluciona esta tarea mediante tuplas.
MSBufferizer
Este es el objeto que acumulará los datos de entrada dentro del filtro y comenzará a enviarlos para su procesamiento tan pronto como la cantidad de información sea suficiente para ejecutar el algoritmo del filtro. Mientras el bufferizador acumule datos, el filtro funcionará en modo inactivo, sin consumir capacidad de cálculo del procesador. Pero en cuanto la función de lectura del bufferizador devuelva un valor distinto de cero, la función process() del filtro comenzará a extraer y procesar los datos del bufferizador en porciones del tamaño necesario, hasta que se agoten.
Los datos aún no utilizados permanecen en el bufferizador como el primer elemento de la tupla, al que se agregan los bloques posteriores de datos de entrada.
La estructura que describe el bufferizador:
struct _MSBufferizer{
queue_t q; /* Cola de mensajes. */
int size; /* Tamaño total de los datos que se encuentran actualmente en el bufferizador. */
};
typedef struct _MSBufferizer MSBufferizer;
Funciones para trabajar con MSBufferizer
Creación de una nueva instancia de bufferizador:
MSBufferizer * ms_bufferizer_new(void);Se asigna memoria, se inicializa en ms_bufferizer_init() y se devuelve un puntero.
Función de inicialización:
void ms_bufferizer_init(MSBufferizer *obj); Se inicializa la cola q, campo tamaño se establece en cero.
Adición de mensaje:
void ms_bufferizer_put(MSBufferizer *obj, mblk_t *m); El mensaje m se agrega a la cola. El tamaño de los bloques de datos calculado se suma a tamaño.
Transferencia al bufferizador de todos los mensajes de la cola de datos del enlace q:
void ms_bufferizer_put_from_queue(MSBufferizer *obj, MSQueue *q); La transferencia de mensajes del enlace q al bufferizador se realiza mediante la función ms_bufferizer_put().
Lectura del bufferizador:
int ms_bufferizer_read(MSBufferizer *obj, uint8_t *data, int datalen); Si el tamaño de los datos acumulados en el bufferizador resulta ser menor que el solicitado (datalen), la función devuelve cero, la copia de datos en data no se lleva a cabo. De lo contrario, se realiza la copia secuencial de datos desde las tuplas que están en el búfer. Después de la copia, la tupla se elimina y se libera la memoria. La copia se detiene en el momento en que se han copiado datalen bytes. Si se queda sin espacio en medio de un bloque de datos, entonces en este mensaje, el bloque de datos se truncará hasta la parte no copiada restante. En la siguiente llamada, la copia continuará desde este punto.
Lectura de la cantidad de datos que están disponibles en este momento en el búfer:
int ms_bufferizer_get_avail(MSBufferizer *obj); Devuelve el campo tamaño del búfer.
Descartar parte de los datos que están en el búfer:
void ms_bufferizer_skip_bytes(MSBufferizer *obj, int bytes);La cantidad especificada de bytes de datos se extrae y se descarta. Se descartan los datos más antiguos.
Eliminar todos los mensajes que se encuentran en el búfer:
void ms_bufferizer_flush(MSBufferizer *obj); El contador de datos se restablece a cero.
Eliminar todos los mensajes que se encuentran en el búfer:
void ms_bufferizer_uninit(MSBufferizer *obj); La reinicialización del contador no se lleva a cabo.
Eliminar el búfer y liberar la memoria:
void ms_bufferizer_destroy(MSBufferizer *obj); Ejemplos de uso del búfer se pueden encontrar en el código fuente de varios filtros del mediastreamer. Por ejemplo, en el filtro MS_L16_ENC, que realiza una permutación de bytes en las muestras del orden de red, al orden del host:
En el siguiente artículo, abordaremos la cuestión de la evaluación de la carga en el ticker y las formas de combatir la carga computacional excesiva en el mediastreamer.
Fuente: habr.com
