

Nota de traducción.: este material proviene de un proyecto educativo — respuesta a una pregunta popular al diseñar una infraestructura basada en Kubernetes. Esperamos que las descripciones detalladas de las ventajas y desventajas de cada opción ayuden a hacer la elección óptima para su proyecto.
TL;DR: el mismo conjunto de cargas de trabajo puede ejecutarse en varios clústeres grandes (con un gran número de cargas en cada clúster) o en múltiples clústeres pequeños (con pocas cargas en cada uno).
A continuación se presenta una tabla que evalúa las ventajas y desventajas de cada enfoque:
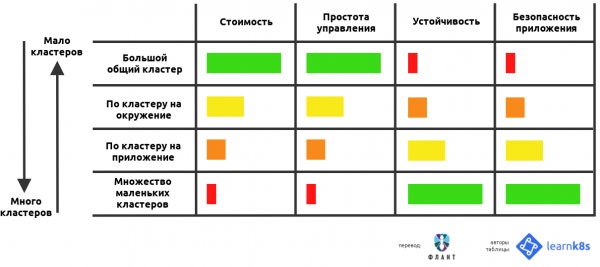
Al utilizar Kubernetes como plataforma para la explotación de aplicaciones, a menudo surgen varias preguntas fundamentales sobre los matices de la configuración de clústeres:
- ¿Cuántos clústeres utilizar?
- ¿Qué tan grandes deben ser?
- ¿Qué debe incluir cada clúster?
En este artículo intentaré responder a todas estas preguntas, analizando las ventajas y desventajas de cada enfoque.
Planteamiento de la cuestión
Como creador de software, es probable que desarrolle y opere múltiples aplicaciones al mismo tiempo.
Además, muchas instancias de estas aplicaciones seguramente se ejecutan en diferentes entornos; por ejemplo, podrían ser dev, test y prod.
Como resultado, se obtiene una matriz completa de aplicaciones y entornos:
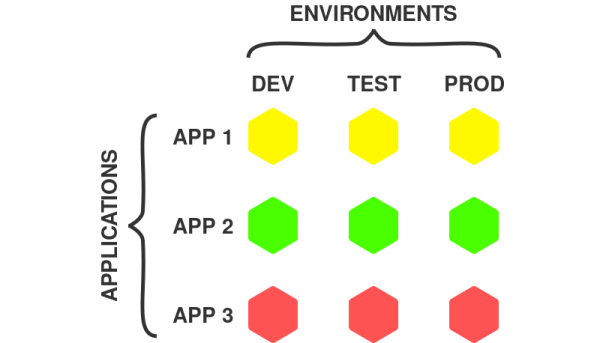
Aplicaciones y entornos
En el ejemplo anterior se presentan 3 aplicaciones y 3 entornos, lo que da un total de 9 posibles combinaciones.
Cada instancia de la aplicación es una unidad de implementación autosuficiente, que se puede manejar de forma independiente de las demás.
Tenga en cuenta que instancia de la aplicación puede consistir en múltiples componentes, como frontend, backend, base de datos, etc. En el caso de una aplicación de microservicios, la instancia incluirá todos los microservicios.
Como resultado, los usuarios de Kubernetes tienen varias preguntas:
- ¿Debería alojar todas las instancias de la aplicación en un solo clúster?
- ¿Debería crear un clúster separado para cada instancia de la aplicación?
- ¿O tal vez debería utilizar una combinación de los enfoques mencionados?
Todas estas opciones son viables, ya que Kubernetes es un sistema flexible que no limita las posibilidades del usuario.
Aquí hay algunas de las posibles rutas:
- un gran clúster común;
- varios clústeres pequeños y especializados;
- un clúster para cada aplicación;
- un clúster para cada entorno.
Como se muestra a continuación, los primeros dos enfoques están en extremos opuestos de la escala de opciones:
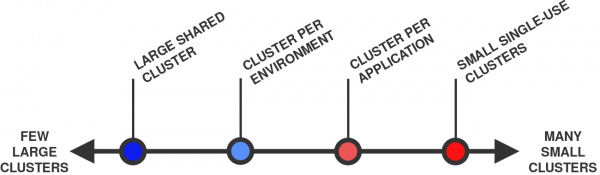
De varios clústeres grandes (a la izquierda) a muchos pequeños (a la derecha)
En general, se considera que un clúster es "más grande" que otro si tiene una mayor suma de nodos y pods. Por ejemplo, un clúster con 10 nodos y 100 pods es más grande que un clúster con 1 nodo y 10 pods.
¡Bien, empecemos!
1. Un gran clúster común
La primera opción es alojar todas las cargas de trabajo en un solo clúster:
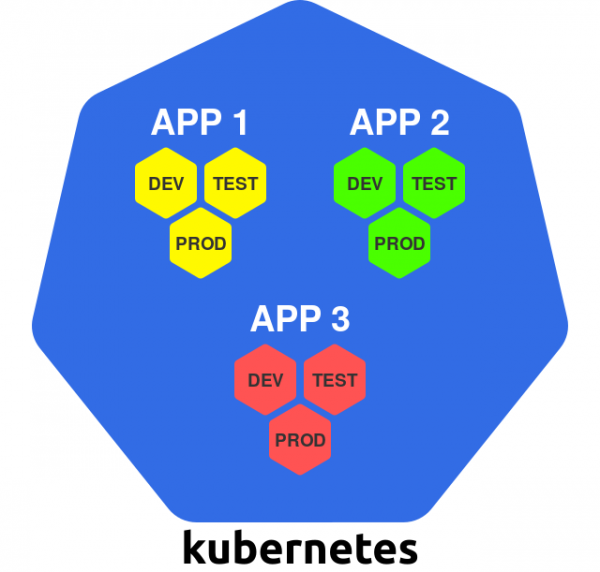
Un gran clúster
En este enfoque, el clúster se utiliza como una plataforma de infraestructura — todo lo necesario lo despliegas simplemente en el clúster Kubernetes existente. Los espacios de nombres
Vamos a revisar los pros y los contras de este enfoque.
+ Uso eficiente de recursos
En el caso de un único clúster, solo se necesita una copia de todos los recursos necesarios para ejecutar y administrar el clúster Kubernetes.
Por ejemplo, esto es cierto para los nodos maestros. Generalmente, cada clúster de Kubernetes tiene 3 nodos maestros, por lo que para un único clúster, su número seguirá siendo el mismo (en comparación, 10 clústeres necesitarán 30 nodos maestros).
La sutileza mencionada también se aplica a otros servicios que funcionan a gran escala en todo el clúster, como balanceadores de carga, controladores de Ingress, sistemas de autenticación, registro y monitoreo.
En un clúster único, todos estos servicios se pueden usar de inmediato para todas las cargas de trabajo (no es necesario crear copias, como en el caso de varios clústeres).
+ Economías
Como consecuencia de lo anterior, un número menor de clústeres generalmente cuesta menos, ya que no hay gastos en recursos redundantes.
Esto es especialmente cierto para los nodos maestros, que pueden costar mucho dinero sin importar el método de implementación (on-premises o en la nube).
Algunos servicios de Kubernetes administrados, como
Google Kubernetes Engine (GKE) o , proporcionan una capa de gestión de forma gratuita. En este caso, la cuestión de los costos es menos apremiante.
También existen servicios gestionados que cobran una tarifa fija por el funcionamiento de cada clúster de Kubernetes (por ejemplo, ).
+ Administración eficiente
Gestionar un solo clúster es más sencillo que múltiples.
La administración puede incluir las siguientes tareas:
- actualización de la versión de Kubernetes;
- configuración del pipeline CI/CD;
- instalación del plugin CNI;
- configuración del sistema de autenticación de usuarios;
- instalación del controlador de acceso;
y muchos más…
En el caso de un solo clúster, esto solo tendrá que hacerse una vez.
Para muchos clústeres, las operaciones deberán repetirse múltiples veces, lo que probablemente requerirá cierta automatización de procesos y herramientas para garantizar la sistematicidad y homogeneidad del proceso.
Y ahora unas palabras sobre las desventajas.
− Punto único de fallo
En caso de fallo del único clúster, todas las cargas de trabajo dejarán de funcionar! ¡Existen muchas situaciones en las que algo puede salir mal:
la actualización de Kubernetes puede causar efectos secundarios inesperados;
- un componente del clúster (por ejemplo, el plugin CNI) comienza a funcionar de manera diferente a lo esperado;
- uno de los componentes del clúster está configurado incorrectamente;
- falla en la infraestructura subyacente.
- Un solo incidente de este tipo puede causar un daño grave a todas las cargas de trabajo alojadas en el clúster compartido.
− Falta de aislamiento fuerte
Trabajar en un clúster compartido significa que las aplicaciones comparten hardware, capacidades de red y el sistema operativo en los nodos del clúster.
En cierto sentido, dos contenedores con dos aplicaciones diferentes que funcionan en el mismo nodo son similares a dos procesos que se ejecutan en la misma máquina bajo el mismo núcleo del sistema operativo.
Los contenedores de Linux proporcionan algún grado de aislamiento, pero no es tan fuerte como el que proporcionan, digamos, las máquinas virtuales. En esencia, el proceso en un contenedor es el mismo proceso que se está ejecutando en el sistema operativo huésped.
Esto puede convertirse en un problema desde el punto de vista de la seguridad: tal organización teóricamente permite que aplicaciones no relacionadas interactúen entre sí (ya sea de forma intencionada o accidental).
Esto puede convertirse en un problema en términos de seguridad: esta organización permite teóricamente a aplicaciones no relacionadas interactuar entre sí (intencionadamente o accidentalmente).
Además, todas las cargas de trabajo en el clúster de Kubernetes comparten algunos servicios comunes del clúster, como — esto permite que las aplicaciones encuentren los servicios de otras aplicaciones en el clúster.
Todos los puntos mencionados anteriormente pueden tener diferentes implicaciones dependiendo de los requisitos de seguridad de las aplicaciones.
Kubernetes proporciona diversas herramientas para prevenir problemas en el sistema de seguridad, como y . Sin embargo, para configurarlas correctamente se requiere cierta experiencia; además, no son capaces de cerrar todas las brechas de seguridad.
Es importante recordar siempre que Kubernetes fue diseñado originalmente para el uso compartido, y no para la aislamiento y seguridad.
− Ausencia de multi-tenancy estricta
Dada la abundancia de recursos compartidos en el clúster de Kubernetes, existen múltiples maneras en las que diferentes aplicaciones pueden "pisarse" entre sí.
Por ejemplo, una aplicación puede monopolizar algún recurso compartido (como CPU o memoria) y privar a otras aplicaciones que se ejecutan en el mismo nodo de su acceso.
Kubernetes proporciona varios mecanismos para controlar este comportamiento, como (ver también el artículo "" — nota del traductor), y . Sin embargo, al igual que en el caso de la seguridad, su configuración es bastante compleja y no pueden prevenir todos los efectos secundarios imprevistos.
− Gran número de usuarios
En el caso de un único clúster, se debe dar acceso a muchas personas. Cuanto mayor es su número, mayor es el riesgo de que rompan algo.
Dentro del clúster se puede controlar quién puede hacer qué mediante (ver el artículo "" — nota del traductor). Sin embargo, esto no evitará que los usuarios "rompan" algo dentro de su área de responsabilidad.
− Los clústeres no pueden crecer indefinidamente
Un clúster que se utiliza para todas las cargas de trabajo probablemente será bastante grande (en términos de nodos y pods).
Pero aquí surge otro problema: los clústeres en Kubernetes no pueden crecer indefinidamente.
Hay un límite teórico en el tamaño del clúster. En Kubernetes, este es aproximadamente .
Sin embargo, en la vida real, los problemas pueden comenzar mucho antes, por ejemplo, con solo .
La cuestión es que los clústeres grandes ejercen una alta carga sobre la capa de control de Kubernetes. En otras palabras, para mantener el clúster en funcionamiento y utilizar los recursos de manera efectiva, se requiere una configuración cuidadosa.
Este problema se estudia en el artículo correspondiente en el blog original titulado "».
Pero consideremos el enfoque opuesto: múltiples clústeres pequeños.
2. Muchos clústeres pequeños y especializados
Con este enfoque, se utiliza un clúster separado para cada elemento desplegado:
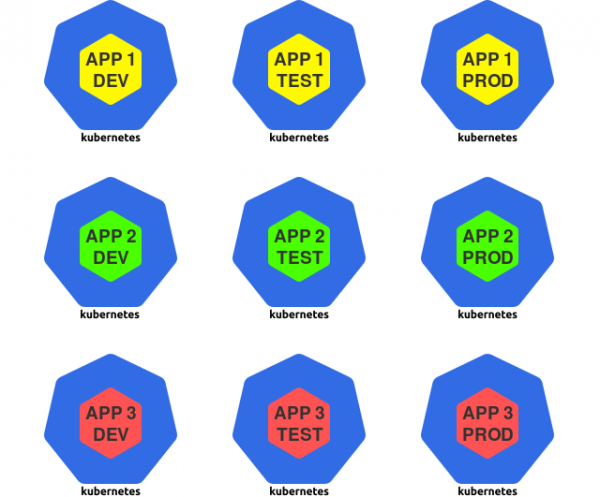
Muchos clústeres pequeños
Para los propósitos de este artículo, un elemento desplegado se entiende como una instancia de la aplicación, por ejemplo, la versión de desarrollo de una aplicación específica.
En esta estrategia, Kubernetes se utiliza como un entorno de ejecución especializado para instancias individuales de aplicaciones.
+ Uso eficiente de recursos
+ Radio de explosión limitado
En caso de "fallo" del clúster, las consecuencias negativas se limitan solo a las cargas de trabajo que se desplegaron en ese clúster. Todas las demás cargas de trabajo permanecen intactas.
+ Aislamiento
Las cargas de trabajo ubicadas en clústeres individuales no comparten recursos como CPU, memoria, sistema operativo, red u otros servicios.
Como resultado, obtenemos un aislamiento estricto entre aplicaciones no relacionadas, lo que puede beneficiar su seguridad.
+ Pocos usuarios
Dado que cada clúster contiene solo un número limitado de cargas de trabajo, se reduce el número de usuarios que tienen acceso a él.
Cuanto menos personas tengan acceso al clúster, menor es el riesgo de que algo "se rompa".
Veamos los inconvenientes.
− Uso ineficiente de recursos
Como se mencionó anteriormente, cada clúster de Kubernetes requiere un conjunto específico de recursos de gestión: nodos maestros, componentes de la capa de control, soluciones de monitoreo y registro.
En el caso de un gran número de clústeres pequeños, se debe dedicar una mayor proporción de recursos a la gestión.
− Costo elevado
El uso ineficiente de recursos conlleva automáticamente altos costos.
Por ejemplo, mantener 30 nodos maestros en lugar de tres con la misma capacidad computacional seguramente se reflejará en los gastos.
− Dificultades de administración
Administrar múltiples clústeres de Kubernetes es mucho más complicado que trabajar con uno solo.
Por ejemplo, será necesario configurar la autenticación y autorización para cada clúster. La actualización de la versión de Kubernetes también deberá realizarse varias veces.
Lo más probable es que sea necesario aplicar automatización para mejorar la eficiencia de todas estas tareas.
Ahora consideremos escenarios menos extremos.
3. Un clúster por cada aplicación
En este enfoque, creas un clúster separado para todas las instancias de una aplicación específica:
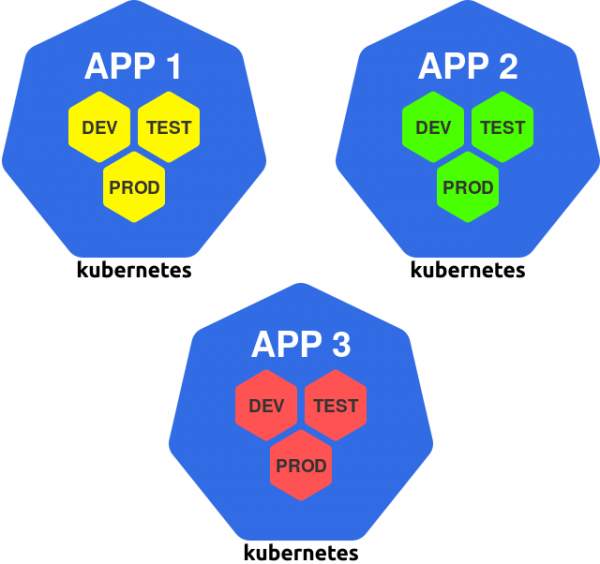
Clúster por aplicación
Este camino puede considerarse como una generalización del principio "un clúster por equipo", ya que generalmente un equipo de ingenieros se ocupa del desarrollo de una o varias aplicaciones.
+ Uso eficiente de recursos
+ El clúster se puede adaptar a la aplicación
Si una aplicación tiene necesidades especiales, se pueden implementar en el clúster sin afectar a otros clústeres.
Estas necesidades pueden incluir workers con GPU, ciertos complementos CNI, service mesh o algún otro servicio.
Cada clúster se puede ajustar según la aplicación en él operativa, para que contenga solo lo necesario.
− Diferentes entornos en un mismo clúster
Una desventaja de este enfoque es que las instancias de aplicaciones de diferentes entornos coexisten en un mismo clúster.
Por ejemplo, la versión de producción de la aplicación opera en el mismo clúster que la versión de desarrollo. Esto también significa que los desarrolladores llevan a cabo su trabajo en el mismo clúster donde se ejecuta la versión de producción de la aplicación.
Si, debido a acciones de los desarrolladores o fallos de la versión de desarrollo, ocurre un fallo en el clúster, potencialmente la versión de producción también puede verse afectada, lo cual es una gran desventaja de este enfoque.
Y, por último, el último escenario en nuestra lista.
4. Un clúster por cada entorno
Este escenario prevé asignar un clúster separado para cada entorno:
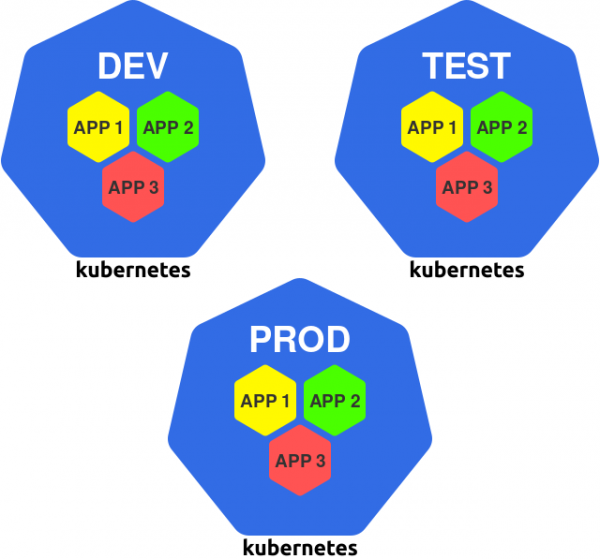
Un clúster por entorno
Por ejemplo, puede que tengas clústeres dev, test y prod, en los que lanzarás todas las instancias de la aplicación destinadas a un entorno específico.
Aquí están las ventajas y desventajas de este enfoque.
+ Aislamiento del entorno de producción
En este enfoque, todos los entornos están aislados entre sí. Sin embargo, en la práctica, esto es especialmente importante para el entorno de producción.
Las versiones de producción de la aplicación ahora no dependen de lo que ocurre en otros clústeres y entornos.
Por lo tanto, si de repente surge un problema en el clúster de desarrollo, las versiones de producción de las aplicaciones seguirán funcionando como si nada hubiera pasado.
+ El clúster se puede adaptar al entorno
Cada clúster se puede adaptar a su entorno. Por ejemplo, se puede:
- instalar herramientas de desarrollo y depuración en el clúster de desarrollo;
- instalar marcos y herramientas de prueba en el clúster; test;
- utilizar hardware y canales de red más potentes en el clúster prod.
Esto permite aumentar la eficiencia tanto en el desarrollo como en la operación de aplicaciones.
+ Restricción de acceso al clúster de producción
La necesidad de trabajar directamente con el clúster de producción no ocurre con frecuencia, por lo que se puede restringir significativamente el número de personas que tienen acceso a él.
Se puede ir aún más lejos y negar completamente el acceso a este clúster a las personas, realizando todos los despliegues mediante una herramienta de automatización CI/CD. Este enfoque ayudará a minimizar el riesgo de errores humanos precisamente donde más se necesita.
Y ahora unas palabras sobre las desventajas.
− Falta de aislamiento entre aplicaciones
La principal desventaja del enfoque es la falta de aislamiento de hardware y recursos entre las aplicaciones.
Las aplicaciones no relacionadas comparten los recursos del clúster: núcleo del sistema, procesador, memoria y algunos otros servicios.
Como se mencionó anteriormente, esto puede ser potencialmente peligroso.
− Imposibilidad de localizar las dependencias de las aplicaciones
Si una aplicación tiene requisitos específicos, es necesario satisfacerlos en todos los clústeres.
Por ejemplo, si una aplicación necesita GPU, cada clúster debe tener al menos un worker con GPU (incluso si solo es usado por esta aplicación).
Como resultado, corremos el riesgo de tener costos más altos y un uso ineficiente de los recursos.
Conclusión
Con un conjunto determinado de aplicaciones, se pueden colocar en varios clústeres grandes o en muchos pequeños.
El artículo analiza las ventajas y desventajas de diferentes enfoques, desde un solo clúster global hasta varios pequeños y especializados:
- un gran clúster común;
- varios clústeres pequeños y especializados;
- un clúster para cada aplicación;
- un clúster para cada entorno.
Entonces, ¿qué enfoque elegir?
Como suele ser, la respuesta depende del escenario de uso: es necesario sopesar las ventajas y desventajas de los diferentes enfoques y elegir la opción más óptima.
Sin embargo, la elección no se limita a los ejemplos mencionados anteriormente: ¡se puede emplear cualquier combinación de ellos!
Por ejemplo, se puede organizar un par de clústeres para cada equipo: un clúster para desarrollo (en el que estarán los entornos dev y test) y un clúster para producción (donde estará el entorno de producción).
Basándote en la información de este artículo, podrás optimizar las ventajas y desventajas según el escenario específico. ¡Buena suerte!
P.D.
También puedes leer en nuestro blog:
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
