

Esta es una transcripción de la presentación en y .
Esta es la historia de un proyecto que utilizaba un sistema de gestión de configuraciones hecho a medida y por qué la migración a Ansible se prolongó durante 18 meses.
Día № -XXX: Antes de comenzar
Inicialmente, la infraestructura consistía en numerosos hosts independientes gestionados por Hyper-V. La creación de una máquina virtual requería múltiples acciones: colocar los discos en el lugar correcto, configurar DNS, reservar DHCP, y almacenar la configuración de la MV en un repositorio git. Este proceso estaba parcialmente automatizado, pero por ejemplo, las MV se distribuían entre los hosts manualmente. Sin embargo, los desarrolladores podían modificar la configuración de la MV en git y aplicarla reiniciando la MV.
Solución de Gestión de Configuraciones Personalizada
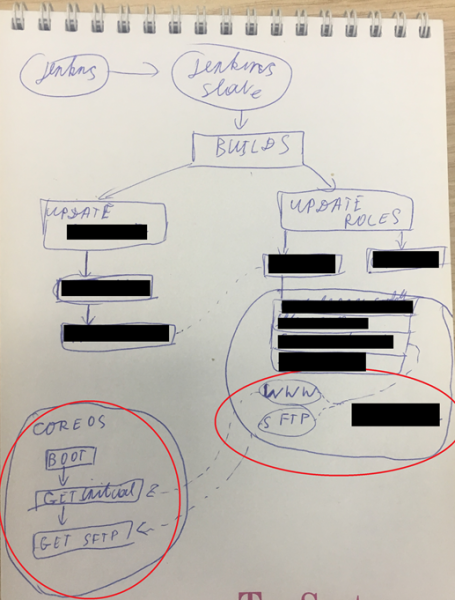
La idea inicial, sospecho, se pensó como IaC: numerosas MV sin estado, que al reiniciarse restablecían su estado. ¿Cómo se veía la gestión de configuraciones de las MV? Es esquemáticamente simple:
- Se asignaban direcciones MAC estáticas a las MV.
- Se conectaba una ISO con CoreOS y un disco de arranque a la MV.
- CoreOS ejecuta un script de personalización descargándolo de un servidor WEB en función de su IP.
- El script extrae la configuración de la MV a través de SCP basándose en la dirección IP.
- Se inicia una serie de archivos de unidad systemd y una serie de scripts bash.
Esta solución tenía muchos problemas evidentes:
- La ISO en CoreOS estaba en desuso.
- Una multitud de acciones y magia difíciles de automatizar al migrar/crear MV.
- Dificultades con las actualizaciones y cuando se necesitaba un software de cierta versión. Aún más complicado con los módulos del núcleo.
- Las MV no estaban completamente vacías de datos, es decir, había MV que tenían un disco montado con datos del usuario adicionalmente.
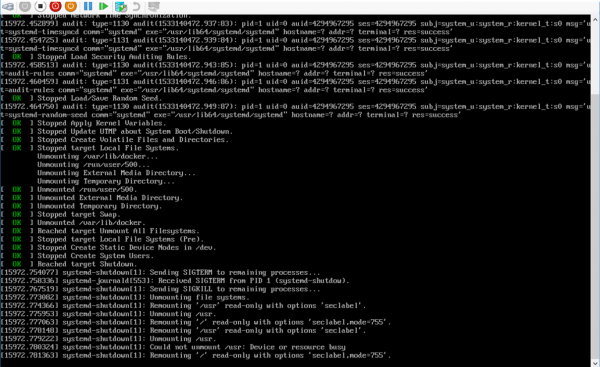
- Constantemente había alguien que cometía errores con las dependencias de las unidades systemd, y al reiniciar, CoreOS se colgaba. Era problemático detectar esto con los medios disponibles en CoreOS.
- Gestión de secretos.
- No había una gestión de configuraciones, solo había bash y configuraciones YML de CoreOS.
Para aplicar la configuración de la MV, era necesario reiniciarla, pero esta podría no reiniciarse. Parecía un problema obvio, pero no hay discos persistentes, no había lugar para guardar los logs. Bueno, intentemos agregar opciones de arranque del núcleo para enviar los logs. Pero no, todo es tan complicado.
Día №0: Reconocimiento del problema
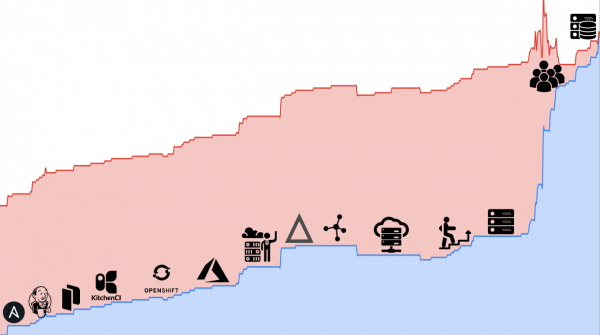
Era una infraestructura de desarrollo común: jenkins, entornos de prueba, monitoreos, registry. CoreOS estaba pensado para alojar clústeres de k8s, es decir, el problema radicaba en cómo se estaba utilizando CoreOS. El primer paso fue elegir la pila.
- CentOS como distribución base, ya que es la distribución más cercana a los entornos de producción.
- Ansible para la gestión de configuraciones, dado que había una amplia experiencia en ello.
- Jenkins como un marco para la automatización de procesos existentes, ya que ya se utilizaba activamente para procesos de desarrollo.
- Hyper-V como plataforma de virtualización. Hay varias razones, más allá de lo que se puede contar, pero en resumen: no podemos utilizar la nube, debemos usar nuestro propio hardware.
Día Nº30: Formalizando los acuerdos existentes — Agreements as Code
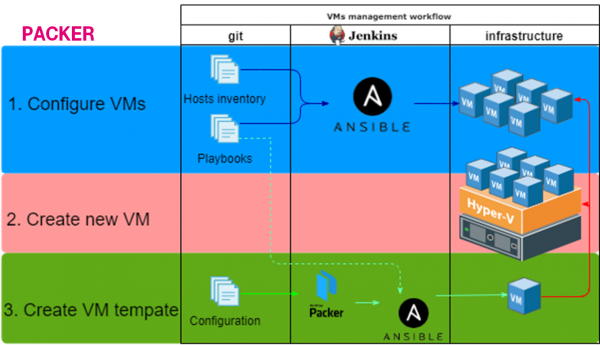
Cuando se entendió la pila, comenzó la preparación para la migración. Formalizando los acuerdos existentes en forma de código (Agreements as Code!). Transición trabajo manual -> mecanización -> automatización.
1. Configurar VMs
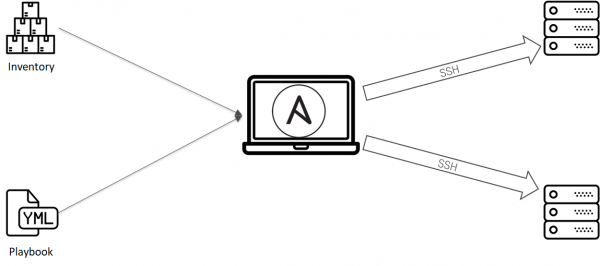
Ansible se desempeña excelentemente en esta tarea. Con mínimas acciones, se puede gestionar las configuraciones de las VMs:
- Creamos un repositorio git.
- Almacenamos la lista de VMs en el inventario, las configuraciones en playbooks y roles.
- Configuramos un slave de jenkins especial desde el que se podrá ejecutar ansible.
- Creamos un job, configuramos Jenkins.
El primer proceso está listo. Los acuerdos están formalizados.
2. Crear nueva VM
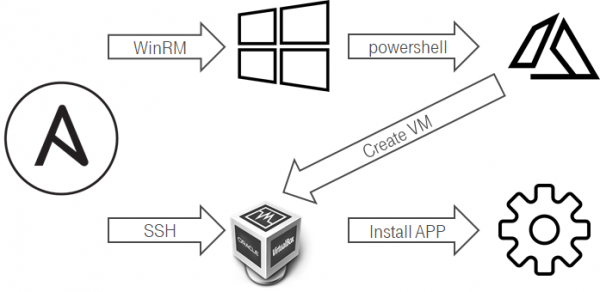
Aquí no era muy conveniente. Desde Linux no es muy fácil crear VMs en Hyper-V. Uno de los intentos de mecanizar este proceso fue:
- Ansible se conecta al host de Windows a través de WinRM.
- Ansible ejecuta un script de PowerShell.
- El script de PowerShell crea una nueva VM.
- Con Hyper-V/ScVMM, al crear una VM se configura el hostname en el sistema operativo invitado.
- La VM al actualizar el lease de DHCP envía su hostname.
- La integración estándar de ddns & dhcp en el controlador de dominio configura la entrada DNS.
- Se pueden añadir VMs al inventario y configurarlas con Ansible.
3. Crear plantilla de VM
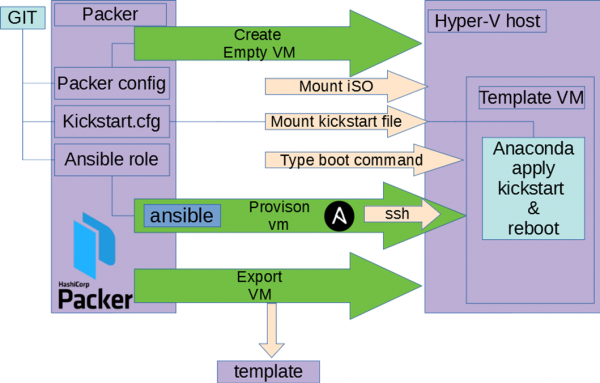
Aquí no se inventó nada; utilizamos packer.
- En el repositorio git almacenamos la configuración de packer, kickstart.
- Configuramos un slave de jenkins especial con hyper-v y Packer.
- Creamos un job, configuramos Jenkins.
Cómo funciona esta conexión:
- Packer crea una VM vacía, conecta el ISO.
- La VM arranca, Packer introduce en el cargador el comando para usar nuestro archivo kickstart desde un disquete o http.
- Se inicia anaconda con nuestra configuración, se hace la configuración inicial del sistema operativo.
- Packer espera la disponibilidad de la VM.
- Packer dentro de la VM ejecuta ansible en modo local.
- Ansible utiliza exactamente los mismos roles que en el paso nº 1.
- Packer exporta la plantilla de la VM.
Día nº 75: Refactorizamos los acuerdos sin romper = Prueba de ansible + Testkitchen
Fijar acuerdos en el código puede no ser suficiente. A veces, si deseas cambiar algo durante el proceso, podrías romper algo. Por eso en la infraestructura también aparece la necesidad de probarla. Para sincronizar el conocimiento dentro del equipo, comenzamos a probar los roles de Ansible. No profundizaré, ya que hay un artículo que describe los eventos de ese momento. (spoiler: esta no fue la versión final y después todo se volvió más complicado) ).
Día nº 130: ¿Y si CentOS+ansible no es necesario? ¿Quizás openshift?
Hay que entender que el proceso de incorporación de infraestructura no fue el único y había subproyectos paralelos. Por ejemplo, recibimos una solicitud para ejecutar nuestra aplicación en openshift y esto resultó en investigaciones que tomaron más de una semana. ¿Qué ralentizó el proceso de migración? Al final, resultó que openshift no cubría todas las necesidades; necesitábamos hardware real, o al menos la posibilidad de jugar con el núcleo.
Día nº 170: Openshift no es adecuado, ¿nos arriesgamos con Windows Azure Pack?
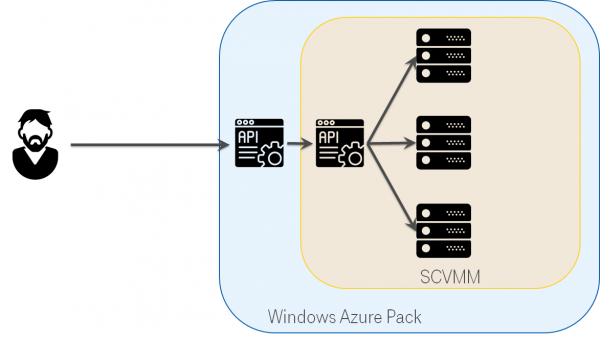
Hyper-V no es muy amigable, SCVMM no lo mejora mucho. Pero existe Windows Azure Pack, que es una capa sobre SCVMM y mimetiza Azure. Sin embargo, en realidad, el producto parece abandonado: la documentación está llena de enlaces rotos y es bastante escasa. Pero como parte de la investigación de opciones para simplificar la vida de nuestra nube, también lo consideramos.
Día nº 250: Windows Azure Pack no es muy bueno. Nos quedamos en SCVMM.
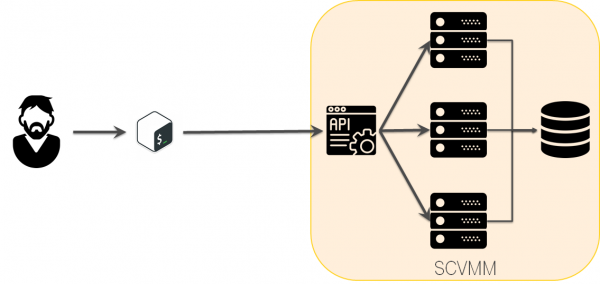
Windows Azure Pack parecía prometedor, pero se decidió no introducir WAP con sus complicaciones en el sistema por características innecesarias y nos quedamos en SCVMM.
Día nº 360: Comemos al elefante en partes.
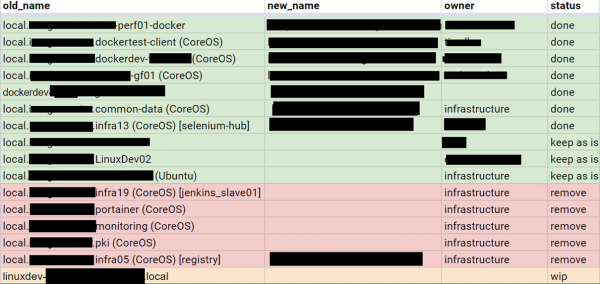
Solo después de un año la plataforma estaba lista para migrar y comenzó el proceso de traslado. Para esto, se estableció una tarea S.M.A.R.T. Enumeramos todas las VMs y comenzamos a revisar una por una junto con su configuración, descripciones en Ansible y pruebas.
Día nº 450: ¿Qué sistema se obtuvo?
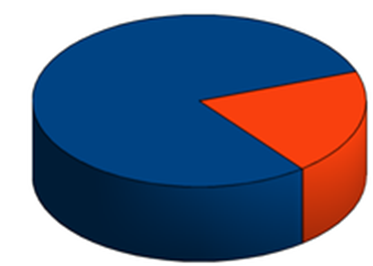
El proceso en sí no es interesante. Es rutinario; se puede señalar que la mayoría de las configuraciones eran relativamente simples o isomórficas y, siguiendo el principio de Pareto, el 80% de las configuraciones requirió el 20% del tiempo. Del mismo modo, el 80% del tiempo se dedicó a la preparación de la mudanza y solo el 20% al propio traslado.
Día nº 540: Final
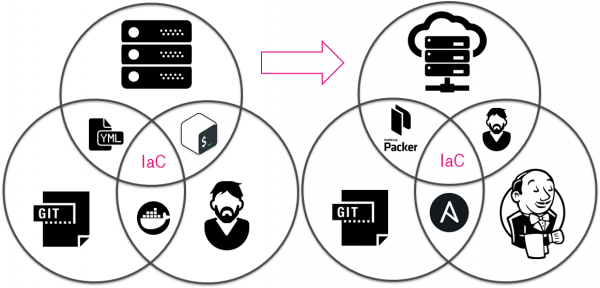
¿Qué ha pasado en 18 meses?
- Los acuerdos se convirtieron en código.
- Trabajo manual -> Mecanización -> Automatización.
Links
Fuente: habr.com
