

Este artículo ayudará a entender cómo funciona el balanceo de carga en Kubernetes, qué sucede al escalar conexiones persistentes y por qué deberías considerar el balanceo del lado del cliente si utilizas HTTP/2, gRPC, RSockets, AMQP u otros protocolos persistentes.
Un poco sobre cómo se redistribuye el tráfico en Kubernetes
Kubernetes proporciona dos abstracciones cómodas para desplegar aplicaciones: servicios (Services) y despliegues (Deployments).
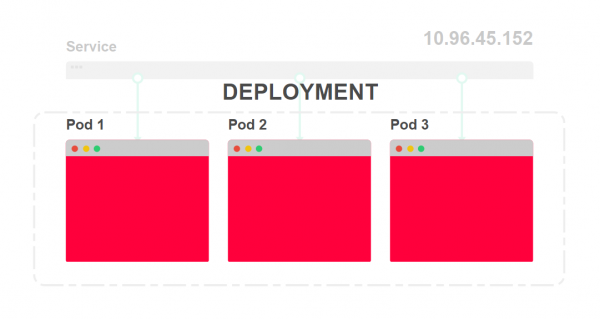
Los despliegues describen cómo y cuántas copias de tu aplicación deberían estar en funcionamiento en cualquier momento. Cada aplicación se despliega como un pod (Pod) y se le asigna una dirección IP.
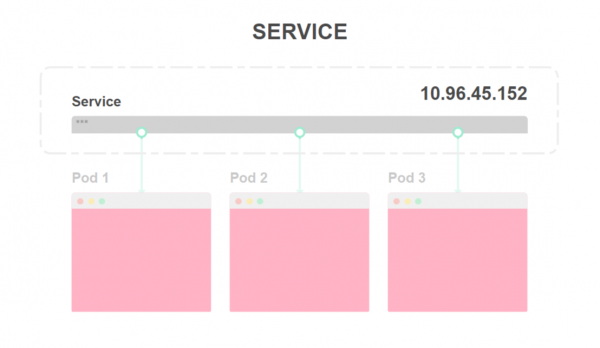
Los servicios son funcionalmente similares a un balanceador de carga. Están diseñados para distribuir el tráfico entre múltiples pods.
Veamos cómo se ve esto.
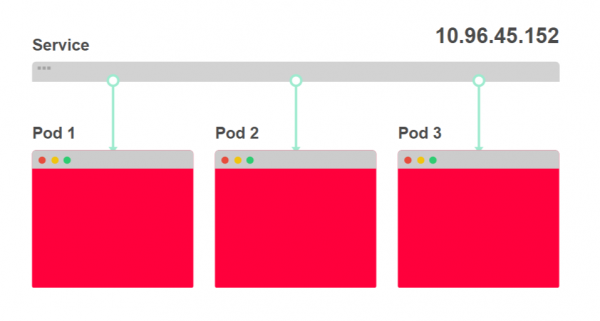
- En el diagrama a continuación, verás tres instancias de una aplicación y un balanceador de carga:

- El balanceador de carga se llama servicio (Service) y se le ha asignado una dirección IP. Cualquier solicitud entrante se redirige a uno de los pods:

- El escenario de despliegue define la cantidad de instancias de la aplicación. Casi nunca tendrás que desplegar directamente un pod:

- Cada pod se le asigna su propia dirección IP:

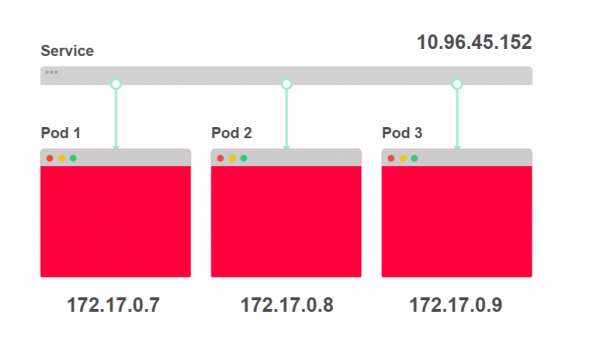
Es útil considerar los servicios como un conjunto de direcciones IP. Cada vez que accedes a un servicio, se selecciona una de las direcciones IP de la lista y se usa como destino.
Esto se ve de la siguiente manera.
- Una solicitud curl 10.96.45.152 al servicio llega:

- El servicio selecciona una de las tres direcciones de los pods como destino:

- El tráfico se redirige a un pod específico:


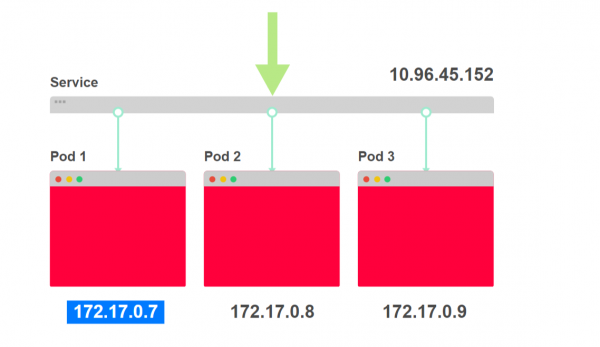
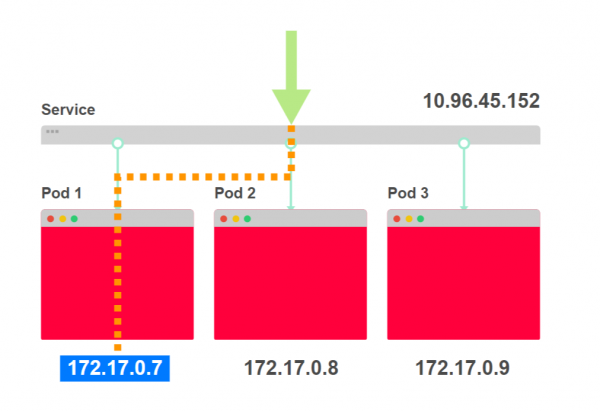
Si tu aplicación consiste en un frontend y un backend, tendrás tanto un servicio como un despliegue para cada uno.
Cuando el frontend realiza una solicitud al backend, no necesita saber cuántos pods está gestionando el backend: pueden ser uno, diez o cien.
Además, el frontend no conoce las direcciones de los pods que gestionan el backend.
Cuando el frontend realiza una solicitud al backend, utiliza la dirección IP del servicio del backend, que no cambia.
Así es como se ve esto.
- El pod 1 solicita a un componente interno del backend. En lugar de seleccionar un pod específico del backend, envía la solicitud al servicio:

- El servicio selecciona uno de los pods del backend como dirección de destino:

- El tráfico va del pod 1 al pod 5, seleccionado por el servicio:

- El pod 1 no sabe cuántos pods como el pod 5 están ocultos detrás del servicio:

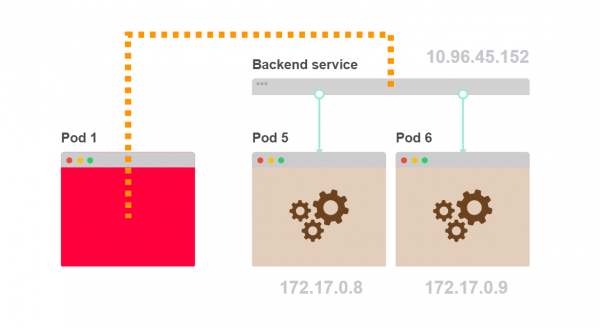
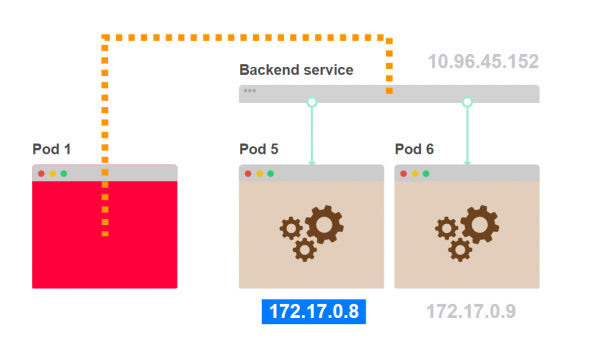
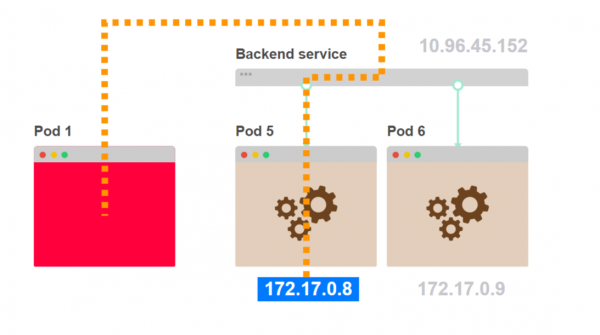
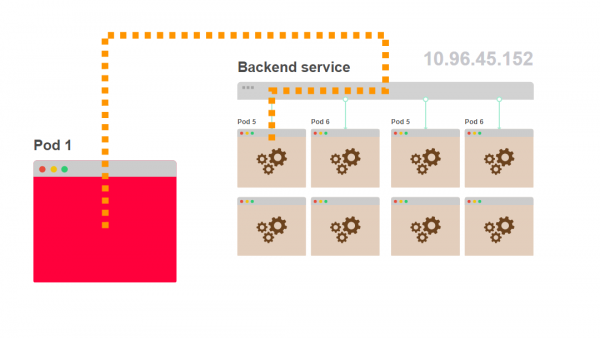
¿Pero cómo exactamente distribuye el servicio las solicitudes? ¿Se utiliza balanceo de carga round-robin? Vamos a investigarlo.
Balanceo de carga en servicios de Kubernetes
Los servicios de Kubernetes no existen. Para un servicio, no hay un proceso al que se le asigne una dirección IP y un puerto.
Puedes comprobarlo accediendo a cualquier nodo del clúster y ejecutando el comando netstat -ntlp.
Ni siquiera podrás encontrar la dirección IP asignada al servicio.
La dirección IP del servicio se sitúa en la capa de control, en el controlador, y está registrada en la base de datos — etcd. Esta misma dirección es utilizada por otro componente — kube-proxy.
Kube-proxy obtiene la lista de direcciones IP de todos los servicios y forma un conjunto de reglas iptables en cada nodo del clúster.
Estas reglas dicen: “Si vemos la dirección IP del servicio, debemos modificar la dirección de destino de la solicitud y enviarla a uno de los pods.”
La dirección IP del servicio solo se utiliza como punto de entrada y no es atendida por ningún proceso que escuche esa dirección IP y puerto.
Veamos esto.
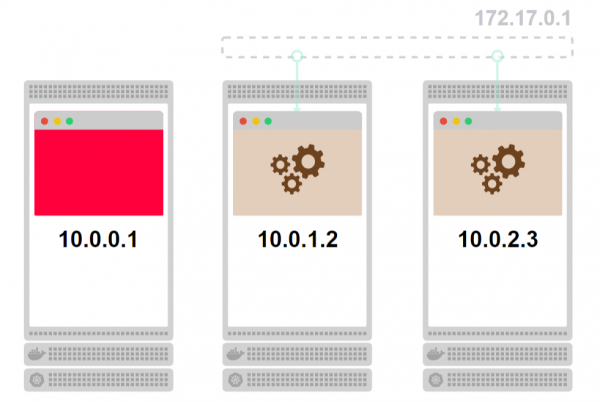
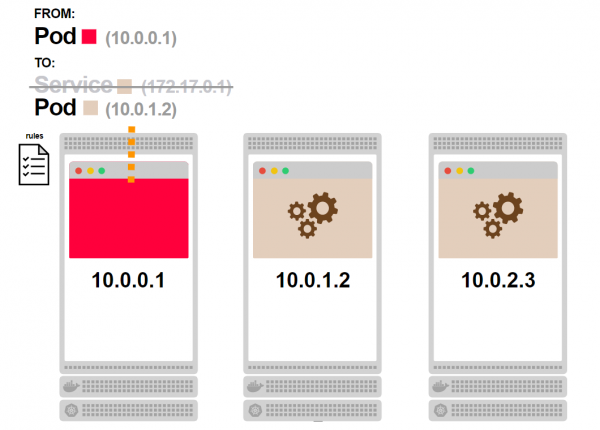
- Consideremos un clúster de tres nodos. En cada nodo hay pods:

- Los pods relacionados, coloreados de beige, son parte del servicio. Dado que el servicio no existe como proceso, se muestra en color gris:

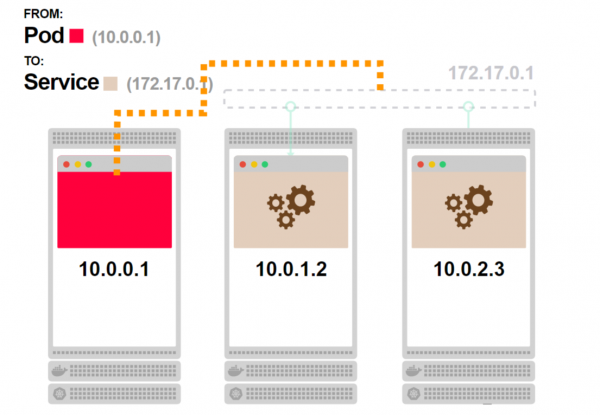
- El primer pod solicita el servicio y debe acceder a uno de los pods relacionados:

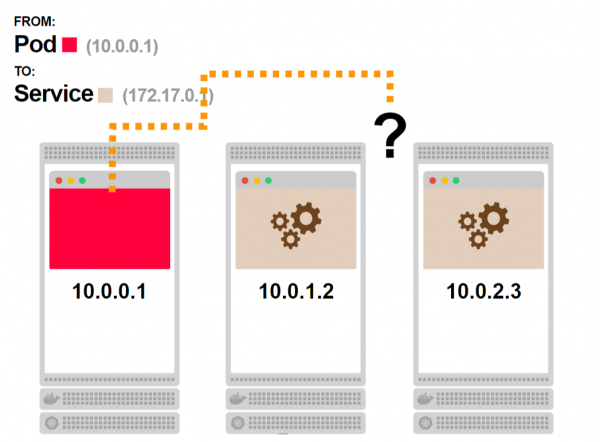
- Pero el servicio no existe, no hay un proceso. ¿Cómo funciona esto?

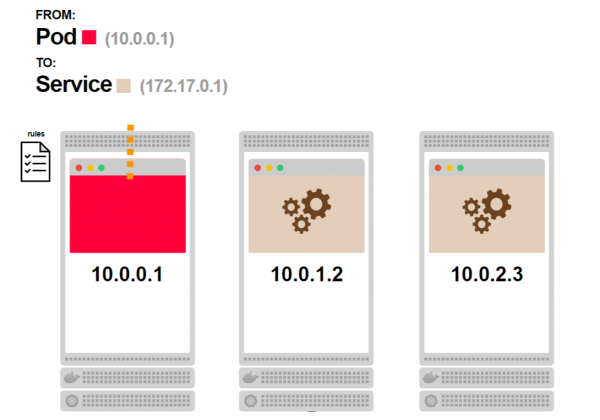
- Antes de que la solicitud salga del nodo, pasa por las reglas de iptables:

- Las reglas de iptables saben que el servicio no existe y reemplazan su dirección IP por una de las direcciones IP de los pods relacionados con este servicio:

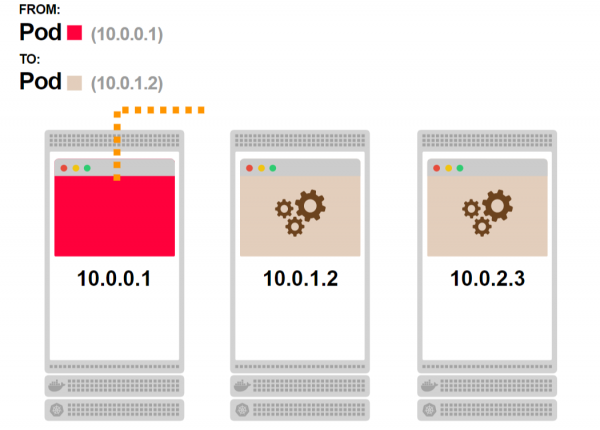
- La solicitud recibe una dirección IP válida como dirección de destino y es procesada correctamente:
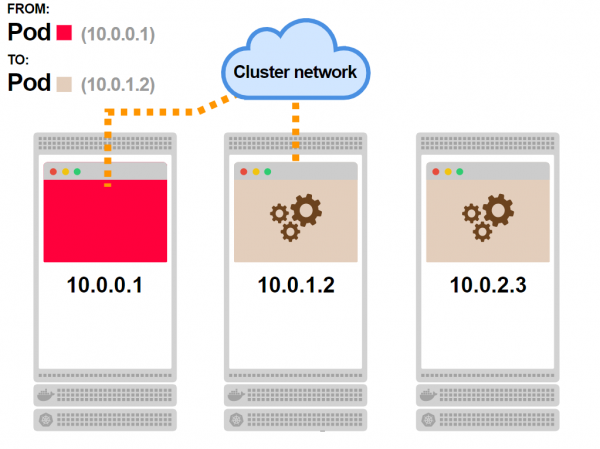
- Dependiendo de la topología de red, la solicitud finalmente alcanza el pod:

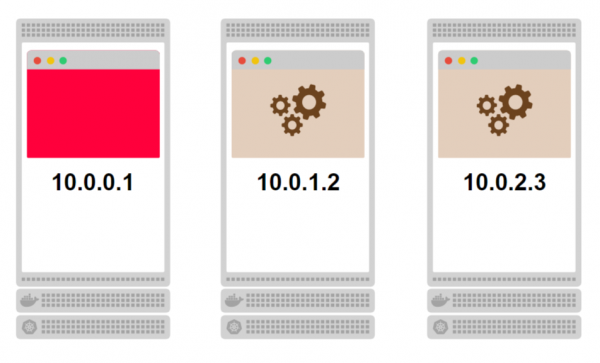
¿Pueden iptables balancear la carga?
No, iptables se utilizan para filtrar y no fueron diseñados para balancear.
Sin embargo, existe la posibilidad de escribir un conjunto de reglas que funcionen como .
Y eso es precisamente lo que se implementa en Kubernetes.
Si tienes tres pods, kube-proxy escribirá las siguientes reglas:
- Seleccionar el primer pod con una probabilidad del 33%, de lo contrario pasar a la siguiente regla.
- Selecciona el segundo pod con una probabilidad del 50%, de lo contrario pasa a la siguiente regla.
- Selecciona el tercer pod.
Este sistema lleva a que cada pod se seleccione con una probabilidad del 33%.
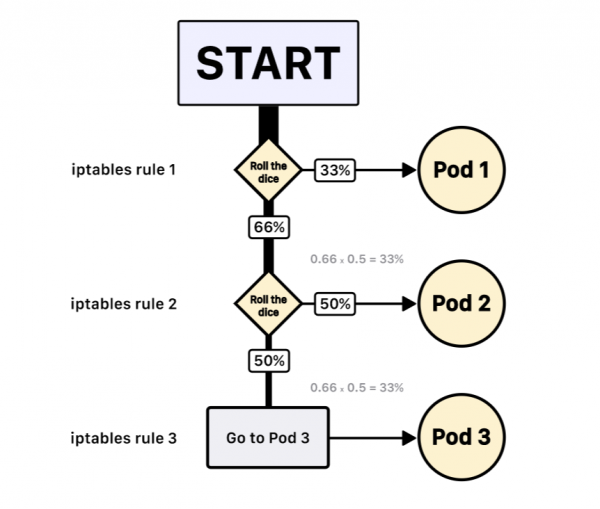
Y no hay garantía de que el pod 2 sea seleccionado después del pod 1.
Nota: iptables utiliza un módulo estadístico con distribución aleatoria. Por lo tanto, el algoritmo de balanceo se basa en una selección aleatoria.
Ahora que comprendes cómo funcionan los servicios, veamos escenarios de trabajo más interesantes.
Las conexiones de larga duración en Kubernetes no se escalan por defecto.
Cada solicitud HTTP del frontend al backend es atendida por una conexión TCP separada que se abre y se cierra.
Si el frontend envía 100 solicitudes por segundo al backend, se abrirán y cerrarán 100 diferentes conexiones TCP.
Se puede reducir el tiempo de procesamiento de la solicitud y disminuir la carga si se abre una sola conexión TCP y se utiliza para todas las solicitudes HTTP posteriores.
El protocolo HTTP incluye una función llamada HTTP keep-alive, o reutilización de conexión. En este caso, una sola conexión TCP se utiliza para enviar y recibir múltiples solicitudes y respuestas HTTP:
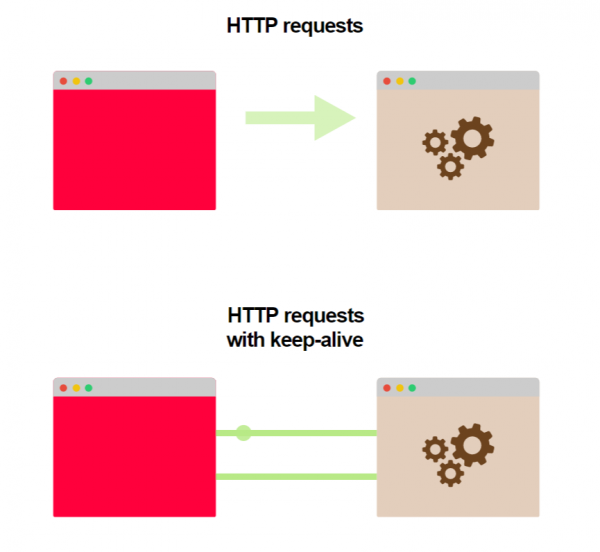
Esta función no está habilitada por defecto: tanto el servidor como el cliente deben configurarse apropiadamente.
La configuración en sí misma es sencilla y está disponible para la mayoría de los lenguajes de programación y entornos.
Aquí hay algunos enlaces a ejemplos en diferentes lenguajes:
¿Qué sucederá si usamos keep-alive en el servicio de Kubernetes?
Supongamos que tanto el frontend como el backend soportan keep-alive.
Tenemos una copia del frontend y tres instancias del backend. El frontend realiza la primera solicitud y abre una conexión TCP al backend. La solicitud llega al servicio, y uno de los pods del backend es seleccionado como dirección de destino. El pod del backend envía una respuesta, y el frontend la recibe.
A diferencia de la situación habitual, cuando se recibe la respuesta la conexión TCP se cierra, ahora se mantiene abierta para las siguientes solicitudes HTTP.
¿Qué sucederá si el frontend envía más solicitudes al backend?
Para enviar esas solicitudes se utilizará la conexión TCP abierta, todas las solicitudes llegarán al mismo pod del backend al que llegó la primera solicitud.
¿No debería iptables redistribuir el tráfico?
No en este caso.
Cuando se establece una conexión TCP, pasa a través de las reglas de iptables, que seleccionan un pod específico del backend donde se enviará el tráfico.
Dado que todas las solicitudes subsiguientes utilizan la conexión TCP ya abierta, las reglas de iptables ya no se invocan.
Veamos cómo se ve esto.
- El primer pod envía una solicitud al servicio:

- Ya sabes lo que sucederá a continuación. El servicio no existe, pero hay reglas de iptables que procesarán la solicitud:
- Uno de los pods del backend será seleccionado como dirección de destino:

- La solicitud llega al pod. En este momento se establecerá una conexión TCP persistente entre los dos pods:

- Cualquier solicitud subsiguiente del primer pod irá a través de la conexión ya establecida:

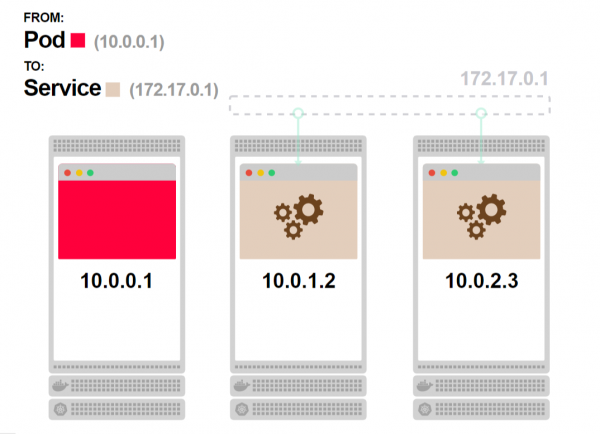
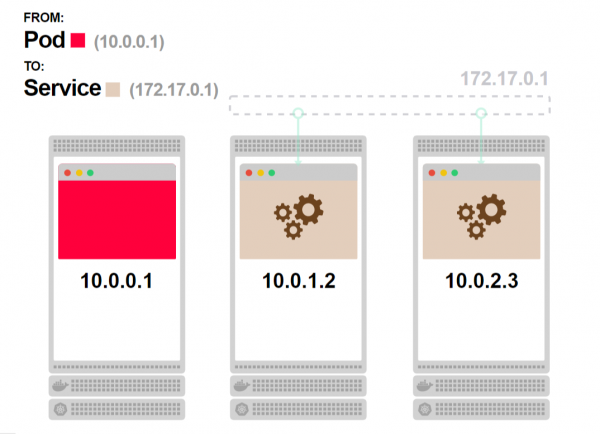
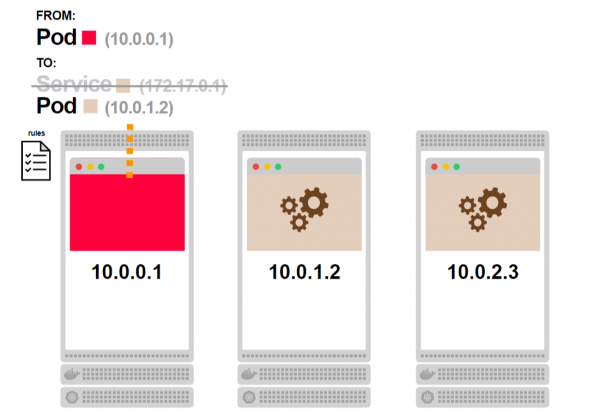
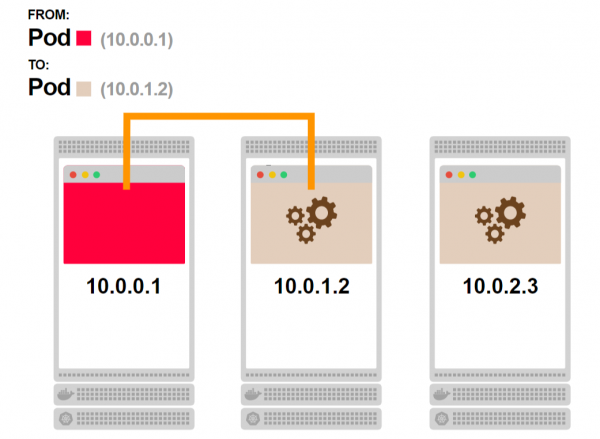
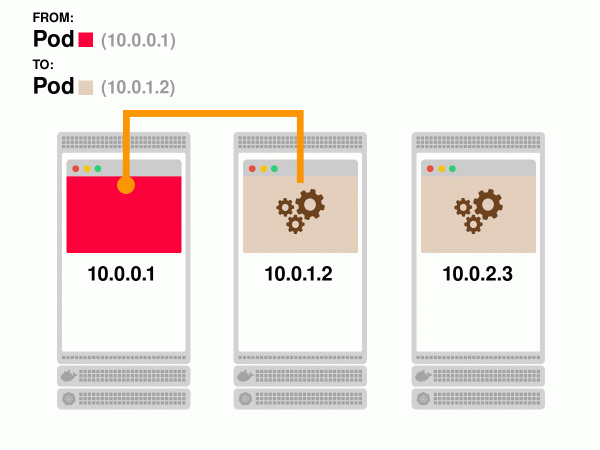
Como resultado, obtuviste un tiempo de respuesta más rápido y una mayor capacidad de ancho de banda, pero perdiste la capacidad de escalar el backend.
Incluso si tienes dos pods en el backend, con una conexión persistente, el tráfico siempre irá a uno de ellos.
¿Se puede solucionar esto?
Dado que Kubernetes no sabe cómo equilibrar conexiones persistentes, esta tarea recae en ti.
Los servicios son un conjunto de direcciones IP y puertos que se denominan puntos finales.
Tu aplicación puede obtener una lista de puntos finales del servicio y decidir cómo distribuir las solicitudes entre ellos. Puedes abrir una conexión persistente con cada pod y equilibrar las solicitudes entre estas conexiones utilizando round-robin.
O aplicar algoritmos de balanceo .
El código del lado del cliente que se encarga del balanceo debe seguir esta lógica:
- Obtener una lista de puntos finales del servicio.
- Para cada punto final, abrir una conexión persistente.
- Cuando necesites hacer una solicitud, utilizar una de las conexiones abiertas.
- Actualizar regularmente la lista de puntos finales, creando nuevas o cerrando antiguas conexiones persistentes en caso de que cambie la lista.
Así es como se verá.
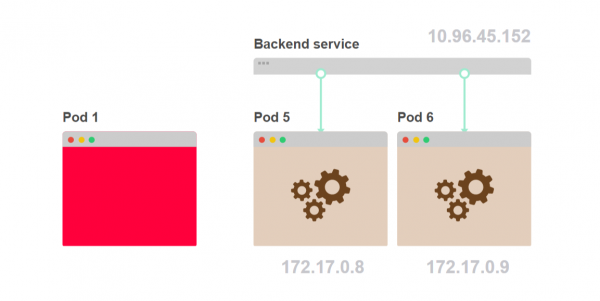
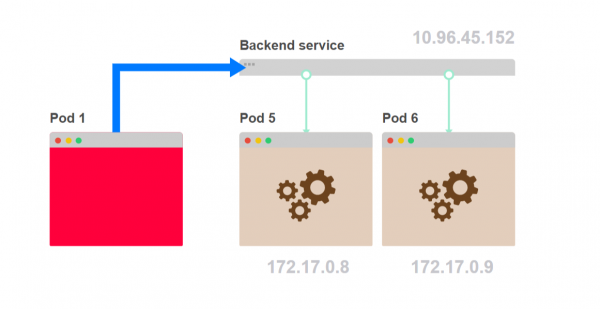
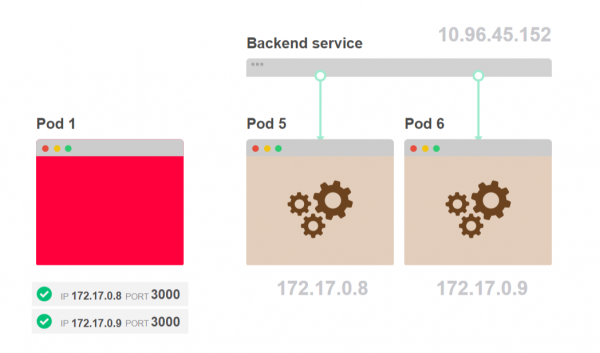
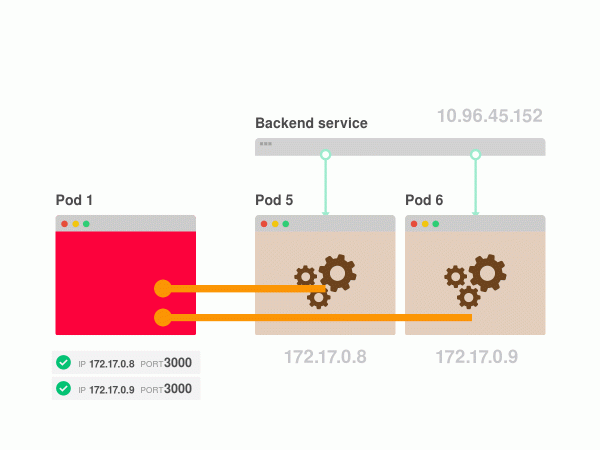
- En lugar de que el primer pod envíe la solicitud al servicio, puedes equilibrar las solicitudes del lado del cliente:

- Necesitas escribir código que pregunte qué pods son parte del servicio:

- Una vez que obtengas la lista, guárdala en el lado del cliente y úsala para conectarte a los pods:

- Usted es responsable del algoritmo de balanceo de carga:
Ahora surge la pregunta: ¿se refiere este problema solo a HTTP keep-alive?
Balanceo de carga del lado del cliente
HTTP no es el único protocolo que puede utilizar conexiones TCP persistentes.
Si su aplicación utiliza una base de datos, la conexión TCP no se abre cada vez que necesita ejecutar una consulta o recuperar un documento de la base de datos.
En su lugar, se abre y utiliza una conexión TCP persistente a la base de datos.
Si su base de datos está desplegada en Kubernetes y se accede a ella mediante un servicio, enfrentará los mismos problemas descritos en la sección anterior.
Una réplica de la base de datos estará más cargada que las demás. Kube-proxy y Kubernetes no ayudarán a balancear las conexiones. Debe ocuparse del balanceo de las solicitudes a su base de datos.
Dependiendo de la biblioteca que utilice para conectarse a la base de datos, puede tener diversas opciones para resolver este problema.
A continuación se muestra un ejemplo de acceso a un clúster de base de datos MySQL desde Node.js:
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints = /* obtener puntos finales del Servicio */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Realizar consultas a la base de datos MySQL en clúster
Existen muchos otros protocolos que utilizan conexiones TCP persistentes:
- WebSockets y WebSockets seguros
- HTTP/2
- gRPC
- RSockets
- AMQP
Ya debería estar familiarizado con la mayoría de estos protocolos.
Pero si estos protocolos son tan populares, ¿por qué no hay una solución estandarizada para el balanceo? ¿Por qué se requiere un cambio en la lógica del cliente? ¿Existe una solución nativa de Kubernetes?
Kube-proxy e iptables están diseñados para manejar la mayoría de los escenarios de uso estándar al desplegar en Kubernetes. Esto se hace por comodidad.
Si utiliza un servicio web que proporciona una API REST, tiene suerte: en este caso, no se utilizan conexiones TCP persistentes, puede usar cualquier servicio de Kubernetes.
Pero en cuanto comience a utilizar conexiones TCP persistentes, deberá lidiar con cómo distribuir uniformemente la carga entre los backends. Kubernetes no contiene soluciones listas para esto.
Sin embargo, por supuesto, existen opciones que pueden ayudar.
Balanceo de conexiones de larga duración en Kubernetes
En Kubernetes hay cuatro tipos de servicios:
- ClusterIP
- NodePort.
- LoadBalancer
- Headless
Los primeros tres servicios funcionan sobre la base de una dirección IP virtual, que es utilizada por kube-proxy para construir reglas de iptables. Pero la base fundamental de todos los servicios es un servicio del tipo headless.
No hay ninguna dirección IP asociada con el servicio headless y solo proporciona un mecanismo para obtener una lista de direcciones IP y puertos relacionados con sus pods (puntos finales).
Todos los servicios se basan en el servicio headless.
El servicio ClusterIP es un servicio headless con algunas adiciones:
- La capa de gestión le asigna una dirección IP.
- Kube-proxy forma las reglas de iptables necesarias.
Así, puedes ignorar kube-proxy y utilizar directamente la lista de puntos finales obtenida del servicio headless para la distribución de carga en tu aplicación.
Pero, ¿cómo agregar esta lógica a todas las aplicaciones desplegadas en el clúster?
Si tu aplicación ya está desplegada, esta tarea puede parecer imposible. Sin embargo, hay una alternativa.
Service Mesh te ayudará.
Probablemente ya hayas notado que la estrategia de balanceo de carga del lado del cliente es bastante estándar.
Cuando la aplicación se inicia, esta:
- Obtiene una lista de direcciones IP del servicio.
- Abre y mantiene un pool de conexiones.
- Actualiza periódicamente el pool, añadiendo o eliminando puntos finales.
Tan pronto como la aplicación quiere hacer una solicitud, esta:
- Selecciona una conexión disponible utilizando alguna lógica (por ejemplo, round-robin).
- Realiza la solicitud.
Estos pasos funcionan tanto para conexiones WebSockets como para gRPC y AMQP.
Puedes extraer esta lógica en una biblioteca separada y usarla en tus aplicaciones.
Sin embargo, en su lugar, puedes usar mallas de servicios, como Istio o Linkerd.
Service Mesh complementa tu aplicación con un proceso que:
- Busca automáticamente las direcciones IP de los servicios.
- Verifica las conexiones, como WebSockets y gRPC.
- Balancea las solicitudes, utilizando el protocolo adecuado.
Service Mesh ayuda a gestionar el tráfico dentro del clúster, pero es bastante exigente en recursos. Otras opciones son usar bibliotecas de terceros, como Netflix Ribbon, o proxys programables, como Envoy.
¿Qué sucederá si se ignoran los problemas de balanceo?
Puedes no usar balanceo de carga y no notar ningún cambio. Vamos a ver algunos escenarios de funcionamiento.
Si tienes más clientes que servidores, no es un gran problema.
Supongamos que hay cinco clientes conectándose a dos servidores. Incluso si no hay balanceo, ambos servidores serán utilizados:
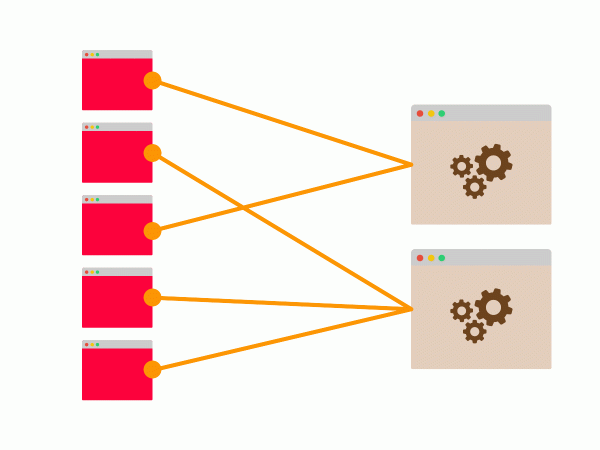
Las conexiones pueden distribuirse de manera desigual: es posible que cuatro clientes se conecten al mismo servidor, pero existe una buena probabilidad de que ambos servidores sean utilizados.
Lo que es más problemático es el escenario opuesto.
Si tienes menos clientes y más servidores, tus recursos pueden no ser utilizados de manera eficiente, lo que podría crear un posible cuello de botella.
Supongamos que hay dos clientes y cinco servidores. En el mejor de los casos, habrá dos conexiones constantes a dos de los cinco servidores.
Los demás servidores estarán inactivos:
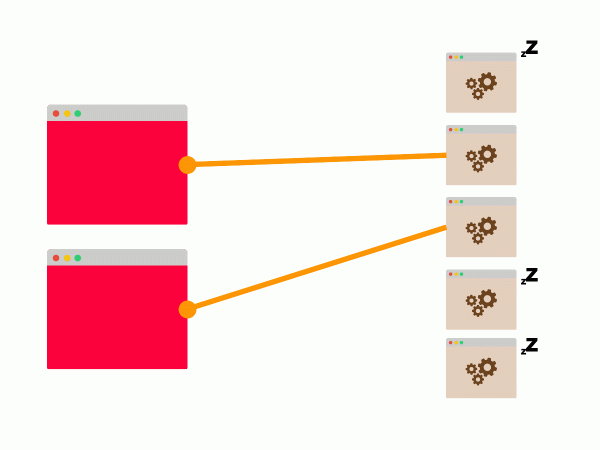
Si estos dos servidores no pueden manejar el procesamiento de las solicitudes de los clientes, el escalado horizontal no solucionará el problema.
Conclusión
Los servicios de Kubernetes están diseñados para funcionar en la mayoría de los escenarios estándar de aplicaciones web.
Sin embargo, una vez que comienzas a trabajar con protocolos de aplicación que utilizan conexiones TCP persistentes, como bases de datos, gRPC o WebSockets, los servicios ya no son adecuados. Kubernetes no proporciona mecanismos internos para balancear conexiones TCP persistentes.
Esto significa que debes escribir aplicaciones teniendo en cuenta la posibilidad de balanceo en el lado del cliente.
La traducción fue preparada por el equipo .
Lecturas adicionales sobre el tema:
- .
- .
- .
Fuente: habr.com
