

A medida que se agotan las direcciones IPv4, muchos operadores de telecomunicaciones se han enfrentado a la necesidad de proporcionar acceso a sus clientes a la red mediante la traducción de direcciones. En este artículo, explicaré cómo se puede alcanzar un rendimiento de nivel Carrier Grade NAT en servidores comerciales.
Un poco de historia
El tema del agotamiento del espacio de direcciones IPv4 ya no es nuevo. En algún momento surgieron listas de espera en RIPE, luego aparecieron intercambios donde se comerciaban bloques de direcciones y se firmaban contratos para su alquiler. Poco a poco, los operadores de telecomunicaciones comenzaron a ofrecer servicios de acceso a Internet mediante la traducción de direcciones y puertos. Algunos no lograron obtener suficientes direcciones para asignar una dirección 'pública' a cada suscriptor, mientras que otros comenzaron a economizar, renunciando a la compra de direcciones en el mercado secundario. Los fabricantes de equipos de red apoyaron esta idea, ya que esta funcionalidad normalmente requiere módulos de expansión o licencias adicionales. Por ejemplo, en Juniper, en la línea de enrutadores MX (excepto los últimos MX104 y MX204), realizar NAPT se puede hacer en una tarjeta de servicio separada MS-MIC, en Cisco ASR1k se requiere la licencia CGN, y en Cisco ASR9k se necesita un módulo separado A9K-ISM-100 y la licencia A9K-CGN-LIC correspondiente. En general, esto no es barato.
IPTables
La tarea de realizar NAT no requiere recursos computacionales especializados, puede ser manejada por procesadores de propósito general, como los que se encuentran en cualquier enrutador doméstico. A nivel de operador de telecomunicaciones, esta tarea se puede resolver utilizando servidores comerciales que funcionen con FreeBSD (ipfw/pf) o GNU/Linux (iptables). No examinaremos FreeBSD ya que hace tiempo abandoné el uso de este sistema operativo, así que nos centraremos en GNU/Linux.
Activar la traducción de direcciones no es complicado. Para comenzar, es necesario escribir una regla en iptables en la tabla nat:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
El sistema operativo cargará el módulo nf_conntrack, que supervisará todas las conexiones activas y realizará las transformaciones necesarias. Aquí hay algunas sutilezas. Primero, dado que se trata de NAT a nivel de operador de telecomunicaciones, es necesario ajustar los timeout, ya que con los valores predeterminados, el tamaño de la tabla de traducción crecerá rápidamente a niveles catastróficos. A continuación, un ejemplo de configuraciones que utilicé en mis servidores:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
Y en segundo lugar, dado que el tamaño de la tabla de traducción por defecto no está diseñado para operar en condiciones de un operador de telecomunicaciones, es necesario aumentar su tamaño:
net.netfilter.nf_conntrack_max = 3145728
También es necesario aumentar la cantidad de buckets para la tabla hash que almacena todas las traducciones (esta es una opción del módulo nf_conntrack):
options nf_conntrack hashsize=1572864
Después de estas sencillas manipulaciones, se obtiene una estructura que puede traducir una gran cantidad de direcciones de clientes en un grupo de direcciones externas. Sin embargo, el rendimiento de esta solución deja mucho que desear. En mis primeros intentos de usar GNU/Linux para NAT (aproximadamente en 2013), pude alcanzar un rendimiento de alrededor de 7Gbit/s a 0.8Mpps en un servidor (Xeon E5-1650v2). Desde entonces, se han realizado muchas optimizaciones en la pila de red del núcleo de GNU/Linux, y el rendimiento de un servidor con el mismo hardware ha crecido prácticamente a 18-19 Gbit/s a 1.8-1.9 Mpps (estos fueron los valores extremos), pero la demanda de volumen de tráfico procesado por un solo servidor ha crecido mucho más rápido. Como resultado, se desarrollaron esquemas de balanceo de carga en diferentes servidores, pero todo esto incrementó la complejidad de la configuración, el mantenimiento y la garantía de calidad de los servicios prestados.
NFTables
Actualmente, la tendencia de moda en el "reenvío de paquetes" es el uso de DPDK y XDP. Se han escrito muchos artículos sobre este tema, se han realizado diversas presentaciones y aparecen productos comerciales (por ejemplo, SKAT de VasExperts). Sin embargo, en el contexto de recursos limitados de programadores en los operadores de telecomunicaciones, crear alguna "creación" basada en estos marcos es bastante problemático. Además, explotar tal solución en el futuro será mucho más complicado, ya que será necesario desarrollar herramientas de diagnóstico. Por ejemplo, el tcpdump estándar no funcionará con DPDK, y los paquetes enviados de vuelta a los cables mediante XDP no serán "vistos". En medio de todas las discusiones sobre nuevas tecnologías de reenvío de paquetes en user-space, han pasado desapercibidos y Pablo Neira Ayuso, mantenedor de iptables, sobre el desarrollo de flow offloading en nftables. Examinemos este mecanismo en detalle.
La idea principal es que si un enrutador ha permitido que los paquetes de una sesión vayan en ambas direcciones (la sesión TCP ha alcanzado el estado ESTABLISHED), no es necesario pasar los paquetes subsecuentes de esta sesión a través de todas las reglas del firewall, ya que todas estas comprobaciones terminarán en la transmisión del paquete hacia el enrutamiento. Además, no es necesario realizar la elección de la ruta, porque ya sabemos a qué interfaz y a qué host se deben enviar los paquetes dentro de esta sesión. Solo queda guardar esta información y utilizarla para la ruta en la fase inicial del procesamiento del paquete. Al realizar NAT, también es necesario guardar información sobre los cambios en las direcciones y puertos, transformados por el módulo nf_conntrack. Sí, por supuesto, en este caso, varios poliseres y otras reglas de información-estadísticas en iptables dejarán de funcionar, pero en el marco de la tarea de un NAT independiente o, por ejemplo, un border, esto no es tan importante, porque los servicios están distribuidos entre los dispositivos.
Configuración
Para utilizar esta función necesitamos:
- Usar un núcleo actualizado. A pesar de que la funcionalidad apareció por primera vez en el núcleo 4.16, durante mucho tiempo fue muy "inmadura" y provocaba regularmente kernel panic. Todo se estabilizó aproximadamente en diciembre de 2019, cuando se lanzaron los núcleos LTS 4.19.90 y 5.4.5.
- Reescribir las reglas de iptables en formato nftables, utilizando una versión suficientemente actual de nftables. Funciona correctamente en la versión 0.9.0
Si con el primer punto todo está más o menos claro, lo principal es no olvidar incluir el módulo en la configuración al compilar (CONFIG_NFT_FLOW_OFFLOAD=m), el segundo punto requiere algunas explicaciones. Las reglas de nftables se describen de manera muy diferente a las de iptables. cubre prácticamente todos los aspectos, también hay convertidores especiales La configuración de NAT es muy sencilla:
Con el flow offload es un poco más complicado, pero bastante claro:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
Aquí está, en esencia, toda la configuración. Ahora todo el tráfico TCP/UDP irá a la tabla fastnat y se procesará mucho más rápido.
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
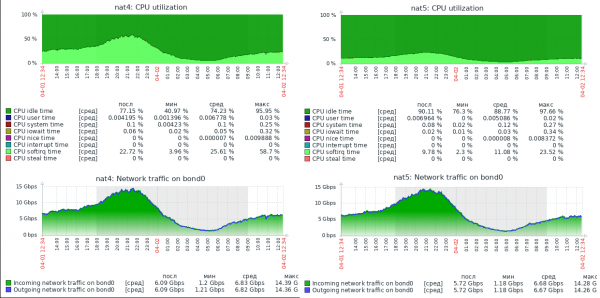
Para que quede claro cuánto es esto de "mucho más rápido", adjuntaré una captura de pantalla de la carga en dos servidores reales, con la misma configuración (Xeon E5-1650v2), configurados de la misma manera y utilizando el mismo núcleo de Linux, pero realizando NAT en iptables (NAT4) y en nftables (NAT5).
Resultados
En la captura de pantalla no hay gráfico de paquetes por segundo, pero en el perfil de carga de estos servidores el tamaño medio del paquete ronda los 800 bytes, por lo que los valores llegan hasta 1.5Mpps. Como se puede ver, el margen de rendimiento del servidor con nftables es enorme. En este momento, este servidor procesa hasta 30Gbit/s a 3Mpps y claramente puede alcanzar el límite físico de la red de 40Gbps, manteniendo recursos de CPU disponibles.
Espero que este material sea útil para los ingenieros de redes que intentan mejorar el rendimiento de sus servidores.
A medida que se agotan las direcciones IPv4, muchos operadores de telecomunicaciones se han enfrentado a la necesidad de organizar el acceso de sus clientes a la red mediante la traducción de direcciones.
Fuente: habr.com
