

En sistemas ERP complejos muchas entidades tienen una naturaleza jerárquica, donde los objetos homogéneos se organizan en un árbol de relaciones "padre - hijo" — esto incluye la estructura organizativa de la empresa (todas esas sucursales, departamentos y grupos de trabajo), el catálogo de productos, las áreas de trabajo y la geografía de los puntos de venta,…
De hecho, no hay ningún , donde no haya algún tipo de jerarquía presente. Pero incluso si no trabajas "en el negocio", aún puedes encontrarte con relaciones jerárquicas fácilmente. Por ejemplo, incluso tu árbol genealógico o el plano de los pisos en un centro comercial son estructuras similares.
Existen muchas maneras de almacenar dicho árbol en bases de datos, pero hoy nos detendremos en una sola opción:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- no olvidemos que la FK no implica la creación automática de un índice, a diferencia de la PK
Y mientras examinas la profundidad de la jerarquía, esta espera pacientemente para ver qué tan [in]efectivas serán tus maneras "ingenuas" de trabajar con dicha estructura.
Analicemos las tareas típicas que surgen, su implementación en SQL y tratemos de mejorar su rendimiento.
#1. Насколько глубока кроличья нора?
Para ser claros, asumiremos que esta estructura reflejará la subordinación de los departamentos en la organización: departamentos, divisiones, sectores, sucursales, grupos de trabajo,… — llámalo como quieras.
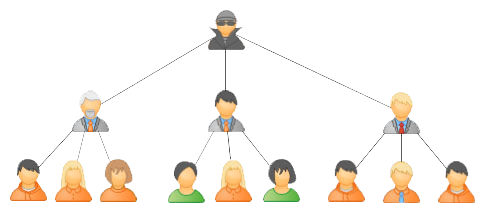
Primero generemos nuestro 'árbol' de 10K elementos
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Comencemos con la tarea más simple: encontrar a todos los empleados que trabajan dentro de un sector específico, o en términos jerárquicos — encontrar todos los descendientes de un nodo. Y también sería útil obtener la "profundidad" del descendiente… Todo esto puede ser necesario, por ejemplo, para construir una .
No estaría mal si estos descendientes tuvieran solo un par de niveles y su cantidad estuviera en unos pocos, pero si hay más de 5 niveles y ya hay decenas de descendientes, podría haber problemas. Veamos cómo se escriben (y funcionan) las variantes tradicionales de búsqueda 'hacia abajo en el árbol'. Pero antes, definamos cuáles de los nodos serán más interesantes para nuestras investigaciones.
Los más «profundos» subárboles:
WITH RECURSIVE T AS (
  SELECT
    id
  , pid
  , ARRAY[id] path
  FROM
    hier
  WHERE
    pid IS NULL
UNION ALL
  SELECT
    hier.id
  , hier.pid
  , T.path || hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T ORDER BY array_length(path, 1) DESC;
id | pid | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
...Los más «anchos» subárboles:
...
SELECT
  path[1] id
, count(*)
FROM
  T
GROUP BY
  1
ORDER BY
  2 DESC;
id | count
------------
5300 | 30
450 | 28
1239 | 27
1573 | 25
Para estas consultas, utilizamos un típico JOIN recursivo:
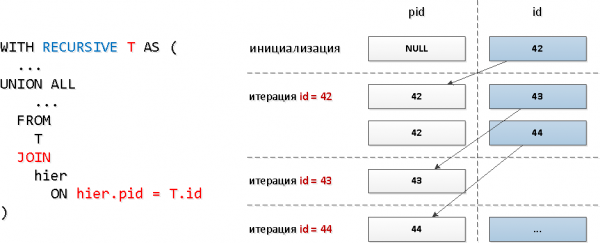
Es obvio que, con este modelo de consulta, el número de iteraciones coincidirá con el número total de descendientes (y son varios десятки), y esto puede consumir recursos significativos y, como consecuencia, tiempo.
Verifiquemos en el subárbol más 'ancho':
WITH RECURSIVE T AS (
  SELECT
    id
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T; 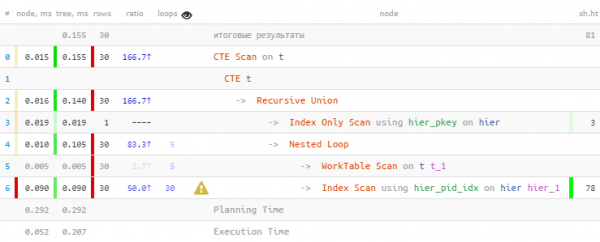
Como imaginábamos, encontramos las 30 entradas. Pero gastamos el 60% de todo el tiempo en esto, porque también hicimos 30 búsquedas en el índice. ¿Podríamos hacerlo en menos tiempo?
Lectura masiva por índice
¿Es necesario hacer una consulta separada al índice para cada nodo? Resulta que no; podemos leer del índice de una vez por varias claves en una sola llamada usando = ANY(array).
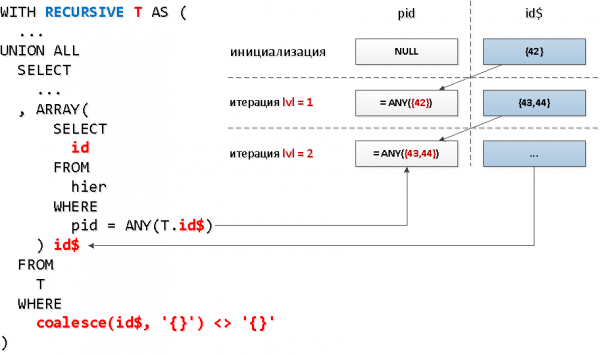
Y en cada uno de esos grupos de identificadores, podemos tomar todos los ID encontrados en el paso anterior por 'nodos'. Esto significa que en cada paso siguiente vamos a buscar de inmediato todos los descendientes de un nivel determinado..
Sin embargo, hay un problema, en la selección recursiva no se puede hacer referencia a sí misma en una subconsulta,y necesitamos filtrar solo lo encontrado en el nivel anterior... Resulta que no se puede hacer una subconsulta a toda la selección, pero sí a un campo específico de esta. Y ese campo puede ser un arreglo, que es lo que necesitamos utilizar. TODOS.
Suena algo extraño, pero en el esquema, todo es simple.
CON RECURSIVE T AS (
  SELECT
    ARRAY[id] id$
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    ARRAY(
      SELECT
        id
      FROM
        hier
      WHERE
        pid = ANY(T.id$)
    ) id$
  FROM
    T
  WHERE
    coalesce(id$, '{}')  '{}' -- condición de salida del ciclo - matriz vacía
)
SELECT
  unnest(id$) id
FROM
T; 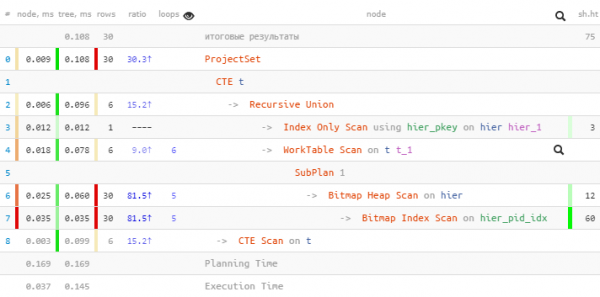
Y lo más importante aquí no es la ganancia de 1.5 veces en tiempo, sino que hemos leído menos buffers, ya que tenemos solo 5 accesos al índice en lugar de 30!
Un bono adicional es que después del unnest final, los identificadores permanecerán ordenados por "niveles".
Indicación de nodo
Otra consideración que ayudará a mejorar el rendimiento es que los "hojas" no pueden tener hijos, lo que significa que no necesitamos buscar "abajo" para ellos en absoluto. En el contexto de nuestra tarea, esto significa que si hemos seguido la cadena de departamentos y hemos llegado al empleado, ya no hay necesidad de buscar más en esta rama.
Introduzcamos en nuestra tabla un nuevo boolean-campo, que nos dirá de inmediato si este registro específico en nuestro árbol es un "nodo" — es decir, si puede tener descendientes.
ALTER TABLE hier
  ADD COLUMN branch boolean;

UPDATE
  hier T
SET
  branch = TRUE
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      hier
    WHERE
      pid = T.id
    LIMIT 1
);
-- Consulta ejecutada con éxito: 3033 filas modificadas en 42 ms.
¡Excelente! Resulta que solo poco más del 30% de todos los elementos del árbol tienen descendientes.
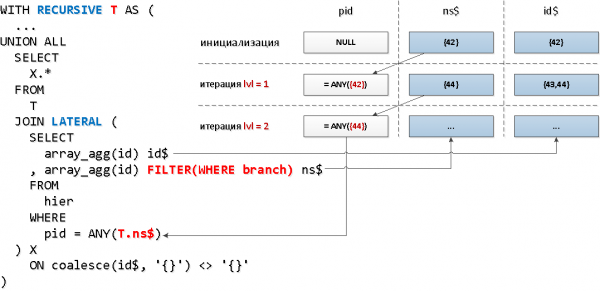
Ahora aplicaremos una mecánica ligeramente diferente — uniones con la parte recursiva a través de LATERAL, lo que nos permitirá acceder de inmediato a los campos de la "tabla" recursiva, y utilizaremos la función agregada con la condición de filtrado por el indicador de nodo para reducir el conjunto de claves:
CON RECURSIVE T AS (
  SELECT
    array_agg(id) id$
  , array_agg(id) FILTER(WHERE branch) ns$
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    X.*
  FROM
    T
  JOIN LATERAL (
    SELECT
      array_agg(id) id$
    , array_agg(id) FILTER(WHERE branch) ns$
    FROM
      hier
    WHERE
      pid = ANY(T.ns$)
  ) X
    ON coalesce(T.ns$, '{}')  '{}'
)
SELECT
  unnest(id$) id
FROM
T; 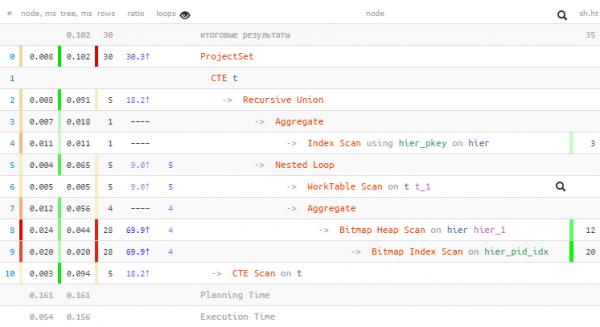
Hemos podido reducir otro acceso al índice y hemos ganado más de 2 veces en volumen leído.
#2. Вернемся к корням
Este algoritmo será útil si necesita recopilar registros para todos los elementos "hacia arriba en el árbol", manteniendo al mismo tiempo información sobre qué hoja original (y con qué indicadores) causó su inclusión en la selección — por ejemplo, para la elaboración de un informe resumen con agregación en nodos.
Lo que sigue debe considerarse exclusivamente como una prueba de concepto, ya que la consulta resulta bastante pesada. Pero si domina su base de datos, vale la pena considerar la aplicación de metodologías similares.
Comencemos con un par de afirmaciones simples:
- El mismo registro de la base de datos es mejor leerlo una sola vez.
- Los registros de la base de datos se leen de manera más eficiente en "lotes", que de forma individual.
Ahora intentemos construir la consulta que necesitamos.
Compra una suscripción
Es evidente que en la inicialización de la recursión (¡¿cómo no?!), tendremos que leer los registros de las hojas según el conjunto de identificadores iniciales:
WITH RECURSIVE tree AS (
  SELECT
    rec -- este es el registro completo de la tabla
  , id::text chld -- este es el "conjunto" de hojas iniciales que lo llevaron aquí
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Si a alguien le pareció extraño que el "conjunto" se almacene como una cadena y no como un arreglo, hay una razón sencilla. Para las cadenas, hay una función de agregación incorporada que "concatena" string_agg, pero no hay ninguna para arreglos. Aunque es .
Paso 2
Ahora necesitamos obtener el conjunto de ID de las secciones que deberemos leer después. Casi siempre estarán duplicados en diferentes registros del conjunto inicial, por lo que necesitamos agrupárselos, manteniendo al mismo tiempo la información sobre las hojas de origen.
Pero aquí nos esperan tres problemas:
- La parte "subrecursiva" de la consulta no puede contener funciones agregadas con
GROUP BY. - La referencia a la "tabla" recursiva no puede estar en una subconsulta anidada.
- La consulta en la parte recursiva no puede contener CTE.
Afortunadamente, todos estos problemas son bastante fáciles de sortear. Comencemos desde el final.
CTE en la parte recursiva
Así es como no funciona:
WITH RECURSIVE tree AS (
  ...
UNION ALL
  WITH T (...)
  SELECT ...
)
Y así — funciona, ¡los paréntesis lo solucionan!
WITH RECURSIVE tree AS (
  ...
UNION ALL
  (
    WITH T (...)
    SELECT ...
  )
)
Consulta anidada a la "tabla" recursiva
Hmm… La referencia a la CTE recursiva no puede estar en una consulta anidada. Pero puede estar dentro de la CTE. ¡Y la consulta anidada puede hacer referencia a esta CTE!
GROUP BY dentro de la recursión
Desagradable, pero… ¡Tenemos un método sencillo para simular GROUP BY usando DISTINCT ON y funciones de ventana!
SELECT
  (rec).pid id
, string_agg(chld::text, ',') chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
GROUP BY 1 -- ¡no funciona!
¡Pero así sí funciona!
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
Ahora vemos por qué el ID numérico se convirtió en texto: ¡para que se puedan unir con una coma!
Paso 3
Para el final solo nos queda un poco:
- revisamos los registros de «secciones» por conjunto de IDs agrupados
- asociamos las secciones leídas con los «conjuntos» de hojas originales
- «desplegamos» la cadena-conjunto utilizando
unnest(string_to_array(chld, ',')::integer[])
WITH RECURSIVE tree AS (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    WITH prnt AS (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes AS (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 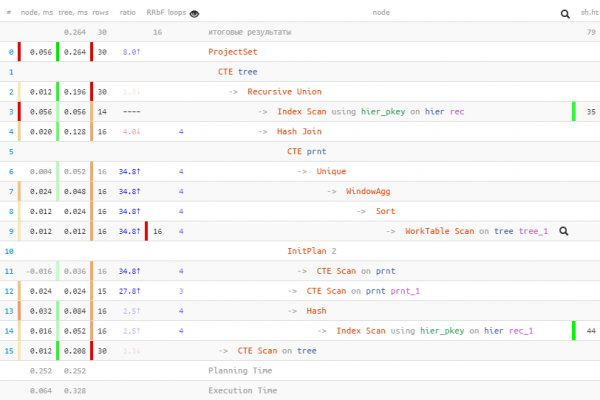
Fuente: habr.com
