

La traducción del artículo ha sido preparada especialmente para los estudiantes del curso .
— desarrollador de software, aficionado a Go y amante de resolver problemas complejos. También es mantenedor de Prometheus y cofundador de Kubernetes SIG instrumentation. Anteriormente fue ingeniero de producción en SoundCloud y lideró el equipo de monitoreo en CoreOS. Actualmente trabaja en Google.
— ingeniero de infraestructura en Improbable. Está interesado en nuevas tecnologías y en los problemas de sistemas distribuidos. Tiene experiencia en programación de bajo nivel en Intel, experiencia como contribuyente en Mesos y experiencia en SRE a nivel mundial en Improbable. Se dedica a mejorar el mundo de los microservicios. Sus tres pasiones: Golang, código abierto y voleibol.
Al observar nuestro producto insignia SpatialOS, puedes deducir que Improbable necesita una infraestructura de nube de alta dinámica a escala global con docenas de clústeres de Kubernetes. Fuimos uno de los primeros en comenzar a usar el sistema de monitoreo . Prometheus es capaz de rastrear millones de métricas en tiempo real y viene con un poderoso lenguaje de consultas que permite extraer la información necesaria.
La simplicidad y confiabilidad de Prometheus es una de sus principales ventajas. Sin embargo, al alcanzar cierta escala, nos encontramos con varias desventajas. Para abordar estos problemas, desarrollamos — un proyecto de código abierto creado por Improbable, para la transformación fluida de los clústeres existentes de Prometheus en un único sistema de monitoreo con almacenamiento ilimitado de datos históricos. Thanos está disponible en Github .
Nuestros objetivos con Thanos
A cierta escala, surgen problemas que superan las capacidades de un Prometheus vanilla. ¿Cómo almacenar de manera confiable y económica petabytes de datos históricos? ¿Es posible hacerlo sin comprometer los tiempos de respuesta de las consultas? ¿Se puede acceder a todas las métricas ubicadas en diferentes servidores de Prometheus mediante una sola solicitud API? ¿Es posible combinar de alguna manera los datos replicados recopilados con Prometheus HA?
Para abordar estas preguntas, creamos Thanos. En las siguientes secciones describimos cómo abordamos estas cuestiones y explicamos los objetivos que perseguimos.
Solicitar datos de múltiples instancias de Prometheus (consulta global)
Prometheus ofrece un enfoque funcional para el sharding. Incluso un solo servidor de Prometheus proporciona suficiente escalabilidad para liberar a los usuarios de las complejidades del sharding horizontal en prácticamente todos los casos de uso.
Aunque este es un excelente modelo de implementación, a menudo se requiere acceder a los datos de diferentes servidores de Prometheus a través de una única API o interfaz de usuario — vista global. Por supuesto, es posible mostrar múltiples consultas en un único panel de Grafana, pero cada consulta solo puede ejecutarse en un servidor de Prometheus. Por otro lado, con Thanos puedes consultar y agregar datos de varios servidores de Prometheus, ya que todos son accesibles desde un único punto final.
Anteriormente, para obtener una vista global en Improbable, organizamos nuestras instancias de Prometheus en una jerarquía de . Esto significaba crear un servidor meta de Prometheus que recopila parte de las métricas de cada servidor 'hoja'.
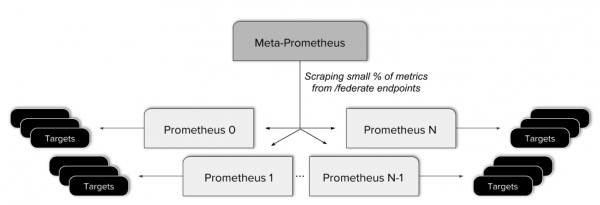
Este enfoque resultó problemático. Condujo a una configuración más complicada, a la adición de un posible punto de falla adicional y a la aplicación de reglas complejas para proporcionar al punto final federado solo los datos necesarios. Además, la federación de este tipo no permite obtener una verdadera vista global, ya que no todos los datos están disponibles desde una única solicitud API.
Esto está estrechamente relacionado con una única representación de los datos recopilados en servidores Prometheus de alta disponibilidad (high-availability, HA). El modelo HA de Prometheus recopila datos de manera independiente dos veces, lo cual es tan sencillo que no podría ser más fácil. Sin embargo, utilizar una representación combinada y desduplicada de ambos flujos sería mucho más conveniente.
Por supuesto, existe la necesidad de servidores Prometheus de alta disponibilidad. En Improbable, tomamos muy en serio la monitorización de datos cada minuto, pero tener una única instancia de Prometheus en el clúster representa un único punto de falla. Cualquier error de configuración o fallo de hardware puede potencialmente llevar a la pérdida de datos importantes. Incluso una implementación simple puede causar pequeños fallos en la recolección de métricas, ya que el reinicio puede tardar significativamente más que el intervalo de scraping.
Almacenamiento confiable de datos históricos
Un almacenamiento económico, rápido y a largo plazo para métricas es nuestro sueño (compartido por la mayoría de los usuarios de Prometheus). En Improbable, nos vimos obligados a configurar el tiempo de retención de métricas en nueve días (para Prometheus 1.8). Esto impone limitaciones evidentes sobre cuán lejos podemos mirar hacia atrás.
Prometheus 2.0 ha mejorado en este aspecto, ya que la cantidad de series temporales ya no afecta al rendimiento general del servidor (ver ). Sin embargo, Prometheus almacena datos en disco local. Aunque una compresión de datos de alta eficiencia puede reducir significativamente el uso del SSD local, todavía existe un límite en la cantidad de datos históricos que se pueden almacenar.
Además, en Improbable nos preocupamos por la confiabilidad, la simplicidad y el costo. Los discos locales grandes son más difíciles de operar y respaldar. Cuestan más y requieren más herramientas de respaldo, lo que lleva a una complejidad innecesaria.
Submuestreo
Una vez que comenzamos a trabajar con datos históricos, nos dimos cuenta de que hay complicaciones fundamentales con O-grande, que hacen que las consultas sean cada vez más lentas si estamos trabajando con datos de semanas, meses y años.
La solución estándar a este problema es (downsampling) — reducir la frecuencia de muestreo de la señal. Con la reducción de la frecuencia de muestreo, podemos 'escalar hacia abajo' a un rango de tiempo mayor y mantener la misma cantidad de muestras, lo que permitirá mantener la capacidad de respuesta de las consultas.
El submuestreo de datos antiguos es un requisito inevitable para cualquier solución de almacenamiento a largo plazo y va más allá del Prometheus estándar.
Objetivos adicionales
Uno de los objetivos iniciales del proyecto Thanos era la integración sin problemas con cualquier instalación existente de Prometheus. El segundo objetivo era la fácil operación con una barrera de entrada mínima. Cualquier dependencia debe ser fácil de satisfacer tanto para usuarios pequeños como grandes, lo que también implica un costo base insignificante.
Arquitectura de Thanos
Después de que enumeramos nuestros objetivos en la sección anterior, trabajemos en ellos y veamos cómo Thanos aborda estos problemas.
Vista global
Para obtener una vista global sobre las instancias existentes de Prometheus, necesitamos vincular un único punto de entrada de solicitudes con todos los servidores. Esto es precisamente lo que hace el componente Thanos. . Se implementa junto a cada servidor de Prometheus y funciona como un proxy, sirviendo datos locales de Prometheus a través de la interfaz gRPC del Store API, lo que permite seleccionar datos de series temporales por etiquetas y rango de tiempo.
Por otro lado, está el componente Querier, escalable horizontalmente y sin estado, que hace un poco más que simplemente responder a las solicitudes PromQL a través del estándar API HTTP de Prometheus. Los componentes Querier, Sidecar y otros de Thanos interactúan a través del .
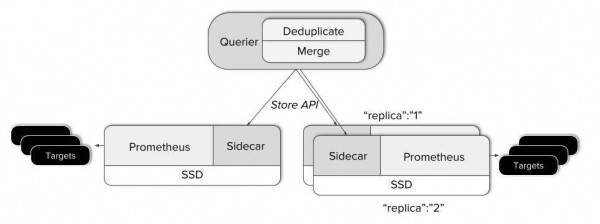
- El Querier, al recibir una solicitud, se conecta al servidor correspondiente del Store API, es decir, a nuestros Sidecars, y obtiene los datos de series temporales de los servidores de Prometheus correspondientes.
- Después de esto, combina las respuestas y ejecuta la consulta PromQL sobre ellas. El Querier puede combinar tanto datos no superpuestos como datos duplicados de servidores HA de Prometheus.
Esto resuelve gran parte de nuestro rompecabezas: combinar datos de servidores de Prometheus aislados en una única vista. De hecho, Thanos se puede utilizar solo por esta capacidad. ¡No se requieren cambios en los servidores Prometheus existentes!
¡Almacenamiento ilimitado!
Sin embargo, tarde o temprano querramos conservar datos que excedan el tiempo de almacenamiento normal de Prometheus. Para almacenar datos históricos hemos elegido un almacenamiento de objetos. Está ampliamente disponible en cualquier nube, así como en centros de datos locales y es muy económico. Además, prácticamente cualquier almacenamiento de objetos es accesible a través de la API S3 bien conocida.
Prometheus escribe datos de la memoria a disco aproximadamente cada dos horas. Un bloque de datos guardados contiene todos los datos para un intervalo de tiempo fijo y es inmutable. Esto es muy conveniente, ya que Thanos Sidecar puede simplemente observar el catálogo de datos de Prometheus y, a medida que se generan nuevos bloques, cargarlos en los buckets del almacenamiento de objetos.
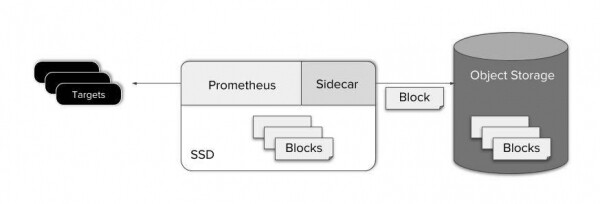
La carga en el almacenamiento de objetos inmediatamente después de escribir en disco también permite mantener la simplicidad del “scraper” (Prometheus y Thanos Sidecar). Esto simplifica el mantenimiento, el costo y el diseño del sistema.
Como pueden ver, la copia de seguridad de datos se realiza de manera muy sencilla. Pero, ¿qué pasa con las consultas de datos en el almacenamiento de objetos?
El componente Thanos Store actúa como un proxy para acceder a los datos del almacenamiento de objetos. Al igual que Thanos Sidecar, participa en el clúster de gossip y implementa la API Store. De este modo, los Querier existentes pueden tratarlo como un Sidecar, como otra fuente de datos de series temporales, sin necesidad de configuración especial.
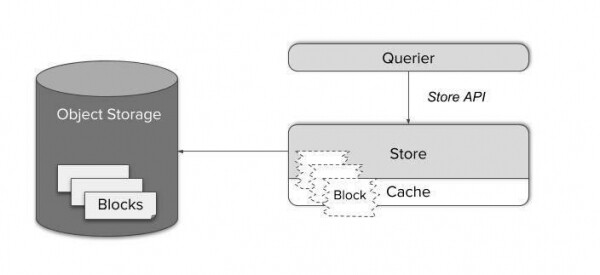
Los bloques de datos de series temporales consisten en varios archivos grandes. Cargarlos a demanda sería bastante ineficiente, y el almacenamiento en caché local requeriría una enorme memoria y espacio en disco.
En su lugar, el Store Gateway sabe cómo manejar el formato de almacenamiento de Prometheus. Gracias a un planificador de consultas inteligente y al almacenamiento en caché de solo las partes indexadas necesarias de los bloques, se ha vuelto posible reducir consultas complejas a un número mínimo de solicitudes HTTP a los archivos del almacenamiento de objetos. De esta forma, se puede reducir el número de solicitudes en cuatro a seis órdenes de magnitud y alcanzar tiempos de respuesta que son, en general, difíciles de distinguir de las consultas de datos en un SSD local.
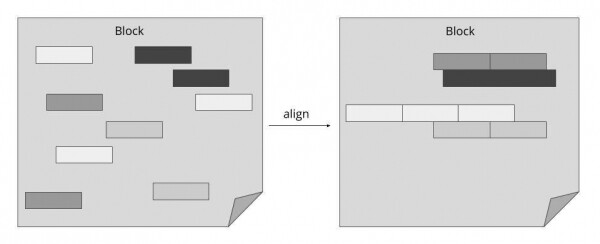
Como se muestra en el diagrama anterior, Thanos Querier reduce significativamente el costo de una solicitud de datos en el almacenamiento de objetos al utilizar el formato de almacenamiento de Prometheus y alinear los datos relacionados. Usando este enfoque, podemos combinar muchas solicitudes individuales en un número mínimo de operaciones en bloque.
Compactación y downsampling
Una vez que un nuevo bloque de datos de series temporales se ha cargado con éxito en el almacenamiento de objetos, lo consideramos como datos "históricos", que están disponibles de inmediato a través del Store Gateway.
Sin embargo, después de un tiempo, los bloques de una misma fuente (Prometheus con Sidecar) se acumulan y ya no utilizan todo el potencial de indexación. Para abordar este problema, introdujimos otro componente llamado Compactor. Simplemente aplica el mecanismo de compactación local de Prometheus a los datos históricos en el almacenamiento de objetos y puede ejecutarse como una simple tarea por lotes periódica.
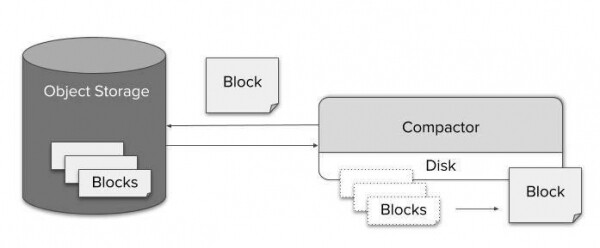
Gracias a la compresión eficiente, realizar una consulta al almacenamiento durante un período prolongado no presenta problemas en términos de tamaño de los datos. Sin embargo, el costo potencial de descomprimir mil millones de valores y procesarlos a través del controlador de consultas inevitablemente llevará a un aumento drástico en el tiempo de ejecución de la consulta. Por otro lado, dado que cada píxel de la pantalla corresponde a cientos de puntos de datos, se vuelve imposible incluso visualizar los datos en resolución completa. Por lo tanto, el downsamping no solo es posible, sino que tampoco dará lugar a una pérdida de precisión notable.
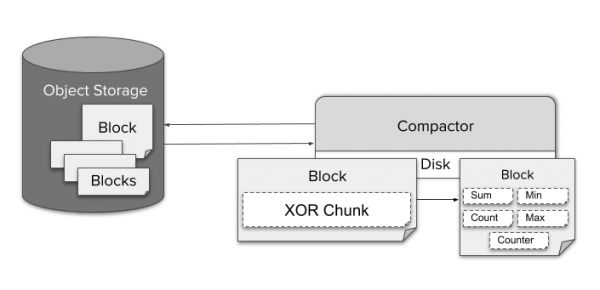
Para el downsamping de datos, Compactor agrega continuamente los datos con una resolución de cinco minutos y una hora. Para cada fragmento sin procesar, codificado con la compresión TSDB XOR, se almacenan diversos tipos de datos agregados, como min, max o sum para un bloque. Esto permite que Querier seleccione automáticamente el agregado que sea adecuado para la consulta PromQL dada.
Para utilizar datos con menor precisión, el usuario no necesita ninguna configuración especial. Querier cambia automáticamente entre diferentes resoluciones y datos sin procesar a medida que el usuario acerca o aleja. Si lo desea, el usuario puede controlar esto directamente a través del parámetro "step" en la consulta.
Dado que el costo de almacenamiento de un GB es bajo, por defecto Thanos conserva los datos originales, los datos con resolución de cinco minutos y de una hora. No es necesario eliminar los datos originales.
Reglas de grabación
Incluso con Thanos, las reglas de grabación son una parte esencial de la pila de monitoreo. Reducen la complejidad, la latencia y el costo de las consultas. También son convenientes para los usuarios para obtener datos agregados por métricas. Thanos se basa en instancias de Prometheus de vanilla, por lo que es completamente aceptable almacenar las reglas de grabación y las reglas de alerta en el servidor Prometheus existente. Sin embargo, en algunos casos, esto puede no ser suficiente:
- Alertas globales y reglas (por ejemplo, notificaciones cuando un servicio no funciona en más de dos de tres clústeres).
- Regla para datos fuera del almacenamiento local.
- El deseo de almacenar todas las reglas y alertas en un solo lugar.
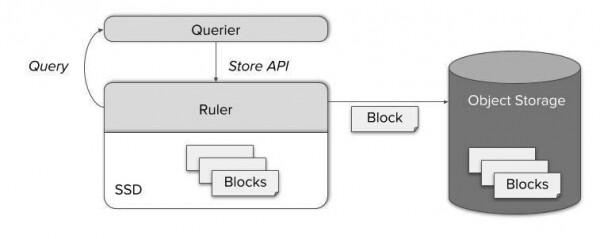
Para todos estos casos, Thanos incluye un componente separado llamado Ruler, que calcula reglas y alertas a través de Thanos Queries. Proporcionando una StoreAPI bien conocida, el nodo Query puede acceder a métricas frescas calculadas. Más tarde, también se almacenan en un almacenamiento de objetos y se hacen accesibles a través de Store Gateway.
El poder de Thanos
Thanos es lo suficientemente flexible como para adaptarse a tus requisitos. Esto es especialmente útil al migrar desde un Prometheus simple. Recordemos rápidamente, con un pequeño ejemplo, lo que hemos aprendido sobre los componentes de Thanos. Aquí se explica cómo trasladar tu Prometheus 'vanilla' al mundo del 'almacenamiento ilimitado de métricas':
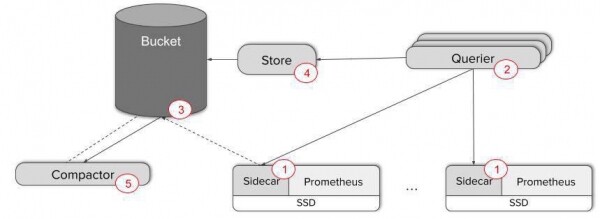
- Agrega Thanos Sidecar a tus servidores Prometheus, por ejemplo, un contenedor vecino en un pod de Kubernetes.
- Despliega varias réplicas de Thanos Querier para poder visualizar los datos. En este punto, es fácil configurar gossip entre Scraper y Querier. Para verificar la interacción del componente, usa la métrica 'thanos_cluster_members'.
¡Solo estos dos pasos son suficientes para proporcionar una vista global y una deduplicación de datos sin costuras de las posibles réplicas HA de Prometheus! Simplemente conecta tus dashboards al punto final HTTP de Querier o utiliza la interfaz de Thanos UI directamente.
Sin embargo, si necesitas respaldo de métricas y almacenamiento a largo plazo, tendrás que realizar tres pasos adicionales:
- Crea un bucket en AWS S3 o GCS. Configura Sidecar para copiar datos a estos buckets. Ahora puedes minimizar el almacenamiento de datos local.
- Despliega Store Gateway y conéctalo al clúster gossip existente. ¡Ahora puedes enviar consultas a los datos en los respaldos!
- Despliega Compactor para mejorar la eficiencia de las consultas durante periodos prolongados, utilizando compactación y downsampling.
Si deseas saber más, no dudes en consultar nuestras y !
En solo cinco pasos hemos transformado Prometheus en un sistema de monitoreo confiable con vista global, almacenamiento ilimitado y potencial alta disponibilidad de métricas.
¡Se necesita tu colaboración en el pull request!
desde el principio fue un proyecto de código abierto. La integración sin fisuras con Prometheus y la posibilidad de usar solo una parte de Thanos lo convierten en una excelente opción para escalar el sistema de monitoreo sin complicaciones.
Siempre estamos abiertos a Pull Requests y Issues en GitHub. Al mismo tiempo, no dudes en contactarnos a través de Issues de GitHub o slack., si tienes preguntas o comentarios, o quieres compartir tu experiencia de uso. Si te gusta lo que hacemos en Improbable, no dudes en contactarnos — !
Fuente: habr.com
