

Del editor del blog de Google: ¿Alguna vez te has preguntado cómo los ingenieros de Google Cloud Technical Solutions (TSE) manejan tus consultas de soporte técnico? La responsabilidad de los ingenieros de soporte técnico de TSE es identificar y resolver las fuentes de problemas indicadas por los usuarios. Algunos de estos problemas son bastante simples, pero a veces aparece una consulta que requiere la atención de varios ingenieros. En este artículo, uno de los empleados de TSE nos hablará sobre un problema muy complicado de su experiencia reciente — Durante este relato, veremos cómo los ingenieros lograron resolver la situación y qué aprendieron en el proceso de solución de errores. Esperamos que esta historia no solo te hable sobre un error profundamente arraigado, sino que también te brinde una comprensión de los procesos involucrados en la presentación de una consulta al soporte de Google Cloud.
La resolución de problemas es al mismo tiempo una ciencia y un arte. Todo comienza con la formulación de una hipótesis sobre la causa del comportamiento anómalo del sistema, que luego se pone a prueba. Sin embargo, antes de formular una hipótesis, debemos definir y expresar claramente el problema. Si la pregunta suena demasiado vaga, tendrás que analizarla a fondo; esa es la parte del "arte" de la resolución de problemas.
En el contexto de Google Cloud, tales procesos se complican enormemente, ya que Google Cloud se esfuerza por garantizar la privacidad de sus usuarios. Debido a esto, los ingenieros de TSE no tienen acceso para editar tus sistemas, ni la capacidad de revisar configuraciones de manera tan amplia como lo hacen los usuarios. Por lo tanto, para verificar cualquiera de nuestras hipótesis, nosotros (los ingenieros) no podemos modificar rápidamente el sistema.
Algunos usuarios creen que nosotros solucionaremos todo como mecánicos en un taller, y simplemente nos envían el ID de la máquina virtual, cuando en realidad el proceso transcurre en forma de conversación: recopilación de información, formulación y confirmación (o refutación) de hipótesis, y, al final, la solución al problema se construye a partir de la comunicación con el cliente.
Problema en cuestión
Hoy nos encontramos ante una historia con un final feliz. Una de las razones del exitoso desenlace del caso propuesto es la descripción muy detallada y precisa del problema. A continuación, se puede ver una copia del primer ticket (editado para ocultar información confidencial):
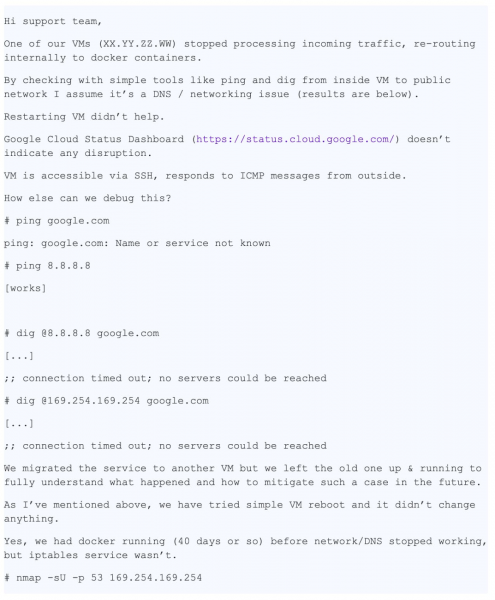
En este mensaje hay mucha información útil para nosotros:
- Se especifica la VM concreta
- Se indica el problema mismo: no funciona el DNS
- Se señala dónde se manifiesta el problema: VM y contenedor
- Se indican los pasos que ha tomado el usuario para identificar el problema
La solicitud fue registrada como "P1: Impacto Crítico - Servicio Inutilizable en producción", lo que significa un monitoreo constante de la situación 24/7 bajo el esquema "Follow the Sun" (puedes leer más sobre ), con su traspaso de un equipo de soporte técnico a otro en cada cambio de zona horaria. De hecho, para cuando el problema llegó a nuestro equipo en Zúrich, había dado la vuelta al mundo. Para ese momento, el usuario había tomado medidas para mitigar las consecuencias, pero temía una repetición de la situación en producción, ya que la causa principal aún no se había descubierto.
Cuando el ticket llegó a Zúrich, ya teníamos la siguiente información:
- Contenido
/etc/hosts - Contenido
/etc/resolv.conf - Salida
iptables-save - Reunido por el equipo
ngreparchivo pcap
Con estos datos estábamos listos para pasar a la fase de "investigación" y resolución de problemas.
Nuestros primeros pasos
Primero, revisamos los registros y el estado del servidor de metadatos y nos aseguramos de que funcionara correctamente. El servidor de metadatos responde a la dirección IP 169.254.169.254 y, entre otras cosas, es responsable del control sobre los nombres de dominio. También verificamos que el firewall trabaja correctamente con la VM y no bloquea paquetes.
Era un problema extraño: la comprobación de nmap refutó nuestra hipótesis principal sobre la pérdida de paquetes UDP, por lo que mentalmente formulamos algunas opciones más y formas de verificación:
- ¿Se pierden los paquetes de forma selectiva? => Verificar las reglas de iptables
- ¿Es demasiado pequeño ? => Проверить вывод
ip a show - ¿El problema afecta solo a los paquetes UDP o también a los TCP? => Ejecutar
dig +tcp - ¿Regresan los paquetes generados por dig? => Ejecutar
tcpdump - ¿Funciona correctamente libdns? => Ejecutar
stracepara verificar la transmisión de paquetes en ambas direcciones
Aquí decidimos llamar al usuario para solucionar problemas en vivo.
Durante la llamada, logramos verificar varias cosas:
- Después de varias verificaciones, descartamos las reglas de iptables de la lista de posibles causas
- Comprobamos las interfaces de red y las tablas de enrutamiento, y verificamos la corrección del MTU
- Descubrimos que
dig +tcp google.com(TCP) funciona como debería, perodig google.com(UDP) no funciona - Al correr
tcpdumpsigue funcionandodig, descubrimos que los paquetes UDP son devueltos - Ejecutamos
strace dig google.comy vemos cómo dig llama correctamente asendmsg()yrecvms(), sin embargo, el segundo se interrumpe por un tiempo de espera
Desafortunadamente, el turno termina y debemos transferir el problema a la siguiente zona horaria. Sin embargo, la consulta ha suscitado interés en nuestro equipo, y un colega propone crear un paquete DNS usando el módulo de Python scrapy.
from scapy.all import *

answer = sr1(IP(dst="169.254.169.254")/UDP(dport=53)/DNS(rd=1,qd=DNSQR(qname="google.com")),verbose=0)
print ("169.254.169.254", answer[DNS].summary())
Este fragmento crea un paquete DNS y envía la consulta al servidor de metadatos.
El usuario ejecuta el código, se devuelve la respuesta DNS y la aplicación la recibe, confirmando la ausencia de problemas a nivel de red.
Después de otro "viaje alrededor del mundo", la consulta regresa a nuestro equipo, y yo asumo completamente su manejo, considerando que será más conveniente para el usuario si la consulta deja de ir de un lado a otro.
Mientras tanto, el usuario amablemente accede a proporcionar una imagen del sistema. Esto son excelentes noticias: la posibilidad de probar el sistema yo mismo acelera significativamente la solución de problemas, ya que ya no tengo que pedir al usuario que ejecute comandos, me envíe los resultados y los analice, ¡puedo hacerlo todo yo mismo!
Mis colegas comienzan a envidiarme un poco. Durante el almuerzo discutimos la consulta, sin embargo, ninguno tiene ideas sobre lo que está sucediendo. Afortunadamente, el mismo usuario ya ha tomado medidas para mitigar el impacto y no tiene prisa, por lo que tenemos tiempo para diseccionar el problema. Y dado que tenemos una imagen, podemos realizar cualquier prueba que nos interese. ¡Genial!
Regresando un paso atrás
Una de las preguntas más populares en las entrevistas para el puesto de ingeniero de sistemas es: "¿Qué sucede cuando haces ping a ?» Вопрос шикарный, так как кандидату необходимо описать пусть от оболочки до пользовательского пространства, до ядра системы и далее к сети. Я улыбаюсь: иногда вопросы с интервью оказываются полезны и в реальной жизни…
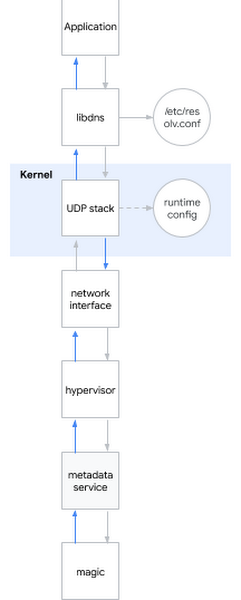
Decido aplicar esta pregunta de recursos humanos al problema actual. En términos simples, cuando intentas resolver un nombre DNS, sucede lo siguiente:
- La aplicación llama a una biblioteca del sistema, como libdns
- libdns verifica la configuración del sistema sobre a qué servidor DNS debe dirigirse (en el diagrama es 169.254.169.254, el servidor de metadatos)
- libdns utiliza llamadas al sistema para crear un socket UDP (SOKET_DGRAM) y enviar paquetes UDP con solicitudes DNS en ambas direcciones
- A través de la interfaz sysctl se puede configurar la pila UDP a nivel de núcleo
- El núcleo interactúa con el hardware para transferir paquetes a través de la red a través de la interfaz de red
- El hipervisor captura y transmite el paquete al servidor de metadatos al contactarlo
- El servidor de metadatos determina el nombre DNS con su magia y devuelve la respuesta de la misma manera
Recuerdo las hipótesis que ya hemos considerado:
Hipótesis: Las bibliotecas están rotas
- Test 1: ejecutar strace en el sistema, verificar que dig realice las llamadas al sistema correctas
- Resultado: se realizan las llamadas al sistema correctas
- Test 2: verificar mediante srapy si podemos resolver nombres eludiendo las bibliotecas del sistema
- Resultado: podemos
- Test 3: ejecutar rpm –V en el paquete libdns y md5sum en los archivos de la biblioteca
- Resultado: el código de la biblioteca es completamente idéntico al código en el sistema operativo en funcionamiento
- Test 4: montar una imagen del sistema raíz del usuario en una VM sin el comportamiento similar, ejecutar chroot, ver si funciona DNS
- Resultado: DNS funciona correctamente
Conclusión basada en las pruebas: el problema no está en las bibliotecas
Hipótesis: Hay un error en la configuración de DNS
- Test 1: verificar tcpdump y observar si se envían y reciben correctamente los paquetes DNS después de ejecutar dig
- Resultado: los paquetes se transmiten correctamente
- Test 2: volver a verificar en el servidor
/etc/nsswitch.confy/etc/resolv.conf - Resultado: todo correcto
Conclusión basada en las pruebas: el problema no está en la configuración de DNS
Hipótesis: el núcleo está dañado
- Test: instalar un nuevo núcleo, verificar la firma, reiniciar
- Resultado: comportamiento similar
Conclusión basada en las pruebas: el núcleo no está dañado
Hipótesis: comportamiento incorrecto de la red del usuario (o de la interfaz de red del hipervisor)
- Test 1: verificar la configuración del firewall
- Resultado: el firewall permite los paquetes DNS tanto en el host como en GCP
- Test 2: interceptar el tráfico y rastrear la corrección de la transmisión y recepción de solicitudes DNS
- Resultado: tcpdump confirma la recepción de paquetes de vuelta por el host
Conclusión basada en las pruebas: el problema no está en la red
Hipótesis: el servidor de metadatos no funciona
- Test 1: verificar los logs del servidor de metadatos en busca de anomalías
- Resultado: no hay anomalías en los logs
- Prueba 2: eludir el servidor de metadatos a través de
dig @8.8.8.8 - Resultado: la resolución falla incluso sin usar el servidor de metadatos
Conclusión basada en las pruebas: el problema no está en el servidor de metadatos
Conclusión: probamos todos los subsistemas excepto las configuraciones del entorno de ejecución!
Sumergiéndome en las configuraciones del entorno de ejecución del núcleo
Para configurar el entorno de ejecución del núcleo, puede utilizar las opciones de línea de comandos (grub) o la interfaz sysctl. Eché un vistazo a /etc/sysctl.conf y solo pensar, encontré algunas configuraciones personalizadas. Sintiendo que había dado en el clavo, deseché todas las configuraciones no relacionadas con la red o no TCP, quedándome con un puñado de configuraciones net.core. Luego me dirigí a donde están los permisos de host de la VM y comencé a aplicar cada una de las configuraciones de la VM rota, hasta que di con el culpable:
net.core.rmem_default = 2147483647¡Ahí está, la configuración de DNS defectuosa! Encontré el arma del crimen. Pero, ¿por qué está ocurriendo esto? Aún necesitaba un motivo.
La configuración del tamaño base del búfer de los paquetes DNS se realiza a través de net.core.rmem_default. El valor típico varía entre aproximadamente 200KiB, sin embargo, si su servidor recibe muchos paquetes DNS, puede aumentar el tamaño del búfer. Si en el momento de recibir un nuevo paquete el búfer está lleno, por ejemplo, porque la aplicación no lo procesa lo suficientemente rápido, comenzará a perder paquetes. Nuestro cliente aumentó correctamente el tamaño del búfer porque temía la pérdida de datos, ya que utilizaba una aplicación para recopilar métricas a través de paquetes DNS. El valor que configuró fue el máximo posible: 231-1 (si se configura 231, el núcleo devolverá «ARGUMENTO INVÁLIDO»).
De repente comprendí por qué nmap y scapy funcionaban correctamente: ¡usaban sockets en bruto! Los sockets en bruto son diferentes de los normales: funcionan al margen de iptables y no se almacenan en búfer.
Pero, ¿por qué un «búfer demasiado grande» causa problemas? Claramente no funciona como se esperaba.
En este punto, podía reproducir el problema en varios núcleos y múltiples distribuciones. El problema ya se manifestaba en el núcleo 3.x y también ahora en el núcleo 5.x.
De hecho, al ejecutar
sysctl -w net.core.rmem_default=$((2**31-1))DNS dejaba de funcionar.
Empecé a buscar valores operativos mediante un simple algoritmo de búsqueda binaria y descubrí que la sistema funcionaba con 2147481343, pero para mí ese número era un conjunto de cifras sin sentido. Le propuse al cliente probar ese número y respondió que la sistema funcionó con google.com, pero aún mostraba un error con otros dominios, así que continué mi investigación.
Instalé , una herramienta que debería haber utilizado antes: muestra exactamente dónde entra el paquete en el núcleo. La culpable fue la función udp_queue_rcv_skb. Descargué el código fuente del núcleo y añadí algunas para rastrear exactamente dónde va el paquete. Rápidamente descubrí la condición necesaria if, y durante un tiempo simplemente me quedé mirando, ya que fue en ese momento que todo finalmente encajó: 231-1, un número sin sentido, un dominio que no funcionaba... El problema estaba en un trozo de código en __udp_enqueue_schedule_skb:
if (rmem > (size + sk->sk_rcvbuf))
		goto uncharge_drop;
Por favor, ten en cuenta:
rmemes de tipo inttamañoes de tipo u16 (int sin signo de dieciséis bits) y almacena el tamaño del paquetesk->sk_rcybufes de tipo int y almacena el tamaño del búfer, que por definición es igual al valor ennet.core.rmem_default
Cuando sk_rcvbuf se acerca a 231, la suma del tamaño del paquete puede llevar a un . Y dado que es int, su valor se vuelve negativo, lo que hace que la condición se vuelva verdadera cuando debería ser falsa (puedes aprender más sobre esto en ).
El error se corrige de manera trivial: convirtiendo a unsigned int. Apliqué la corrección y reinicié el sistema, tras lo cual DNS volvió a funcionar.
El sabor de la victoria
Le envié mis hallazgos al cliente y envié el parche del núcleo. Estoy satisfecho: cada pieza del rompecabezas encajó en su lugar, puedo explicar con precisión por qué observamos lo que observamos, y lo más importante, ¡pudimos encontrar la solución al problema gracias al trabajo en equipo!
Es justo reconocer que el caso resultó ser raro, y afortunadamente, pocas veces recibimos solicitudes tan complicadas de los usuarios.
Fuente: habr.com
