

¡Hola, Habr! En los últimos meses hemos estado en una situación muy interesante y me gustaría compartir nuestra historia sobre la escalabilidad de la infraestructura. Durante este tiempo, SberMarket ha crecido cuatro veces en pedidos y ha lanzado su servicio en 17 nuevas ciudades. El explosivo aumento en la demanda de entrega de productos nos ha obligado a escalar la infraestructura. Lee sobre las conclusiones más interesantes y útiles más abajo.
Me llamo Dima Bobylev, soy el director técnico de SberMarket. Dado que este es el primer post en nuestro blog, diré algunas palabras sobre mí y sobre la compañía. El otoño pasado participé en el concurso de jóvenes líderes de Runet. Para el concurso, yo sobre cómo vemos en SberMarket la cultura interna y el enfoque hacia el desarrollo del servicio. Y aunque no logré ganar en el concurso, pude formular para mí los principios fundamentales del desarrollo del ecosistema IT.
Al gestionar un equipo, es importante entender y encontrar el equilibrio entre lo que necesita el negocio y las necesidades de cada desarrollador en particular. Actualmente, SberMarket está creciendo 13 veces año tras año, y esto afecta al producto, exigiendo un aumento constante en los volúmenes y en la velocidad de desarrollo. A pesar de esto, dedicamos suficiente tiempo a los desarrolladores para el análisis preliminar y la escritura de código de calidad. El enfoque establecido no solo ayuda en la creación de un producto funcional, sino también en su posterior escalabilidad y desarrollo. Como resultado de este crecimiento, SberMarket se ha convertido en el líder entre los servicios de entrega de productos: entregamos diariamente alrededor de 18,000 pedidos al día, aunque a principios de febrero eran aproximadamente 3,500.
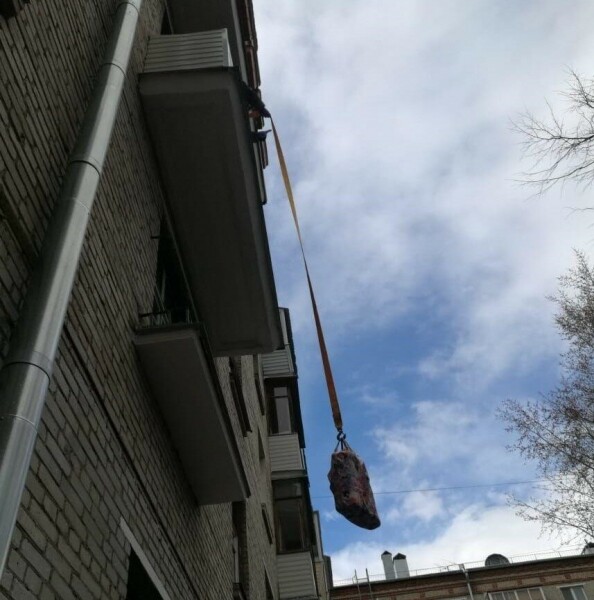
Una vez, un cliente pidió al mensajero de SberMarket que le entregara productos sin contacto, directamente en el balcón.
Pero vayamos a lo concreto. En los últimos meses, hemos estado trabajando activamente en la escalación de la infraestructura de nuestra empresa. Esta necesidad se explicaba por factores internos y externos. Al mismo tiempo que nuestra base de clientes se expandía, el número de tiendas conectadas creció de 90 a principios de año a más de 200 a mediados de mayo. Por supuesto, estuvimos preparados, reservamos la infraestructura principal y calculamos la posibilidad de escalar vertical y horizontalmente todas las máquinas virtuales alojadas en la nube de Yandex. Sin embargo, la práctica demostró: 'Todo lo que puede salir mal, saldrá mal'. Y hoy quiero compartir las situaciones más curiosas que ocurrieron durante estas semanas. Espero que nuestra experiencia sea útil para usted.
Slave está en plena capacidad operativa
Incluso antes del inicio de la pandemia, nos encontramos con un aumento en el número de solicitudes a nuestros servidores backend. La tendencia de pedir productos con entrega a domicilio comenzó a ganar impulso, y con la implementación de las primeras medidas de aislamiento en relación con la COVID-19, la carga aumentó drásticamente a lo largo del día. Surgió la necesidad de descargar rápidamente los servidores principales de la base de datos y trasladar parte de las solicitudes de lectura a los servidores réplicas (slave).
Nos preparamos con anticipación para este paso, y ya se habían puesto en marcha 2 servidores slave para tal maniobra. En ellos, principalmente, se ejecutaban tareas por lotes para la generación de feeds informativos para el intercambio de datos con socios. Estos procesos generaban una carga adicional y, con razón, habían sido excluidos 'de la ecuación' un par de meses antes.
Dado que en Slave se estaba llevando a cabo la replicación, nos adherimos a la concepción de que las aplicaciones solo podían trabajar con ellos en modo de solo lectura. El Plan de Recuperación ante Desastres suponía que en caso de una catástrofe podríamos montar simplemente el Slave en lugar del Master y redirigir todas las solicitudes de escritura y lectura al Slave. Sin embargo, también deseábamos utilizar réplicas para las necesidades del departamento de análisis, por lo que los servidores no se trasladaron completamente a un estado de solo lectura, y cada host tenía su propio conjunto de usuarios, algunos con derechos de escritura para guardar resultados intermedios de cálculos.
Hasta cierto nivel de carga, teníamos suficiente con el maestro tanto para la escritura como para la lectura al procesar solicitudes http. A mediados de marzo, justo cuando Sbermarket decidió pasar completamente al trabajo remoto, comenzamos a experimentar un crecimiento exponencial en RPS. Cada vez más de nuestros clientes se quedaban en casa o trabajaban desde allí, lo que se reflejó en los indicadores de carga.
La capacidad del 'maestro' dejó de ser suficiente, por lo que comenzamos a mover algunas de las solicitudes de lectura más pesadas a la réplica. Para dirigir las solicitudes de escritura al maestro y las de lectura al esclavo de manera transparente, utilizamos la gema ruby «». Creamos un usuario especial con el sufijo _readonly sin derechos de escritura. Sin embargo, debido a un error en la configuración de uno de los hosts, algunas solicitudes de escritura se enviaron al servidor esclavo con el nombre de usuario que tenía los derechos correspondientes.
El problema no se manifestó de inmediato, ya que la carga aumentada incrementó el desfase de los esclavos. La inconsistencia de los datos se detectó por la mañana, cuando después de las importaciones nocturnas, los esclavos no habían 'alcanzado' al maestro. Atribuimos esto a la alta carga en el propio servicio y las importaciones relacionadas con el lanzamiento de nuevas tiendas. Sin embargo, proporcionar datos con un retraso de varias horas era inaceptable, así que cambiamos los procesos al segundo esclavo analítico, ya que tenía más recursos y no estaba cargado con solicitudes de lectura (lo que nos ayudó a explicar la ausencia de retraso en la replicación).mayor audiencia.Cuando entendimos las razones del 'desplazamiento' del esclavo principal, el analítico ya había fallado por la misma razón. A pesar de tener dos servidores adicionales, a los que planeábamos transferir la carga en caso de que fallara el maestro, resultó que en un momento crítico no había ninguno disponible debido a un desafortunado error.
Pero dado que no solo realizamos un dump de la base de datos (la restauración en ese momento tomó alrededor de 5 horas), sino también un snapshot del servidor maestro, pudimos lanzar la réplica en un plazo de 2 horas. Sin embargo, después de eso, nos esperaba una larga aplicación del registro de la replicación (porque el proceso se realiza en modo de un solo hilo, pero esa ya es otra historia).
Но так как мы делали не только dump БД (рестор на тот момент составлял около 5 часов), но и snapshot master-сервера, запустить реплику удалось в течение 2 часов. Правда после этого нас ожидало накатывание лога репликации в течение продолжительного времени (потому что процесс идет в однопоточном режиме, но это уже совсем другая история).
Salida: Después de este incidente, quedó claro que debíamos abandonar la práctica de restringir el acceso de escritura para los usuarios y declarar todo el servidor como solo lectura. Con este enfoque, podemos estar seguros de que las réplicas estarán disponibles en momentos críticos.
La optimización de incluso una sola consulta pesada puede 'revivir' la base de datos.
Aunque actualizamos constantemente el catálogo en el sitio, las consultas que lanzábamos a los servidores secundarios mostraban un pequeño desfase respecto al servidor primario. El tiempo que nos llevó detectar y solucionar el problema de los 'esclavos' que 'se salían del circuito' superó el 'umbral psicológico' (durante ese tiempo podrían haberse actualizado los precios, y los clientes verían datos desactualizados), y nos vimos obligados a redirigir todas las consultas al servidor principal de la base de datos. Como resultado, el sitio funcionaba lentamente… pero al menos funcionaba. Y mientras el esclavo se recuperaba, no nos quedó más remedio que optimizar.
Mientras los servidores secundarios se recuperaban, los minutos se alargaban lentamente, el maestro permanecía sobrecargado y dedicamos todos nuestros esfuerzos a optimizar las tareas activas según la 'Regla de Pareto': seleccionamos las principales consultas que generaban la mayor parte de la carga y comenzamos a ajustar. Esto se hacía directamente 'sobre la marcha'.
Un efecto interesante fue que un MySQL completamente cargado responde incluso a una mejora menor en los procesos. La optimización de un par de consultas que solo generaban el 5% de la carga total ya mostró una notable reducción en el uso de CPU. Como resultado, pudimos asegurar un margen aceptable de recursos para que el maestro trabajara con la base de datos y obtener el tiempo necesario para recuperar las réplicas.
Salida: Incluso una pequeña optimización permite 'sobrevivir' durante horas de sobrecarga. Justo lo que necesitábamos durante el tiempo de recuperación de los servidores con réplicas. Por cierto, discutiremos el aspecto técnico de la optimización de consultas en uno de los próximos artículos. Así que suscríbete a nuestro blog si esto puede resultarte útil.
Organiza el monitoreo del estado de los servicios asociados.
Nos encargamos de procesar pedidos de clientes, por lo que nuestros servicios interactúan constantemente con API de terceros: son puertas de enlace para el envío de SMS, plataformas de pago, sistemas de enrutamiento, geocodificadores, el servicio de la FNS y muchos otros sistemas. Y cuando la carga comenzó a crecer rápidamente, comenzamos a encontrar limitaciones en los API de nuestros servicios asociados, en las que antes ni siquiera habíamos pensado.
Un exceso inesperado de las cuotas de los servicios asociados puede llevar a la inactividad de los suyos. Muchos API bloquean a los clientes que superan los límites, y en algunos casos, una sobrecarga de solicitudes puede saturar la producción del socio.
Por ejemplo, en el momento del aumento de entregas, los servicios relacionados no podían manejar las tareas de distribución y definición de rutas. Como resultado, se daban situaciones en las que los pedidos estaban hechos, pero el servicio que generaba la ruta no funcionaba. Debo decir que nuestros logististas hicieron prácticamente lo imposible en estas circunstancias, y la clara interacción del equipo ayudó a compensar las caídas temporales de los servicios. Pero tal volumen de solicitudes no se puede manejar manualmente de forma constante, y después de un tiempo habríamos enfrentado una brecha inaceptable entre los pedidos y su ejecución.
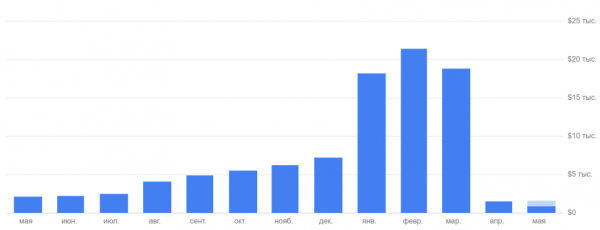
Se tomó una serie de medidas organizativas y el trabajo coordinado del equipo ayudó a ganar tiempo mientras negociábamos nuevas condiciones y esperábamos la modernización de los servicios de algunos socios. Existen otros API que sorprenden por su alta resistencia y tarifas astronómicas en caso de tráfico elevado. Por ejemplo, al principio utilizábamos un conocido API de mapas para determinar la dirección del punto de entrega. Pero al final del mes recibimos una factura de casi 2 millones de rublos. Después de eso, decidimos reemplazarlo rápidamente. No voy a hacer publicidad, pero diré que nuestros gastos se redujeron considerablemente.
Salida: Es esencial monitorear las condiciones de trabajo de todos los servicios asociados y tenerlas en cuenta. Incluso si hoy parece que tienen 'un gran margen', no significa que mañana no se conviertan en un obstáculo para el crecimiento. Y, por supuesto, es mejor acordar las condiciones financieras para las solicitudes aumentadas al servicio con anticipación.
A veces resulta que "" (c) no ayuda
Estamos acostumbrados a los «cuellos de botella» en la base de datos principal o en los servidores de aplicaciones, pero al escalar, los problemas pueden aparecer donde menos los esperamos. Para la búsqueda de texto completo en el sitio, utilizamos el motor Apache Solr. Con el aumento de la carga, notamos una disminución en el tiempo de respuesta y la carga del CPU del servidor llegó a alcanzar el 100%. ¿Qué puede ser más simple? Le damos más recursos al contenedor con Solr.
En lugar del aumento de rendimiento esperado, el servidor simplemente «murió». Se sobrecargaba al 100% de inmediato y respondía aún más lento. Inicialmente, teníamos 2 núcleos y 2 GB de RAM. Decidimos hacer lo que normalmente ayuda: le dimos al servidor 8 núcleos y 32 GB. Todo empeoró considerablemente (cómo y por qué lo explicaremos en una publicación aparte).
En unos pocos días, entendimos las complejidades de este asunto y logramos un rendimiento óptimo con 8 núcleos y 32 GB. Esta configuración permite seguir incrementando la carga, lo cual es muy importante, ya que el crecimiento no solo se da en los clientes, sino también en el número de tiendas conectadas: en 2 meses su número se ha duplicado.
Salida: Los métodos estándar como «agregar más hardware» no siempre funcionan. Así que, al escalar cualquier servicio, es necesario comprender bien cómo utiliza los recursos y probar su desempeño en nuevas condiciones por adelantado.
Sin estado — la clave para un fácil escalado horizontal.
En general, nuestro equipo se adhiere al enfoque conocido: los servicios no deben tener estado interno (stateless) y deben ser independientes del entorno de ejecución. Esto nos permitió enfrentar el aumento de la carga mediante un simple escalado horizontal. Pero teníamos un servicio - excepción: un procesador de tareas en segundo plano prolongadas. Se encargaba del envío de correos electrónicos y SMS, el procesamiento de eventos, la generación de feeds, la importación de precios e inventarios, y el procesamiento de imágenes. De alguna manera, dependía del almacenamiento local de archivos y existía en una única instancia.
Cuando aumentó la cantidad de tareas en la cola del procesador (lo cual ocurrió naturalmente con el crecimiento de los pedidos), el rendimiento del host en el que se alojaban el procesador y el almacenamiento de archivos se convirtió en un factor limitante. Como resultado, se detuvieron las actualizaciones de assortimento y precios, el envío de notificaciones a los usuarios y muchas otras funciones críticas que quedaron atascadas en la cola. El equipo de Ops migró rápidamente el almacenamiento de archivos a un sistema de almacenamiento en red similar a S3, lo que nos permitió lanzar varias máquinas potentes para escalar el procesador de tareas en segundo plano.
Salida: La regla Stateless debe seguirse para todos los componentes sin excepción, incluso si parece que "aquí definitivamente no nos quedaremos atascados". Es mejor dedicar un poco de tiempo a organizar correctamente el trabajo de todos los sistemas que tener que reescribir código y reparar un servicio que está bajo carga después de la prisa.
7 principios para un crecimiento intenso
A pesar de la disponibilidad de capacidades adicionales, durante el proceso de crecimiento encontramos varios obstáculos. Durante este tiempo, la cantidad de pedidos aumentó más de 4 veces. Ahora ya estamos entregando más de 17,000 pedidos al día en 62 ciudades y planeamos expandir aún más nuestra geografía: en el primer semestre de 2020 se espera el lanzamiento del servicio en todo Rusia. Para hacer frente a la creciente carga, teniendo en cuenta las lecciones aprendidas, hemos establecido 7 principios fundamentales de funcionamiento bajo condiciones de crecimiento constante:
- Gestión de incidentes. Creamos un tablero en Jira, donde cada incidente se refleja como un ticket. Esto ayudará a priorizar y ejecutar las tareas relacionadas con el incidente. Después de todo, en esencia, no es aterrador cometer un error, lo aterrador es cometer el mismo error dos veces. Para aquellos casos en que los incidentes se repiten antes de poder corregir la causa, debe haber una instrucción lista para actuar, porque durante una carga alta es importante reaccionar de inmediato.
- Monitoreo se requiere para todos los elementos de la infraestructura sin excepción. Gracias a él, pudimos prever el aumento de la carga y seleccionar correctamente los 'cuellos de botella' para priorizar su eliminación. Es probable que, bajo alta carga, se rompa o empiece a fallar todo lo que no pensabas. Por eso, es mejor crear nuevas alertas justo después de que ocurran los primeros incidentes, para monitorearlos y anticiparlos.
- Alertas correctas son absolutamente necesarias ante un aumento brusco de la carga. En primer lugar, deben informar exactamente qué se ha roto. En segundo lugar, no debe haber demasiadas alertas, ya que una abundancia de alertas no críticas lleva a ignorar todas las notificaciones en general.
- Las aplicaciones deben ser sin estado. Nos hemos asegurado de que no debe haber excepciones a esta regla. Se necesita una completa independencia del entorno de ejecución. Para ello, puedes almacenar datos compartidos en una base de datos o, por ejemplo, directamente en S3. Y aún mejor seguir las normas. Durante un aumento brusco, no hay tiempo para optimizar el código, y se tendrá que afrontar la carga aumentando directamente los recursos computacionales y utilizando escalado horizontal.
- Cuotas y rendimiento de servicios externos. Durante un crecimiento rápido, el problema puede surgir no solo en tu infraestructura, sino también en el servicio externo. Lo más frustrante es cuando esto ocurre no por un fallo, sino por alcanzar cuotas o límites. Así que los servicios externos deben escalar tan bien como tú mismo.
- Separa procesos y colas. Esto ayuda mucho cuando hay un bloqueo en uno de los gateways. No habríamos enfrentado retrasos en la transmisión de datos si las colas llenas para el envío de SMS no interfirieran con el intercambio de notificaciones entre los sistemas de información. Además, sería más fácil aumentar el número de trabajadores si trabajaran por separado.
- Realidades financieras. Cuando hay un crecimiento explosivo de flujos de datos, no hay tiempo para pensar en tarifas y suscripciones. Pero debes mantenerlos en mente, especialmente si eres una pequeña empresa. Una gran factura puede ser presentada por el propietario de cualquier API, así como por tu proveedor de alojamiento. Así que debes leer los contratos con atención.
Conclusión
No sin pérdidas, pero hemos superado esta etapa y hoy nos esforzamos por seguir todos los principios encontrados, y cada máquina tiene la posibilidad de aumentar su rendimiento hasta 4 veces para lidiar con imprevistos.
En las próximas publicaciones compartiremos nuestra experiencia en la investigación de la caída de rendimiento en Apache Solr, así como sobre la optimización de consultas y cómo la interacción con la FNS ayuda a la empresa a ahorrar dinero. Suscríbete a nuestro blog para no perderte nada y cuéntanos en los comentarios si has tenido problemas similares durante el aumento del tráfico.
Solo los usuarios registrados pueden participar en la encuesta. , por favor.
¿Has experimentado disminuciones o caídas en el servicio debido a un aumento repentino en la carga por:
55,6%La imposibilidad de agregar rápidamente recursos computacionales10
16,7%Límites de la infraestructura del proveedor de hosting3
33,3%Límites de APIs de terceros6
27,8%Violaciones de los principios sin estado en tus aplicaciones5
88,9%Inoptimización del código de tus propios servicios16
Votaron 18 usuarios. Se abstuvieron 6 usuarios.
Fuente: habr.com
