

Hola a todos. Soy Vladislav Rodin. Actualmente soy el director del curso "Arquitecto de Cargas Altas" en OTUS y también enseño en cursos dedicados a la arquitectura de software.
Además de enseñar, como habrán notado, me dedico a escribir contenido original para el blog de OTUS en Habr, y el artículo de hoy lo quiero dedicar al lanzamiento del curso , el cual está abierto para inscripciones en este momento.
Introducción
En Hablamos de que las transacciones en bases de datos cumplen con dos objetivos: garantizar la tolerancia a fallos y el acceso a datos en un entorno concurrente. Para llevar a cabo plenamente estos objetivos, una transacción debe tener propiedades ACID. Hoy hablaremos en detalle sobre la letra I (aislamiento) en este acrónimo.
⚠️ Limitado
El aislamiento resuelve el problema del acceso a datos en un entorno concurrente, proporcionando de hecho protección contra condiciones de carrera. En ideal, el aislamiento significa serialización, es decir, una propiedad que garantiza que el resultado de las transacciones concurrentes sea el mismo que si se ejecutaran de manera secuencial. El principal problema de esta propiedad radica en que es muy difícil de garantizar técnicamente y, como consecuencia, afecta considerablemente el rendimiento del sistema. Por esta razón, a menudo se relaja el aislamiento, asumiendo los riesgos de que ocurran ciertas anomalías, de las que hablaremos a continuación. La posibilidad de que ocurran ciertas anomalías es precisamente lo que caracteriza el nivel de aislamiento de las transacciones.
Las anomalías más conocidas son: lectura sucia, lectura no repetible, lectura fantasma, pero en realidad hay 5 más: escritura sucia, actualización perdida de cursor, actualización perdida, lectura sesgada, escritura sesgada.
Escritura sucia
La esencia de la anomalía radica en que las transacciones pueden sobrescribir datos no confirmados.
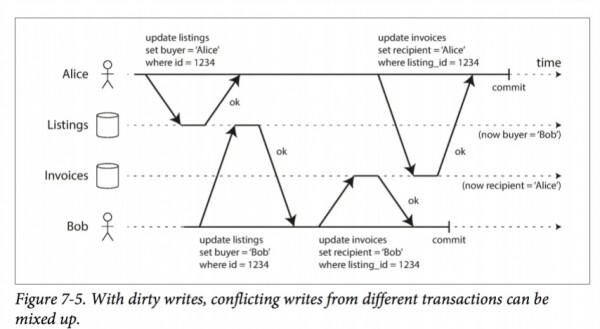
Esta anomalía es peligrosa no solo porque los datos pueden entrar en conflicto después de que ambas transacciones se confirmen (como en la imagen), sino también porque se rompe la atomicidad: puesto que permitimos sobrescribir datos no confirmados, no está claro cómo revertir una transacción sin afectar a la otra.
La anomalía se soluciona bastante fácil: se coloca un bloqueo en la escritura antes de comenzar, impidiendo que otras transacciones cambien el registro hasta que se levante el bloqueo.
Lectura sucia
Lectura sucia significa leer datos no confirmados.
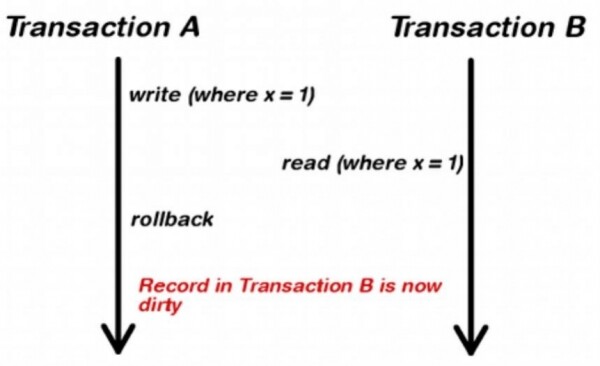
Los problemas surgen cuando es necesario realizar acciones o tomar decisiones basadas en una muestra.
Para corregir la anomalía, se puede imponer un bloqueo de lectura, pero esto afectará gravemente al rendimiento. Es mucho más simple decir que para hacer un rollback de la transacción, el estado original de los datos (antes del inicio de la escritura) debe ser necesariamente guardado en el sistema. ¿Por qué no leer de allí? Eso es bastante barato, por lo que la mayoría de las bases de datos deshabilitan la lectura sucia por defecto.
Actualización perdida
La actualización perdida se refiere a las actualizaciones perdidas, y la traducción refleja con bastante precisión la esencia del problema:
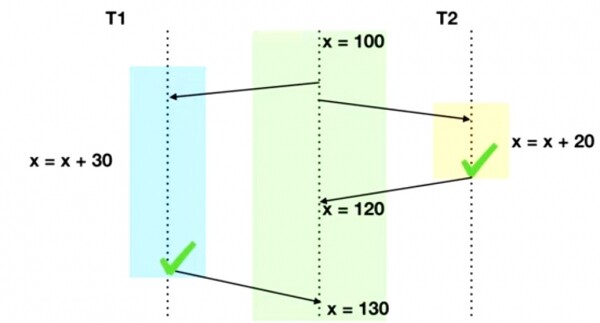
De hecho, el resultado de la transacción T2 fue cancelado. Esta situación se corrige mediante bloqueos explícitos o implícitos de registros. Es decir, o bien simplemente realizamos la actualización del registro, y entonces se produce un bloqueo implícito, o bien ejecutamos select for update, lo que provoca un bloqueo tanto de lectura como de escritura. Tenga en cuenta que esta operación es bastante peligrosa: al realizar una 'lectura inocente', bloqueamos otras lecturas. Algunas bases ofrecen una opción más segura, select for share, que permite leer datos, pero no permite modificarlos.
Actualización perdida del cursor
Para un control más fino, las bases pueden ofrecer otras herramientas, como un cursor. Un cursor es una estructura que contiene un conjunto de filas y permite iterar sobre ellas. declare cursor_name for select_statement. El contenido del cursor se describe mediante un select.
¿Para qué sirve un cursor? La cuestión es que algunas bases de datos ofrecen un bloqueo en todos los registros seleccionados por el select (estabilidad de lectura), o solo en el registro en el que se encuentra en ese momento el cursor (estabilidad del cursor). Con la estabilidad del cursor se realiza un bloqueo corto, lo que permite reducir la cantidad de bloqueos si estamos iterando sobre una gran muestra de datos. Por eso, la anomalía de la actualización perdida se destaca para el cursor por separado.
Lectura no repetible
La lectura no repetible consiste en que durante la ejecución de nuestra transacción, dos lecturas consecutivas del mismo registro darán diferentes resultados, porque otra transacción intervino entre estas dos lecturas, cambió nuestros datos y fue confirmada.
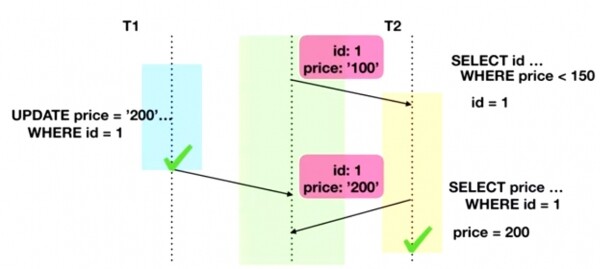
¿Por qué es un problema en absoluto? Imagina que el objetivo de la transacción T2 en la imagen es seleccionar todos los productos cuyo precio sea inferior a 150 u.e. Alguien más ha actualizado el precio a 200 u.e. Por lo tanto, el filtro establecido no funcionó.
Estas anomalías dejan de ocurrir al agregar bloqueos en dos fases o al utilizar el mecanismo MVCC, del cual me gustaría hablar por separado.
Lectura fantasma
Se denomina lectura fantasma a la lectura de datos que han sido añadidos por otra transacción.
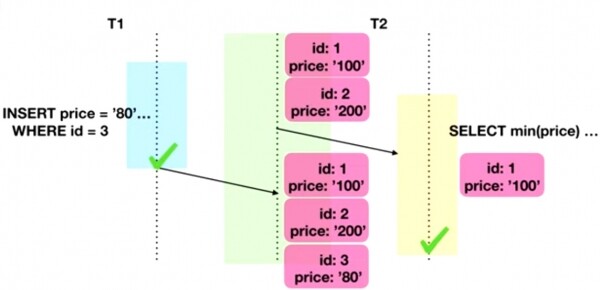
Como ejemplo, se puede observar la selección incorrecta del producto más barato cuando se produce esta anomalía.
Deshacerse de las lecturas fantasma ya es bastante complicado. Un bloqueo convencional no es suficiente, ya que no podemos bloquear lo que aún no existe. Los sistemas 2PL utilizan bloqueo predictivo, mientras que los sistemas MVCC anulan las transacciones que pueden ser interrumpidas por una inserción. Tanto un mecanismo como el otro son bastante pesados.
Deslizamiento de lectura
El deslizamiento de lectura ocurre cuando trabajamos con múltiples tablas, cuyo contenido debe cambiar de manera coherente.
Supongamos que hay tablas que representan publicaciones y su metainformación:
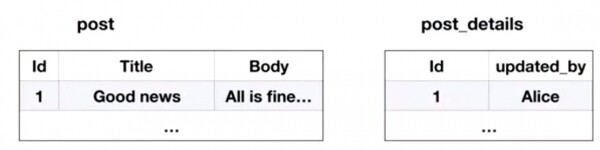
Una transacción lee de las tablas, mientras que otra las modifica:
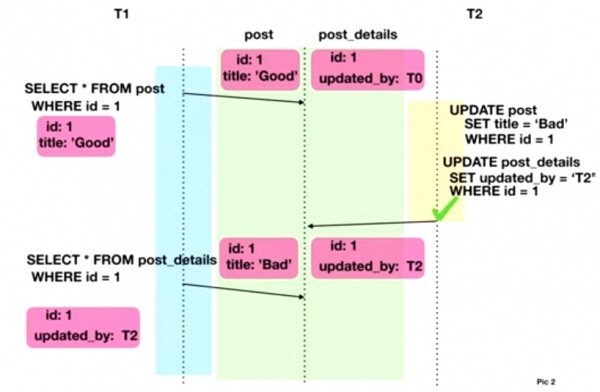
Como resultado de la ejecución de la transacción T1, la publicación tiene title = Bueno y updated_by = T2, lo que es una cierta incongruencia.
De hecho, es una lectura no repetible, pero en el contexto de varias tablas.
Para corregirlo, T1 puede colocar bloqueos en todas las filas que va a leer, lo que evitará que la transacción T2 modifique la información. En el caso de MVCC, la transacción T2 será anulada. Protegerse de esta anomalía puede ser importante si utilizamos cursores.
Deslizamiento de escritura
Esta anomalía también es más fácil de explicar con un ejemplo: supongamos que en nuestro sistema al menos un médico debe estar de guardia, pero ambos médicos decidieron cancelar su guardia:
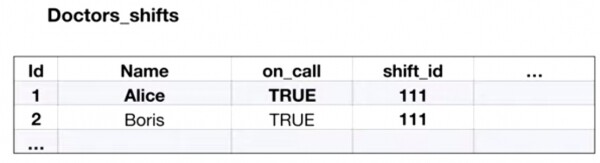
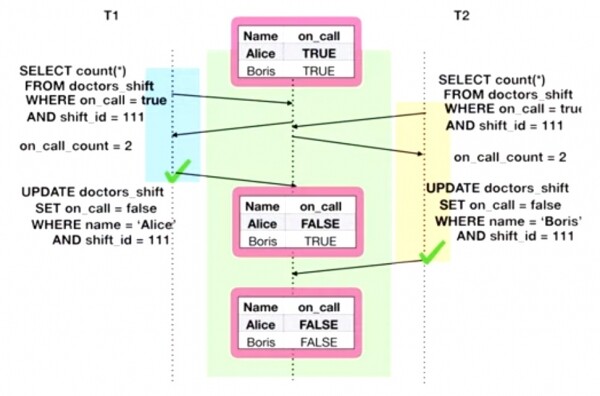
La anomalía llevó a que ninguno de los médicos se presentara a la guardia. ¿Por qué sucedió esto? Porque la transacción verificaba una condición que podía ser violada por otra transacción y, debido a la aislamiento, no pudimos ver este cambio.
Es la misma lectura no repetible. Como alternativa, los selects pueden colocar bloqueos en estos registros.
El write skew y el read skew son combinaciones de las anomalías anteriores. Se puede considerar el write skew, que es en esencia un phantom read. Consideremos una tabla que contiene los nombres de los empleados, sus salarios y el proyecto en el que trabajan:
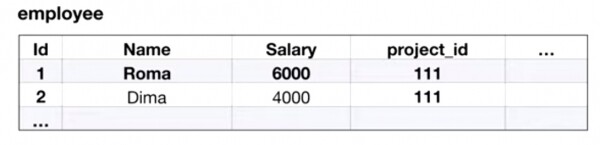
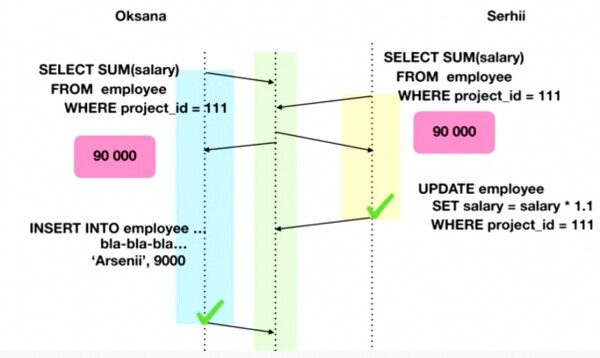
Como resultado, obtenemos el siguiente panorama: cada gerente pensó que su cambio no llevaría a un excedente presupuestario, por lo que realizaron cambios en el personal que, en conjunto, resultaron en un sobrepaso.
La causa de este problema es exactamente la misma que en el caso del phantom read.
Conclusiones
Reducir el nivel de aislamiento de transacciones en una base de datos es un compromiso entre seguridad y rendimiento; la elección de este nivel debe hacerse considerando los riesgos potenciales para el negocio al enfrentar determinadas anomalías.
Fuente: habr.com
