

Esta primavera ya discutimos algunos temas introductorios, como y . En el segundo de ellos incluso prometimos continuar explorando el rendimiento de varias topologías de múltiples discos en ZFS. Este es un sistema de archivos de próxima generación que se está implementando en todas partes: desde hasta .
Bien, hoy es el día más adecuado para conocer ZFS, lectores curiosos. Simplemente sepan que, según la modesta estimación del desarrollador de OpenZFS, Matt Arens, "realmente es complicado".
Pero antes de llegar a los números —y los habrá, lo prometo— sobre todas las configuraciones de ocho discos de ZFS, es necesario hablar de cómo cómo ZFS almacena datos en el disco.
Zpool, vdev y device
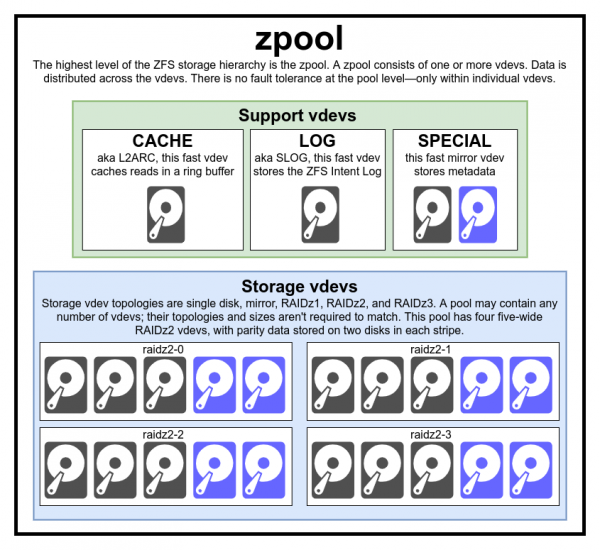
Este diagrama de un pool completo incluye tres vdevs auxiliares, uno de cada clase, y cuatro para RAIDz2
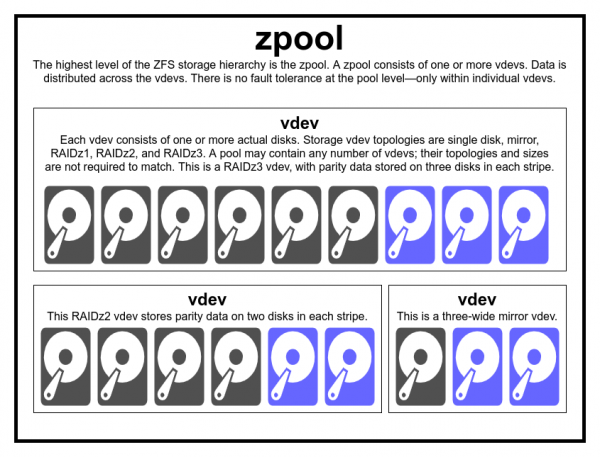
Generalmente, no hay razones para crear un pool a partir de tipos y tamaños de vdev no coincidentes —pero si lo desea, nada le impide hacerlo
Para entender realmente el sistema de archivos ZFS, es necesario observar de cerca su estructura real. En primer lugar, ZFS combina los niveles tradicionales de gestión de volúmenes y sistemas de archivos. En segundo lugar, utiliza un mecanismo transaccional de copia en escritura. Estas características significan que la estructura del sistema es muy diferente de los sistemas de archivos y arrays RAID convencionales. El primer conjunto de bloques de construcción básicos para entender: es el pool de almacenamiento (zpool), el dispositivo virtual (vdev) y el dispositivo real (device).
zpool
El pool de almacenamiento zpool es la estructura más alta de ZFS. Cada pool contiene uno o más dispositivos virtuales. A su vez, cada uno de ellos contiene uno o más dispositivos reales (device). Los pools virtuales son bloques autónomos. Una computadora física puede contener dos o más pools separados, pero cada uno es completamente independiente de los demás. Los pools no pueden compartir dispositivos virtuales.
La redundancia de ZFS está a nivel de dispositivos virtuales, no a nivel de pools. A nivel de pools no hay absolutamente ninguna redundancia —si se pierde algún almacenamiento vdev o un vdev dedicado, entonces se pierde todo el pool junto con él.
Los modernos grupos de almacenamiento pueden sobrevivir a la pérdida de caché o de registro del dispositivo virtual; aunque pueden perder una pequeña cantidad de datos no escritos si pierden el registro del vdev durante un corte de energía o una falla del sistema.
Existe una creencia común de que las 'bandas de datos' (stripes) de ZFS se escriben a través de todo el grupo. Esto es incorrecto. Zpool no es simplemente un RAID0 divertido, es más bien algo más complejo. con un mecanismo complejo y variable de distribución.
En su mayor parte, las escrituras se distribuyen entre los dispositivos virtuales disponibles de acuerdo con el espacio libre disponible, por lo que teóricamente todos se llenarían al mismo tiempo. En versiones más recientes de ZFS, se toma en cuenta el uso actual (utilización) del vdev; si un dispositivo virtual está significativamente más cargado que otro (por ejemplo, debido a una alta carga de lectura), se omitirá temporalmente para la escritura, a pesar de tener el mayor coeficiente de espacio libre.
El mecanismo de determinación de utilización incorporado en los métodos modernos de distribución de escritura de ZFS puede reducir la latencia y aumentar el rendimiento durante períodos de carga inusualmente alta; pero esto no da carta blanca para la mezcla involuntaria de HDD lentos y SSD rápidos en un mismo grupo. Un grupo desigualmente equilibrado seguirá funcionando a la velocidad del dispositivo más lento, es decir, como si estuviera completamente compuesto de esos dispositivos.
vdev
Cada grupo de almacenamiento consta de uno o varios dispositivos virtuales (virtual device, vdev). A su vez, cada vdev incluye uno o más dispositivos físicos. La mayoría de los dispositivos virtuales se utilizan para almacenamiento simple de datos, pero existen varias clases auxiliares de vdev, incluyendo CACHE, LOG y SPECIAL. Cada uno de estos tipos de vdev puede tener una de cinco topologías: dispositivo único (single-device), RAIDz1, RAIDz2, RAIDz3 o espejo (mirror).
RAIDz1, RAIDz2 y RAIDz3 son tipos especiales de lo que los viejos llamarían RAID de doble paridad (diagonal). 1, 2 y 3 se refieren a cuántos bloques de paridad se asignan a cada franja de datos. En lugar de discos separados para la paridad, los dispositivos virtuales RAIDz distribuyen esta paridad de manera semiuniforme entre los discos. Un arreglo RAIDz puede perder tantos discos como bloques de paridad tenga; si pierde uno más, fallará y llevará consigo el pool de almacenamiento.
En los dispositivos virtuales espejo (mirror vdev), cada bloque se almacena en cada dispositivo en vdev. Aunque los espejos dobles (two-wide) son los más comunes, en un espejo puede haber cualquier cantidad arbitraria de dispositivos; en instalaciones grandes, para mejorar el rendimiento de lectura y la resiliencia, a menudo se utilizan espejos triples. Un espejo vdev puede sobrevivir a cualquier falla mientras al menos un dispositivo en vdev siga funcionando.
Los vdev individuales son intrínsecamente peligrosos. Este tipo de dispositivo virtual no sobrevivirá a ninguna falla, y si se utiliza como almacenamiento o vdev especial, su falla resultará en la destrucción de todo el pool. Aquí se debe tener mucho, mucho cuidado.
Los dispositivos virtuales CACHE, LOG y SPECIAL pueden ser creados en cualquiera de las topologías mencionadas anteriormente, pero recuerde que la pérdida de un dispositivo virtual SPECIAL significa la pérdida del pool, por lo que se recomienda encarecidamente una topología redundante.
dispositivo
Probablemente este es el término más fácil de entender en ZFS: se refiere literalmente a un dispositivo de bloques de acceso aleatorio. Recuerde que los dispositivos virtuales están compuestos de dispositivos individuales, y un pool está hecho de dispositivos virtuales.
Los discos, ya sean magnéticos o de estado sólido, son los dispositivos de bloques más comunes utilizados como bloques de construcción de vdev. Sin embargo, cualquier dispositivo con un descriptor en /dev funcionará, por lo que se pueden usar arreglos RAID de hardware completos como dispositivos individuales.
Un archivo raw simple es uno de los dispositivos de bloques alternativos más importantes de los que se puede construir un vdev. Los pools de prueba de son una forma muy conveniente de probar los comandos del pool y ver cuánto espacio está disponible en el pool o dispositivo virtual de esta topología.
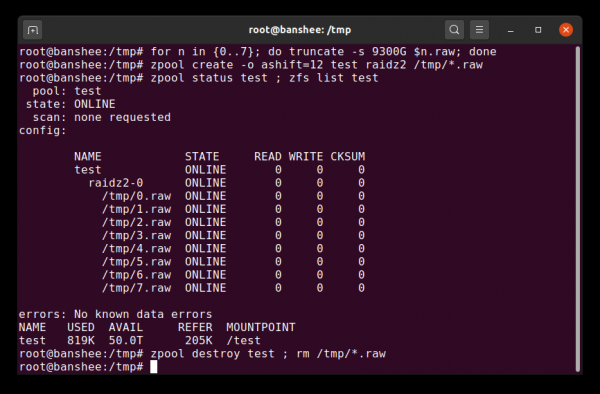
Puedes crear un grupo de prueba a partir de archivos dispersos en solo unos segundos, pero no olvides eliminar todo el grupo y sus componentes después.
Supongamos que deseas configurar un servidor con ocho discos y planeas usar discos de 10 TB (~9300 GiB), pero no estás seguro de cuál topología se adapta mejor a tus necesidades. En el ejemplo anterior, construimos un grupo de prueba a partir de archivos dispersos en segundos, y ahora sabemos que un RAIDz2 vdev compuesto por ocho discos de 10 TB proporciona 50 TiB de capacidad útil.
Otra categoría especial de dispositivos son los SPARE (de reserva). A diferencia de los dispositivos convencionales, los dispositivos de reemplazo en caliente pertenecen a todo el grupo, no a un solo dispositivo virtual. Si algún vdev en el grupo falla y un dispositivo de reserva está conectado y disponible, se unirá automáticamente al vdev afectado.
Una vez conectado al vdev afectado, el dispositivo de reserva comienza a recibir copias o reconstrucciones de los datos que deberían estar en el dispositivo faltante. En RAID tradicional, esto se llama recuperación (rebuilding), y en ZFS se conoce como "recuperación de redundancia" (resilvering).
Es importante destacar que los dispositivos de reserva no sustituyen permanentemente a los dispositivos fallidos. Son solo un reemplazo temporal para reducir el tiempo durante el cual se observa la degradación del vdev. Después de que el administrador reemplace el dispositivo fallido del vdev, se lleva a cabo la recuperación de redundancia en el nuevo dispositivo permanente, y el SPARE se desconecta del vdev y regresa a su función de reserva para todo el grupo.
Conjuntos de datos, bloques y sectores
El siguiente conjunto de bloques de construcción que debemos entender en nuestro viaje por ZFS se relaciona menos con el hardware y más con cómo están organizados y almacenados los propios datos. Aquí omitimos algunos niveles, como el metaslab, para no sobrecargar de detalles, manteniendo así una comprensión de la estructura general.
Conjunto de datos (dataset)
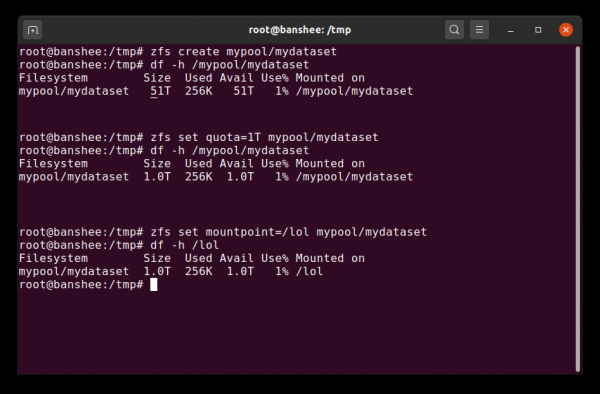
Cuando creamos un conjunto de datos por primera vez, muestra todo el espacio disponible del grupo. Luego, establecemos una cuota y cambiamos el punto de montaje. ¡Magia!
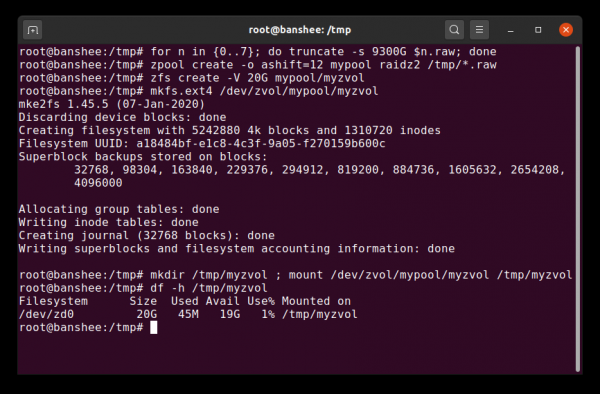
Zvol es en su mayoría solo un conjunto de datos sin su capa de sistema de archivos, que aquí reemplazamos por un sistema de archivos ext4 completamente normal.
El conjunto de datos ZFS es aproximadamente comparable a un sistema de archivos montado estándar. Al igual que un sistema de archivos común, a primera vista parece "simplemente otra carpeta más". Pero, al igual que los sistemas de archivos montables, cada conjunto de datos ZFS tiene su propio conjunto de propiedades básicas.
En primer lugar, a un conjunto de datos se le puede asignar una cuota. Si estableces zfs set quota=100G poolname/datasetname, no podrás escribir en la carpeta montada /poolname/datasetname más de 100 GiB.
¿Notaste la presencia y ausencia de la barra diagonal al comienzo de cada línea? Cada conjunto de datos tiene su propio lugar tanto en la jerarquía de ZFS como en la jerarquía de montaje del sistema. En la jerarquía de ZFS no hay barra inicial: comienzas con el nombre del pool y luego sigues el camino de un conjunto de datos al siguiente. Por ejemplo, pool/parent/child para un conjunto de datos llamado child debajo del conjunto de datos padre parent en un pool con un nombre creativo pool.
Por defecto, el punto de montaje del conjunto de datos será equivalente a su nombre en la jerarquía de ZFS, con una barra al principio: el pool llamado pool se montará como /pool, el conjunto de datos parent se montará en /pool/parent, y el conjunto de datos hijo child se montará en /pool/parent/child. Sin embargo, el punto de montaje del conjunto de datos puede ser cambiado.
Si especificamos zfs set mountpoint=/lol pool/parent/child, el conjunto de datos pool/parent/child se montará en el sistema como /lol.
Además de los conjuntos de datos, debemos mencionar los volúmenes (zvols). Un volumen es aproximadamente comparable a un conjunto de datos, excepto que en él realmente no hay un sistema de archivos: es solo un dispositivo de bloque. Puedes, por ejemplo, crear zvol llamado mypool/myzvol, luego formatearlo con un sistema de archivos ext4, y luego montar este sistema de archivos: ¡ahora tienes un sistema de archivos ext4, pero con soporte para todas las funciones de seguridad de ZFS! Puede parecer tonto en una computadora, pero tiene mucho más sentido como backend al exportar un dispositivo iSCSI.
Bloques
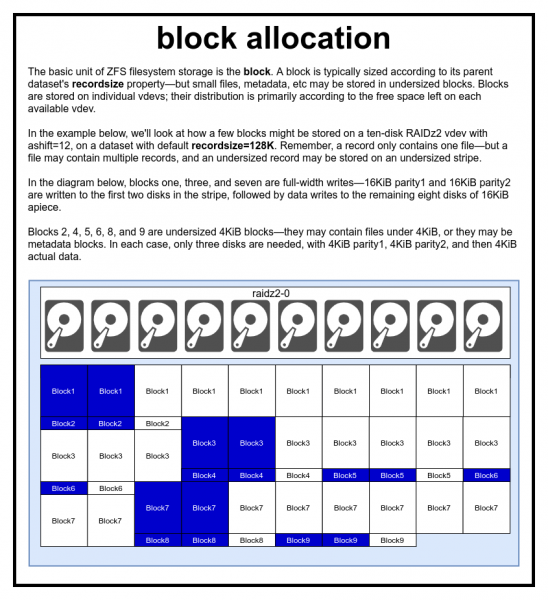
Un archivo se presenta como uno o varios bloques. Cada bloque se almacena en un dispositivo virtual. El tamaño del bloque generalmente es igual al parámetro recordsize, pero puede ser reducido a 2^ashift, si contiene metadatos o un archivo pequeño.
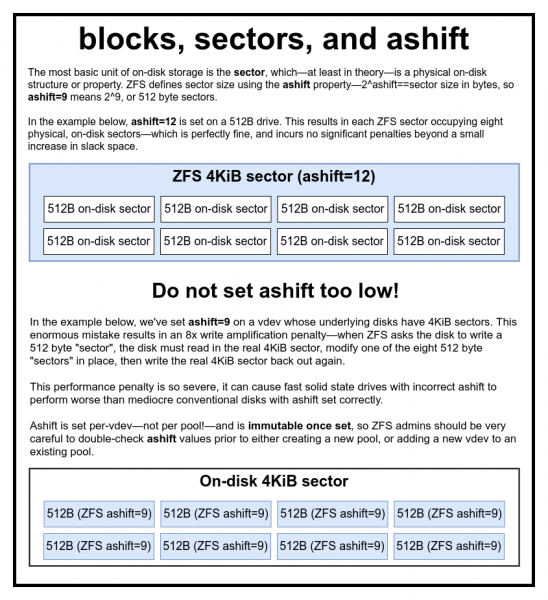
Realmente, realmente no estamos bromeando sobre el enorme daño al rendimiento si se establece un ashift demasiado pequeño.
En el grupo ZFS, todos los datos, incluidos los metadatos, se almacenan en bloques. El tamaño máximo del bloque para cada conjunto de datos se define en la propiedad recordsize (tamaño del registro). El tamaño del registro puede cambiar, pero esto no alterará el tamaño o la ubicación de cualquier bloque que ya haya sido escrito en el conjunto de datos; solo se aplica a nuevos bloques a medida que se escriben.
A menos que se indique lo contrario, el tamaño de registro actual por defecto es de 128 KiB. Es una especie de compromiso complicado, en el que el rendimiento no será ideal, pero tampoco será terrible en la mayoría de los casos. Tamaño del registro puede establecerse en cualquier valor de 4K a 1M (con configuraciones adicionales recordsize puede establecerse aún más grande, pero rara vez es una buena idea).
Cualquier bloque hace referencia solo a los datos de un único archivo; no puedes encajar dos archivos diferentes en un solo bloque. Cada archivo consiste en uno o varios bloques, dependiendo de su tamaño. Si el tamaño del archivo es menor que el tamaño del registro, se almacenará en un bloque de menor tamaño; por ejemplo, un bloque con un archivo de 2 KiB ocupará solo un sector de 4 KiB en el disco.
Si el archivo es lo suficientemente grande y requiere varios bloques, entonces todos los registros de ese archivo tendrán un tamaño recordsize — incluyendo el último registro, cuya mayor parte puede resultar ser .
Los volúmenes zvol no tienen la propiedad recordsize — en su lugar tienen una propiedad equivalente volblocksize..
Sectores
El último y más básico bloque de construcción es el sector. Esta es la unidad física más pequeña que se puede escribir o leer desde un dispositivo base. Durante varias décadas, la mayoría de los discos han utilizado sectores de 512 bytes. Recientemente, la mayoría de los discos están configurados para sectores de 4 KiB, y algunos, especialmente SSD, tienen sectores de 8 KiB o incluso más.
En el sistema ZFS, hay una propiedad que permite establecer manualmente el tamaño del sector. Esta propiedad ashift. Es algo confuso que ashift sea una potencia de dos. Por ejemplo, ashift=9 significa un tamaño de sector de 2^9, o 512 bytes.
ZFS solicita al sistema operativo información detallada sobre cada dispositivo de bloque cuando se añade a un nuevo vdev, y teóricamente establece ashift automáticamente según esta información. Desafortunadamente, muchos discos proporcionan información incorrecta sobre su tamaño de sector para mantener la compatibilidad con Windows XP (que no podía entender discos con otros tamaños de sectores).
Esto significa que se recomienda encarecidamente al administrador de ZFS conocer el tamaño real de sector de sus dispositivos y establecerlo manualmente. ashift. Si ashift se establece demasiado bajo, se incrementa de forma astronómica la cantidad de operaciones de lectura/escritura. Así, escribir "sectores" de 512 bytes en un sector real de 4 KiB implica primero escribir el primer "sector", luego leer el sector de 4 KiB, modificarlo con el segundo "sector" de 512 bytes, volver a escribirlo en el nuevo sector de 4 KiB y así sucesivamente para cada escritura.
En el mundo real, esta penalización afecta a los SSD Samsung EVO, para los cuales debería aplicarse ashift=13, pero estos SSD informan incorrectamente sobre su tamaño de sector, y por lo tanto se establece por defecto ashift=9. Si un administrador del sistema experimentado no cambia esta configuración, este SSD funcionará más lentamente que un HDD magnético normal.
En comparación, un tamaño demasiado grande ashift prácticamente no tiene ninguna penalización. No hay una disminución real en el rendimiento, y el aumento del espacio no utilizado es infinitesimal (o nulo cuando la compresión está habilitada). Por ello, recomendamos encarecidamente que incluso aquellos discos que realmente usan sectores de 512 bytes, configuren ashift=12 o incluso ashift=13, para mirar con confianza hacia el futuro.
Propiedad ashift se establece para cada dispositivo virtual vdev, y no para el pool, como muchos piensan erróneamente, y no se cambia después de la configuración. Si accidentalmente lo alteras ashift al agregar un nuevo vdev al pool, habrás contaminado irremediablemente este pool con un dispositivo de bajo rendimiento y, por lo general, no hay otra opción que destruir el pool y comenzar desde cero. Incluso eliminar el vdev no salvará de la configuración incorrecta. ashift!
El mecanismo de copia al escribir
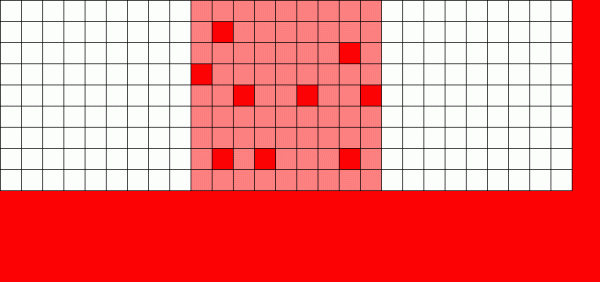
Si a un sistema de archivos normal necesita reescribir datos, modifica cada bloque donde se encuentra.
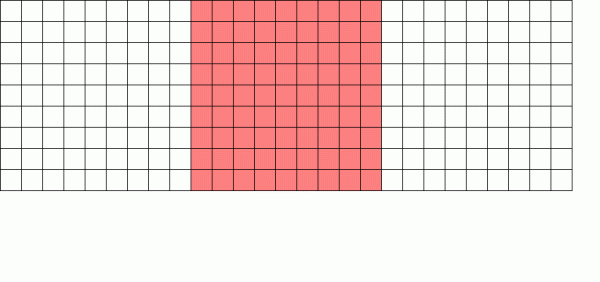
El sistema de archivos con copia al escribir guarda una nueva versión del bloque y luego desbloquea la versión antigua.
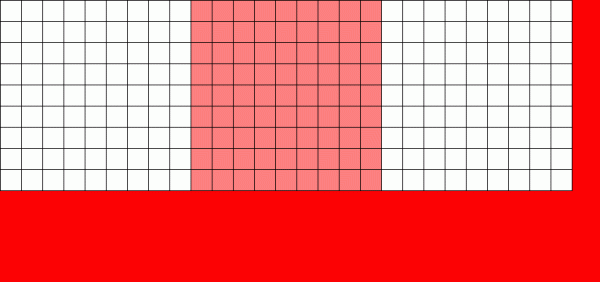
En términos abstractos, si ignoramos la ubicación física real de los bloques, nuestra 'cometa de datos' se simplifica a un 'gusano de datos' que se mueve de izquierda a derecha por el mapa del espacio disponible.
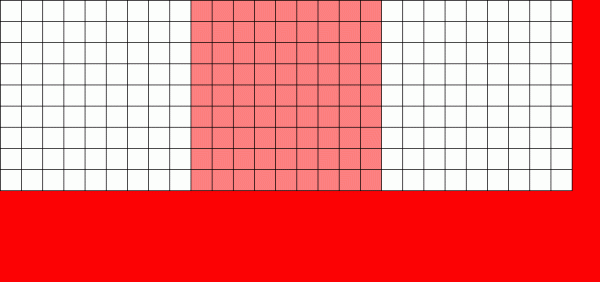
Ahora podemos tener una buena idea de cómo funcionan los snapshots de copia al escribir: cada bloque puede pertenecer a varios snapshots y se conservará hasta que se destruyan todos los snapshots asociados.
El mecanismo de copia al escribir (Copy on Write, CoW) es la base fundamental de lo que hace que ZFS sea un sistema tan impresionante. El concepto básico es simple: si le pides a un sistema de archivos tradicional que cambie un archivo, hará exactamente lo que pediste. Si le pides a un sistema de archivos con copia al escribir que haga lo mismo, dirá 'está bien' pero te mentirá.
En lugar de eso, el sistema de archivos con copia al escribir guarda una nueva versión del bloque modificado y luego actualiza los metadatos del archivo para romper la conexión con el bloque antiguo y asociar el nuevo bloque que acabas de guardar.
La desconexión del bloque antiguo y la asociación del nuevo se realiza en una sola operación, por lo que no se puede interrumpir: si apagas la alimentación después de que ocurra, tienes una nueva versión del archivo, y si apagas la alimentación antes, tienes la versión antigua. En cualquier caso, no habrá conflictos en el sistema de archivos.
La copia al escribir en ZFS ocurre no solo a nivel de sistema de archivos, sino también a nivel de gestión de discos. Esto significa que ZFS no es susceptible a los huecos de escritura () — un fenómeno en el que la franja solo se escribió parcialmente antes de un fallo del sistema, dañando el arreglo después del reinicio. Aquí, la franja se escribe de manera atómica, el vdev siempre es coherente, y .
ZIL: el diario de intenciones de ZFS
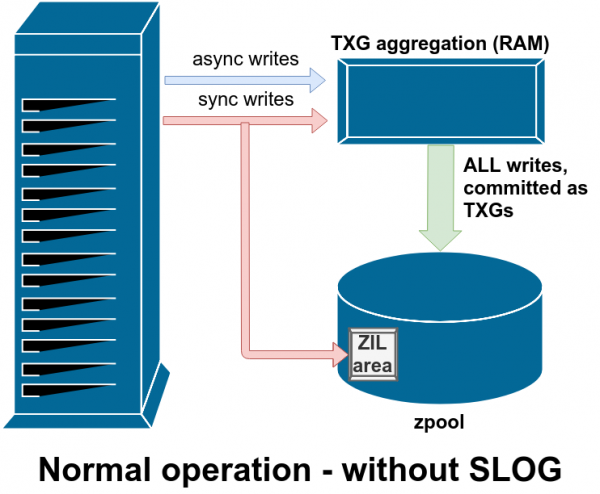
El sistema ZFS maneja las escrituras síncronas de una manera especial: las guarda temporalmente, pero inmediatamente en el ZIL, antes de escribirlas permanentemente junto con las escrituras asíncronas.
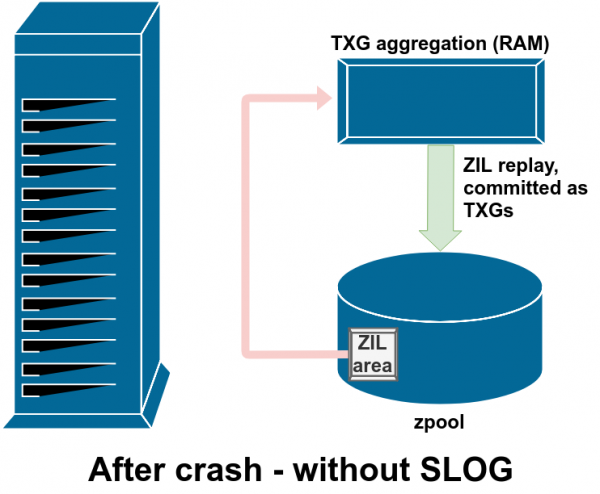
Normalmente, los datos escritos en el ZIL nunca se vuelven a leer. Pero esto es posible después de un fallo del sistema.
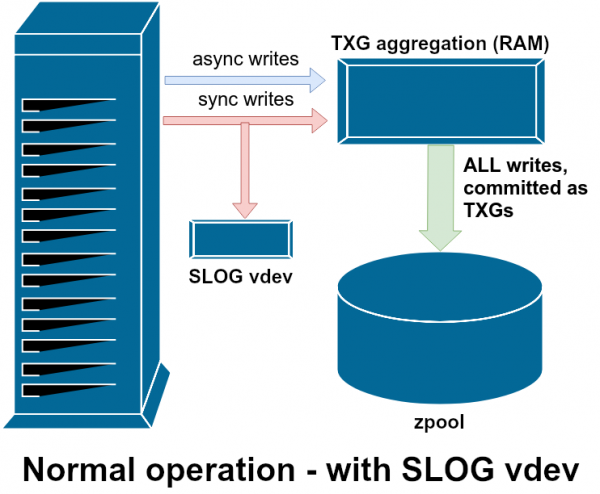
SLOG, o dispositivo LOG secundario, es simplemente un vdev especial — y, preferiblemente, muy rápido — donde ZIL puede almacenarse por separado del almacenamiento principal.
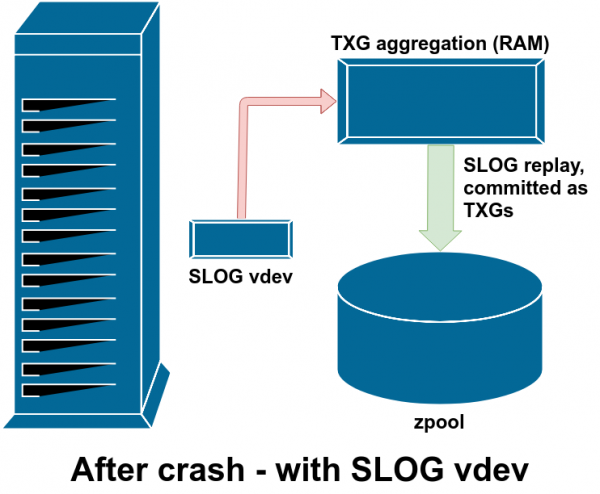
Después de un fallo, todos los datos sucios en ZIL se reproducen — en este caso, ZIL se encuentra en SLOG, así que se reproducen desde allí.
Existen dos categorías principales de operaciones de escritura: sincrónicas (sync) y asincrónicas (async). Para la mayoría de las cargas de trabajo, la gran mayoría de las operaciones de escritura son asincrónicas — el sistema de archivos permite agregarlas y emitirlas en paquetes, reduciendo la fragmentación y aumentando significativamente el ancho de banda.
Las escrituras sincrónicas son algo completamente diferente. Cuando una aplicación solicita una escritura sincrónica, le dice al sistema de archivos: «Necesitas registrar esto en la memoria no volátil, este mismo momento, y hasta entonces no puedo hacer nada más». Por lo tanto, las escrituras sincrónicas deben registrarse inmediatamente en el disco — y si esto aumenta la fragmentación o reduce el ancho de banda, así sea.
ZFS maneja las escrituras sincrónicas de manera diferente a los sistemas de archivos convencionales — en lugar de verterlas inmediatamente en el almacenamiento normal, ZFS las registra en un área de almacenamiento especial llamada ZFS Intent Log, o ZIL. La clave es que estas escrituras también permanecen en memoria, siendo agregadas junto con las solicitudes de escritura asincrónicas normales, para ser luego volcadas en el almacenamiento como grupos de transacciones (TXG, Transaction Groups) completamente normales.
En condiciones normales de operación, ZIL se escribe y nunca se lee nuevamente. Cuando después de unos momentos las escrituras de ZIL se registran en el almacenamiento principal dentro de los TXG normales desde la memoria, se desconectan de ZIL. La única vez que algo se lee de ZIL es durante la importación de un pool.
Si ocurre un fallo en ZFS — fallo del sistema operativo o corte de energía — cuando hay datos en ZIL, estos datos se leerán durante la próxima importación del pool (por ejemplo, al reiniciar un sistema de recuperación). Todo lo que está en ZIL se leerá, se combinará en grupos TXG, se registrará en el almacenamiento principal y luego se desconectará de ZIL durante el proceso de importación.
Una de las clases auxiliares de vdev se llama LOG o SLOG, que es un dispositivo secundario LOG. Su tarea es proporcionar al pool un dispositivo vdev separado y, preferiblemente, mucho más rápido, con una alta resistencia a la escritura, para almacenar ZIL, en lugar de almacenar ZIL en el almacenamiento principal del vdev. El propio ZIL se comporta de la misma manera independientemente de dónde se almacena, pero si el vdev con LOG tiene un rendimiento de escritura muy alto, las escrituras sincrónicas sucederán más rápido.
Agregar un vdev con LOG al pool no puede mejorar el rendimiento de la escritura asincrónica, incluso si obligas a todas las escrituras en ZIL usando zfs set sync=always, seguirán atadas al almacenamiento principal en TXG de la misma forma y al mismo ritmo que sin el registro. La única mejora directa en el rendimiento es la latencia de la escritura sincrónica (ya que una velocidad de registro mayor acelera la ejecución de las operaciones sync).
Sin embargo, en un entorno que ya requiere una gran cantidad de escrituras sincrónicas, el vdev LOG puede acelerar indirectamente la escritura asincrónica y la lectura no en caché. Descargar las escrituras ZIL en un vdev LOG separado significa menos competencia por IOPS en el almacenamiento primario, lo que en cierta medida mejora el rendimiento de todas las operaciones de lectura y escritura.
Instantáneas
El mecanismo de copia en escritura también es una base necesaria para las instantáneas atómicas de ZFS y la replicación asincrónica incremental. En un sistema de archivos activo, hay un árbol de punteros que marca todas las escrituras con los datos actuales; cuando haces una instantánea, simplemente haces una copia de este árbol de punteros.
Cuando se sobrescribe una escritura en un sistema de archivos activo, ZFS primero escribe la nueva versión del bloque en el espacio no utilizado. Luego desvincula la antigua versión del bloque del sistema de archivos actual. Pero si alguna instantánea hace referencia al antiguo bloque, este sigue siendo inalterado. ¡El bloque antiguo no se recuperará realmente como espacio libre hasta que se destruyan todas las instantáneas que referencian ese bloque!
Replicación
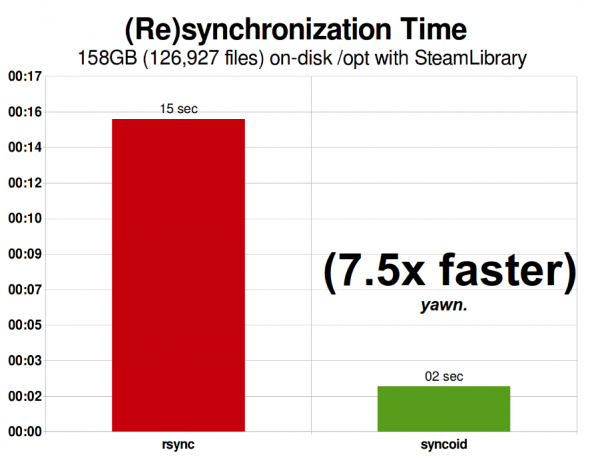
Mi biblioteca de Steam en 2015 ocupaba 158 GiB y contenía 126,927 archivos. Esto está bastante cerca de la situación óptima para rsync; la replicación ZFS a través de la red fue «solo» un 750% más rápida.
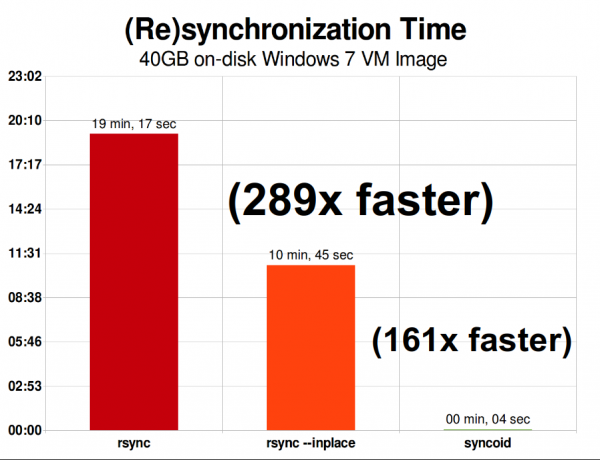
En la misma red, la replicación de un archivo de imagen de máquina virtual de 40 gigabytes de Windows 7 es una historia completamente diferente. La replicación de ZFS ocurre 289 veces más rápido que rsync, o "solo" 161 veces más rápido si sabe lo suficiente como para llamar a rsync con la opción --inplace.
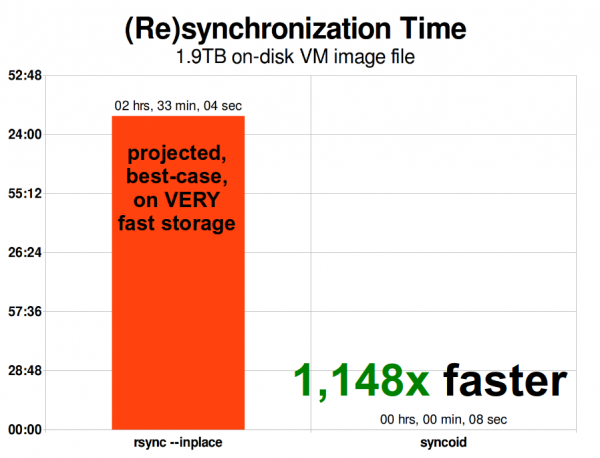
Cuando la imagen de la máquina virtual se escala, los problemas de rsync también escalan con ella. Un tamaño de 1,9 TiB no es tan grande para una imagen de máquina virtual moderna, pero es lo suficientemente grande como para que la replicación de ZFS sea 1148 veces más rápida que rsync, incluso con el argumento de rsync --inplace.
Una vez que comprenda cómo funcionan las instantáneas, no será difícil captar la esencia de la replicación. Dado que una instantánea es simplemente un árbol de punteros a registros, se deduce que si hacemos zfs send de la instantánea, estamos enviando tanto este árbol como todos los registros asociados. Cuando transmitimos esto a zfs send en zfs receive en el objeto de destino, escribe tanto el contenido real del bloque como el árbol de punteros que referencia los bloques en el conjunto de datos de destino.
Las cosas se vuelven aún más interesantes en el segundo zfs send. Ahora tenemos dos sistemas, cada uno conteniendo poolname/datasetname@1, mientras toma una nueva instantánea poolname/datasetname@2. Por lo tanto, en el pool original tiene datasetname@1 y datasetname@2, mientras que en el pool de destino solo hay la primera instantánea por el momento. datasetname@1.
Dado que entre la fuente y el destino tenemos una instantánea compartida datasetname@1, podemos hacer un incremental zfs send sobre ella. Cuando le decimos al sistema zfs send -i poolname/datasetname@1 poolname/datasetname@2, compara los dos árboles de punteros. Cualquier puntero que exista solo en @2, evidentemente, apunta a nuevos bloques, por lo que necesitaremos el contenido de esos bloques.
En el sistema remoto, el proceso incremental send es igual de sencillo. Primero, escribimos todos los nuevos registros incluidos en el flujo send, y luego añadimos punteros a esos bloques. Voilà, tenemos @2 en el nuevo sistema!
La replicación incremental asíncrona de ZFS es una gran mejora respecto a los métodos anteriores que no se basaban en instantáneas, como rsync. En ambos casos, se transfieren solo los datos modificados, pero rsync debe primero leer desde el disco todos los datos desde ambos lados, para verificar el checksum y compararlo. A diferencia de esto, la replicación ZFS no lee nada excepto los árboles de punteros y cualquier bloque que no esté presente en el snapshot compartido.
Compresión integrada
El mecanismo de escritura también simplifica el sistema de compresión integrada. En un sistema de archivos tradicional, la compresión es problemática: tanto la versión antigua como la nueva de los datos modificados residen en el mismo espacio.
Si consideramos un fragmento de datos en medio del archivo, que comienza su vida como un megabyte de ceros desde 0x00000000 y así sucesivamente, se puede comprimir fácilmente a un solo sector en el disco. Pero ¿qué pasará si reemplazamos este megabyte de ceros por un megabyte de datos no comprimibles, como JPEG o ruido pseudoaleatorio? Sorprendentemente, este megabyte de datos requerirá no uno, sino 256 sectores de 4 KiB, mientras que en este lugar del disco solo se ha reservado un sector.
ZFS no tiene tal problema, ya que las escrituras modificadas siempre se registran en el espacio no utilizado: el bloque original ocupa solo un sector de 4 KiB, y la nueva escritura ocupará 256, pero esto no es un problema, ya que el fragmento "medio" del archivo recientemente modificado se habría registrado en el espacio no utilizado independientemente de si su tamaño ha cambiado o no, por lo que para ZFS esto es una situación bastante normal.
La compresión integrada de ZFS está desactivada por defecto, y el sistema ofrece algoritmos conectables: actualmente entre ellos están LZ4, gzip (1-9), LZJB y ZLE.
- LZ4 es un algoritmo de flujo que ofrece una compresión y descompresión extremadamente rápidas y una mejora en el rendimiento para la mayoría de los casos de uso, incluso en CPUs bastante lentos.
- GZIP es un algoritmo venerable que todos los usuarios de sistemas Unix conocen y aman. Se puede implementar con niveles de compresión de 1 a 9, con un aumento en el grado de compresión y uso de CPU a medida que se acerca al nivel 9. El algoritmo es adecuado para todas las variantes de uso de texto (u otros tipos de datos extremadamente comprimibles), pero de lo contrario a menudo presenta problemas con la CPU; úsalo con precaución, especialmente en niveles más altos.
- LZJB es el algoritmo original en ZFS. Está obsoleto y ya no debería usarse, LZ4 lo supera en todos los aspectos.
- ZLE — codificación de nivel cero, Zero Level Encoding. En general, no afecta a los datos normales, pero comprime grandes secuencias de ceros. Es útil para conjuntos de datos completamente no comprimibles (como JPEG, MP4 u otros formatos ya comprimidos), ya que ignora los datos no comprimibles, pero comprime el espacio no utilizado en los registros finales.
Recomendamos la compresión LZ4 para prácticamente todos los casos de uso; la penalización por rendimiento al encontrarse con datos no comprimibles es muy baja, y aumento de rendimiento para datos típicos es considerable. La copia de una imagen de máquina virtual para una nueva instalación del sistema operativo Windows (sistema operativo recién instalado, sin datos dentro aún) con compression=lz4 se realizó un 27% más rápido que con compression=none, en .
ARC — caché de reemplazo adaptativo
ZFS es el único sistema de archivos moderno que conocemos que utiliza su propio mecanismo de caché de lectura, en lugar de depender de la caché de páginas del sistema operativo para almacenar copias de bloques recientemente leídos en la memoria RAM.
Aunque la caché propia no está exenta de problemas: ZFS no puede responder a nuevas solicitudes de asignación de memoria tan rápido como el núcleo, por lo que una nueva solicitud malloc() de asignación de memoria puede fallar si necesita la memoria RAM actualmente ocupada en ARC. Pero hay razones de peso para usar una caché propia, al menos por ahora.
Todos los sistemas operativos modernos conocidos, incluyendo MacOS, Windows, Linux y BSD, utilizan el algoritmo LRU (Least Recently Used) para implementar la caché de páginas. Este es un algoritmo primitivo que eleva el bloque en caché "hacia arriba en la cola" después de cada lectura y desalojar bloques "hacia abajo en la cola" según sea necesario para agregar nuevos fallos de caché (bloques que debían ser leídos desde el disco, no desde la caché) hacia arriba.
Por lo general, el algoritmo funciona bien, pero en sistemas con grandes conjuntos de datos de trabajo, LRU puede fácilmente llevar a thrashing: desalojar bloques que se necesitan con frecuencia para liberar espacio para bloques que nunca se volverán a leer desde la caché.
— un algoritmo mucho menos ingenuo que puede considerarse como un caché "ponderado". Después de cada lectura de un bloque en caché, se vuelve un poco más "pesado" y es más difícil de desalojar; incluso después de ser despejado, el bloque es rastreado durante un período de tiempo determinado. Un bloque que ha sido desalojado, pero que luego debe ser leído de nuevo en la caché, también se volverá "más pesado".
El resultado final de todo esto es una caché con una tasa de aciertos (hit ratio) mucho mayor, que es la relación entre aciertos en caché (lecturas realizadas desde la caché) y fallos (lecturas desde el disco). Esta es una estadística extremadamente importante; no solo los hits en la caché se manejan órdenes de magnitud más rápido, sino que los fallos en la caché también pueden ser atendidos más rápido, ya que cuántos más hits hay en la caché, menos solicitudes paralelas hay al disco y menor es la latencia para aquellos fallos restantes que deben ser atendidos desde el disco.
Conclusión
Después de estudiar la semántica básica de ZFS — cómo funciona la copia al escribir, así como las relaciones entre pools de almacenamiento, dispositivos virtuales, bloques, sectores y archivos — estamos listos para discutir el rendimiento real con números reales.
En la siguiente parte, examinaremos el rendimiento real de los pools con vdev en espejo y RAIDz, unos en comparación con otros, así como en comparación con las topologías RAID tradicionales del núcleo de Linux que hemos explorado. .
Al principio, solo queríamos considerar lo básico: las propias topologías de ZFS; pero después de eso estaremos listos para hablar sobre configuración avanzada y ajuste de ZFS, incluyendo el uso de tipos auxiliares de vdev, como L2ARC, SLOG y Special Allocation.
Fuente: habr.com
