

SQL, ¿qué puede ser más simple? Cada uno de nosotros puede escribir una consulta sencilla: simplemente introducimos select, enumeramos las columnas necesarias, luego from, el nombre de la tabla, un poco de condiciones en donde y listo: tenemos los datos útiles en nuestro bolsillo, (casi) sin importar qué SGBD esté funcionando en el fondo (o tal vez no sea ). Como resultado, trabajar prácticamente con cualquier fuente de datos (relacional o no) se puede considerar desde la perspectiva de código común (con todas las implicaciones: control de versiones, revisión de código, análisis estático, pruebas automáticas, y todo eso). Y no solo se refiere a los propios datos, esquemas y migraciones, sino a toda la vida del almacén. En este artículo, hablaremos sobre las tareas cotidianas y los problemas en el trabajo con varias bases de datos bajo el enfoque de "database as code".
Y empecemos directamente con . Las primeras batallas del tipo "SQL vs ORM" se observaron ya en .
Mapeo objeto-relacional
Los partidarios de ORM valoran tradicionalmente la velocidad y la simplicidad del desarrollo, la independencia del SGBD y la limpieza del código. Para muchos de nosotros, el código que interactúa con la base de datos (y a menudo la propia base de datos)
generalmente se ve algo así...
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
El modelo está adornado con inteligentes anotaciones, y en algún lugar detrás de escena, el valiente ORM genera y ejecuta toneladas de SQL. Cabe mencionar que los desarrolladores intentan protegerse de su base de datos con kilómetros de abstracciones, lo que sugiere una cierta .
Por otro lado, los defensores del "SQL hecho a mano" destacan la posibilidad de exprimir todo el jugo de su SGBD sin capas y abstracciones adicionales. Como resultado, surgen proyectos "centrados en datos", donde una persona especialmente entrenada (ellos mismos son "básicos", "baseadores", "basteadores", etc.) se encarga de la base, y a los desarrolladores solo les queda "extraer" las vistas y los procedimientos almacenados listos, sin entrar en detalles.
¿Y qué tal si tomamos lo mejor de ambos mundos? Como se hace en la maravillosa herramienta con un nombre positivo . Permítanme citar un par de líneas de la idea general en mi traducción libre, y en más detalle se puede familiarizarse con ella. .
Clojure es un gran lenguaje para crear DSLs, pero SQL ya es en sí mismo un gran DSL, y no necesitamos otro. Las S-expr son maravillosas, pero aquí no aportan nada nuevo. Al final, solo obtenemos paréntesis por el hecho de tener paréntesis. ¿No estás de acuerdo? Entonces espera a que la abstracción sobre la base de datos falle y empieces a luchar con la función. (raw-sql)
¿Y qué hacer? Dejemos SQL como SQL: un archivo para cada consulta:
-- name: users-by-country
select *
  from users
 where country_code = :country_code
… y luego lee este archivo, convirtiéndolo en una función normal de Clojure:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Se ha creado una función con el nombre `users-by-country`.
;;; Vamos a usarla:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Siguiendo el principio de "SQL por separado, Clojure por separado", obtienes:
- Sin sorpresas sintácticas. Tu base de datos (como cualquier otra) no se ajusta al estándar SQL al 100% — pero para Yesql no es importante. Nunca perderás tiempo buscando funciones con una sintaxis equivalente a SQL. Nunca tendrás que volver a la función. (raw-sql "some (‘funky’ :: SYNTAX)")).
- Mejor soporte del editor. Tu editor ya tiene excelente soporte para SQL. Al mantener SQL como SQL, puedes simplemente usarlo.
- Compatibilidad de equipo. Tus DBA pueden leer y escribir SQL que utilizas en tu proyecto de Clojure.
- Configuración de rendimiento más sencilla. ¿Necesitas construir un plan para una consulta problemática? No es un problema cuando tu consulta es SQL común.
- Reutilización de consultas. Lleva esos mismos archivos SQL a otros proyectos, porque es solo el viejo buen SQL — simplemente compártelo.
Para mí, la idea es muy genial y además muy simple, lo que ha hecho que el proyecto adquiera popularidad en muchos idiomas diferentes. A continuación, intentaremos aplicar una filosofía similar separando el código SQL de todo lo demás, muy lejos de ORM.
IDE & DB-gestores
Comencemos con una tarea cotidiana sencilla. A menudo necesitamos buscar algunos objetos en la base de datos, por ejemplo, encontrar una tabla en un esquema y estudiar su estructura (qué columnas, claves, índices, restricciones y demás se utilizan). Y de cualquier IDE gráfico o de un DB-manager básico, esperamos principalmente estas capacidades. Para que sea rápido y no tengamos que esperar media hora hasta que se dibuje la ventana con la información necesaria (especialmente con una conexión lenta a una base de datos remota), y además, para que la información obtenida sea fresca y actual, y no un caché obsoleto. De hecho, cuanto más compleja y grande es la base de datos y mayor es su cantidad, más difícil es hacerlo.
Pero normalmente dejo el ratón a un lado y simplemente escribo código. Supongamos que necesitamos saber qué tablas (y con qué propiedades) están en el esquema 'HR'. En la mayoría de los sistemas de gestión de bases de datos, se puede obtener el resultado deseado con una simple consulta de information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
De base de datos a base de datos, el contenido de estas tablas de referencia varía dependiendo de las capacidades de cada sistema de gestión de bases de datos. Y, por ejemplo, para MySQL de este mismo directorio se pueden obtener parámetros específicos de esta base de datos:
select table_name
     , storage_engine -- El 'motor' utilizado ('MyISAM', 'InnoDB' etc)
     , row_format     -- El formato de la fila ('Fixed', 'Dynamic' etc)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle no tiene information_schema, pero tiene , y no surgen grandes problemas:
select table_name
     , pct_free       -- Mínimo espacio libre en el bloque de datos (%)
     , pct_used       -- Mínimo espacio usado en el bloque de datos (%)
     , last_analyzed  -- Fecha de la última recopilación de estadísticas
     , ...
  from all_tables
 where owner = 'HR'
ClickHouse no es una excepción:
select name
     , engine -- El 'motor' utilizado ('MergeTree', 'Dictionary' etc)
     , ...
  from system.tables
 where database = 'HR'
Algo similar se puede hacer en Cassandra (donde hay columnfamilies en lugar de tablas y keyspaces en lugar de esquemas):
select columnfamily_name
     , compaction_strategy_class  -- Estrategia de recolección de basura
     , gc_grace_seconds           -- Tiempo de vida de la basura
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Para la mayoría de las otras bases de datos, también se pueden inventar consultas similares (incluso en Mongo hay , que contiene información sobre todas las colecciones en el sistema).
Por supuesto, de esta manera se puede obtener información no solo sobre las tablas, sino sobre cualquier objeto en general. Periodicamente, personas amables comparten dicho código para diferentes bases de datos, como por ejemplo en la serie de artículos de Habr "Funciones para documentar bases de datos PostgreSQL" (, , ). Por supuesto, mantener toda esta montaña de consultas en la cabeza y escribirlas constantemente no es un placer "tan genial", así que en mi IDE/editor favorito tengo un conjunto de fragmentos preparados para las consultas más utilizadas, y solo queda introducir los nombres de los objetos en la plantilla.
Al final, este método de navegación y búsqueda de objetos es mucho más flexible, ahorra mucho tiempo y permite obtener exactamente la información y en el formato que se necesita en ese momento (como se describe, por ejemplo, en la publicación ).
Operaciones con objetos
Después de que hemos encontrado y estudiado los objetos necesarios, es momento de hacer algo útil con ellos. Naturalmente, sin quitar los dedos del teclado.
No es un secreto que la simple eliminación de una tabla se verá prácticamente igual en todas las bases de datos:
drop table hr.personsSin embargo, crear una tabla es algo más interesante. Prácticamente cualquier SGBD (incluyendo muchos NoSQL) puede 'create table' de alguna manera, y la mayor parte de su sintaxis no diferirá mucho (nombre, lista de columnas, tipos de datos), pero los demás detalles pueden variar drásticamente y dependen de la estructura interna y las capacidades de cada SGBD en particular. Mi ejemplo favorito es que en la documentación de Oracle solo las 'BNF' desnudas para la sintaxis 'create table' . Otros SGBD tienen capacidades más modestas, pero cada uno también posee muchas características interesantes y únicas para la creación de tablas (, , , ). Es poco probable que algún 'wizard' gráfico de otra IDE (especialmente si es universal) pueda cubrir completamente todas estas capacidades, y si lo logra, será un espectáculo no apto para cardíacos. Al mismo tiempo, un operador bien escrito y a tiempo create table permitirá utilizar todas ellas sin esfuerzo, haciendo que el almacenamiento y el acceso a tus datos sean confiables, óptimos y lo más cómodos posible.
También en muchas bases de datos hay tipos de objetos específicos que no están presentes en otras bases de datos. Además, podemos realizar operaciones no solo sobre los objetos de la base de datos, sino también sobre la propia base de datos, como "matar" un proceso, liberar una área de memoria, activar el seguimiento, cambiar al modo "solo lectura" y mucho más.
Y ahora, un poco de dibujo
Una de las tareas más comunes es construir un diagrama con los objetos de la base de datos, ver en una imagen bonita los objetos y las relaciones entre ellos. Casi cualquier IDE gráfico es capaz de hacerlo, así como algunas utilidades de línea de comandos, herramientas gráficas especializadas y modeladores. Ellos dibujarán algo "como saben", y un poco de influencia en este proceso solo se puede lograr mediante algunos parámetros en el archivo de configuración o marcando opciones en la interfaz.
Pero este problema se puede resolver de manera mucho más sencilla, flexible y elegante, y por supuesto, con la ayuda de código. Para la construcción de diagramas de cualquier complejidad, tenemos varios lenguajes de marcado especializados (DOT, GraphML, etc.), y con ellos, una gran variedad de aplicaciones (GraphViz, PlantUML, Mermaid) que pueden leer estas instrucciones y visualizarlas en diferentes formatos. Bueno, y ya sabemos cómo obtener la información sobre los objetos y las relaciones entre ellos.
Daremos un pequeño ejemplo de cómo podría verse esto, utilizando PlantUML y (a la izquierda la consulta SQL que generará la instrucción necesaria para PlantUML, y a la derecha el resultado):
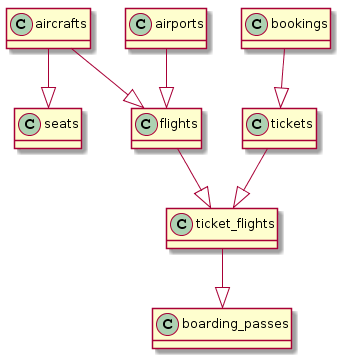
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
Y si nos esforzamos un poco, a partir de podemos obtener algo que se asemeje mucho a un verdadero diagrama ER:
La consulta SQL un poco más compleja
-- Encabezado
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tablas
select format('Table(%s, "%s n información sobre %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Relaciones entre tablas
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "Un %s puede tener muchos %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Pie
select '@enduml' 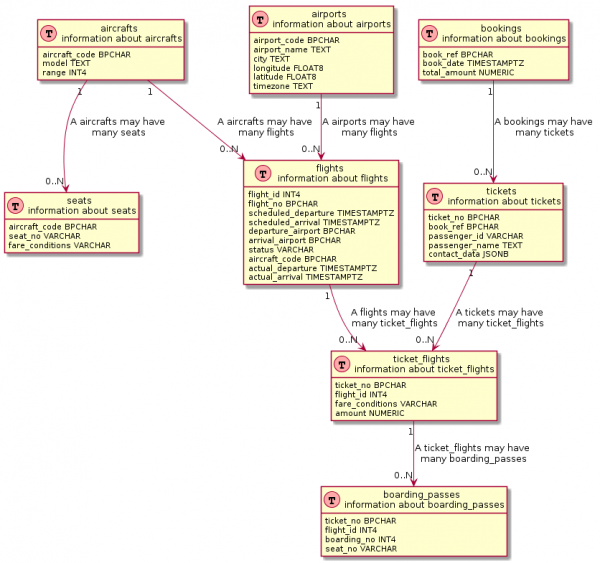
Si se observa atentamente, muchos herramientas de visualización también utilizan consultas similares bajo el capó. Sin embargo, estas consultas suelen estar profundamente , sin mencionar cualquier modificación que se les pudiera hacer.
Métricas y monitoreo
Pasemos a un tema tradicionalmente complicado: el monitoreo del rendimiento de bases de datos. Recordaré una pequeña historia verdadera que me contó "un amigo mío". En un proyecto, había un poderoso DBA del cual pocos desarrolladores conocían personalmente y ni siquiera habían visto alguna vez (a pesar de que, según rumores, trabajaba en un edificio vecino). En la hora "X", cuando el sistema de producción de un gran retail comenzaba a "sentirse mal" una vez más, él enviaba en silencio capturas de pantalla de gráficos del Oracle Enterprise Manager, donde destacaba con un marcador rojo los puntos críticos para "mayor claridad" (lo cual, dicho sea de paso, ayudaba muy poco). Así que había que basarse en esta "fotografía" para solucionar los problemas. Nadie tenía acceso al valioso (en ambos sentidos de la palabra) Enterprise Manager, ya que el sistema era complicado y caro, temían que si los "desarrolladores tocaban algo, todo podría romperse". Por lo tanto, los desarrolladores encontraban empíricamente el lugar y la causa de los delays y lanzaban un parche. Si la temida carta del DBA no llegaba de nuevo en poco tiempo, todos respiraban aliviados y volvían a sus tareas actuales (hasta la nueva carta).
Pero el proceso de monitoreo puede ser mucho más divertido y amigable, y lo más importante: accesible y transparente para todos. Al menos la parte básica, como complemento a los sistemas de monitoreo principales (que son indudablemente útiles e irremplazables en muchos casos). Cualquier SGBD está preparado para compartir de forma gratuita información sobre su estado actual y rendimiento. En la misma "sangrienta" Oracle DB, prácticamente cualquier información de rendimiento se puede obtener de las vistas del sistema, desde procesos y sesiones hasta el estado de la caché de búfer (por ejemplo, , sección "Monitoreo"). En PostgreSQL también hay un montón de vistas del sistema para , en particular, algunas esenciales en la vida diaria de cualquier DBA, como , , . En MySQL, incluso hay un esquema separado creado para esto. . Y en Mongo, un agrega datos sobre el rendimiento en una colección del sistema .
Así, armado con algún recolector de métricas (Telegraf, Metricbeat, Collectd), que puede ejecutar consultas SQL personalizadas, un almacenamiento de estas métricas (InfluxDB, Elasticsearch, Timescaledb) y un visualizador (Grafana, Kibana), se puede obtener un sistema de monitoreo bastante ligero y flexible, que estará estrechamente integrado con otras métricas del sistema (obtenidas, por ejemplo, del servidor de aplicaciones, del sistema operativo, etc.). Como se hace, por ejemplo, en pgwatch2, donde se utiliza la combinación de InfluxDB + Grafana y un conjunto de consultas a las vistas del sistema, a las que también se pueden .
Total
Y esta es solo una lista aproximada de lo que se puede hacer con nuestra base de datos mediante código SQL convencional. Estoy seguro de que se pueden encontrar muchas más aplicaciones, escríbannos en los comentarios. La próxima vez hablaremos sobre cómo (y, lo más importante, por qué) automatizar todo esto e incorporarlo a su pipeline de CI/CD.
Fuente: habr.com
