

Hace seis meses — un servicio público para PostgreSQL.
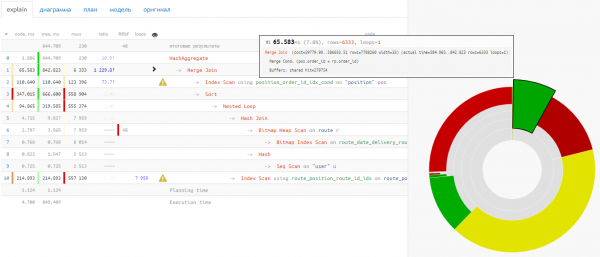
En los meses transcurridos hemos hecho un informe sobre él , preparamos un artículo resumen basado en las recomendaciones que proporciona... pero lo más importante es que recopilamos sus comentarios y observamos casos de uso reales.
Y ahora estamos listos para hablar sobre las nuevas funcionalidades que pueden utilizar.
Soporte para diferentes formatos de planes
Plan del registro, junto con la consulta
Directamente desde la consola, seleccionamos todo el bloque, comenzando desde la línea con Texto de la Consulta, con todos los espacios en blanco iniciales:
        Texto de la Consulta: INSERT INTO dicquery_20200604 VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insertar en dicquery_20200604 (costo=0.00..0.05 filas=1 ancho=52) (tiempo real=40.376..40.376 filas=0 bucles=1)
          Resolución de Conflictos: NADA
          Índices de Árbitro de Conflictos: dicquery_20200604_pkey
          Tuplas Insertadas: 1
          Tuplas en Conflicto: 0
          Buffers: hit compartido=9 leído=1 ensuciado=1
          ->  Resultado  (costo=0.00..0.05 filas=1 ancho=52) (tiempo real=0.001..0.001 filas=1 bucles=1)
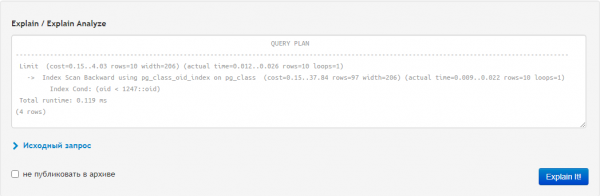
… y pegamos todo lo copiado directamente en el campo del plan, sin separar nada:
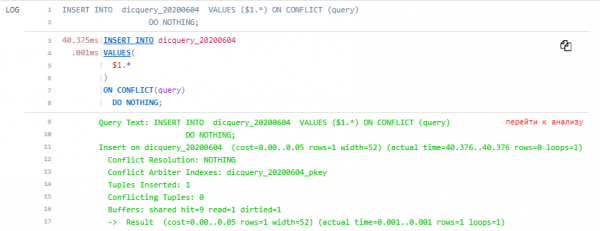
Al final obtenemos un extra en el plan desglosado además de la pestaña «contexto», donde nuestra consulta se presenta en todo su esplendor:
JSON y YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
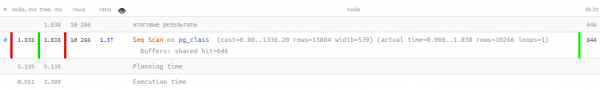
]"Ya sea con comillas externas, como copia pgAdmin, o sin ellas: pegamos en el mismo campo, y al final — ¡belleza!
Visualización Mejorada
Tiempo de Planificación / Tiempo de Ejecución
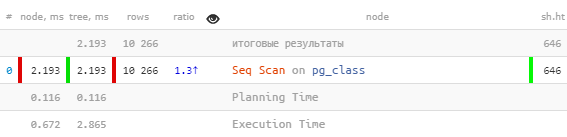
Ahora se puede ver mejor a dónde se fue el tiempo adicional al ejecutar la consulta:
Tiempo de I/O
A veces uno se enfrenta a situaciones en las que, en el plan, parece que no se leyeron o escribieron muchos recursos, pero el tiempo de ejecución es desproporcionadamente largo.
Aquí hay que decir: "Oh, probablemente en ese momento el disco en el servidor estaba sobrecargado, ¡por eso se leyó tan lento!" Pero eso no es muy preciso...
Pero se puede determinar de manera absolutamente confiable. La cuestión es que entre las opciones de configuración del servidor PG hay :
Incluye la medición del tiempo de las operaciones de entrada/salida. Este parámetro está deshabilitado por defecto, ya que requiere solicitar constantemente la hora actual al sistema operativo, lo que puede ralentizar significativamente el trabajo en algunas plataformas. Para evaluar el costo de medir el tiempo en su plataforma, puede utilizar la herramienta pg_test_timing. La estadística de entrada/salida se puede obtener a través de la vista pg_stat_database, en la salida de EXPLAIN (cuando se utiliza el parámetro BUFFERS) y a través de la vista pg_stat_statements.
Este parámetro se puede activar también en el contexto de una sesión local:
SET track_io_timing = TRUE;Y ahora lo más emocionante: hemos aprendido a entender y mostrar estos datos teniendo en cuenta todas las transformaciones del árbol de ejecución:
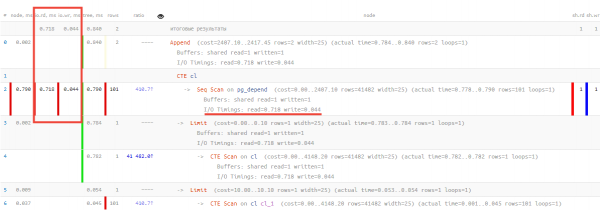
Aquí se puede notar que de 0.790 ms de tiempo de ejecución, 0.718 ms se dedicaron a leer una página de datos, 0.044 ms a escribirla, y todo el resto de la actividad útil consumió solo 0.028 ms.
El futuro con PostgreSQL 13
Puede consultar la revisión completa de las novedades , y nosotros específicamente sobre los cambios en los planes.
Planificación de buffers
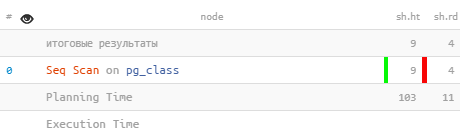
La consideración de los recursos asignados al planificador se reflejó en otro parche que no está relacionado con pg_stat_statements. EXPLAIN con la opción BUFFERS reportará la cantidad de buffers utilizados en la etapa de planificación:
 Seq Scan en pg_class (filas reales=386, bucles=1)
   Buffers: compartido aciertos=9 leído=4
 Tiempo de planificación: 0.782 ms
   Buffers: compartido aciertos=103 leído=11
 Tiempo de ejecución: 0.219 ms
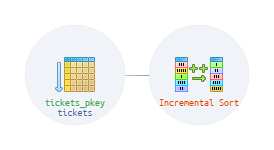
Ordenación incremental
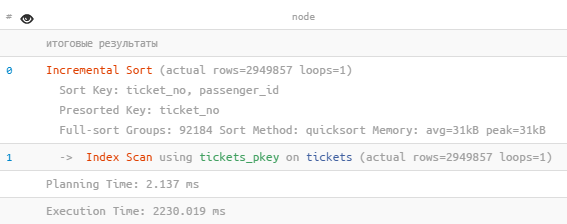
En casos donde se requiere ordenar por múltiples claves (k1, k2, k3…), el planificador ahora puede aprovechar el conocimiento de que los datos ya están ordenados por varias de las primeras claves (por ejemplo, k1 y k2). En este caso, no es necesario reordenar todos los datos desde cero, sino que se pueden dividir en grupos secuenciales con valores iguales de k1 y k2, y "completar" la ordenación por la clave k3.
De esta manera, toda la ordenación se descompone en varias ordenaciones secuenciales de menor tamaño. Esto reduce la cantidad de memoria necesaria y también permite obtener los primeros datos antes de que se complete toda la ordenación.
 Ordenación incremental (filas reales=2949857, bucles=1)
   Clave de ordenación: ticket_no, passenger_id
   Clave preordenada: ticket_no
   Grupos de orden completo: 92184 Método de ordenación: quicksort Memoria: avg=31kB peak=31kB
   ->  Escaneo de índice usando tickets_pkey en tickets (filas reales=2949857, bucles=1)
 Tiempo de planificación: 2.137 ms
 Tiempo de ejecución: 2230.019 ms
Mejoras en UI/UX
¡Capturas de pantalla, están por todas partes!
Ahora en cada pestaña hay una opción para tomar rápidamente una captura de pantalla de la pestaña en el portapapeles usando todo el ancho y la profundidad de la pestaña — el «mirador» en la parte superior derecha:
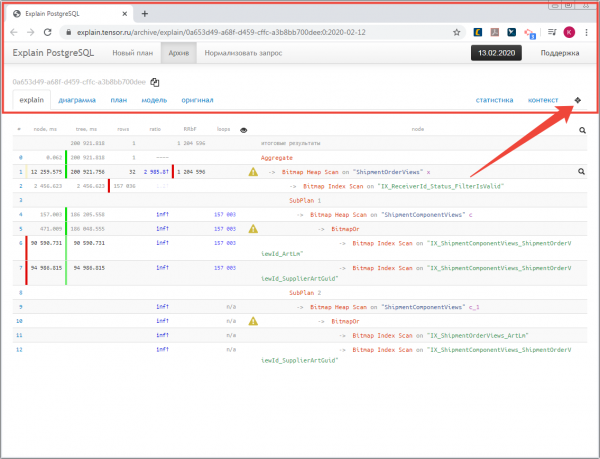
De hecho, la mayoría de las imágenes para esta publicación se obtuvieron precisamente así.
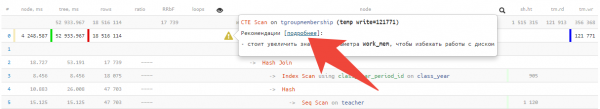
Recomendaciones en los nodos
No solo han aumentado en número, sino que se puede , accediendo al enlace:
Eliminación del archivo
Algunos pidieron mucho que se agregara la opción de eliminar completamente incluso los planes que no se publican en el archivo — por favor, solo hay que pulsar el ícono correspondiente:
Y no olvidemos que tenemos un , donde se pueden enviar comentarios y sugerencias.
Fuente: habr.com
