

Nota de traducción.: los autores de este artículo son ingenieros de una pequeña empresa checa llamada pipetail. Han logrado recopilar una lista impresionante de [algunos problemas banales, pero aún] tan relevantes relacionados con la operación de clústeres de Kubernetes.
A lo largo de los años de uso de Kubernetes, hemos trabajado con un gran número de clústeres (tanto gestionados como no gestionados — en GCP, AWS y Azure). Con el tiempo, comenzamos a notar que ciertos errores se repiten constantemente. Sin embargo, no hay nada vergonzoso en ello: ¡nosotros mismos hemos cometido la mayoría!
En este artículo se recogen los errores más comunes, así como se menciona cómo corregirlos.
1. Recursos: solicitudes y límites
Este punto definitivamente merece la máxima atención y el primer lugar en la lista.
La solicitud de CPU generalmente o no está definida en absoluto, o tiene un valor muy bajo (para colocar el mayor número posible de pods en cada nodo). Así, los nodos se ven sobrecargados. Durante picos de carga, la capacidad de procesamiento del nodo está completamente utilizada y la carga de trabajo específica recibe solo lo que 'solicitó' a través de limitación de CPU. Esto lleva a un aumento de la latencia en la aplicación, timeouts y otras consecuencias desagradables. (Más sobre esto en nuestra otra traducción reciente: '" — nota del traductor)
BestEffort (extremadamente no recomendado):
resources: {}Solicitud de CPU extremadamente baja (extremadamente no recomendado):
   resources:
      Requests:
        cpu: "1m"
Por otro lado, tener un límite de CPU puede llevar a una omisión injustificada de ciclos por parte de los pods, incluso si la CPU del nodo no está completamente cargada. Nuevamente, esto puede llevar a un aumento de latencia. Existen debates en curso sobre el parámetro CPU CFS quota en el núcleo de Linux y la limitación de CPU dependiendo de los límites establecidos, así como la desactivación de la cuota CFS… Lamentablemente, los límites de CPU pueden causar más problemas de los que resuelven. Más sobre esto se puede encontrar en el enlace a continuación.
La sobreasignación (overcommiting) de memoria puede conducir a problemas más graves. Alcanzar el límite de CPU implica omisión de ciclos, mientras que alcanzar el límite de memoria resulta en el 'asesinato' de pod. ¿Alguna vez has observado OOMkill? Да, речь идет именно о нем.
¿Quieres minimizar la probabilidad de que esto suceda? No distribuyas volúmenes excesivos de memoria y utiliza Guaranteed QoS (Calidad de Servicio) estableciendo la solicitud de memoria igual al límite (como en el ejemplo a continuación). Lee más al respecto en (ingeniero líder de Zalando).
Burstable (mayor probabilidad de ser OOMkilled):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Guaranteed:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
¿Qué puede ayudar potencialmente en la configuración de recursos?
Con metrics-server puedes ver el consumo actual de recursos de CPU y el uso de memoria de los pods (y de sus contenedores). Probablemente ya lo estés utilizando. Simplemente ejecuta los siguientes comandos:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Sin embargo, solo muestran el uso actual. Con esto, puedes tener una idea aproximada de las magnitudes, pero al final necesitarás el historial de cambios en las métricas a lo largo del tiempo (para responder a preguntas como: «¿Cuál fue la carga máxima de CPU?», «¿Cuál fue la carga ayer por la mañana?» — etc.). Para esto, puedes usar Prometheus, DataDog y otras herramientas. Simplemente obtienen métricas del metrics-server y las almacenan, permitiendo al usuario solicitarlas y construir gráficos correspondientes.
permite automatizar este proceso. Rastrea el historial de uso de CPU y memoria y ajusta las solicitudes y límites nuevos basándose en esta información.
El uso efectivo de la capacidad computacional es una tarea difícil. Es como jugar constantemente al tetris. Si pagas demasiado por la capacidad computacional con un bajo consumo promedio (digamos, ~10 %), te recomendamos que prestes atención a los productos basados en AWS Fargate o Virtual Kubelet. Están construidos sobre un modelo de facturación serverless/pago por uso, lo que en estas condiciones puede resultar más barato.
2. Probes de liveness y readiness
Por defecto, las comprobaciones de estado de liveness y readiness en Kubernetes no están habilitadas. Y a veces se olvidan de habilitarlas...
¿Pero cómo más se puede iniciar un reinicio del servicio en caso de un error irrecuperable? ¿Y cómo sabe el balanceador de carga que cierto pod está listo para aceptar tráfico? ¿O que puede manejar más tráfico?
A menudo estas pruebas se confunden entre sí:
- Liveness — verificación de «vitalidad», que reinicia el pod en caso de fallo.
- Disponibilidad — verificación de disponibilidad, que desconecta el pod del servicio de Kubernetes en caso de fallo (esto se puede verificar con
kubectl get endpoints) y el tráfico no se envía hasta que la próxima verificación se complete con éxito.
Ambas estas verificaciones SE REALIZAN A LO LARGO DE TODO EL CICLO DE VIDA DEL POD. Esto es muy importante.
Hay una creencia común de que las pruebas de disponibilidad se ejecutan solo al inicio, para que el balanceador de carga pueda saber que el pod está listo (Listo) y puede comenzar a procesar tráfico. Sin embargo, esta es solo una de sus aplicaciones.
Otra es la capacidad de saber que el tráfico hacia el pod es excesivo y está sobrecargándolo (o el pod está realizando cálculos intensivos en recursos). En este caso, la verificación de disponibilidad ayuda a reducir la carga en el pod y "enfriarlo".La finalización exitosa de la verificación de disponibilidad en el futuro permite volver a aumentar la carga en el pod.En este caso (en caso de fallo de la prueba de disponibilidad), el fallo de la verificación de vida sería muy contraproducente. ¿Por qué reiniciar un pod que está sano y trabajando duro?
Por lo tanto, en algunos casos, la ausencia total de verificaciones es mejor que habilitarlas con parámetros configurados incorrectamente. Como se mencionó anteriormente, si la verificación de vida copia la verificación de disponibilidad, estás en grandes problemas. Una posible opción es configurar , y peligrosa verificación de vida.
Ambos tipos de verificaciones no deben fallar en caso de que las dependencias generales fallen, de lo contrario, esto llevará a una cascada (avalancha) de fallos de todos los pods. En otras palabras, .
3. LoadBalancer para cada servicio HTTP
Lo más probable es que ya tengas en tu clúster servicios HTTP que te gustaría exponer al mundo exterior.
Si abres el servicio como tipo: LoadBalancer, su controlador (dependiendo del proveedor de servicios) proporcionará y acordará un LoadBalancer externo (no necesariamente operando en L7, más bien en L4), y esto puede impactar en el costo (dirección estática externa IPv4, capacidad de computo, facturación por segundo) debido a la necesidad de crear muchos de estos recursos.
En este caso, es mucho más lógico utilizar un único balanceador de carga externo, abriendo los servicios como tipo: NodePort.O, mejor aún, desplegar algo como nginx-ingress-controller (o traefik), que actúe como único NodePort. con un endpoint asociado a un equilibrador de carga externo, y enrutar tráfico en el clúster mediante ingresslos recursos de Kubernetes.
Otros microservicios intra-clúster que interactúan entre sí pueden "comunicarse" usando servicios de tipo ClusterIP y un mecanismo de descubrimiento de servicios a través de DNS. Solo no utilices sus DNS/IP públicos, ya que esto puede afectar la latencia y aumentar el costo de los servicios en la nube.
4. Escalado automático del clúster sin tener en cuenta sus particularidades
Al añadir nodos al clúster y eliminarlos, no debes confiar solo en métricas básicas como el uso de CPU en esos nodos. La programación del pod debe tener en cuenta múltiples restricciones, tales como afinidad de pods/nodos, taints y tolerations, solicitudes de recursos, QoS, etc. Usar un autoscaler externo que no tenga en cuenta estas particularidades puede llevar a problemas.
Imagina que un pod debe ser programado, pero todos los recursos de CPU disponibles están solicitados/ocupados y el pod se queda atascado en el estado Pending. Un autoscaler externo ve la carga promedio actual de CPU (no la requerida) y no inicia la ampliación (scale-out) — no agrega otro nodo. Como resultado, este pod no será programado.
Además, la reducción de escala (scale-in) — eliminar un nodo del clúster — siempre es más difícil de implementar. Imagina que tienes un pod stateful (con almacenamiento persistente conectado). Los volúmenes persistentes generalmente pertenecen a una zona de disponibilidad específica y no se replican en la región. Por lo tanto, si el autoscaler externo elimina un nodo con ese pod, el programador no podrá programar ese pod en otro nodo, ya que esto solo se puede hacer en la zona de disponibilidad donde se encuentra el almacenamiento persistente. El pod quedará atascado en el estado Pending.
En la comunidad de Kubernetes, el . Funciona en el clúster, soporta API de los principales proveedores de servicios en la nube, tiene en cuenta todas las restricciones y puede escalar en los casos mencionados anteriormente. También es capaz de realizar scale-in manteniendo todas las restricciones establecidas, ahorrando así dinero (que de otro modo se gastaría en recursos no utilizados).
5. Desestimar las capacidades de IAM/RBAC
Ten cuidado al usar usuarios de IAM con secretos permanentes para máquinas y aplicaciones. Organice el acceso temporal utilizando roles y cuentas de servicio (cuentas de servicio).
A menudo nos encontramos con claves de acceso (y secretos) que están 'hardcodeados' en la configuración de la aplicación, así como con la negligencia en la rotación de secretos a pesar de tener acceso a Cloud IAM. Utilice roles de IAM y cuentas de servicio en lugar de usuarios, donde sea apropiado.
Olvídese de kube2iam y pase directamente a roles de IAM para cuentas de servicio (como se describe en Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
Una anotación. No es tan difícil, ¿verdad?
Además, no otorgue a las cuentas de servicio y perfiles de instancias privilegios admin y cluster-admin, si no los necesitan. Esto es un poco más complicado de implementar, especialmente en RBAC K8s, pero definitivamente vale la pena el esfuerzo.
6. No confíe en la anti-afinidad automática para los pods
Imagínese que tiene tres réplicas de un deployment en un nodo. El nodo falla, y con él todas las réplicas. Una situación desagradable, ¿verdad? ¿Pero por qué todas las réplicas estaban en un solo nodo? ¡¿No debe Kubernetes garantizar alta disponibilidad (HA)?!
Lamentablemente, el programador de Kubernetes no cumple por sí mismo las reglas de separación (anti-afinidad) para los pods. Tienen que ser especificadas explícitamente:
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
Y eso es todo. Ahora los pods se programarán en nodos diferentes (esta condición se verifica solo durante la programación, pero no durante su funcionamiento — de ahí requiredDuringSchedulingIgnoredDuringExecution).
Aquí hablamos de podAntiAffinity en nodos diferentes: topologyKey: "kubernetes.io/hostname", — y no en diferentes zonas de disponibilidad. Para implementar una HA completa, será necesario profundizar más en este tema.
7. Ignorar los PodDisruptionBudgets
Imagina que tienes una carga de producción en un clúster de Kubernetes. Ocasionalmente, es necesario actualizar los nodos y el clúster mismo (o sacarlos de funcionamiento). El PodDisruptionBudget (PDB) es algo así como un acuerdo de garantía de servicio entre los administradores del clúster y los usuarios.
El PDB ayuda a evitar interrupciones en los servicios causadas por falta de nodos:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
En este ejemplo, como usuario del clúster, le dices a los administradores: «Oye, tengo un servicio zookeeper, y no importa lo que hagan, me gustaría que al menos 2 réplicas de este servicio siempre estuvieran disponibles».
Puedes leer más sobre esto .
8. Varios usuarios o entornos en un clúster común
Espacios de nombres de Kubernetes (namespaces) no proporcionan una fuerte aislamiento.
Es un mito común pensar que si implementas una carga no-prod en un espacio de nombres, y una carga prod en otro, entonces no se influirán entre sí… Sin embargo, se puede lograr cierto nivel de aislamiento mediante solicitudes/limitaciones de recursos, establecimiento de cuotas, asignación de priorityClasses. Un tipo de aislamiento “físico” en el plano de datos es proporcionado por affinities, tolerations, taints (o nodeselectors), sin embargo, tal separación es bastante difícil de implementar.
Aquellos que necesiten combinar ambos tipos de cargas de trabajo en un solo clúster tendrán que lidiar con la complejidad. Si no hay tal necesidad, y puedes permitirte crear otro clúster (digamos, en la nube pública), sería mejor hacerlo. Esto permitirá alcanzar un nivel de aislamiento mucho más alto.
9. externalTrafficPolicy: Cluster
Muy a menudo vemos que todo el tráfico dentro del clúster llega a través de un servicio tipo NodePort, para el cual por defecto se establece la política externalTrafficPolicy: Cluster. Esto significa que NodePort. está abierto en cada nodo del clúster, y se puede usar cualquiera de ellos para interactuar con el servicio deseado (conjunto de pod’s).
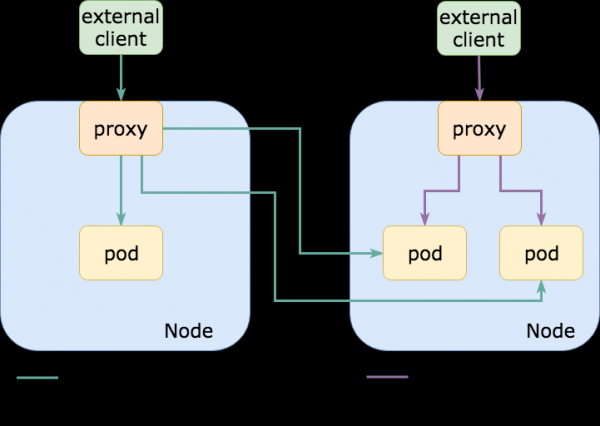
Sin embargo, los pod’s reales asociados con el mencionado servicio NodePort, generalmente solo están en un subconjunto de esos nodos. En otras palabras, si me conecto a un nodo en el que no hay el pod deseado, este redirigirá el tráfico a otro nodo, agregando un salto (hop) y aumentando la latencia (si los nodos están en diferentes zonas de disponibilidad/data centers, la latencia puede ser bastante alta; además, aumentarán los costos de tráfico de egress).
Por otro lado, si para un cierto servicio de Kubernetes se establece la política externalTrafficPolicy: Local, entonces NodePort se abre solo en aquellos nodos donde realmente se están ejecutando los pod’s necesarios. Al utilizar un balanceador de carga externo, que verifica el estado (healthchecking) de los endpoints (como lo hace AWS ELB), este dirigirá el tráfico solo a los nodos necesarios., lo que beneficiará a las latencias, necesidades computacionales, costos de egress (y el sentido común también lo dictamina).
Es muy probable que ya estés utilizando algo como traefik o nginx-ingress-controller como punto final NodePort (o un LoadBalancer que también utiliza NodePort) para enrutamiento de tráfico HTTP ingress, y habilitar esta opción puede reducir significativamente la latencia en tales solicitudes.
En puedes conocer más a fondo sobre externalTrafficPolicy, sus ventajas y desventajas.
10. No te ates a los clústeres y no abuses del plano de control
Antes, los servidores solían llevar nombres propios: , HAL9000 y Colossus… Hoy en día han sido reemplazados por identificadores generados aleatoriamente. Sin embargo, la costumbre persiste, y ahora los nombres propios se asignan a los clústeres.
Una historia típica (basada en hechos reales): todo comenzó con una prueba de concepto, por lo que el clúster tenía el orgulloso nombre de testing… Pasaron los años, y todavía se utiliza en producción, y todos temen tocarlo.
No hay nada divertido en que los clústeres se conviertan en mascotas, así que te recomendamos eliminarlos periódicamente, aprovechando para practicar en la recuperación después de fallos (esto ayudará — nota del traductor)). Además, también sería bueno dedicar tiempo a la capa de gestión (control plane). Tener miedo de tocarla no es una buena señal. Etcd ¿está muerto? Chicos, ¡realmente están en problemas!
Por otro lado, no te sumerjas demasiado en manipularlo. Con el tiempo la capa de gestión puede volverse lenta.Probablemente se deba a la gran cantidad de objetos que se crean sin su rotación (una situación común al usar Helm con configuraciones predeterminadas, lo que provoca que su estado no se actualice en configmaps/secretos — como resultado, se acumulan miles de objetos en la capa de gestión) o a la edición constante de objetos kube-api (para escalado automático, para CI/CD, para monitoreo, registros de eventos, controladores, etc.).
Además, te recomendamos verificar los acuerdos SLA/SLO con tu proveedor de Kubernetes gestionado y prestar atención a las garantías. El proveedor puede garantizar la disponibilidad de la capa de gestión (o sus subcomponentes), pero no la latencia p99 de las solicitudes que le envías. En otras palabras, se puede establecer kubectl get nodes, y la respuesta se obtendrá solo después de 10 minutos, y esto no será una violación de los términos del acuerdo de servicio.
11. Bonificación: uso de la etiqueta latest
Esto ya es un clásico. En tiempos recientes, nos encontramos con esta técnica no tan a menudo, ya que muchos, habiendo aprendido por la amarga experiencia, han dejado de utilizar la etiqueta :latest y han comenzado a fijar (pin) las versiones. ¡Hurra!
ECR ; recomendamos familiarizarse con esta notable característica.
Currículum
No esperes que todo funcione con un simple gesto: Kubernetes no es una panacea. Una mala aplicación (y, posiblemente, empeore). La despreocupación llevará a una complejidad excesiva, con un funcionamiento lento y tenso de la capa de gestión. Además, corres el riesgo de quedarte sin una estrategia de recuperación ante desastres. No cuentes con que Kubernetes «out of the box» asumirá la garantía de aislamiento y alta disponibilidad. Dedica un tiempo a hacer que tu aplicación sea realmente cloud native.
Puedes conocer las experiencias fallidas de diversos equipos en de Henning Jacobs.
Los que deseen complementar la lista de errores mencionada en este artículo pueden contactarnos en Twitter (, ).
P.D. del traductor
También puedes leer en nuestro blog:
- «»;
- «»;
- «» (reseña y video de la charla);
- «».
Fuente: habr.com
