

El Capacity Tier (o como lo llamamos internamente en Vima — captir) apareció en la época de Veeam Backup and Replication 9.5 Update 4 con el nombre de Archive Tier. La idea subyacente es permitir mover copias de seguridad que han caído fuera de la llamada ventana de restauración operativa a almacenes de objetos. Esto ayudaba a liberar espacio en disco para aquellos usuarios que tenían poco. Esta opción se llamaba Move Mode.
Para realizar esta acción sencilla (como parece) solo era necesario cumplir con dos condiciones: todos los puntos de la copia de seguridad que se va a mover deben estar fuera de la mencionada ventana de restauración operativa, que se establece explícitamente en la interfaz. Y la segunda: la cadena debe estar en lo que se llama «estado sellado» (sealed backup chain o Inactive Backup Chain). Esto significa que con el tiempo no se producen cambios en esta cadena.
Pero en VBR v10, la concepción se complementó con nuevas funciones: apareció el Copy Mode, Sealed Mode y una cosa con un nombre difícil de pronunciar: Immutability.
Hoy vamos a hablar de estas emocionantes cosas. Primero, cómo funcionaba en VBR9.5u4, y luego los cambios en la décima versión.
Y que me perdonen los defensores del lenguaje puro, pero no es posible traducir demasiados términos.
Así que aquí habrá un montón de anglicismos.
Y muchas gifs.
Y imágenes.
- Sin el más mínimo arrepentimiento. Autor del artículo.
Como fue
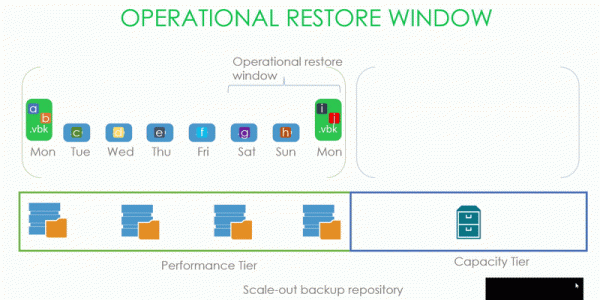
Bueno, empecemos con el análisis de la ventana de restauración operativa y la copia de seguridad sellada (o como se llama en la documentación, Inactive Backup Chain). Sin su comprensión, no se podrá explicar nada más.
Como podemos ver en la imagen, tenemos una cadena de copia de seguridad con bloques de datos, que está situada en el performance tier del repositorio SOBR, al cual está conectado el Capacity Tier. Nuestra ventana de copia de seguridad operativa es de tres días.
Por lo tanto, la copia .vbk creada el lunes sella la cadena anterior, cuya ventana está establecida en tres días. Y, por lo tanto, se puede comenzar a llevar al capacity tier todo lo que tenga más de esos tres días.
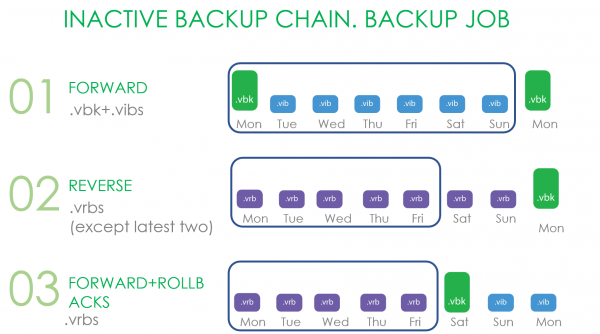
Pero, ¿qué se entendía exactamente por una cadena sellada y qué podía enviarse al capacity tier en la actualización 4?
Para Forward Incremental, el signo de un sellado de la cadena es la creación de una nueva copia de seguridad completa. Y no importa cómo se obtenga esa copia completa: se consideran tanto las copias completas sintéticas como las copias completas activas.
En el caso de Reverse, son todos los archivos que no caen dentro de la ventana operativa.
En el caso de Forward increment con rollbacks, todos los rollbacks y .vbk, si hay otro .vbk en el performance extent.
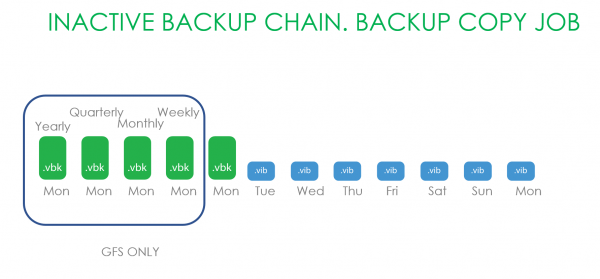
Ahora consideremos una opción de trabajo con cadenas de Backup Copy. Aquí solo se incluía lo que estaba bajo la retención de GFS. Porque todo lo que se almacene en cadenas de backup copy más recientes puede ser de alguna manera modificado.
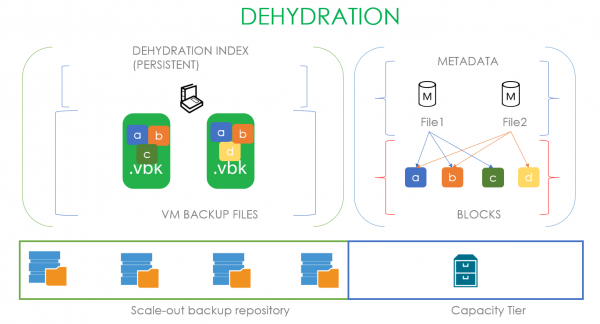
Ahora echemos un vistazo bajo el capó. Allí ocurre un proceso llamado deshidratación, que consiste en dejar residuos de archivos de backup en el extent y trasladar bloques de estos archivos al capacity tier. Para optimizar este proceso se utiliza lo que se llama un índice de deshidratación, que permite no copiar bloques que ya han sido transferidos al capacity tier.
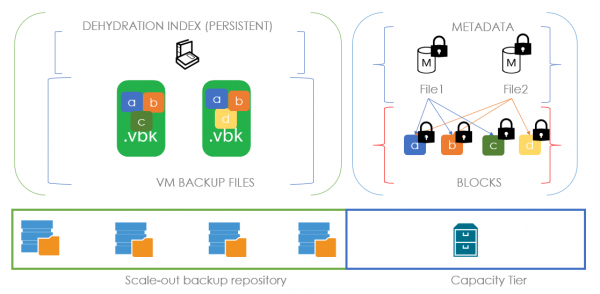
Veamos cómo se ve esto con un ejemplo: supongamos que tenemos un .vbk que ha salido de la ventana operativa y pertenece a una cadena sellada. Esto significa que tenemos todo el derecho de transferirlo al capacity tier. En el momento de la transferencia, se crea un archivo de metadatos en el capacity tier y se trasladan los bloques del archivo transferido. En el archivo de metadatos a nivel de referencias se describe de qué bloques consta nuestro archivo. En el caso de la imagen, nuestro primer archivo consta de bloques a, b, c y en los metadatos se colocan referencias a estos bloques. Cuando tenemos un segundo archivo .vbk listo para trasladarse y compuesto por bloques a, b y d, al analizar el índice de deshidratación entendemos que solo es necesario trasladar el bloque d. Su archivo de metadatos contendrá referencias a los dos bloques anteriores y uno nuevo.
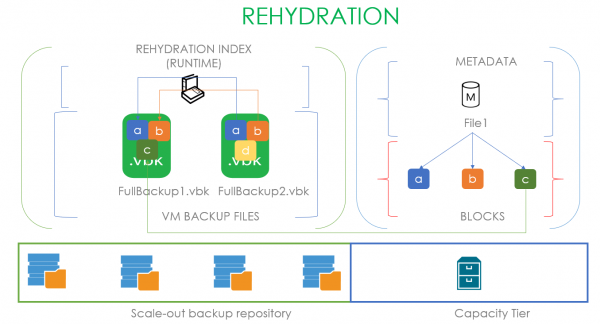
Por lo tanto, el proceso de volver a llenar estos residuos con datos se llama rehidratación. Aquí se utiliza su propio índice de rehidratación, que se basa en el archivo .vbk más antiguo en el performance extent local. Es decir, si el usuario desea recuperar un archivo del capacity tier, primero creamos un índice de bloques de la copia de seguridad completa más antigua y solo trasladamos los bloques faltantes desde el capacity tier. En el caso presentado en la imagen, para rehidratar FullBackup1.vbk de acuerdo con el índice de rehidratación solo nos falta el bloque C, que retiramos del capacity tier. Si el capacity tier es un almacenamiento de objetos en la nube, esto permite ahorrar enormes sumas de dinero.
Aquí puede parecer que esta tecnología es idéntica a la utilizada en los aceleradores WAN, pero solo lo parece. En los aceleradores, la deduplicación es global; aquí se utiliza de manera local dentro de cada archivo a un determinado offset. Esto se debe a la diferencia en los problemas que se resuelven: aquí necesitamos copiar grandes archivos de respaldos completos, y según nuestras investigaciones, incluso si entre ellos transcurre un largo período de tiempo, dicho algoritmo de deduplicación da el mejor resultado.
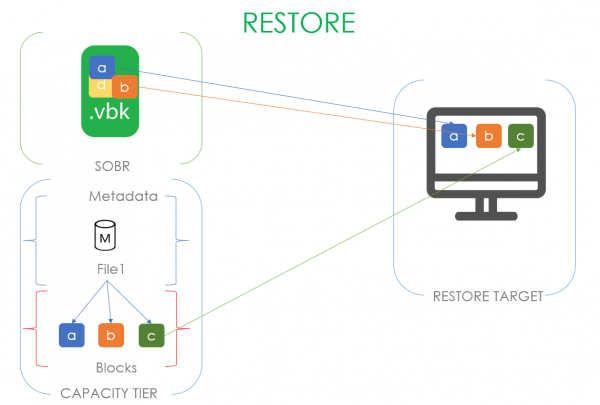
¡Pero más índices al dios de los índices! ¡También hay un índice para la recuperación de datos! Cuando iniciamos la recuperación de una máquina ubicada en un área de capacidad, solo leeremos bloques de datos únicos que no están en el área de rendimiento.
Como se ha dicho
Con esto hemos terminado la parte introductoria. Es bastante detallada, pero, como se mencionó anteriormente, sin estos detalles no se puede explicar cómo funcionan las nuevas funciones. Por lo tanto, sin más preámbulos, pasemos al primero.
Modo de copia
Se basa en gran medida en tecnologías existentes, pero lleva consigo una lógica de uso completamente diferente.
El objetivo de este modo es garantizar que todos los datos ubicados en el extent local tengan una copia en el área de capacidad.
Si comparamos directamente los modos Move y Copy, quedaría así:
- Solo se puede mover una cadena sellada. En el caso del modo de copia, se transporta absolutamente todo, independientemente de lo que ocurra en el trabajo de respaldo.
- El movimiento se activa cuando los archivos están fuera de las ventanas de operación del respaldo, mientras que la copia se activa tan pronto como aparece un archivo de respaldo.
- El seguimiento de nuevos datos para copiar ocurre de manera constante, mientras que para el movimiento se activa cada 4 horas.
Al considerar el nuevo modo, propongo avanzar de ejemplos simples a complejos.
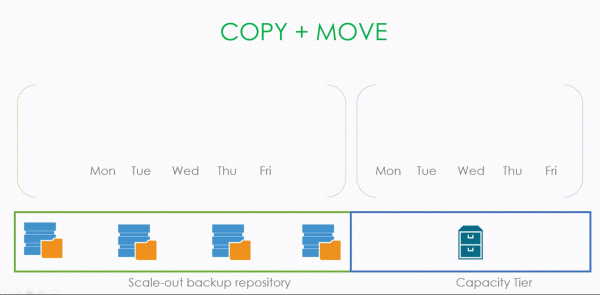
En el caso más simple, simplemente nos aparecen nuevos archivos con incrementos, y simplemente los copiamos en el área de capacidad. Sin importar qué modo se use en el trabajo de respaldo, sin importar si pertenece a la parte sellada de la cadena o no, sin importar si ha expirado nuestra ventana operativa. Simplemente tomamos y copiamos.
El proceso detrás de esto sigue siendo la deshidratación tal como se describió anteriormente. En modo de copia, también se asegura de que no copiemos bloques que ya están en nuestro almacenamiento. La única diferencia es que, en modo de movimiento, reemplazábamos los archivos reales con archivos vacíos, mientras que aquí no los tocamos y los dejamos tal como están. En el resto, es exactamente el mismo índice de deshidratación, que se esfuerza por ahorrar su dinero y tiempo.
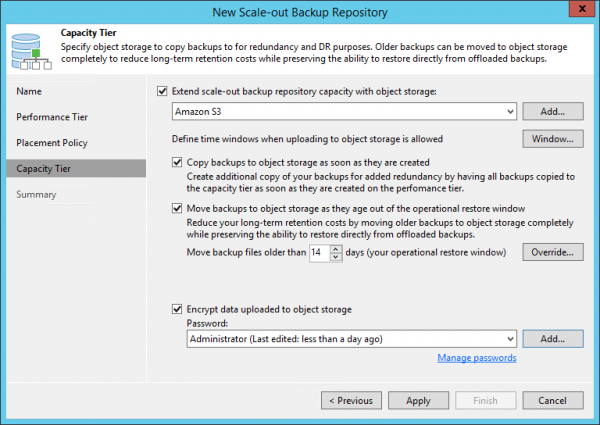
Surge la pregunta: si miramos en la interfaz de usuario, hay una opción para seleccionar ambas opciones al mismo tiempo. ¿Cómo funcionará este modo combinado?
Vamos a analizarlo.
El inicio es estándar: se crea un archivo de respaldo y se copia de inmediato. Se crea un incremento y también se copia. Esto continúa hasta que entendemos que los archivos han salido de nuestra ventana operativa y se ha creado una cadena sellada. En este momento, realizamos la operación de deshidratación y reemplazamos estos archivos con vacíos. Por supuesto, no copiamos nada de nuevo al nivel de capacidad.
Toda esta lógica interesante se controla con solo una casilla en la interfaz: Copiar respaldos al almacenamiento de objetos tan pronto como se crean.
¿Y para qué necesitamos este modo de copia?
Sería mejor reformular la pregunta: ¿de qué riesgos nos protege? ¿Qué problema nos ayuda a resolver?
La respuesta es obvia: por supuesto, es la recuperación de datos. Si tenemos una copia completa de los datos locales en el almacenamiento de objetos, no importa qué suceda con nuestro entorno de producción, siempre podemos recuperar los datos de los archivos ubicados en un hipotético Amazon.
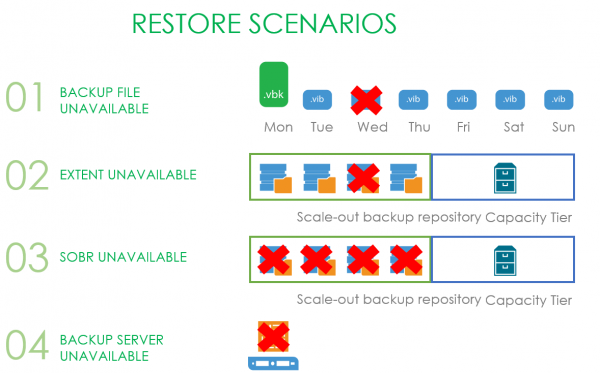
Por lo tanto, vamos a repasar los posibles escenarios, desde el más simple hasta el más complejo.
La aflicción más simple que puede caer sobre nosotros es la inaccesibilidad de uno de los archivos en la cadena de respaldo.
Una historia más triste es que uno de los extensores de nuestro repositorio SOBR se ha roto.
Peor aún es cuando todo el repositorio SOBR se vuelve inaccesible, pero el nivel de capacidad sigue funcionando.
Y todo está realmente mal cuando se muere el servidor de respaldo y tu primer deseo es intentar llegar a la frontera canadiense en diez minutos.
Ahora, analicemos cada situación por separado.
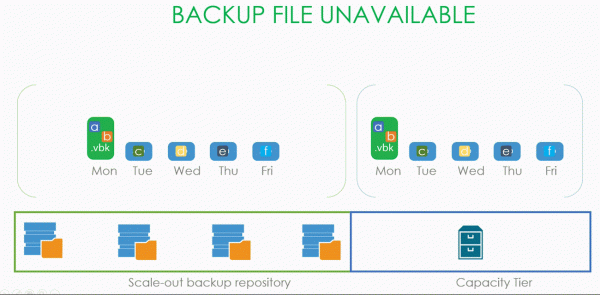
Cuando perdimos uno (bueno, incluso varios) archivos de copia de seguridad, solo necesitaremos iniciar el proceso de rescaneo del repositorio, y el archivo perdido será reemplazado por un archivo vacío. Y con el proceso de rehidratación (del que se habló al principio del artículo), el usuario podrá descargar datos del almacenamiento en la nube a su almacenamiento local.
Ahora la situación es un poco más complicada. Supongamos que nuestro SOBR consta de dos extensiones que trabajan en modo de rendimiento, lo que significa que nuestros .vbk y .vib están distribuidos entre ellas de manera bastante desigual. Y en algún momento, una de las extensiones se vuelve inaccesible, y el usuario necesita urgentemente recuperar la máquina, parte de cuyos datos se encuentran precisamente en esta extensión.
El usuario inicia el asistente de recuperación, elige un punto al que desea restaurar, y el asistente, en el transcurso de su trabajo, llega a la conclusión de que no tiene todos los datos necesarios para la recuperación localmente, por lo que necesita descargarlos del almacenamiento en la nube. Al mismo tiempo, los bloques que quedaron en el almacenamiento local no se descargarán de la nube. Gracias al índice de restauración (sí, también se mencionó al principio del artículo).
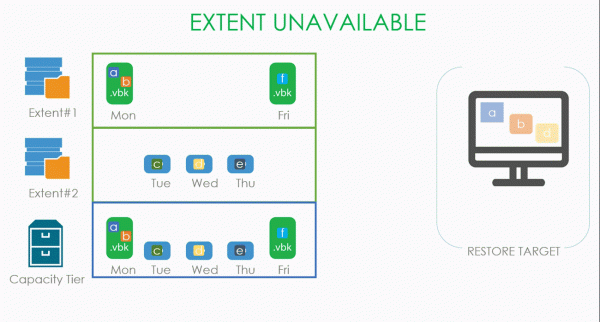
Una variante de este caso es que todo el repositorio SOBR se vuelva inaccesible. En este caso, no tenemos nada que copiar de los almacenes locales, y todos los bloques se descargan de la nube.
Y la situación más interesante: el servidor de copias de seguridad ha fallado. Aquí hay dos opciones: el administrador es competente y realizó copias de seguridad de la configuración, o el administrador es un malvado Pinocho y no hizo copia de seguridad de la configuración.
En el primer caso, será suficiente simplemente desplegar una instalación limpia de VBR en algún lugar y restaurar su base desde la copia de seguridad con herramientas estándar. Al finalizar este proceso, todo volverá a la normalidad. O será restaurado según uno de los escenarios mencionados arriba.
Pero si el administrador es su propio enemigo o si la copia de seguridad de la configuración también ha sufrido una famosa calamidad, aquí tampoco lo dejaremos a su suerte. Para este caso, hemos introducido un nuevo procedimiento llamado Import Object Storage. Este permite omitir el proceso de recreación manual del repositorio SOBR y su vinculación a un tirador de capacidad, seguido de un rescaneo, y simplemente agregar el almacenamiento de objetos en la interfaz de Veeam y ejecutar el procedimiento Import Storage Repository. Lo único que puede interponerse entre usted y sus copias de seguridad es la solicitud de una contraseña si sus copias de seguridad han sido cifradas.
Con esto, terminamos sobre el Modo Copia y pasamos a
Modo Sellado
La idea principal es que no pueden aparecer nuevas copias de seguridad en el extento seleccionado del repositorio SOBR. Hasta la versión 10, solo teníamos el Modo de Mantenimiento, donde se prohibía completamente cualquier trabajo con el repositorio. Una especie de modo hardcore para sacar el almacenamiento de la operación, donde solo estaba disponible el botón Evacuar, que movía las copias de seguridad a otro extento de una sola vez.
El Modo Sellado es una especie de variante "suave": prohibimos crear nuevas copias de seguridad y eliminamos progresivamente las antiguas según la retención seleccionada, pero en el proceso no perdemos la posibilidad de recuperarnos de los puntos almacenados. Es algo muy útil, especialmente cuando el hardware está cerca del final de su vida útil y necesita ser reemplazado, o simplemente debe liberarse para algo más importante, y no hay dónde mover todo de una vez. O no se puede eliminar.
Por lo tanto, el principio de funcionamiento es bastante simple: hay que prohibir todas las operaciones de escritura (aparecimiento de nuevos datos), dejando las de lectura (restauraciones) y eliminación (retención).
Ambos modos se pueden usar simultáneamente, solo hay que tener en cuenta que el Mantenimiento tiene mayor prioridad.
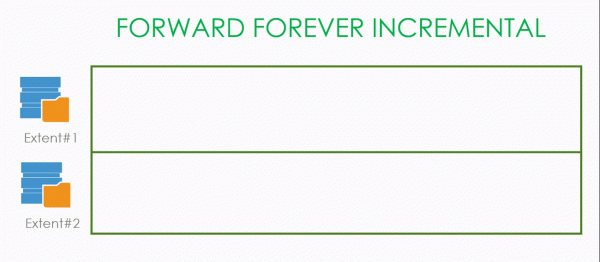
Como ejemplo, consideremos un SOBR que consta de dos extentos. Supongamos que durante los primeros cuatro días se crearon copias de seguridad en modo Incremental Infinito Adelante, y luego sellamos el extento. Esto lleva a que iniciemos la creación de un nuevo full activo en el segundo extento disponible. Si nuestra retención es de cuatro, entonces, cuando toda la cadena situada en el extento sellado salga de su límite, se eliminará sin remordimientos.
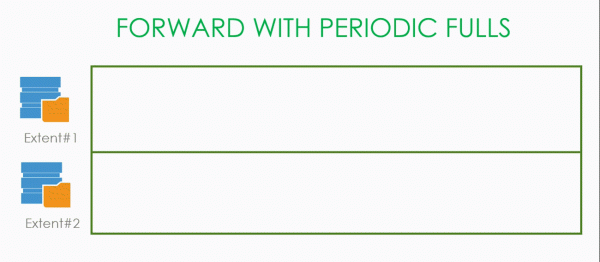
Hay situaciones en las que la eliminación ocurre antes. Por ejemplo, esto es un Forward incremental con full backups periódicos. Si durante los dos primeros días realizamos full backups, y el jueves decidimos sellar el repositorio, entonces el viernes, cuando se cree un nuevo full, el archivo del lunes será eliminado ya que hasta ese punto no tiene dependencias. Y ese punto no depende de nadie. Después de esto, esperamos a que se creen cuatro puntos en el extente disponible y eliminamos los tres restantes, que no pueden ser eliminados independientemente unos de otros.
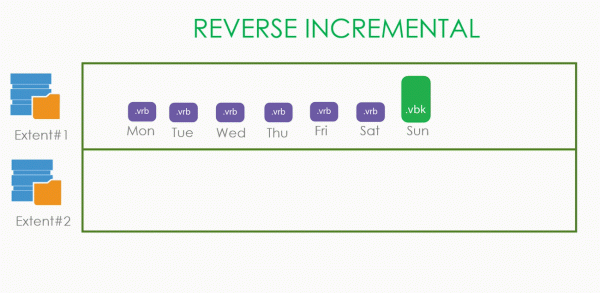
Las cosas son más sencillas con Reverse Incremental. En él, los puntos más antiguos no dependen de nada y pueden ser eliminados sin problema. Por lo tanto, tan pronto como se cree un nuevo .vbk en un nuevo extente, los antiguos .vrb serán eliminados uno por uno.
Por cierto, ¿por qué creamos un nuevo .vbk cada vez? Si no lo hiciéramos y continuáramos con la antigua cadena de incrementos, el viejo .vbk quedaría atascado indefinidamente en cualquier modo, impidiendo su eliminación. Por lo tanto, se decidió que tan pronto como se sella un extente, creamos un full backup en un extente libre.
Las cosas son más complicadas con el capacity tier.
Primero consideremos el modo copy. Supongamos que hemos creado backups activamente durante cuatro días, y luego el capacity tier fue sellado. No eliminamos nada, sino que simplemente soportamos la retención, después de lo cual eliminamos los datos del capacity tier.
Algo similar sucede en el modo move: esperamos la retención, eliminamos lo antiguo en el almacenamiento local y eliminamos lo que está almacenado en el object storage.
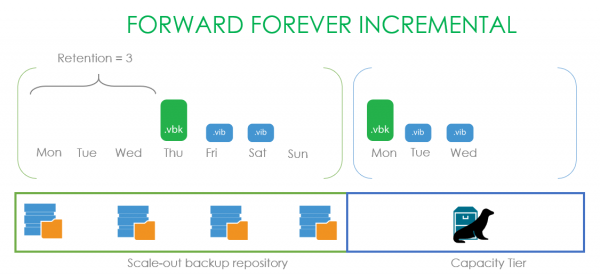
Un ejemplo interesante con Forever forward incremental. Establecemos la retención en tres puntos y comenzamos a hacer backups desde el lunes, que se copian correctamente en la nube. Después de sellar el almacenamiento, los backups continúan creándose, manteniendo tres puntos, pero los datos almacenados en el capacity tier permanecen dependientes y no pueden ser eliminados. Por lo tanto, esperamos al jueves, cuando nuestro .vbk sale del rango de retención, y solo entonces eliminamos toda la cadena guardada.
Y una pequeña aclaración: todos los ejemplos aquí se muestran con una sola máquina. Si tienes varias en el backup, la retención variará dependiendo de si se realizó un Active Full o no.
Y con esto, en principio, es todo. Así que pasemos a la característica más hardcore —
Inmutabilidad
Al igual que con los puntos anteriores, primero se debe mencionar qué problema resuelve esta función. En cuanto exportamos nuestros respaldos a algún lugar de almacenamiento, surge el deseo urgente de garantizar su conservación, es decir, prohibir físicamente su eliminación y cualquier modificación durante el período de retención establecido. Esto incluye a los administradores, incluso bajo sus cuentas de superusuario. Esto permite protegerlos contra la corrupción accidental o intencionada. Quien trabaja con AWS puede haber encontrado una función similar bajo el nombre de Object Lock.
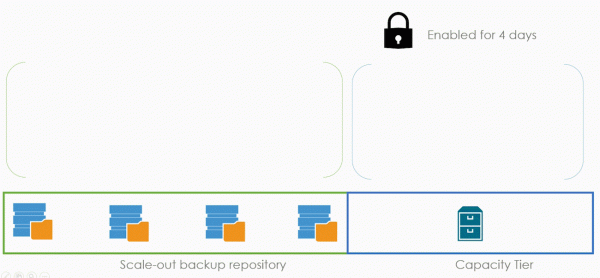
Ahora consideremos el modo en términos generales, y luego profundizaremos en los detalles. En nuestro ejemplo, la Inmutabilidad estará habilitada para nuestro tiro de capacidad con una retención de cuatro días. Y el respaldo incluirá el modo Copia.
La inmutabilidad no interactúa de ninguna manera con la retención general. Por ejemplo, no agrega puntos adicionales ni nada por el estilo. Simplemente, durante cuatro días, una persona no puede eliminar los archivos de respaldos. Si se realiza un respaldo el lunes, el archivo se podrá eliminar únicamente el viernes.
Todos los conceptos previamente explicados de deshidratación, índices y metadatos continúan funcionando exactamente igual. Pero con una condición: el bloqueo se aplica no solo a los datos, sino también a los metadatos. Esto se hace en caso de que un astuto atacante decida borrar nuestra base de metadatos y para que los bloques de datos no se conviertan en un revoltijo binario inútil.
Y ahora ha llegado el momento perfecto para explicar nuestra tecnología de generación de bloques. O generación de bloques. Para ello, consideremos la situación que llevó a su aparición.
Tomemos una línea de tiempo de seis días y marquemos en la parte inferior el tiempo de expiración esperado de la inmutabilidad. Creamos, en el primer día, un archivo que consiste en un bloque de datos a y sus metadatos. Si la inmutabilidad se establece en tres días, es lógico suponer que en el cuarto día los datos serán desbloqueados y eliminados. En el segundo día, añadiremos un nuevo file2, que consiste en el bloque b con las mismas configuraciones. El bloque a aún debería ser eliminado en el cuarto día. Pero en el tercer día sucede lo terrible: se crea un archivo File3, que consiste en un nuevo bloque d y un enlace al antiguo bloque a. Esto significa que para el bloque a su bandera de inmutabilidad debe ser reinstaurada a un nuevo plazo, que se desplaza al sexto día. Y aquí surge un problema: en las copias de seguridad reales, tales bloques se generan en gran cantidad. Y para extender su periodo de inmutabilidad, hay que realizar una gran cantidad de solicitudes cada vez. De hecho, esto se convierte en un proceso casi infinito a diario, ya que con gran probabilidad encontraremos enormes lotes de bloques desduplicados con cada copia. ¿Y qué significa una gran cantidad de solicitudes para los proveedores de almacenamiento de objetos? ¡Correcto! Una enorme factura al final del mes.
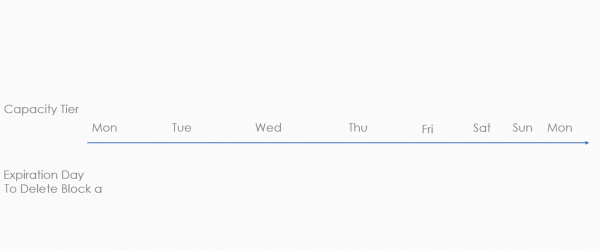
Y para no generar de la nada grandes costos para nuestros valiosos clientes, se ideó el mecanismo de generación de bloques. Este es un periodo adicional que añadimos al periodo de inmutabilidad establecido. En el ejemplo a continuación, este periodo es de dos días. Pero esto es solo un ejemplo. En realidad, se utiliza una fórmula propia que proporciona aproximadamente diez días adicionales con un bloqueo mensual.
Continuaremos analizando la misma situación, pero ahora con la generación de bloques. Creamos en el primer día file1 a partir del bloque a y los metadatos. Acumulamos el período de generaciones e inmutabilidad, lo que significa que la posibilidad de eliminar el archivo será en el sexto día. Si en el segundo día creamos File2, que consiste en el bloque b y un enlace al bloque a, entonces no sucede nada respecto a la fecha prevista de eliminación. Se mantiene en el sexto día. Con esto estamos tratando de ahorrar dinero en la cantidad de solicitudes. La única situación en la que el plazo puede ser trasladado es si el período de generación ha expirado. Es decir, si en el tercer día el nuevo File3 contiene un enlace al bloque a, se añadirá la generación 2 ya que la Gen1 ya ha expirado. La fecha de eliminación esperada del bloque a se trasladará al octavo día. Esto nos permite reducir drásticamente la cantidad de solicitudes para extender la vida útil de los bloques deduplicados, lo que ahorra una gran cantidad de dinero a los clientes.
La tecnología en sí está disponible para los usuarios de S3 y hardware compatible con S3, cuyos fabricantes garantizan que su implementación no difiere de la de Amazon. De aquí la respuesta a la pregunta legítima de por qué no se admite Azure: ellos tienen una función similar, pero funciona a nivel de contenedores, no de objetos individuales. Por cierto, en Amazon hay modo de bloqueo de objeto en dos modalidades: cumplimiento y gobernanza. En el segundo caso, permanece la posibilidad de que el superadmin y root de todos los root, a pesar del bloqueo de objeto, elimine los datos. En caso de cumplimiento, todo queda sellado de manera irrevocable y ninguna copia de seguridad puede ser eliminada por nadie. Ni siquiera por los administradores de Amazon (según sus declaraciones oficiales). Soportamos específicamente este modo.
Y, como es tradicional, un poco de enlaces útiles:
- Sobre en todos los detalles.
- Toda la información sobre de la mejor manera
- A en detalles
Fuente: habr.com
