

Hace dos años ya hice una publicación hablado de . Ahora hay algunos avances en el proyecto, y también he publicado la competencia de , por lo que decidí escribir esta breve reseña en Habr.
[ ]
A quién puede interesar esto
Esto puede interesarle si trabaja en un pequeño equipo o incluso solo. No tiene monitoreo y no está seguro de si realmente lo necesita. O si ha probado algún monitoreo serio y popular "para grandes chicos", pero no funcionó para usted, o funciona en casi configuración predeterminada y no ha cambiado mucho su vida. Y también — si definitivamente no tiene planes de asignar a un empleado (o incluso un departamento) solo para que pase un par de horas al día monitoreando el tablero de control de monitoreo o configurándolo.
Qué hace único a okerr
A continuación, mostraré las características interesantes de okerr que lo distinguen de otros sistemas de monitoreo.
Okerr es un monitoreo híbrido
En el monitoreo interno, un "agente" se ejecuta en las máquinas observadas, que transmite datos al servidor de monitoreo (por ejemplo, el espacio libre en los discos). En el monitoreo externo, el servidor realiza comprobaciones a través de la red (por ejemplo, ping o disponibilidad de un sitio web). Cada enfoque tiene sus limitaciones. Okerr utiliza ambos métodos. Las verificaciones dentro de los servidores se ejecutan con un agente muy ligero (30Kb) o con sus propios scripts y aplicaciones, y las verificaciones de red se realizan a través de los sensores de okerr en diferentes países.
okerr no es solo un software, sino también un servicio
La parte del servidor de cualquier monitoreo es una cosa grande y complicada, es difícil de instalar y configurar, y requiere recursos. Con okerr, puede instalar su propio servidor de monitoreo (es gratuito y de código abierto), o simplemente usar solo la parte del cliente, y beneficiarse del servicio de nuestro servidor. También es gratis.
Si la supervisión permite compensar la falta de fiabilidad de los servidores y aplicaciones, surge una pregunta filosófica: ¿Quién cuida al guardián? ¿Cómo nos informará la supervisión sobre un problema si ella misma 'ha fallado' por alguna razón, ya sea por sí sola o junto con otros recursos (por ejemplo, si se cae el canal hacia el centro de datos)? Al usar el servicio externo okerr, este problema se resuelve: recibirás una alerta incluso si todo el centro de datos con tus servidores se queda sin energía o es víctima de un ataque zombi.
Por supuesto, existe el riesgo de que el servidor okerr también esté fuera de servicio, eso es cierto (como se sabe, el 90% de la fiabilidad se logra siempre de forma sencilla y 'gratuita', el 99% con el mínimo de esfuerzo, y cada nueve adicional se vuelve exponencialmente más difícil). Pero, en primer lugar, las posibilidades de esto son menores, y en segundo lugar, el problema podría pasar desapercibido solo si coincide en el tiempo con problemas en nuestros servidores. Si tenemos una fiabilidad del 99.9% y tú también del 99.9% (números no tan altos), entonces la probabilidad de un fallo no detectado es del 0.1% de 0.1% = 0.0001%. ¡Añadir tres nueves a la fiabilidad casi sin esfuerzo y sin coste es bastante bueno!
Otra ventaja de la supervisión como servicio es que el proveedor de hosting o la agencia web puede instalar el servidor okerr en sus instalaciones y ofrecer acceso a los clientes como un servicio adicional de pago o gratuito. Tus competidores solo tienen hosting y sitios web, mientras que tú cuentas con un hosting fiable con supervisión.
Okerr trata sobre indicadores
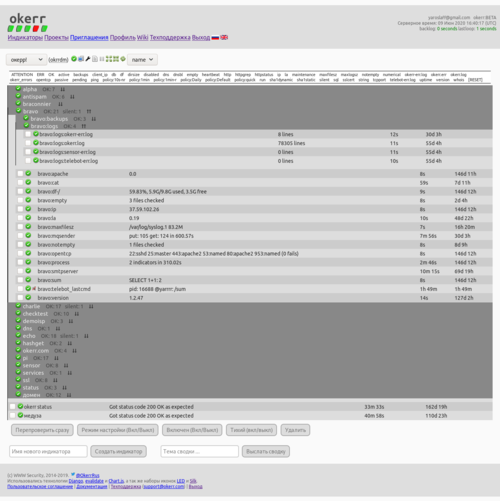
Un indicador es una 'luz'. Tiene dos estados principales: verde (OK) o rojo (ERR). En el proyecto hay numerosos indicadores agrupados (por ejemplo, por servidores). En la página principal del proyecto puedes ver de inmediato si todo está en verde (y se puede cerrar) o si algo está parpadeando en rojo y necesita corrección. Al cambiar entre estos estados, se envía una notificación. Una vez al día, mientras tú lo configures, se envía un resumen del proyecto.
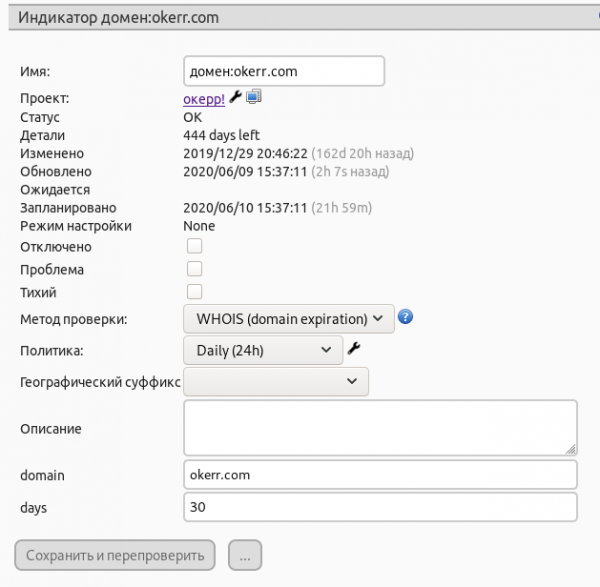
Cada indicador de okerr tiene condiciones integradas según las cuales cambia de estado (en Zabbix esto se llama trigger). Por ejemplo, la carga media no debe ser superior a 2 (por supuesto, esto se puede ajustar). Y para cada verificación interna (carga media, espacio en disco, ...) hay un watchdog. Si por alguna razón no recibimos una confirmación exitosa a tiempo, se registra un error y se envía una alerta.
Nuestro esquema de trabajo habitual implica una verificación matutina del correo, donde, entre otros mensajes, revisamos el resumen (programamos su hora para el inicio de la jornada). Si todo está en orden, nos ocupamos de otros asuntos importantes (aunque podemos, por seguridad, echar un vistazo rápido al tablero de okerr para asegurarnos de que, en ese momento, todo esté en verde). Si llega una alerta, respondemos.
Por supuesto, hay la opción de mantener solo indicadores "informativos" (para ver el estado de la red desde la monitorización), pero todo está diseñado para que sea sencillo, fácil y rápido crear indicadores para la supervisión automática y el envío de alertas.
El propósito de configurar okerr radica en las alertas, en que puedes crear un indicador en un minuto, que puede estar "dormido" durante un año, solo recibiendo actualizaciones, y cuando algo falla después de un año, se activa y envía una alerta. El minuto que invertiste una vez en crear el indicador se recuperó, ya que te enteraste del problema de inmediato, antes que nadie. Es posible que incluso hayas podido solucionarlo antes de que alguien más lo notara. ¡Lo que se levanta rápidamente no se cuenta como caído!
Seguridad
Sería decepcionante que establecieras la monitorización para aumentar la fiabilidad y, como resultado, te atacaran a través de ella, y hay muchas vulnerabilidades en diferentes herramientas de monitorización., ).
Agente (okerrmod del paquete ), que opera en el sistema, no es un servidor de red, sino un cliente. Por lo tanto, en el servidor supervisado no hay puertos abiertos adicionales, el cliente funciona fácilmente detrás de un firewall o NAT y es muy difícil (de hecho, diría que "imposible") hackearlo a través de la red, ya que en principio no escucha un socket de red.
Cobertura total de la monitorización
Ahora tenemos la regla de que nos enteramos de todos los problemas técnicos a través de okerr. Si por alguna razón esta regla se rompe (okerr no te informa sobre su inminente ocurrencia (si es posible) o sobre que ya ha ocurrido) — añadimos comprobaciones a okerr.
Comprobaciones externas
Un conjunto bastante típico:
- ping
- estado http
- verificación de la validez y frescura del certificado SSL (te alertará si está a punto de expirar)
- puerto TCP abierto y banner en él
- grep http (en la página no debe haber un texto específico)
- hash sha1 para detectar cambios en la página.
- DNS (el registro DNS debe tener un valor específico)
- WHOIS (te alertará si el dominio está a punto de caducar)
- Antispam DNSBL (comprobación del host en más de 50 listas negras de spam)
Comprobaciones internas
También, un conjunto bastante típico (pero fácilmente ampliable).
- df (espacio libre en los discos)
- promedio de carga
- opentcp (sockets TCP escuchando abiertos — notificará si algo se inicia o se cae)
- uptime — simplemente tiempo de actividad del servidor. Notificará si cambia a la baja (es decir, si el servidor se reinicia)
- client_ip
- dirsize — lo usamos para rastrear cuando nuestros rootfs de máquinas virtuales superan el tamaño permitido, sin imponer restricciones estrictas, y para los tamaños de los directorios personales de los usuarios
- empty y nonempty — controlan archivos que deben estar vacíos (o no vacíos). Por ejemplo, el registro de errores del servidor okerr — debe estar vacío, y si hay al menos una línea, recibiré una notificación y lo revisaré. En cambio, mail.log en el servidor de correo NO debe estar vacío (dentro de N minutos después de la rotación). A veces, ha estado vacío después de actualizar el sistema, cuando logrotate no pudo reiniciar correctamente rsyslog.
- linecount — número de líneas en un archivo (como wc -l). Lo usamos como un reemplazo más suave para empty, cuando el registro de errores puede crecer, pero solo lentamente (por ejemplo, Googlebot está intentando acceder a algunas páginas cerradas). Hay un límite de 2 líneas cada 20 minutos. Si supera este límite, habrá una alerta.
Comprobaciones internas interesantes
Si hasta este punto has leído «de manera superficial», ahora será más interesante leerlo con más atención.
backups
Controla las copias de seguridad en el directorio. Nuestros archivos de copias de seguridad tienen nombres como «ServerName-20200530.tar.gz». Para cada servidor, en okerr se crea un indicador ServerName-DATE.tar.gz (la fecha real cambia a la línea «DATE»). Se controla tanto la existencia de una copia de seguridad reciente como su tamaño (por ejemplo, no puede ser menor que el 90% de la copia de seguridad anterior).
¿Qué debe hacerse para que se empiece a rastrear una nueva copia de seguridad después de que comenzamos a crearla y colocarla en este directorio? ¡Nada! Este es un enfoque muy conveniente cuando no se necesita hacer «nada», porque:
- Hacer «nada» es bastante rápido, ahorra tiempo
- Es difícil olvidar hacer «nada»
- Es complicado hacer «nada» incorrectamente. Hacer nada es el método más confiable
Si de repente dejan de aparecer nuevos archivos de copia de seguridad — habrá una alerta. Si, por ejemplo, desactivaste uno de los servidores, y no debería haber más copias de seguridad suyas — necesitarás eliminar el indicador (a través de la interfaz web o desde la línea de comandos mediante API).
maxfilesz
Monitorea el tamaño de los archivos más grandes (generalmente: /var/log/*). Esto permite detectar problemas impredecibles, como ataques de fuerza bruta o envío de spam a través del servidor.
runstatus/runline
Estos son dos módulos proxy importantes para ejecutar otros programas en el servidor. Runstatus informa en el indicador el código de salida del programa. Por ejemplo, en okerr no hay (no se requiere) un módulo para verificar que los servicios de systemd estén funcionando. Esto se realiza a través de runstatus (vea más abajo). Runline — informa al servidor la línea que emite el programa. Por ejemplo, temp_RUN="cat /sys/class/thermal/thermal_zone0/temp" en la configuración de Runline en nuestro servidor crea un indicador servername:temp con la temperatura del procesador.
sql
Ejecuta una consulta numérica a MySQL y reporta el resultado en el indicador. En el caso más simple, se puede hacer, por ejemplo, "SELECT 1" — esto verifica que la base de datos en general está funcionando.
Pero una aplicación mucho más interesante es, por ejemplo, rastrear la cantidad de pedidos en una tienda en línea. Si sabes que tienes entre 100 pedidos por hora, puedes establecer un umbral mínimo de 100 o 80. Entonces, si de repente tus ventas caen, recibirás una alerta y podrás investigar.
Toma nota: no importa por qué motivo impredecible haya ocurrido esto:
- El servidor simplemente no está disponible (sin energía o sin conexión), y la alerta provino de que el indicador se "estancó".
- El servidor está sobrecargado, funciona lentamente o se pierden paquetes, los usuarios están incómodos y se marchan sin compras.
- El servidor ha sido incluido en listas de spam y su correo no es aceptado, los usuarios no pueden registrarse.
- Se ha agotado el presupuesto de la campaña publicitaria, los anuncios no se están mostrando.
Pueden haber muchas razones y no todas se pueden prever de antemano, y es técnicamente complicado rastrear. Pero se puede seguir cómodamente un parámetro final (pedidos) y determinar si la situación es sospechosa y merece ser investigada.
Indicadores lógicos
Permite utilizar expresiones lógicas (sintaxis de Python) a través del módulo (). Para la expresión están disponibles los datos del proyecto y sus indicadores. Por ejemplo, en el capítulo sobre la verificación SQL anterior, quizás notaron un punto débil: durante el día podemos tener de 100 ventas por hora, pero por la noche — 20, y eso es habitual, no es un problema. ¿Qué hacer? El indicador estará constantemente alertando por la noche.
Se pueden crear dos indicadores, uno diurno y otro nocturno. Ambos pueden ser "silenciosos" (no enviarán alertas). Y se puede crear un indicador lógico que requiera que el indicador diurno esté OK hasta las 20:00 y, después de las 20:00, que solo el indicador nocturno esté OK.
Otro ejemplo de uso de un indicador lógico es escalación. Por ejemplo, el gerente de proyecto se da de baja de las alertas (no las necesita, los administradores deben reaccionar a los problemas comunes), pero se suscribe al indicador lógico, que se pone rojo si cualquier indicador en el proyecto no se corrige en el tiempo asignado.
Además, existe la posibilidad de asignar un tiempo permitido para las operaciones, por ejemplo, de 3 a 5 de la mañana. No nos preocupa si los servidores y sitios "caen" en este período. Pero a las 5:00 deben estar funcionando. Si no lo están en cualquier otro momento, habrá una alerta. De igual manera, el indicador lógico permite tener en cuenta la reserva de servidores. Si tienes 5 servidores web, los administradores pueden apagar 1-2 servidores en cualquier momento. Pero si hay menos de 3 de 5 servidores en activo, habrá una alerta.
Los ejemplos anteriores no son funciones de okerr, no son características que deban activarse y configurarse. No hay tales funciones en okerr, pero hay un módulo lógico que permite implementar esta funcionalidad (Algo similar a los lenguajes de programación: si tenemos operadores aritméticos, no necesitamos una función especial en el lenguaje para calcular el 20% de IVA, siempre se puede hacer uno mismo según sus necesidades).
El indicador lógico es probablemente uno de los pocos temas relativamente complejos en okerr, pero la buena noticia es que no necesitas dominarlos hasta que se presente la necesidad. Sin embargo, amplían mucho las capacidades, manteniendo el sistema bastante simple.
Añadiendo sus propias verificaciones
Quisiera transmitir la idea de que okerr no es un conjunto de mil verificaciones listas para cualquier ocasión, sino más bien, en primer lugar, un motor simple con la posibilidad sencilla de crear sus propias verificaciones. Crear sus propias verificaciones en okerr no es una tarea para hackers, co-desarrolladores del sistema, o al menos para usuarios avanzados de okerr, sino una tarea accesible para cualquier administrador que instaló linux por primera vez hace un mes.
Las verificaciones mínimas se realizan a través del módulo :
Esta línea en el archivo de configuración avisará si de repente /bin/true no se inicia o devuelve un valor diferente a 0.
true_OK=\/bin\/trueSolo una línea y ya hemos ampliado un poco la funcionalidad de okerr. Incluso esta verificación ya tiene su valor: si de repente su servidor falla, el indicador correspondiente en el servidor de okerr no se actualizará a tiempo y, después de un tiempo, se generará una alerta.
Esta verificación notificará que el servidor apache2 ha caído (por si acaso…):
apache_OK="systemctl is-active --quiet apache2"
Así que, si tiene algún lenguaje de programación, al menos puede escribir scripts shell, ya puede agregar sus propias verificaciones.Más complejo: se puede escribir (en cualquier lenguaje) su propio módulo para okerrmod. En el caso más sencillo, se verá así:
¿No es verdad que no es muy difícil? El módulo debe realizar la verificación y devolver los resultados en STDOUT. Un módulo más complejo puede dar, por ejemplo, lo siguiente:
#!/usr/bin/python3

print("STATUS: OK")
$ okerrmod --dump df NAME: pi:df-\/ TAGS: df METHOD: numerical|maxlim=90 DETAILS: 49.52%, 13.9G\/28.2G usados, 13.0G libres STATUS: 49.52NAME: pi:df-\/boot TAGS: df METHOD: numerical|maxlim=90 DETAILS: 84.32%, 53.1M\/62.9M usados, 9.9M libres STATUS: 84.32
Actualiza varios indicadores a la vez (separados por una línea en blanco), crea los necesarios si es necesario, indica los detalles de la verificación y la etiqueta, para que sea fácil encontrar los indicadores necesarios en el tablero.Hay un bot de Telegram
Telegram
@OkerrBot Páginas de estado
En nuestra época, las páginas de estado son casi un requisito para cualquier negocio que tenga IT, tenga un compromiso responsable con la fiabilidad y respete a sus clientes\/usuarios.
В наше время, страницы статуса — уже почти must have для любого бизнеса у которого есть IT, ответственное отношение к надежности и который уважительно относится к своим клиентам/пользователям.
Imagina la situación: un usuario quiere hacer algo, ver información o realizar un pedido, y algo no funciona. No sabe cuál es el problema, de quién es la responsabilidad y cuándo se resolverá. ¿Quizás el sitio web de tu empresa esté inactivo? ¿O dejó de funcionar hace seis meses y no se arreglará hasta dentro de dos años? Y el refrigerador hay que comprarlo ya, está en el carrito... Es completamente diferente cuando una persona ve que algo no está bien en tu empresa (al menos queda claro que el problema no está de su lado), que el problema ha sido identificado, que ya están trabajando en ello, y que tal vez incluso han determinado un tiempo aproximado para la solución. El usuario puede suscribirse y recibir una notificación por correo cuando el problema se haya solucionado y se pueda realizar lo que quería (comprar el refrigerador).
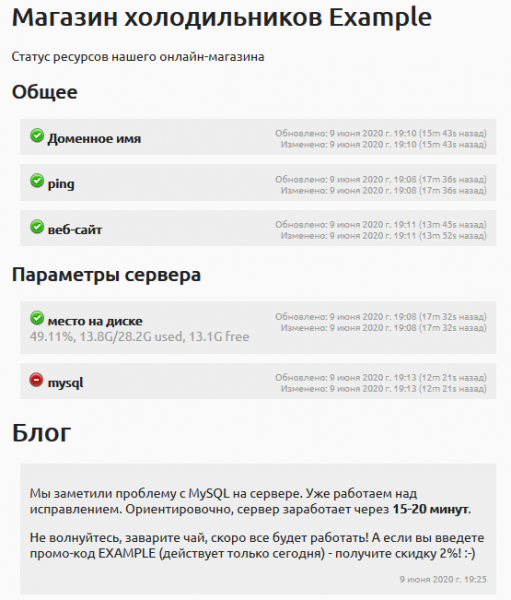
Los problemas y el tiempo de inactividad le pueden ocurrir a cualquiera. Pero los usuarios y socios confían más en aquellos que son más transparentes y se encargan de ello de manera responsable.
Aquí . Aquí hay ejemplos de cómo lucen estas páginas en otros proyectos y . .
Failover
Para no hacer este artículo aún más extenso, volveré a referirme a mi artículo anterior — . Si puedes crear un servidor redundante, con el uso de failover, en principio no tendrás largos tiempos de inactividad: tan pronto como se detecte el problema, los usuarios serán redirigidos automáticamente a un servidor de respaldo en funcionamiento. Y me parece que es una función muy interesante y destacada que escasea en otros lugares.
Bajos requisitos del sistema
Para los servidores de okerr, utilizamos máquinas con RAM desde 2Gb. Para los sensores de red, incluso 512Mb son suficientes. La parte del cliente consume casi nada. (El paquete pesa 26 Kb, pero requiere Python3 y bibliotecas estándar). El cliente se ejecuta desde un script de cron, por lo que su consumo de memoria constante es prácticamente nulo. Entre las máquinas monitorizadas, contamos con sensores (VPS muy económicos con 512Mb de RAM) y Raspberry Pi. Incluso se pueden enviar actualizaciones sin la parte del cliente ! (ver abajo)
Teniendo esto en cuenta, okerr es probablemente el más gratuito Un sistema de monitoreo que ya existe, porque incluso para usar otro sistema gratuito y de código abierto como Zabbix o Nagios, necesitas asignarle recursos (servidor), lo que ya implica un costo. Además, en cualquier caso, se requiere cierto mantenimiento del servidor. Con okerr, esta parte se puede eliminar. Pero también puedes mantenerlo y usar tu propio servidor, dependiendo de lo que prefieras.
API e integración en tu propio software
Arquitectura sencilla y abierta. okerr tiene una estructura bastante simple , con la que es fácil trabajar. ¿Necesitas crear 1000 indicadores? Un script de shell de 3-4 líneas lo hará. ¿Necesitas reconfigurar 1000 indicadores? También es muy sencillo. Por ejemplo, queremos verificar todos nuestros certificados HTTPS desde un sensor ruso:
#!/bin/sh

for indicator in `okerrclient --api-filter sslcert`
do
    echo set location for $indicator
    okerrclient --api-set location=ru retest=1 --name $indicator
done
Puedes actualizar un indicador tanto usando nuestro módulo cliente como directamente, simplemente a través de curl.
# short and nice (using okerrupdate and config file)
$ okerrupdate MyIndicator OK

# only curl is enough!
$ curl -d 'textid=MyProject&name=MyIndicator&secret=MySecret&status=OK' https://bravo.okerr.com/
Se pueden actualizar los indicadores directamente desde tu programa. Por ejemplo, enviando señales de heartbeat, para que okerr sepa que está en funcionamiento y genere una alarma si se detiene o se bloquea. Por cierto, los componentes de okerr hacen exactamente eso: okerr se monitorea a sí mismo, y los problemas en casi cualquier módulo serán detectados y generarán una notificación sobre el problema. (Y en caso de este "casi", se verifican de manera cruzada desde otro servidor)
Este es un código (simplificado) en nuestro bot de Telegram:
from okerrupdate import OkerrProject, OkerrExc

op = OkerrProject()
uptimei = op.indicator("{}:telebot_uptime".format(hostname))
...
uptimei.update('OK', 'pid: {} Uptime: {} cmds: {}'.format(
        os.getpid(), dhms(uptime), commands_cnt))
Para actualizar indicadores desde programas Python, hay una biblioteca , para otros idiomas, no hay bibliotecas, pero se puede llamar al script okerrupdate o realizar una solicitud HTTP al servidor de okerr.
Cómo nos ayuda okerr
Okerr ha cambiado nuestras vidas. De verdad. Es posible que otro sistema de monitoreo también pudiera hacerlo, pero con okerr nos resulta fácil y simple, y tiene todas las funciones que necesitábamos (y lo que no tenía, lo añadimos nosotros). Por cierto, si falta alguna función, pregúntame y la agregaré (no prometo nada, pero quiero que okerr sea el mejor sistema de monitoreo para proyectos pequeños y medianos). O, mejor aún, agrégala tú mismo, es muy sencillo.
Hemos logrado vivir bajo el principio de «enterarse de todos los problemas a través de okerr». Si de repente ocurre un problema del que no nos enteramos a través de okerr, lo añadimos a la verificación en okerr. (En este caso, al decir «nosotros», me refiero a nosotros como usuarios del sistema, no como co-desarrolladores). Al principio esto sucedía con frecuencia, pero ahora es muy raro.
Monitoreo
A través de okerr, monitoreamos el tamaño de los registros en todos los servidores. Leer cada línea del registro con atención es, por supuesto, imposible, pero simplemente seguir la velocidad de crecimiento ya proporciona mucha información. A través de esto, hemos descubierto el envío de spam, ataques de fuerza bruta para adivinar contraseñas, y cuando algunas aplicaciones «se vuelven locas», no logran algo y repiten una y otra vez (cada vez añadiendo un par de líneas al registro).
Certificados SSL. Casi inmediatamente después del lanzamiento nuestro cliente comenzó a ofrecer a sus clientes certificados SSL gratuitos (alrededor de mil de ellos). ¡Y esto resultó ser un verdadero infierno para la administración! La cuestión es que los sitios son «vivos», los clientes ocasionalmente piden que se les haga algo, los programadores lo hacen. Pueden trasladar un sitio a otro DocumentRoot, por ejemplo. O añadir un Rewrite incondicional en la configuración del VirtualHost. Naturalmente, después de eso, se rompe la actualización automática de los certificados. Ahora todos nuestros hosts SSL se añaden a okerr automáticamente a través de otra herramienta útil de nuestro paquete . Simplemente ejecutamos a2okerr.py — y si en el servidor aparecen varios sitios nuevos, se añadirán automáticamente a okerr. Si por alguna razón el certificado no se actualiza, tres semanas antes de que caduque el certificado — estamos al tanto y averiguamos por qué no se actualiza, esa perra. a2certbot.py del mismo paquete — ayuda mucho en esto (verifica inmediatamente los problemas más probables y señala lo que se revisó bien y dónde probablemente hay un problema).
Monitoreamos la fecha de caducidad de todos nuestros dominios. Y todos nuestros servidores de correo que envían correos — también son verificados por más de 50 listas negras. (Y a veces terminan en ellas). Por cierto, ¿sabías que los servidores de correo de google también están en listas negras? Simplemente para autoevaluación, añadimos mail-wr1-f54.google.com a los servidores monitoreados, ¡y efectivamente está en la lista negra SORBS! (Esto va a la cuestión del valor de los «anti-spammers»)
Las copias de seguridad: ya mencioné lo fácil que es hacer seguimiento con okerr. Pero también vigilamos las copias de seguridad recientes en nuestro servidor y (con la ayuda de una herramienta independiente que utiliza okerr) las copias de seguridad que subimos a Amazon Glacier. Y, sí, de vez en cuando ocurren problemas. No es en vano que hagamos seguimiento.
Utilizamos un indicador de escalación. Con él, se puede ver si algún problema no se ha corregido durante mucho tiempo. Y yo mismo, cuando resuelvo tareas, a veces puedo olvidar algunas. La escalación es un buen recordatorio, incluso si te supervisas a ti mismo.
En general, considero que la calidad de nuestro trabajo ha mejorado significativamente. Casi no hay tiempo de inactividad (bueno, o el cliente no tiene tiempo de notarlo. ¡Solo un shhh!), y, al mismo tiempo, la carga de trabajo ha disminuido y las condiciones de trabajo son más tranquilas. Hemos pasado de una forma de trabajo apresurada, parcheando fugas con cinta, a un trabajo más sereno y controlado, donde muchos problemas se predicen con antelación y hay tiempo para prevenirlos. Incluso los problemas que ya ocurrieron ahora son más fáciles de corregir: en primer lugar, nos enteramos de ellos antes de que los clientes entren en pánico, en segundo lugar, a menudo ocurre que el problema está relacionado con un trabajo reciente (mientras hacía una cosa, rompí otra) — así que es más fácil resolverlo sobre la marcha.
Y aquí hay otro caso...
¿Sabías que en el popular Debian 9 (Stretch) un paquete tan conocido como phpmyadmin sigue (¡ya han pasado muchos meses!) en estado vulnerable? (). Cuando la vulnerabilidad salió, rápidamente tomamos diferentes medidas para abordarla. Pero configuré en okerr el seguimiento de la página del security-tracker para saber cuándo se publicaría una solución 'bonita' (a través de la suma SHA1 del contenido). Varias veces el indicador me alertó, la página cambió, pero como puedes ver, hasta ahora (desde enero de 2019) no se indica que el problema se haya resuelto. Puede que, de hecho, alguien sepa de qué se trata el problema, que hace más de un año este paquete tan importante siga vulnerable.
Otra vez en una situación similar: después de la vulnerabilidad en SSH, fue necesario actualizar todos los servidores. Y cuando estableces una tarea, necesitas controlar su ejecución. (Los subordinados tienden a no entenderlo bien, a olvidar, a confundirse, a cometer errores). Por eso, primero agregamos en okerr una verificación de la versión de SSH en todos los servidores, y a través de okerr monitoreamos para asegurarnos de que las actualizaciones se aplicaran a todos los servidores. (¡Es conveniente! Elegí este tipo de indicador y se puede ver de inmediato en qué servidor está qué versión). Cuando nos aseguramos de que la tarea estaba completada en todos los servidores, eliminamos los indicadores.
En un par de ocasiones hubo una situación en la que surgía un problema y luego se pasaba solo. (¿A todos les suena esto?). Hasta que lo notas, hasta que lo verificas, ya no queda nada por comprobar: todo ya funciona bien. Pero luego vuelve a fallar. Esto nos ocurrió, por ejemplo, con los productos que estábamos subiendo al Amazon Marketplace (MWS). En algún momento, el inventario cargado era incorrecto (cantidades y precios erróneos). Nos dimos cuenta. Pero para resolverlo, era importante conocer el problema de inmediato. Desafortunadamente, MWS, al igual que todos los servicios de Amazon, es un poco lento, por lo que siempre había un retraso, pero aun así, logramos al menos captar de manera aproximada la conexión entre el problema y los scripts que lo causaban (hicimos una verificación, lo vinculamos a okerr y lo verificamos de inmediato al recibir una alerta).
Un caso interesante que recientemente añadió un gran y costoso host europeo, del cual es nuestro cliente. De repente, todos nuestros servidores desaparecieron de los radares. Al principio, el cliente notó por sí mismo (más rápido que Okerr) que el sitio con el que trabajaba no se abría y creó un ticket sobre esto. Pero no fue solo un sitio, ¡sino todos! (Natasha, ¡todos hemos fallado!). Entonces, Okerr comenzó a enviar largos informes con todos los indicadores que se encendieron. ¡Pánico, pánico, corremos en círculos (¿qué más se puede hacer?). Luego todo se recuperó. Resulta que había trabajos programados en el centro de datos (una vez cada muchos años) y, por supuesto, deberían haber sido avisados. Pero tuvieron algún contratiempo y no avisaron. Bueno, un infarto más o menos. Pero después de que todo se restauró, ¡hay que volver a verificar todo! No puedo imaginar cómo lo haría a mano. Okerr verificó todo en pocos minutos. Resultó que la mayoría de los servidores solo estaban temporalmente inaccesibles, pero funcionaban. Algunos se reiniciaron, pero también volvieron a estar en pie como debían. De todas las pérdidas, perdimos dos copias de seguridad que deberían haberse creado y subido mientras ocurría este completo desastre. Ni siquiera intenté crearlas, simplemente después de un día llegaron alertas de que todo estaba OK, las copias de seguridad aparecieron. Me gusta mucho este ejemplo porque Okerr resultó muy útil en una situación que ni siquiera habíamos pensado de antemano, pero esa es la tarea del monitoreo: contrarrestar lo impredecible.
Para los sensores de Okerr utilizamos hosting lo más barato posible (ya que la calidad y fiabilidad no son importantes, se aseguran mutuamente). Así que, recientemente encontramos un hosting muy vigoroso y súper barato, los benchmarks eran increíbles. Pero... a veces resulta que las conexiones salientes desde la máquina virtual se realizan desde otra IP (vecina). Maravillas. El módulo client_ip con no obtiene la IP correcta. Y también en los registros del servidor se puede ver que la actualización llegó desde esa IP vecina. Actualmente estamos resolviendo esto con el soporte. Es bueno que lo notamos en tiempos de calma. Pero, por ejemplo, a menudo sucede que el acceso se establece mediante una lista blanca de IP y, si el servidor a veces parpadea de esta manera por un corto tiempo, se puede intentar rastrear este problema durante mucho tiempo.
Y además, ya que hablamos de VPS, siempre utilizamos opciones económicas (hetzner, ovh, scaleway). Tanto por los benchmarks como por la estabilidad, nos gusta mucho. También utilizamos el más caro Amazon EC2 para otros proyectos. Así que, gracias a okerr, tenemos una opinión fundamentada. Ambos, los económicos y los más caros, fallan. Y no diría que, durante el tiempo que hemos observado, los hostings baratos como hetzner han sido notablemente menos estables que EC2. Por lo tanto, si no estás atado a otras características de Amazon, ¿por qué pagar más? 🙂
¿Qué sigue?
Si en este punto aún no te he ahuyentado demasiado de Okerr, ¡pruébalo! Directamente a través de este enlace puedes acceder a (¡Haz clic ahora!). Pero ten en cuenta que la cuenta de demostración es compartida, por lo que si estás haciendo algo, otra persona en la misma cuenta puede interferir contigo al mismo tiempo. O (mejor) regístrate a través del enlace en — es muy sencillo, sin SMS. Si no te gusta usar tu correo electrónico real, puedes usar uno desechable, como mailinator (recomiendo ). Estas cuentas pueden ser eliminadas con el tiempo, pero para pruebas son adecuadas.
Después de registrarte, se te ofrecerá realizar un entrenamiento (completar algunas tareas de capacitación no muy difíciles). Los límites iniciales son bastante bajos, pero son suficientes para entrenamiento o un servidor. Después de completar el entrenamiento, los límites (por ejemplo, el número máximo de indicadores) serán aumentados.
De la documentación, primero sobre la parte del servidor y sobre el cliente (). Pero si algo no está claro, escribe a support (at) okerr.com o deja un ticket; trataremos de resolverlo rápidamente.
Si lo vas a usar en serio y esos límites aumentados no son suficientes, también, escríbenos al soporte, lo aumentaremos (gratis).
¿Quieres instalar el servidor okerr en tu propio servidor? Aquí está . Recomendamos instalar en una virtualización limpia, así podrás hacerlo fácilmente con un script de instalación. En tu propia virtualización, no hay límites :-). Y nuevamente, si necesitas ayuda, siempre trataremos de ayudarte.
Queremos que este proyecto despegue, que el mundo se vuelva más seguro gracias a nosotros. Gracias al software y los servicios gratuitos, el mundo se ha vuelto más amigable y se desarrolla de manera más dinámica. Los códigos fuente se pueden almacenar en un github gratuito, y para el correo se puede usar gmail gratuito. Usamos gratuito para soporte. No es necesario pagar por servidores, no necesitas descargar ni configurar, ni resolver diferentes problemas de operación. Cada nuevo proyecto, cada equipo, tiene de inmediato tanto correo como repositorios y CRM. Y todo esto es de muy alta calidad, gratuito y disponible inmediatamente. Queremos que para el monitoreo sea lo mismo: pequeñas empresas y proyectos podrían usar okerr de forma gratuita y, incluso en la etapa de nacimiento y crecimiento, tener la fiabilidad de proyectos serios y establecidos.
Fuente: habr.com
