

Hola a todos, me llamo Sergey Emelyanchik. Soy el director de la empresa Audit-Telecom, el principal desarrollador y autor del sistema Veliam. Decidí escribir un artículo sobre cómo mi amigo y yo creamos una empresa de outsorcing, desarrollamos software para nosotros y posteriormente comenzamos a distribuirlo a todos los interesados a través del sistema SaaS. Sobre cómo yo no creía en absoluto que esto fuera posible. En el artículo habrá no solo una historia, sino también detalles técnicos sobre cómo se creó el producto Veliam. Incluyendo algunos fragmentos del código fuente. Contaré qué errores cometimos y cómo los corregimos después. Tenía dudas sobre si publicar un artículo así. Pero pensé que era mejor hacerlo, obtener retroalimentación y mejorar, que no publicar y quedarme pensando en lo que podría haber sido…
Antecedentes
Trabajé en una empresa como empleado de TI. La empresa era bastante grande con una estructura de red extensa. No me detendré en mis deberes, solo diré que definitivamente no incluían desarrollar nada.
Teníamos monitoreo, pero por pura curiosidad académica, quería intentar escribir uno propio. La idea era que fuera web, para poder acceder fácilmente sin instalar clientes y ver qué estaba pasando en la red desde cualquier dispositivo, incluyendo dispositivos móviles a través de Wi-Fi, y también quería comprender rápidamente en qué habitación se encontraba el equipo que "se había puesto enfermo", ya que había requisitos bastante estrictos sobre el tiempo de respuesta ante tales problemas. Al final, se me ocurrió el plan de escribir una simple página web, que tendría un fondo JPEG con el esquema de la red, recortar los dispositivos con sus direcciones IP de esa imagen, y mostrar el contenido dinámico sobre la imagen en las coordenadas adecuadas con una dirección IP verde o parpadeante en rojo. La tarea estaba planteada, comencemos.
Anteriormente, programé en Delphi, PHP, JS y un poco de C++. Conozco bastante bien el funcionamiento de redes. VLAN, Routing (OSPF, EIGRP, BGP), NAT. Eso fue suficiente para poder escribir un prototipo de monitoreo primitivo por mi cuenta.
Escribí lo planeado en PHP. El servidor Apache y PHP estaba en Windows porque Linux para mí en ese momento era algo incomprensible y muy complicado. Como resultó más tarde, estaba muy equivocado y en muchos sentidos, Linux es mucho más fácil que Windows, pero ese es un tema aparte y sabemos cuántas controversias hay al respecto. El programador de tareas de Windows ejecutaba cada cierto intervalo (no recuerdo con precisión, pero algo así como una vez cada tres segundos) un script PHP que sondeaba todos los objetos con un simple ping y guardaba el estado en un archivo.
system(“ping -n 3 -w 100 {$ip_address}“);
Sí, en ese momento también tenía dificultades con las bases de datos. No sabía que se podía paralelizar procesos, y la revisión de todos los nodos de la red tomaba mucho tiempo porque ocurría en un solo hilo. Especialmente surgían problemas cuando varios nodos estaban inactivos, ya que cada uno de ellos retrasaba el script 300 ms. En el lado del cliente había una simple función cíclica que cada pocos segundos descargaba información actualizada del servidor mediante una solicitud Ajax y actualizaba la interfaz. Y después de tres pings fallidos consecutivos, si había una página web abierta en la computadora con el monitoreo, sonaba una alegre melodía.
Cuando todo salió bien, me sentí muy inspirado por el resultado y pensé que podría agregar más (dadas mis habilidades y posibilidades). Pero siempre he despreciado los sistemas con millones de gráficos, que considero, y sigo considerando hasta el día de hoy, en la mayoría de los casos innecesarios. Quería añadir solo lo que realmente me ayudaría en mi trabajo. Este principio se mantiene hasta hoy como fundamental en el desarrollo de Veliam. Luego, comprendí que sería genial si no tuviera que mantener la monitorización abierta y saber sobre los problemas, y que cuando ocurriera uno, pudiera abrir la página y ver dónde estaba el nodo problemático de la red y qué hacer con él. En aquel entonces, no leía el correo electrónico, simplemente no lo usaba. Encontré en internet que existen puertas de enlace SMS, a las que se puede enviar una solicitud GET o POST, y me enviarán a mi teléfono móvil un SMS con el texto que escriba. Inmediatamente supe que quería eso. Y comencé a estudiar la documentación. Después de un tiempo, lo logré, y ahora recibía mensajes SMS sobre problemas en la red en mi móvil con el nombre del “objeto caído”. Aunque el sistema era primitivo, fue creado por mí, y lo más importante que me motivó a desarrollarlo fue que era un programa práctico que realmente me ayuda en mi trabajo.
Y llegó el día en que uno de los canales de internet en el trabajo falló, pero mi monitorización no me dio ninguna señal al respecto. Como los DNS de Google aún respondían perfectamente. Era hora de pensar en cómo podría monitorizar que el canal de comunicación estuviese activo. Hubo diferentes ideas sobre cómo hacerlo. No tenía acceso a todo el equipo. Tenía que idear una forma de entender cuál de los canales estaba vivo, pero sin poder observar esto en el propio equipo de red. Entonces, un colega me sugirió que tal vez el trazado de la ruta hacia los servidores públicos puede diferir dependiendo de qué canal de comunicación se utilice para salir a internet. Comprobé y resultó ser cierto. Había diferentes rutas al hacer el trazado.
system(“tracert -d -w 500 8.8.8.8”);
Así apareció otro script, o más bien, la trazabilidad fue añadida innecesariamente al final del mismo script que hacía ping a todos los dispositivos de la red. Era otro proceso largo que se ejecutaba en el mismo hilo y ralentizaba el funcionamiento de todo el script. Pero en ese momento no era tan obvio. De cualquier manera, cumplía su función, ya que en el código estaba fijado cuál debía ser la trazabilidad de cada uno de los canales. Así fue como comenzó a funcionar el sistema que ya monitorizaba (término que se utiliza en exceso, ya que no se recogían métricas, solo se realizaba un ping) los dispositivos de red (enrutadores, switches, wi-fi, etc.) y los canales de comunicación con el mundo exterior. Los SMS llegaban puntualmente y en el diagrama siempre se podía ver claramente dónde estaba el problema.
Después, en el trabajo cotidiano, tenía que encargarme de la cruzada de conexiones. Cada vez que tenía que acceder a los switches de Cisco para ver qué interfaz usar, me resultaba tedioso. Hubiera sido genial hacer clic en el monitoreo del objeto y ver una lista de sus interfaces con descripciones. Eso me hubiera ahorrado tiempo. Además, en este esquema no tendría que haber lanzado PuTTY o SecureCRT, ingresar credenciales y comandos. Simplemente hacía clic en el monitoreo, veía lo que necesitaba y continuaba con mi trabajo. Comencé a buscar cómo podía interactuar con los switches. A primera vista, me encontré con dos opciones: SNMP o acceder al switch por SSH, introducir los comandos necesarios y analizar el resultado. Descarté SNMP debido a su complejidad de implementación, no podía esperar para obtener el resultado. Con SNMP tendría que haber indagado mucho en el MIB para generar datos sobre las interfaces. Hay un comando maravilloso en CISCO.
show interface statusMuestra exactamente lo que necesito para las inspecciones. ¿Para qué sufrir con SNMP cuando solo quiero ver la salida de este comando?, pensé. Después de un tiempo, implementé esa funcionalidad. Hacía clic en el objeto en la página web. Se activaba un evento que hacía que, mediante AJAX, el cliente se conectara al servidor, y este, a su vez, se conectaba por SSH al switch que necesitaba (las credenciales estaban incrustadas en el código, no había ganas de mejorar, de hacer menús separados donde podría cambiar las credenciales desde la interfaz, solo necesitaba el resultado y rápido) ingresaba allí el comando mencionado y lo devolvía de nuevo al navegador. Así comencé a ver la información de las interfaces con un solo clic del mouse. Era extremadamente conveniente, especialmente cuando tenía que ver esta información en varios switches al mismo tiempo.
El monitoreo de canales basado en trazas resultó no ser la mejor idea, ya que a veces se realizaban trabajos en la red, y la traza podía cambiar, lo que hacía que el monitoreo comenzara a gritarme que había problemas con el canal. Después de gastar un montón de tiempo en el análisis, me daba cuenta de que todos los canales estaban funcionando, pero mi monitoreo me engañaba. Al final, les pedí a mis colegas que administraban los switches que generaban los canales que simplemente me enviaran syslog cuando cambiara el estado de visibilidad de los vecinos. Por lo tanto, era mucho más sencillo, rápido y veraz que la traza. Cuando llegaba un evento de tipo vecino perdido, inmediatamente hacía una alerta sobre la caída del canal.
Luego, aparecieron salidas por clic en el objeto, algunas otras órdenes y se añadió SNMP para recopilar algunas métricas, y en este sentido, eso fue todo. El sistema no desarrolló más allá de eso. Hacía todo lo que necesitaba, era una buena herramienta. Muchos lectores probablemente me dirán que ya hay un montón de software en Internet para resolver estas tareas. Pero en realidad, no encontré productos gratuitos como esos en ese momento y realmente quería desarrollar habilidades de programación, y qué mejor que una tarea aplicada real para motivar eso. Así fue como la primera versión del monitoreo se completó y no se modificó más.
Creación de la empresa Audit-Telecom
Con el tiempo, empecé a trabajar paralelamente en otras empresas, ya que mi horario laboral me lo permitía. Trabajar en diferentes compañías acelera rápidamente el desarrollo de habilidades en diversas áreas y amplia tu perspectiva. Hay empresas en las que, como se dice, eres un poco de todo. Por un lado, esto es complicado, pero por otro lado, si no eres perezoso, te conviertes en un especialista versátil, lo que te permite resolver tareas más rápida y eficazmente porque sabes cómo funciona el área relacionada.
Mi amigo Pavel (también en el sector de TI) intentaba constantemente motivarme a iniciar un negocio propio. Hubo innumerables ideas con diversas variantes de emprendimiento. Esto se discutió durante varios años. Y al final, no llegamos a nada porque yo soy escéptico y Pavel es un soñador. Cada vez que proponía alguna idea, yo siempre desconfiaba y me negaba a participar. Pero realmente queríamos abrir nuestro propio negocio.
Finalmente, pudimos encontrar una opción que satisficiera a ambos y dedicarnos a lo que sabemos hacer. En 2016, decidimos crear una empresa de TI que ayudaría a los negocios a resolver problemas relacionados con la tecnología. Esto incluye la implementación de sistemas de TI (1C, servidores de terminales, servidores de correo, etc.), su mantenimiento, un HelpDesk clásico para usuarios y administración de redes.
Sinceramente, en el momento de crear la empresa, no creía en ella aproximadamente en un 99,9%. Pero de alguna manera, Pavel logró que lo intentara y, adelantándome, resultó tener razón. Pavel y yo aportamos 300,000 rublos cada uno, registramos una nueva LLC llamada “Audit-Telecom”, alquilamos una pequeña oficina, hicimos tarjetas de visita increíbles, y en general, como probablemente la mayoría de los empresarios principiantes e inexpertos, comenzamos a buscar clientes. La búsqueda de clientes es toda una historia. Posiblemente escribamos un artículo separado para el blog corporativo si a alguien le interesa. Llamadas en frío, volantes, y demás. Esto no dio resultados. Como leo ahora en muchas historias sobre negocios, en gran medida, todo depende de la suerte. Tuvimos suerte. Y literalmente un par de semanas después de la creación de la empresa, mi hermano Vladimir se acercó a nosotros, quien nos trajo nuestro primer cliente. No quiero abrumar con los detalles del trabajo con los clientes, el artículo no es sobre eso, solo diré que hicimos una auditoría, identificamos los puntos críticos y esos puntos fallaron mientras se tomaba la decisión de si colaborar con nosotros de forma permanente como externalizadores. Después de eso, se tomó de inmediato una decisión positiva.
Luego, en su mayoría a través del boca a boca, comenzaron a aparecer otras empresas para nuestro servicio. El helpdesk estaba en un sistema. Las conexiones con el equipo de red y servidores en otro, o más bien, dependiendo de cada uno. Algunos guardaban accesos directos, otros utilizaban libretas de direcciones RDP. El monitoreo, otra sistema aparte. Trabajar en sistemas dispersos es muy incómodo para el equipo. Se pierde información importante. Por ejemplo, si el servidor terminal del cliente deja de estar disponible. De inmediato, llegan solicitudes de los usuarios de ese cliente. El especialista de soporte crea una solicitud (que llegó por teléfono). Si los incidentes y las solicitudes se registraran en un solo sistema, el especialista de soporte vería inmediatamente cuál era el problema del usuario y se lo comunicaría, mientras se conecta al objeto necesario para atender la situación. Todos están al tanto de la situación táctica y trabajan de manera coordinada. No encontramos un sistema donde todo esto estuviera integrado. Se hizo evidente que era hora de crear nuestro propio producto.
Continuación del trabajo en nuestro propio sistema de monitoreo
Era evidente que el sistema desarrollado anteriormente no se adaptaba a las necesidades actuales, ni en funcionalidad ni en calidad. Se tomó la decisión de construir un sistema desde cero. Gráficamente, esto debería haber sido muy diferente. Debía ser un sistema jerárquico para abrir fácilmente el objeto necesario para el cliente adecuado. La estructura de la primera versión no era razonable en este caso, ya que los clientes eran diversos y no importaba en qué instalaciones se encontraba el equipo. Esto ya estaba abordado en la documentación.
Así que, las tareas:
- Estructura jerárquica;
- Una parte del servidor que se puede colocar en el cliente en forma de máquina virtual para recopilar las métricas necesarias y enviarlas a un servidor central que las agregará y nos las mostrará;
- Notificaciones. Aquellas que no se pueden perder, ya que en ese momento no había forma de que alguien se quedara mirando la pantalla;
- Sistema de solicitudes. Comenzaron a aparecer clientes a los que atendíamos no solo el equipo de servidores y redes, sino también estaciones de trabajo;
- Capacidad de conectarse rápidamente a los servidores y equipos desde el sistema;
Las tareas estaban definidas, comenzamos a escribir. A la par, íbamos procesando las solicitudes de los clientes. En ese momento éramos cuatro personas. Empezamos a desarrollar ambas partes, tanto el servidor central como el servidor para la instalación en los clientes. Para este momento, Linux ya no era desconocido para nosotros y se decidió que las máquinas virtuales en los clientes serían con Debian. No habría instaladores, solo crearíamos el proyecto de la parte del servidor en una máquina virtual específica y luego simplemente la clonaremos para el cliente necesario. Este fue otro error. Luego quedó claro que en esta estructura no se había trabajado adecuadamente en el mecanismo de actualizaciones. Es decir, agregábamos alguna nueva función y luego había todo un problema para distribuirla a todos los servidores de los clientes, pero volveremos a esto más adelante, todo a su debido tiempo.
Creamos el primer prototipo. Podía hacer ping a los dispositivos de red necesarios de nuestros clientes y a los servidores, y enviar estos datos a nuestro servidor central. A su vez, este actualizaba esos datos en el conjunto general del servidor central. Aquí escribiré no solo la historia de cómo y qué se logró, sino también cuáles errores de principiantes se cometieron y cómo después tuvimos que pagar por ello en tiempo. Así que, todo el árbol de objetos se almacenaba en un único archivo en forma de objeto serializado. Mientras conectamos a la sistema algunos clientes, todo estaba más o menos bien, aunque a veces había algunos artefactos que eran completamente incomprensibles. Pero cuando conectamos una docena de servidores al sistema, comenzaron a suceder maravillas. A veces, por razones incomprensibles, todos los objetos en el sistema simplemente desaparecían. Es importante señalar que los servidores que tenían los clientes enviaban datos al servidor central cada pocos segundos mediante solicitudes POST. El lector atento y el programador experimentado ya se habrán dado cuenta de que surgió un problema de acceso múltiple a ese mismo archivo en el que se almacenaba el objeto serializado desde diferentes hilos simultáneamente. Y justo cuando esto ocurría, surgían maravillas con la desaparición de objetos. El archivo simplemente se volvía vacío. Pero esto no se descubrió de inmediato, sino solo en el proceso de explotación con varios servidores. Durante este tiempo, se agregó funcionalidad para el escaneo de puertos (los servidores enviaban al central no solo información sobre la disponibilidad de los dispositivos, sino también sobre los puertos abiertos en ellos). Esto se hizo llamando al comando:
$connection = @fsockopen($ip, $port, $errno, $errstr, 0.5);
los resultados a menudo eran incorrectos y el escaneo se realizaba muy lentamente. Casi olvido el ping, que se ejecutaba a través de fping:
system("fping -r 3 -t 100 {$this->ip}");
Esto tampoco se había paralelizado y, por lo tanto, el proceso era muy lento. Más tarde, en fping se pasó toda la lista de direcciones IP necesarias para verificar y recibimos de vuelta la lista de aquellos que respondieron. A diferencia de nosotros, fping podía paralelizar procesos.
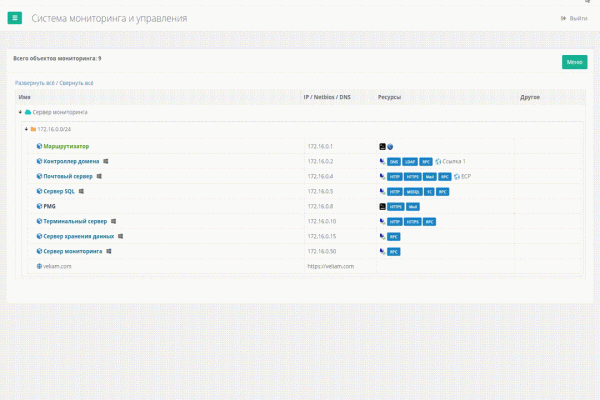
Otro trabajo rutinario frecuente era configurar ciertos servicios a través de la WEB. Por ejemplo, el ECP de MS Exchange. En realidad, es solo un enlace. Así que decidimos que debíamos permitirnos agregar estos enlaces directamente en el sistema, para no tener que buscar en la documentación o en marcadores cómo acceder al ECP de un cliente específico. Así nació el concepto de enlaces de recursos para el sistema, su funcionalidad está disponible hasta el día de hoy y no ha sufrido cambios, bueno, casi.
Funcionalidad de los enlaces de recursos en Veliam
Conexiones remotas
Así es como se ve en acción en la versión actual de Veliam
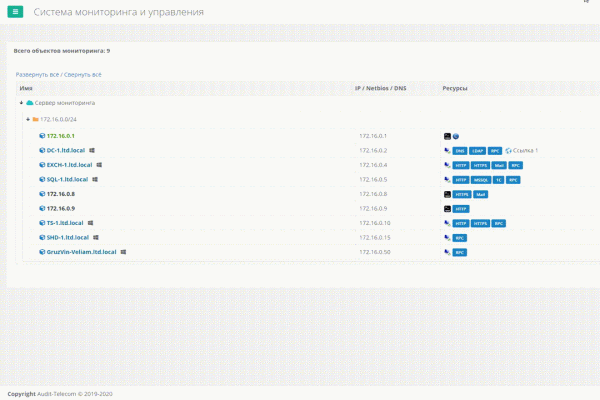
Una de las tareas era la conexión rápida y conveniente a servidores, que ya eran muchos (más de cien) y era extremadamente incómodo recorrer millones de accesos directos RDP guardados previamente. Se necesitaba una herramienta. Hay software en internet que funciona como una especie de agenda de contactos para estas conexiones RDP, pero no están integrados con el sistema de monitoreo y no se pueden guardar las cuentas. Introducir cuentas diferentes para varios clientes cada vez es un verdadero desastre, especialmente cuando te conectas decenas de veces al día a diferentes servidores. Con SSH la situación es un poco mejor, hay mucho buen software que permite organizar estas conexiones en carpetas y recordar las cuentas de usuario. Pero hay 2 problemas. Primero: para las conexiones RDP y SSH no encontramos un programa único. Segundo: si en algún momento no estoy en mi computadora y necesito conectarme rápidamente, o simplemente reinstalé el sistema, tendré que recurrir a la documentación para ver la cuenta de este cliente. Eso es incómodo y una pérdida de tiempo.
La estructura jerárquica que necesitábamos para los servidores de los clientes ya existía en nuestro producto interno. Solo había que idear cómo integrar conexiones rápidas al equipo necesario. Para empezar, al menos dentro de nuestra propia red.
Dado que el cliente en nuestro sistema era un navegador que no tiene acceso a los recursos locales de la computadora para simplemente ejecutar una aplicación necesaria con un comando, se ideó realizar todo a través del "esquema de URL personalizado de Windows". Así apareció un "plugin" en nuestro sistema que simplemente incluía Putty y Remote Desktop Plus, y al instalarlo, registraba la URI en Windows. Ahora, cuando queríamos conectarnos a un objeto por RDP o SSH, hacíamos clic en esta acción en nuestro sistema y se activaba el Custom URI. Se iniciaba el estándar mstsc.exe integrado en Windows o putty, que venía con el "plugin". Uso la palabra plugin entre comillas porque no es un plugin de navegador en el sentido clásico.
Esto era al menos algo. Una libreta de direcciones conveniente. Además, en el caso de Putty, todo iba realmente bien, ya que podía recibir como parámetros de entrada tanto la IP de conexión como el nombre de usuario y la contraseña. Es decir, nos conectábamos a servidores Linux en nuestra red con un solo clic sin necesidad de ingresar contraseñas. Pero con RDP no todo era tan simple. En el mstsc estándar no se pueden proporcionar las credenciales como parámetros. Aquí es donde Remote Desktop Plus fue de ayuda, permitiendo hacerlo. Ahora ya podemos prescindir de él, pero durante mucho tiempo fue un compañero fiel en nuestro sistema. Con los sitios HTTP(S) todo era simple, esos objetos simplemente se abrían en el navegador y ya está. Conveniente y práctico. Pero esa fue felicidad solo en la red interna.
Dado que la gran mayoría de los problemas los resolvíamos de forma remota desde la oficina, lo más sencillo era establecer VPN con los clientes. Entonces, desde nuestro sistema, podíamos conectarnos a ellos. Pero aún así era un poco incómodo. Para cada cliente había que mantener un montón de conexiones guardadas en cada computadora, y antes de conectarse a cualquiera, había que activar la VPN correspondiente. Utilizamos esa solución durante bastante tiempo. Pero el número de clientes estaba aumentando, el número de VPN también, y todo esto comenzó a generar tensión y había que hacer algo al respecto. Especialmente lloraba cuando se reinstalaba el sistema, cuando había que ingresar de nuevo decenas de conexiones VPN en un nuevo perfil de Windows. ¡Basta de aguantar esto!, dije, y comencé a pensar en qué se podía hacer. VPN He decidido que tengo que buscar una solución más eficiente. No quiero más complicaciones ni pérdidas de tiempo innecesarias. Estoy convencido de que existe una forma de simplificar este proceso y mejorar la gestión de nuestras conexiones a clientes. La planificación y el uso de un software adecuado podría ser clave para convertir este desafío en una experiencia más fluida y productiva.
Es una costumbre que todos los clientes tengan como routers dispositivos de la conocida marca Mikrotik. Son bastante funcionales y convenientes para realizar prácticamente cualquier tarea. Entre sus desventajas, está el hecho de que son 'secuestrados'. Hemos resuelto este problema de manera sencilla, cerrando todos los accesos desde el exterior. Pero necesitábamos tener acceso a ellos sin tener que ir al cliente, ya que eso llevaría mucho tiempo. Así que simplemente creamos túneles hacia cada uno de esos Mikrotik y los agrupamos en un conjunto separado, sin ningún tipo de enrutamiento, para evitar la unión de nuestra red con las redes de los clientes y entre sí.
Nació la idea de que, al hacer clic en el objeto deseado en el sistema, el servidor central de monitoreo, conociendo las credenciales SSH de todos los Mikrotik de los clientes, se conectara al necesario, creando una regla de redirección hacia el host específico con el puerto correspondiente. Aquí hay varios puntos a considerar. La solución no es universal — funcionará solo para Mikrotik, ya que la sintaxis de los comandos varía entre routers. Además, estas redirecciones debían eliminarse de alguna manera, y la parte del servidor de nuestro sistema no podía rastrear de ninguna manera si había terminado mi sesión de trabajo por RDP. Y una redirección de este tipo es una brecha para el cliente. No perseguimos la universalidad, ya que el producto se utilizaba solo dentro de nuestra empresa y ni siquiera se pensó en hacerlo público.
Cada uno de los problemas se resolvió a su manera. Al crear una regla, esta redirección solo estaba disponible para una dirección IP externa específica (desde la cual se había iniciado la conexión). De esa manera, se logró evitar brechas en la seguridad. Pero con cada conexión de este tipo, se añadía una regla en el Mikrotik en la página NAT y no se limpiaba. Y es bien sabido que cuanto más reglas hay, mayor es la carga en el procesador del router. En general, no podía aceptar que entrara una vez en algún Mikrotik y encontrara cientos de reglas muertas que no eran útiles para nadie.
Dado que nuestro servidor no puede rastrear el estado de la conexión, dejemos que MikroTik lo rastree por sí mismo. Escribí un script que monitoreaba constantemente todas las reglas de redirección con una descripción específica y verificaba si había alguna conexión TCP correspondiente a dicha regla. Si no había habido ninguna durante un tiempo determinado, probablemente la conexión ya se había cerrado y esta redirección se podía eliminar. Todo funcionó, el script funcionaba bien.
Por cierto, aquí está:
global atmonrulecounter {"dontDelete"="dontDelete"}
:foreach i in=[/ip firewall nat find comment~"atmon_script_main"] do={
	local dstport [/ip firewall nat get value-name="dst-port" $i]
	local dstaddress [/ip firewall nat get value-name="dst-address" $i]
	local dstaddrport "$dstaddress:$dstport"
	#log warning message=$dstaddrport
	local thereIsCon [/ip firewall connection find dst-address~"$dstaddrport"]
	if ($thereIsCon = "") do={
		set ($atmonrulecounter->[$dstport]) ($atmonrulecounter->[$dstport] + 1)
		#:log warning message=($atmonrulecounter->[$dstport])
		if (($atmonrulecounter->[$dstport]) > 5) do={
			#log warning message="Removing nat rules added automatically by atmon_script"
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_main_$dstport"]
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_sub_$dstport"]
			set ($atmonrulecounter->[$dstport]) 0
		}
	} else {
		set ($atmonrulecounter->[$dstport]) 0
	}
}
Seguramente podría haberlo hecho más bonito, rápido, etc., pero funcionaba, no sobrecargaba los MikroTik y se desempeñaba excelentemente. Finalmente pudimos conectarnos a los servidores y equipos de red de los clientes con solo un clic. Sin levantar VPN ni ingresar contraseñas. Trabajar con el sistema se volvió realmente muy conveniente. El tiempo de mantenimiento se redujo, y todos gastamos tiempo trabajando, no conectándonos a los objetos necesarios.
Respaldo de Mikrotik
Teníamos configurado el respaldo de todos los MikroTik en FTP. En general, todo estaba bien. Pero cuando necesitábamos acceder a un backup, teníamos que abrir ese FTP y buscarlo allí. Teníamos un sistema donde tengamos todos los routers registrados, sabemos comunicarnos con los dispositivos a través de SSH. ¿Por qué no hacer que el sistema recoja diariamente los backups de todos los MikroTik?, pensé. Y me puse a implementarlo. Nos conectamos, hicimos el backup y lo llevamos al almacenamiento.
Código del script en PHP para realizar el backup desde MikroTik:
<?php

	$IP = '0.0.0.0';
	$LOGIN = 'admin';
	$PASSWORD = '';
	$BACKUP_NAME = 'test';

    $connection = ssh2_connect($IP, 22);

    if (!ssh2_auth_password($connection, $LOGIN, $PASSWORD)) exit;

    ssh2_exec($connection, '\/system backup save name="atmon" password="atmon"');
    stream_get_contents($connection);
    ssh2_exec($connection, '\/export file="atmon.rsc"');
    stream_get_contents($connection);
    sleep(40);

    $sftp = ssh2_sftp($connection);

    \/ Download backup file
    $size = filesize("ssh2.sftp:\/\/{$sftp}\/atmon.backup");
    $stream = fopen("ssh2.sftp:\/\/{$sftp}\/atmon.backup", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read < $len && ($buf = fread($stream, $len - $read))) {
        $read += strlen($buf);
        $contents .= $buf;
    }
    file_put_contents ($BACKUP_NAME . '.backup',$contents);
    @fclose($stream);

    sleep(3);
    \/ Download RSC file
    $size = filesize("ssh2.sftp:\/\/{$sftp}\/atmon.rsc");
    $stream = fopen("ssh2.sftp:\/\/{$sftp}\/atmon.rsc", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read
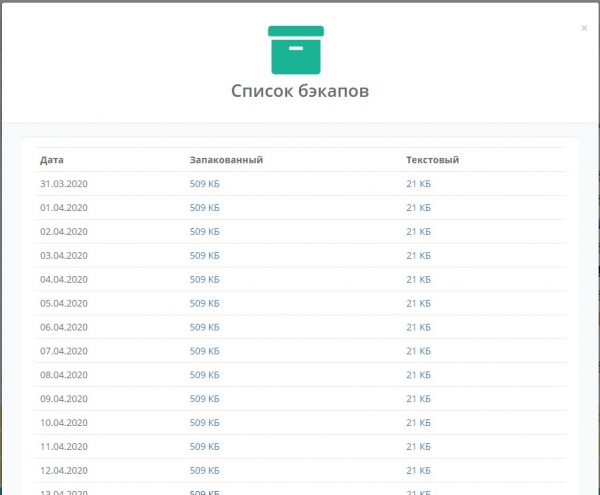
La copia de seguridad se realiza en dos formatos: binario y configuración de texto. El formato binario ayuda a restaurar rápidamente la configuración necesaria, mientras que el formato de texto permite entender qué hacer en caso de un reemplazo forzado de equipo, cuando no se puede cargar el binario. Al final, obtuvimos una funcionalidad adicional conveniente en el sistema. De hecho, al agregar nuevos Mikrotik, no fue necesario configurar nada; simplemente se añadió el objeto al sistema y se estableció la cuenta SSH. Luego, el sistema se encargó automáticamente de realizar las copias de seguridad. En la versión actual de Veliam SaaS, esta funcionalidad aún no está disponible, pero pronto la portaremos.
Capturas de pantalla de cómo se veía en el sistema interno
Transición a un almacenamiento adecuado en la base de datos
Anteriormente mencioné que aparecían artefactos. A veces desaparecía toda la lista de objetos en el sistema, otras veces, al editar un objeto, la información no se guardaba y tenía que renombrar el objeto tres veces. Esto irritaba a todos. La desaparición de objetos ocurría raramente y se podía restaurar fácilmente recuperando ese mismo archivo, pero el fallo al editar objetos era algo frecuente. Probablemente, al principio no lo hice a través de la base de datos porque no entendía cómo se podía mantener un árbol con todas sus relaciones en una tabla plana. Es plano, mientras que el árbol es jerárquico. Sin embargo, una buena solución para el acceso múltiple, y posteriormente (al complicarse el sistema) para las transacciones, es una base de datos. Seguramente no soy el primero en enfrentar este problema. Comencé a investigar en Google. Resultó que ya se había pensado en esto antes y existen varios algoritmos que construyen un árbol a partir de una tabla plana. Después de revisar cada uno, implementé uno de ellos. Pero esta ya era una nueva versión del sistema, ya que en esencia reescribirlo debido a esto significó hacer un gran esfuerzo. El resultado fue predecible, los problemas de comportamiento aleatorio del sistema desaparecieron. Alguien podría decir que estos errores son bastante primitivos (scripts de un solo hilo, almacenamiento de información con acceso concurrente desde diferentes hilos en un archivo, etc.) en el ámbito del desarrollo de software. Puede que así sea, pero mi trabajo principal era la administración, mientras que la programación era algo secundario que hacía por diversión, y simplemente no tenía experiencia trabajando en un equipo de programadores, donde estos aspectos elementales me habrían sido señalados de inmediato por colegas más experimentados. Así que acumulé todas estas lecciones por mí mismo, pero entendí muy bien el material. Además, mi trabajo implica tanto reuniones con clientes como acciones dirigidas a intentar promocionar la empresa, una gran cantidad de cuestiones administrativas dentro de la compañía y mucho más. Pero de una manera u otra, lo que había ya era demandado. Los chicos y yo mismo utilizábamos el producto en nuestro trabajo diario. Hubo ideas que fueron abiertamente malogradas, y soluciones que consumieron tiempo y que al final se entendió que eran herramientas ineficaces y que nadie las utilizaba, y eso no llegó a Veliam.
Servicio de soporte — HelpDesk
No estará de más mencionar cómo se formó el HelpDesk. Esta es en realidad una historia aparte, ya que en Veliam es la tercera versión completamente nueva, que se diferencia de todas las anteriores. Ahora es un sistema simple, intuitivo, sin adornos innecesarios y con la posibilidad de integrarse con el dominio, así como el acceso a este mismo perfil de usuario desde cualquier lugar a través de un enlace en el correo. Y lo más importante, hay la posibilidad de conectarse desde cualquier lugar (ya sea en casa o en la oficina) al solicitante a través de VNC directamente desde la solicitud, sin VPN ni redireccionamientos de puertos. Les contaré cómo llegamos a esto, qué había antes y qué soluciones horribles se han utilizado.
Nos conectábamos a los usuarios a través del famoso TeamViewer. En todas las computadoras de los usuarios a los que atendemos, se instala TV. Lo primero que hicimos mal y luego eliminamos fue vincular cada cliente a su hardware. ¿Cómo entraba un usuario al sistema HD para dejar una solicitud? En todas las computadoras, además de TV, había una utilidad especial escrita en Lazarus (aquí muchos pondrán los ojos en blanco y tal vez incluso busquen qué es eso, pero lo mejor que sabía de los lenguajes compilables era Delphi, y Lazarus es casi lo mismo, solo que gratuito). En resumen, el usuario ejecutaba un script especial que lanzaba esta utilidad, la cual leía el HWID del sistema y después se abría el navegador y se realizaba la autorización. ¿Por qué se hizo esto? En algunas empresas, el conteo de los usuarios atendidos se realiza uno a uno, y el precio del servicio cada mes se calcula según la cantidad de personas. Esto está claro, dirás tú, pero ¿por qué vinculación al hardware? Muy simple, algunas personas volvían a casa y hacían solicitudes desde su computadora portátil en plan “hagan que todo se vea bonito aquí”. Además de leer el HWID del sistema, la utilidad extraía del registro el ID actual de TeamViewer y también lo enviaba a nosotros. TeamViewer tiene una API para integración. Y realizamos esta integración. Pero había un problema. A través de esta API no se puede conectar a la computadora del usuario a menos que él inicie claramente esa sesión, y después de intentar conectarse, también tiene que hacer clic en “confirmar”. En ese momento, nos pareció lógico que sin el permiso del usuario, nadie debería conectarse, y dado que la persona está frente a la computadora, ella también inicia la sesión y responde afirmativamente a la solicitud de conexión remota. Resultó que no era así. Los solicitantes olvidaban iniciar la sesión, y teníamos que decírselo en una llamada telefónica. Esto consumía tiempo y frustraba a ambas partes del proceso. Más aún, no era raro que alguien dejara una solicitud, pero solo permitiera la conexión cuando se iba a almorzar. Porque el problema no es crítico y no quiere que su flujo de trabajo se interrumpa. Por lo tanto, no hará clic en ningún botón para permitir la conexión. Así fue como surgió una funcionalidad adicional al autorizarse en HelpDesk: la lectura del ID de TeamViewer. Conocíamos la contraseña constante que se usaba al instalar TeamViewer. Mejor dicho, solo lo conocía el sistema, ya que estaba incrustada en el instalador y en nuestro sistema. Por lo tanto, había un botón de conexión en la solicitud, y al hacer clic en él, no había que esperar nada, se abría TeamViewer de inmediato y se establecía la conexión. Al final, había dos tipos posibles de conexiones. A través de la API oficial de TeamViewer y nuestra versión improvisada. Para mi sorpresa, casi de inmediato dejaron de usar la primera, aunque se indicó que se utilizara solo en casos especiales y cuando el usuario mismo lo permitiera. Después de todo, ahora se exige seguridad. Pero resultó que a los solicitantes no les importaba. No tienen problemas en que los conecten sin la tecla de confirmación. Y dado que así es, en el futuro se eliminó la funcionalidad de conexión a través de la API por falta de necesidad.
Transición a la multiprocesamiento en Linux
Ya se había planteado la cuestión de acelerar el escaneo de red para la apertura de una lista predefinida de puertos y la simple verificación de objetos de red. La primera solución obvia que viene a la mente es la multiprocesamiento. Dado que el tiempo principal que se gasta en el ping es la espera del regreso del paquete, y el siguiente ping no puede comenzar hasta que no regrese el paquete anterior, en empresas que tienen incluso más de 20 servidores más equipos de red, esto ya funcionaba bastante lentamente. La cuestión es que un paquete puede perderse, pero no se puede notificar inmediatamente al administrador del sistema. Simplemente ignorará tal spam muy rápidamente. Por lo tanto, es necesario hacer ping a cada objeto más de una vez antes de llegar a una conclusión sobre la inaccesibilidad. Sin entrar demasiado en detalles, se debe paralelizar porque, si no se hace, lo más probable es que el administrador del sistema se entere del problema por parte del cliente, y no del sistema de monitoreo.
PHP en sí mismo no admite multiprocesamiento de forma nativa. Soporta multiproceso, se puede hacer un fork. Pero, ya tenía escrito un mecanismo de consulta y quería hacer que una sola vez leyera todos los nodos que necesitaba desde la base de datos, hacer ping a todos de una vez, esperar la respuesta de cada uno y solo después de eso escribir los datos. Esto ahorra en la cantidad de solicitudes de lectura. La multiprocesamiento encajaba perfectamente en esta idea. Para PHP, existe el módulo PThreads, que permite la verdadera multiprocesamiento; sin embargo, tuve que trabajar bastante para configurarlo en PHP 7.2, pero se logró. El escaneo de puertos y el ping se volvieron rápidos. En lugar de, por ejemplo, 15 segundos por ronda antes, este proceso ahora tomó 2 segundos. Ese fue un buen resultado.
Auditoría rápida de nuevas empresas
¿Cómo surgió la funcionalidad de recopilación de diversas métricas y características del hardware? Es simple. A veces, nos piden simplemente una auditoría de la infraestructura de TI actual. Y también es necesario para acelerar la auditoría de un nuevo cliente. Necesitábamos algo que nos permitiera entrar en una empresa mediana o grande y orientarnos rápidamente sobre qué tienen en realidad. El ping en la red interna lo bloquean, en mi opinión, solo aquellos que quieren complicarse la vida, y por nuestra experiencia, son pocos. Pero también hay quienes lo hacen. Por lo tanto, se puede escanear rápidamente las redes en busca de dispositivos con un simple ping. Luego, se pueden agregar y escanear en busca de puertos abiertos que nos interesen. En esencia, esta funcionalidad ya existía, solo era necesario añadir un comando desde el servidor central al subordinado, para que este escaneara las redes especificadas y añadiera a la lista todo lo que encontrara. Olvidé mencionar que se suponía que ya teníamos una imagen lista con el sistema configurado (servidor subordinado de monitoreo) que podríamos desplegar en el cliente durante la auditoría y conectarlo a nuestra nube.
Sin embargo, el resultado de la auditoría suele incluir un montón de información diversa y una de ellas es qué dispositivos hay en la red. En primer lugar, nos interesaban los servidores Windows y las estaciones de trabajo Windows que forman parte del dominio. En empresas medianas y grandes, la ausencia de un dominio es probablemente una excepción a la regla. Para hablar el mismo idioma, considero que una empresa media tiene más de 100 personas. Era necesario idear una manera de recopilar datos de todas las máquinas y servidores Windows, sabiendo sus direcciones IP y la cuenta del administrador del dominio, pero sin tener que instalar ningún software en cada uno de ellos. Aquí es donde entra en juego la interfaz WMI. Windows Management Instrumentation (WMI), en su traducción literal, es la herramienta de gestión de Windows. WMI es una de las tecnologías básicas para la gestión centralizada y el monitoreo del funcionamiento de varias partes de la infraestructura informática bajo la plataforma Windows. Tomado de la wiki. Luego tuvimos que trabajar nuevamente en cómo reunir wmic (que es el cliente de WMI) para Debian. Una vez que todo estuvo listo, solo quedaba consultar a través de wmic los nodos necesarios sobre la información requerida. A través de WMI se puede obtener casi cualquier información de una computadora con Windows y, además, se puede gestionar la computadora, por ejemplo, enviarla a reiniciar. Así comenzó la recopilación de información sobre estaciones y servidores Windows en nuestro sistema. Además, se incluía información actual sobre los indicadores de carga del sistema. Estos los consultamos con mayor frecuencia, mientras que la información sobre el hardware la consultamos con menos frecuencia. Después de esto, realizar la auditoría se volvió un poco más agradable.
Decisión sobre la distribución de software
Nosotros mismos usamos el sistema todos los días y siempre está abierto para cada empleado técnico. Y pensamos que también podríamos compartir lo que ya tenemos con otros. El sistema aún no estaba completamente listo para ser distribuido. Era necesario rehacer muchas cosas para que la versión local se convirtiera en SaaS. Esto incluye cambios en varios aspectos técnicos en el funcionamiento del sistema (conexiones remotas, servicio de soporte), análisis de módulos en términos de licenciamiento, particionamiento de bases de datos de clientes, escalado de cada uno de los servicios y desarrollo de sistemas de autoactualización para todas las partes. Pero eso será en la segunda parte del artículo.
mensaje de Update.
Fuente: habr.com
