

La búsqueda de dependencias funcionales en datos se aplica en diferentes áreas del análisis de datos: gestión de bases de datos, limpieza de datos, ingeniería inversa de bases de datos y exploración de datos. Ya hemos publicado sobre las propias dependencias de Anastasia Birillo y Nikita Bobrov. Esta vez, Anastasia, graduada del Computer Science Center de este año, comparte el desarrollo de este trabajo en el marco de la investigación que defendió en el centro.
Selección de la tarea
Durante mis estudios en el centro de CS, empecé a profundizar en el estudio de bases de datos, especialmente en la búsqueda de dependencias funcionales y diferencias. Este tema estaba relacionado con mi trabajo de curso en la universidad, así que durante la realización del proyecto, comencé a leer artículos sobre diversas dependencias en bases de datos. Escribí una revisión de este campo, uno de mis primeros en inglés y lo presenté en la conferencia SEIM-2017. Me alegró mucho saber que fue aceptado, y decidí profundizar en el tema. La propia concepción no es nueva, se comenzó a aplicar en los años 90, pero todavía se utiliza en muchos campos.
En el segundo semestre de estudios en el centro, comencé un proyecto de investigación sobre la mejora de algoritmos para la búsqueda de dependencias funcionales. Trabajé en él junto con el estudiante de posgrado de la SPbGU, Nikita Bobrov, en JetBrains Research.
Complejidad computacional de la búsqueda de dependencias funcionales
El principal problema es la complejidad computacional. El número posible de dependencias mínimas y no triviales está limitado por el valor  , donde
 , el número de atributos de la tabla. El tiempo de ejecución de los algoritmos depende no solo de la cantidad de atributos, sino también de la cantidad de filas. En los años 90, los algoritmos para la búsqueda de dependencias funcionales en PCs de escritorio podían procesar conjuntos de datos que contenían hasta 20 atributos y decenas de miles de filas, durante varias horas. Los algoritmos modernos, que funcionan en procesadores multinúcleo, detectan dependencias en conjuntos de datos de cientos de atributos (hasta 200) y cientos de miles de filas, aproximadamente en el mismo tiempo. Sin embargo, esto no es suficiente: ese tiempo es inaceptable para la mayoría de las aplicaciones reales. Por lo tanto, desarrollamos enfoques para acelerar los algoritmos existentes.
Esquemas de caché para la intersección de particiones
En la primera parte del trabajo, desarrollamos esquemas de caché para la clase de algoritmos que utilizan el método de intersección de particiones. Una partición para un atributo representa un conjunto de listas, donde cada lista contiene los números de fila con los mismos valores para ese atributo. Cada una de estas listas se llama clúster. Muchos algoritmos modernos utilizan particiones para determinar si una dependencia se mantiene o no, adheriéndose a la siguiente lemma: La dependencia  se mantiene si
 . Aquí
 se designa la partición y se utiliza el concepto de tamaño de partición, que es el número de clústeres en ella. Los algoritmos que utilizan particiones, cuando se rompe una dependencia, añaden atributos adicionales al lado izquierdo de la dependencia, después de lo cual recalculan la dependencia mediante la operación de intersección de particiones. Esta operación se llama especialización en los artículos. Pero hemos observado que las particiones para dependencias que se mantendrán solo después de varios rondas de especialización pueden ser reutilizadas de manera activa, lo que puede reducir considerablemente el tiempo de ejecución de los algoritmos, ya que la operación de intersección es costosa.
Por lo tanto, propusimos una heurística basada en la Entropía de Shannon y la incertidumbre de Gini, así como nuestra métrica, que llamamos Entropía Inversa. Esta es una modificación menor de la Entropía de Shannon y aumenta a medida que aumenta la singularidad del conjunto de datos. La heurística propuesta es la siguiente:

Aquí  es el grado de singularidad de la partición recién calculada
 , y
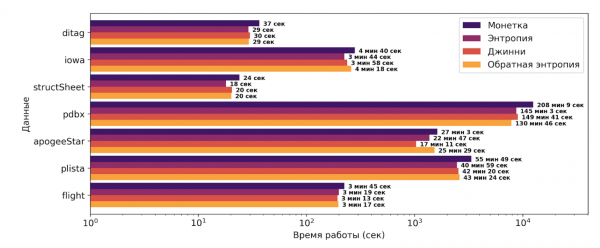
 es una medida mediana de la singularidad para atributos individuales. Se probaron las tres métricas mencionadas anteriormente como medidas de singularidad. También se puede notar que la heurística incluye dos modificadores. El primero indica cuán cercana está la partición actual a la clave primaria y permite en mayor medida almacenar en caché aquellas particiones que están alejadas de la clave potencial. El segundo modificador permite rastrear la ocupación de la caché y, por lo tanto, estimula la adición de más particiones a la caché cuando hay espacio disponible. La solución exitosa de esta tarea permitió acelerar el algoritmo PYRO entre un 10% y un 40% dependiendo del conjunto de datos. Cabe destacar que el algoritmo PYRO es el más exitoso en este campo.
En la figura a continuación se pueden ver los resultados de la aplicación de la heurística propuesta en comparación con el enfoque básico de almacenamiento en caché, basado en lanzar una moneda. El eje X es logarítmico.
Método alternativo de almacenamiento de particiones
Luego propusimos un método alternativo para el almacenamiento de particiones. Las particiones representan un conjunto de clústeres, cada uno de los cuales almacena los números de las tuplas con los mismos valores para ciertos atributos. Estos clústeres pueden contener secuencias largas de números de tuplas, por ejemplo, si los datos en la tabla están ordenados. Por lo tanto, propusimos un esquema de compresión para el almacenamiento de particiones, a saber, el almacenamiento de intervalos de valores en los clústeres de particiones:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Primer~intervalo}, underbrace{7, 8}_{Segundo~intervalo}, 10}}\ downarrow{Compresión}\ pi(X) = {{underbrace{$, 1, 5}_{Primer~intervalo}, underbrace{7, 8}_{Segundo~intervalo}, 10}}$$display$$
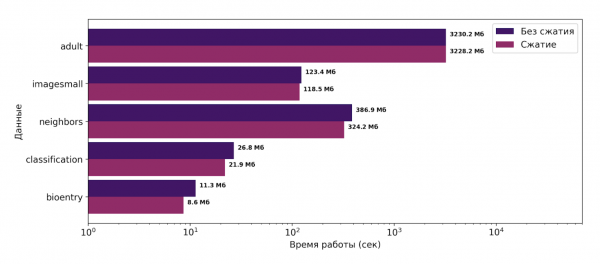
Este método logró reducir el consumo de memoria durante la ejecución del algoritmo TANE entre un 1% y un 25%. El algoritmo TANE es un algoritmo clásico para la búsqueda de FD, utiliza particiones en su funcionamiento. En el ámbito práctico se eligió el algoritmo TANE, ya que implementar el almacenamiento de intervalos en él fue significativamente más sencillo que, por ejemplo, en PYRO, para evaluar si el enfoque propuesto funciona. Los resultados obtenidos se presentan en la figura a continuación. El eje X es logarítmico.
Conferencia ADBIS-2019
Según los resultados de la investigación en septiembre de 2019, presenté un artículo en la conferencia 23rd European Conference on Advances in Databases and Information Systems (ADBIS-2019). Durante la presentación, el trabajo fue destacado por Bernhard Thalheim, una figura relevante en el campo de las bases de datos. Los resultados de la investigación fueron la base de mi tesis de maestría en matemáticas y mecánica en SPbGU, donde ambas aproximaciones propuestas (caché y compresión) se implementaron en ambos algoritmos: TANE y PYRO. Los resultados mostraron que los enfoques propuestos son universales, ya que en ambos algoritmos, con ambos enfoques, se observó una reducción significativa de la memoria consumida, así como una notable disminución en el tiempo de ejecución de los algoritmos.
Fuente: habr.com
