

En 2018, en círculos profesionales y en conferencias temáticas dedicadas a la IA, surgió el concepto de MLOps, que rápidamente se afianzó en la industria y ahora se desarrolla como una disciplina independiente. A largo plazo, MLOps podría convertirse en uno de los campos más solicitados en TI. ¿Qué es exactamente y para qué sirve? Lo analizamos a continuación.
¿Qué es MLOps?
MLOps (la fusión de tecnologías y procesos de aprendizaje automático con enfoques para implementar modelos desarrollados en los procesos empresariales) es una nueva forma de colaboración entre representantes del negocio, científicos, matemáticos, especialistas en aprendizaje automático e ingenieros de TI en la creación de sistemas de inteligencia artificial.
En otras palabras, es la manera de convertir los métodos y tecnologías de aprendizaje automático en herramientas útiles para resolver problemas empresariales.
Es importante entender que la cadena de productividad comienza mucho antes del desarrollo del modelo. Su primer paso es definir el problema empresarial, las hipótesis sobre el valor que se puede extraer de los datos y la idea de negocio para su aplicación.
El concepto de MLOps surgió como analogía al concepto de DevOps en relación a los modelos y tecnologías de aprendizaje automático. DevOps es un enfoque para el desarrollo de software que permite aumentar la velocidad de implementación de cambios individuales manteniendo la flexibilidad y la fiabilidad a través de varios métodos, entre los que se incluyen el desarrollo continuo, la división de funciones en varios microservicios independientes, pruebas automatizadas y despliegue de cambios individuales, monitoreo global de la operatividad y un sistema de respuesta rápida a fallos detectados, entre otros.
DevOps definió el ciclo de vida del software y en la comunidad de especialistas surgió la idea de aplicar la misma metodología a los grandes datos. DataOps es un intento de adaptar y expandir la metodología considerando las particularidades del almacenamiento, transmisión y procesamiento de grandes volúmenes de datos en diversas plataformas interconectadas.
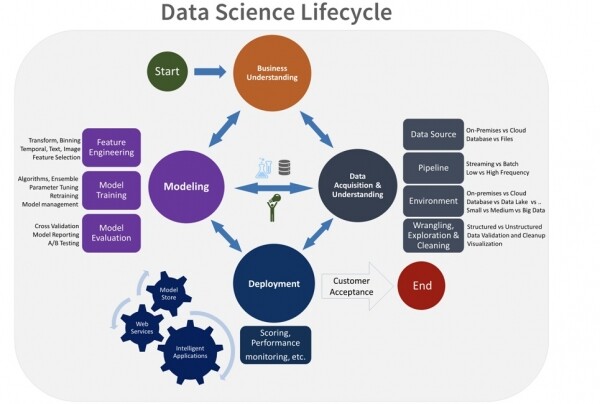
Con la aparición de una cierta masa crítica de modelos de aprendizaje automático integrados en los procesos empresariales, se ha observado una fuerte similitud entre el ciclo de vida de los modelos matemáticos de aprendizaje automático y el ciclo de vida del software. La única diferencia es que los algoritmos de los modelos se crean utilizando herramientas y métodos de aprendizaje automático. Por lo tanto, de forma natural surgió la idea de aplicar y adaptar los enfoques de desarrollo de software ya conocidos para los modelos de aprendizaje automático. Así, en el ciclo de vida de los modelos de aprendizaje automático se pueden distinguir las siguientes etapas clave:
- definición de la idea de negocio;
- entrenamiento del modelo;
- prueba e implementación del modelo en el proceso empresarial;
- operación del modelo.
Cuando en el proceso de operación surge la necesidad de modificar o reentrenar el modelo con nuevos datos, el ciclo se reinicia: el modelo se ajusta, se prueba y se despliega una nueva versión.
Parenthesis. ¿Por qué reentrenar, en lugar de volver a entrenar? El término 'sobreajuste del modelo' tiene una doble interpretación: entre especialistas significa un defecto en el modelo, cuando el modelo predice bien, repitiendo prácticamente el parámetro pronosticado en el conjunto de entrenamiento, pero funciona mucho peor en un conjunto de datos externo. Naturalmente, tal modelo es defectuoso, ya que este defecto no permite su aplicación.
En este ciclo de vida parece lógico utilizar herramientas de DevOps: pruebas automatizadas, despliegue y monitoreo, estructurando el cálculo de modelos en forma de microservicios independientes. Pero hay una serie de particularidades que impiden la aplicación directa de estas herramientas sin un envoltorio adicional de ML.
Cómo hacer que los modelos funcionen y generen beneficios.
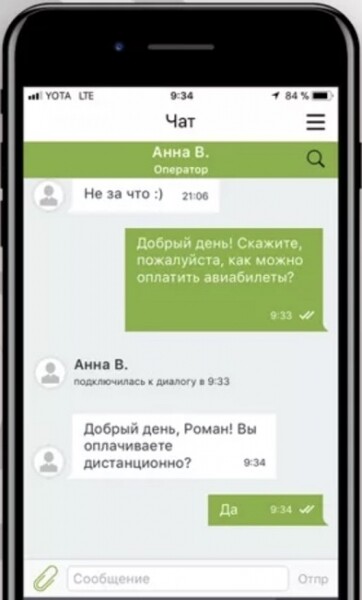
Como ejemplo que utilizaremos para demostrar la aplicación del enfoque MLOps, tomaremos la tarea clásica de automatización del chat de soporte para productos bancarios (o cualquier otro). Normalmente, el proceso de soporte mediante chat se ve de la siguiente manera: el cliente ingresa un mensaje con una pregunta en el chat y recibe una respuesta de un especialista dentro de un árbol de diálogos predefinido. La tarea de automatizar dicho chat generalmente se aborda con conjuntos de reglas definidas por expertos, que son muy laboriosos de desarrollar y mantener. La efectividad de tal automatización, dependiendo del nivel de complejidad de la tarea, puede llegar a ser del 20 al 30%. Naturalmente, surge la idea de que la implementación de un módulo de inteligencia artificial, un modelo desarrollado mediante aprendizaje automático, es más ventajosa, que:
- es capaz de manejar un mayor número de solicitudes sin la intervención de un operador (dependiendo del tema, en algunos casos la efectividad puede alcanzar entre el 70 y el 80%);
- se adapta mejor a formulaciones no estándar en el diálogo: puede determinar la intención, el deseo real del usuario según una solicitud poco clara;
- puede identificar cuándo la respuesta del modelo es adecuada y cuándo existen dudas sobre la "conciencia" de esta respuesta, lo que requeriría hacer una pregunta adicional de clarificación o transferir al operador;
- puede ser reentrenada de manera automatizada (en lugar de un grupo de desarrolladores que constantemente adaptan y corrigen los guiones de respuestas, un especialista en Data Science reentrena el modelo utilizando bibliotecas de aprendizaje automático apropiadas).
¿Cómo hacer que un modelo tan avanzado funcione?
Al igual que al abordar cualquier otra tarea, antes de desarrollar dicho módulo, es necesario definir el proceso de negocio y describir formalmente la tarea específica que resolveremos aplicando el método de aprendizaje automático. En este punto, comienza el proceso de operacionalización, indicado con la abreviatura Ops.
El siguiente paso consiste en que el especialista en Data Science, en colaboración con el ingeniero de datos, verifica la disponibilidad y suficiencia de los datos y la hipótesis del negocio sobre la viabilidad de la idea empresarial, desarrollando un prototipo del modelo y evaluando su efectividad real. Solo después de la confirmación por parte del negocio se puede iniciar la transición del desarrollo del modelo a su integración en los sistemas que realizan procesos empresariales específicos. La planificación integral de la implementación, así como una comprensión profunda de cada etapa sobre cómo se utilizará el modelo y qué efecto económico generará, son aspectos fundamentales en los procesos de implementación de enfoques MLOps en el panorama tecnológico de la empresa.
Con el desarrollo de las tecnologías de IA, se incrementa de forma exponencial la cantidad y diversidad de tareas que pueden resolverse a través del aprendizaje automático. Cada uno de estos procesos empresariales representa un ahorro para la empresa gracias a la automatización del trabajo de empleados en posiciones masivas (centros de llamadas, verificación y clasificación de documentos, etc.), una expansión de la base de clientes mediante la adición de nuevas funciones atractivas y convenientes, ahorro de recursos mediante un uso óptimo y redistribución de recursos, entre muchas otras cosas. En última instancia, cualquier proceso está orientado a la creación de valor y, como consecuencia, debe generar un efecto económico determinado. Aquí es muy importante formular con claridad la idea de negocio y calcular las ganancias esperadas de la implementación del modelo dentro de la estructura general de creación de valor de la empresa. A veces ocurren situaciones en las que la implementación del modelo no justifica su costo, y el tiempo que dedican los especialistas en aprendizaje automático resulta mucho más caro que el salario de un operador que realiza esta tarea. Por esta razón, es esencial identificar tales casos en las primeras etapas de creación de sistemas de IA.
Por lo tanto, el modelo comienza a generar ganancias solo cuando, en el proceso MLOps, se ha formulado correctamente la tarea empresarial, se han establecido prioridades y, en las primeras etapas de desarrollo, se ha definido el proceso de integración del modelo en el sistema.
Un nuevo proceso implica nuevos desafíos.
Una respuesta exhaustiva a la cuestión fundamental de los negocios sobre la aplicabilidad de los modelos de ML para resolver problemas, la cuestión general de la confianza en la IA es uno de los desafíos clave en el proceso de desarrollo e implementación de enfoques MLOps. Inicialmente, las empresas son escépticas sobre la implementación del aprendizaje automático en los procesos: es difícil confiar en modelos en áreas donde anteriormente, por lo general, trabajaban personas. Para las empresas, los programas se presentan como "cajas negras", cuya relevancia de las respuestas aún debe ser probada. Además, en el sector bancario, en el negocio de telecomunicaciones y en otros, existen estrictos requisitos de reguladores gubernamentales. Todos los sistemas y algoritmos que se implementan en los procesos bancarios están sujetos a auditoría. Para abordar esta tarea y demostrar a las empresas y reguladores la validez y corrección de las respuestas de la inteligencia artificial, junto con el modelo se implementan herramientas de monitoreo. Además, existe un procedimiento de validación independiente, obligatorio para los modelos regulatorios, que cumple con los requisitos del Banco Central. Un grupo de expertos independiente audita los resultados obtenidos por el modelo teniendo en cuenta los datos de entrada.
El segundo desafío es la evaluación y consideración de los riesgos modelo al implementar un modelo de aprendizaje automático. Si incluso una persona no puede responder con un ciento por ciento de certeza a la pregunta de si el vestido era blanco o azul, la inteligencia artificial también tiene derecho a cometer errores. Además, es importante tener en cuenta que con el tiempo, los datos pueden cambiar, y los modelos necesitan ser reentrenados para ofrecer resultados suficientemente precisos. Para que el proceso empresarial no se vea afectado, es necesario gestionar los riesgos del modelo y monitorear su funcionamiento, reentrenándolo regularmente con nuevos datos.
Pero después de la primera fase de desconfianza, comienza a manifestarse el efecto contrario. Cuantas más modelos se implementan exitosamente en los procesos, mayor es el apetito de las empresas por utilizar la inteligencia artificial: surgen nuevas y nuevas tareas que se pueden resolver con métodos de aprendizaje automático. Cada tarea inicia todo un proceso que requiere diversas competencias:
- los ingenieros de datos preparan y procesan los datos;
- los científicos de datos aplican herramientas de aprendizaje automático y desarrollan el modelo;
- IT implementa el modelo en el sistema;
- El ingeniero de ML define cómo integrar correctamente este modelo en el proceso, qué herramientas de TI utilizar dependiendo de los requisitos para el modo de aplicación del modelo, teniendo en cuenta el flujo de solicitudes, el tiempo de respuesta, etc.
- El arquitecto de ML diseña cómo se puede implementar físicamente el producto de software en un sistema industrial.
Todo el ciclo requiere una gran cantidad de especialistas altamente calificados. En un determinado punto de desarrollo y grado de penetración de los modelos de ML en los procesos empresariales, se hace evidente que escalar linealmente el número de especialistas de manera proporcional al crecimiento de las tareas se vuelve costoso e ineficiente. Por lo tanto, surge la cuestión de la automatización del proceso de MLOps: la definición de varias clases estándar de tareas de aprendizaje automático, el desarrollo de pipelines típicos para el procesamiento de datos y el reentrenamiento de modelos. En la imagen ideal para resolver tales tareas se requieren profesionales que dominen igualmente las competencias en la intersección de Big Data, Ciencia de Datos, DevOps y TI. Por lo tanto, el mayor problema en la industria de Ciencia de Datos y el mayor desafío al organizar procesos de MLOps es la falta de tal competencia en el actual mercado laboral. Los especialistas que cumplen con tales requisitos son actualmente una rareza en el mercado laboral y son muy valorados.
Sobre la cuestión de las competencias
En teoría, todas las tareas de MLOps se pueden resolver con herramientas clásicas de DevOps sin recurrir a una expansión especializada del modelo de roles. Como hemos mencionado anteriormente, el científico de datos debe ser no solo un matemático y especialista en análisis de datos, sino también un gurú de todo el pipeline; es responsabilidad de él desarrollar la arquitectura, programar modelos en varios lenguajes dependiendo de la arquitectura, preparar la vitrina de datos y desplegar la aplicación misma. Sin embargo, la creación de la infraestructura tecnológica, realizada en el proceso integral de MLOps, consume hasta el 80% del esfuerzo laboral, lo que significa que un matemático calificado, que es lo que se espera de un buen Científico de Datos, solo dedicará el 20% de su tiempo a su especialidad. Por lo tanto, la diferenciación de roles de los especialistas que llevan a cabo el proceso de implementación de modelos de aprendizaje automático se vuelve vital.
Cuán detalladas deben ser las divisiones de roles depende de la escala de la empresa. No es lo mismo cuando en una startup hay un solo especialista, un trabajador versátil que es ingeniero, arquitecto y DevOps a la vez. Es completamente diferente cuando en una gran empresa todos los procesos de desarrollo de modelos están concentrados en unos pocos especialistas de Data Science de alto nivel, mientras que un programador o un especialista en bases de datos, quienes son competencias más comunes y menos costosas en el mercado laboral, pueden asumir gran parte de las tareas rutinarias.
Por lo tanto, la definición de los límites en la elección de los especialistas para garantizar el proceso de MLOps y la organización del proceso de operacionalización de los modelos desarrollados afecta directamente la velocidad y la calidad de los modelos, la productividad del equipo y el clima laboral.
Lo que nuestra equipo ya ha logrado
No hace mucho tiempo comenzamos a construir la estructura de competencias y los procesos de MLOps. Pero ya estamos en la fase de prueba de MVP con nuestros proyectos de gestión del ciclo de vida de modelos y la implementación de modelos como servicio.
También hemos determinado la estructura de competencias y la organización óptimas para una gran empresa, así como la interacción entre todos los participantes del proceso. Se organizaron equipos Agile que abordan tareas para todo el espectro de los clientes empresariales, además de establecer un proceso de colaboración con los equipos de proyectos para crear plataformas e infraestructuras, que son la base del edificio MLOps en construcción.
Cuestiones para el futuro
MLOps es un campo en desarrollo que enfrenta una escasez de competencias y que en el futuro tomará impulso. Mientras tanto, es mejor basarse en los avances y prácticas de DevOps. El objetivo principal de MLOps es utilizar de manera más efectiva los modelos de ML para resolver los problemas del negocio. Sin embargo, surgen muchas preguntas:
- ¿Cómo reducir el tiempo para implementar modelos en producción?
- ¿Cómo disminuir las fricciones burocráticas entre equipos de diferentes competencias y aumentar el enfoque en la colaboración?
- ¿Cómo rastrear modelos, gestionar versiones y organizar un monitoreo efectivo?
- ¿Cómo crear un ciclo de vida realmente cíclico para un modelo de ML moderno?
- ¿Cómo estandarizar el proceso de aprendizaje automático?
Las respuestas a estas preguntas determinarán en gran medida cuán rápidamente MLOps revelará su potencial por completo.
Fuente: habr.com
