

En Badoo, monitoreamos constantemente nuevas tecnologías y evaluamos si vale la pena utilizarlas en nuestro sistema. Queremos compartir uno de estos estudios con la comunidad. Se centra en Loki, un sistema de agregación de logs.
Loki es una solución para almacenar y visualizar logs, y este stack ofrece un sistema flexible para analizarlos y enviar datos a Prometheus. En mayo, se lanzó una nueva actualización que los creadores están promoviendo activamente. Nos interesó saber qué puede hacer Loki, qué posibilidades ofrece y en qué medida puede ser una alternativa a ELK, el stack que estamos utilizando actualmente.
Qué es Loki
Grafana Loki es un conjunto de componentes para un sistema completo de manejo de logs. A diferencia de otros sistemas similares, Loki se basa en la idea de indexar solo los metadatos de los logs — labels (al igual que en Prometheus), mientras que los logs en sí se comprimen en trozos separados.
,
Antes de pasar a la descripción de lo que se puede hacer con Loki, quiero aclarar lo que significa 'la idea de indexar solo metadatos'. Compararemos el enfoque de Loki con el enfoque de indexación en soluciones tradicionales, como Elasticsearch, utilizando un ejemplo de una línea de log de nginx:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Los sistemas tradicionales analizan la línea completa, incluyendo campos con una gran cantidad de valores únicos como user_id e item_id, y almacenan todo en grandes índices. La ventaja de este enfoque es que se pueden realizar consultas complejas rápidamente, ya que casi todos los datos están en el índice. Sin embargo, esto implica que el índice se vuelve grande, lo que se traduce en mayores requerimientos de memoria. En última instancia, un índice de texto completo de logs es comparable en tamaño a los mismos logs. Para que se pueda buscar rápidamente, el índice debe estar cargado en memoria. Cuantos más logs hay, más rápido crece el índice y más memoria consume.
El enfoque de Loki requiere que se extraigan solo los datos necesarios de la cadena, cuya cantidad de valores es pequeña. De esta manera, obtenemos un índice pequeño y podemos buscar datos filtrándolos por tiempo y por campos indexados, y luego escaneando los restantes mediante expresiones regulares o búsqueda de subcadenas. El proceso parece no ser el más rápido, pero Loki divide la consulta en varias partes y las ejecuta en paralelo, procesando una gran cantidad de datos en poco tiempo. La cantidad de shards y las consultas paralelas en ellos se configuran; así, la cantidad de datos que se pueden procesar por unidad de tiempo depende linealmente de los recursos proporcionados.
Este compromiso entre un índice rápido grande y un índice pequeño con un barrido completo paralelo permite a Loki controlar el costo del sistema. Este se puede ajustar y escalar de forma flexible según las necesidades.
El stack de Loki consta de tres componentes: Promtail, Loki y Grafana. Promtail recopila registros, los procesa y los envía a Loki. Loki los almacena. Y Grafana puede solicitar datos de Loki y mostrarlos. En general, Loki se puede utilizar no solo para almacenar registros y buscar en ellos. Todo el stack ofrece grandes posibilidades para el procesamiento y análisis de los datos entrantes, utilizando el enfoque de Prometheus.
La descripción del proceso de instalación se puede encontrar .
Búsqueda en registros
Se puede buscar en los registros a través de la interfaz especial de Grafana: Explorer. Para las consultas se utiliza el lenguaje LogQL, muy similar a PromQL, que se utiliza en Prometheus. En principio, se puede considerar como un grep distribuido.
La interfaz de búsqueda se ve así:
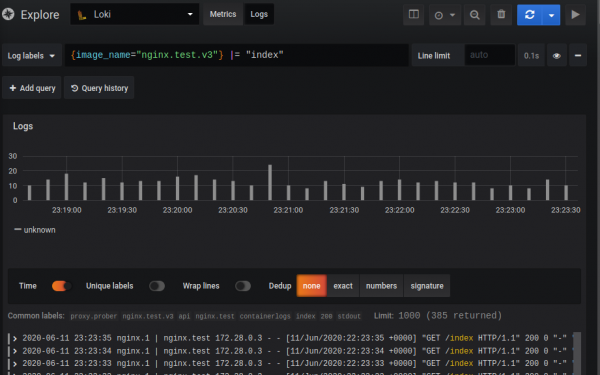
La consulta en sí consta de dos partes: selector y filter. El selector es la búsqueda en los metadatos indexados (etiquetas) que se asignaron a los registros, y el filter es la cadena de búsqueda o expresión regular que filtra los registros definidos por el selector. En el ejemplo dado: En llaves se encuentra el selector y todo lo que sigue es el filtro.
{image_name="nginx.promtail.test"} |= "index"Debido al principio de funcionamiento de Loki, no se pueden hacer consultas sin un selector, pero las etiquetas se pueden hacer tan generales como se desee.
El selector consiste en valores clave en llaves. Se pueden combinar selectores y establecer diferentes condiciones de búsqueda utilizando operadores =, != o expresiones regulares:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Encontrará los registros con la etiqueta instance, con valores kafka-2, kafka-3, y excluirá dev
Un filtro es un texto o una expresión regular que filtrará todos los datos obtenidos por el selector.
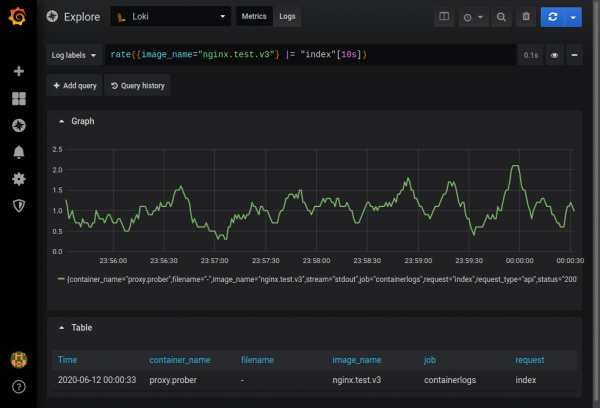
Hay posibilidad de obtener gráficos ad-hoc de los datos obtenidos en modo metrics. Por ejemplo, se puede saber la frecuencia de aparición en los registros de nginx de una entrada que contenga la cadena index:
La descripción completa de las capacidades se puede encontrar en la documentación .
Análisis de registros
Hay varias maneras de recolectar registros:
- Usando Promtail, el componente estándar del stack para la recolección de registros.
- Directamente desde el contenedor de Docker utilizando
- Utilizar Fluentd o Fluent Bit, que pueden enviar datos a Loki. A diferencia de Promtail, tienen parsers listos para casi cualquier tipo de registro y manejan también registros multilínea.
Normalmente se utiliza Promtail para el análisis. Hace tres cosas:
- Encuentra fuentes de datos.
- Les adjunta etiquetas.
- Envía los datos a Loki.
Actualmente, Promtail puede leer registros de archivos locales y del journal de systemd. Debe estar instalado en cada máquina de la que se recojan registros.
Hay una integración con Kubernetes: Promtail automáticamente a través de la API REST de Kubernetes conoce el estado del clúster y recoge registros de la nodo, servicio o pod, etiquetando inmediatamente basado en los metadatos de Kubernetes (nombre del pod, nombre del archivo, etc.).
También se pueden etiquetar basándose en los datos del registro mediante un Pipeline. Un Pipeline de Promtail puede constar de cuatro tipos de etapas. Más detalles en , aquí señalaré algunos matices.
- Etapas de análisis. Esta es la etapa de RegEx y JSON. En esta etapa extraemos datos de los registros en lo que se llama extracted map. Se pueden extraer de JSON, simplemente copiando los campos que necesitamos en el extracted map, o mediante expresiones regulares (RegEx), donde en el extracted map se 'mapean' grupos nombrados. El extracted map es un almacén de key-value, donde key es el nombre del campo y value es su valor extraído de los registros.
- Etapas de transformación. Esta etapa tiene dos opciones: transform, donde definimos las reglas de transformación, y source, que es la fuente de datos para la transformación desde el extracted map. Si un campo no existe en el extracted map, se creará. Así, se pueden crear etiquetas que no se basen en el extracted map. En esta etapa, podemos manipular datos en el extracted map, utilizando un . Además, hay que recordar que el mapa extraído se carga completamente durante el análisis, lo que permite, por ejemplo, verificar su valor: “{{if .tag}el valor de la etiqueta existe{end}}”. La plantilla soporta condiciones, ciclos y algunas funciones de cadena, como Replace y Trim.
- Etapas de acción. En esta etapa, se puede hacer algo con lo extraído:
- Crear una etiqueta de los datos extraídos, que será indexada por Loki.
- Modificar o establecer la hora del evento desde el registro.
- Modificar los datos (texto del registro) que se enviarán a Loki.
- Crear métricas.
- Etapas de filtrado. Etapa de coincidencia, donde se pueden enviar a /dev/null los registros que no necesitamos, o dirigirlos para un procesamiento posterior.
Voy a mostrar con un ejemplo del procesamiento de registros nginx comunes, cómo se pueden analizar los registros usando Promtail.
Para la prueba, tomaremos como proxy de nginx una imagen modificada de nginx jwilder/nginx-proxy:alpine y un pequeño demonio que puede interrogarse a sí mismo a través de HTTP. Al demonio se le han asignado varios endpoints para los cuales puede responder con distintos tamaños, con diferentes estados HTTP y con diferentes retardos.
Recogeremos los registros de los contenedores de Docker, que se pueden encontrar en la ruta /var/lib/docker/containers//-json.log
En docker-compose.yml configuramos Promtail y especificamos la ruta al archivo de configuración:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Añadimos en promtail.yml la ruta a los registros (en la configuración hay una opción "docker" que hace lo mismo en una línea, pero no sería tan claro):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # solo para linux
Al activar esta configuración, los registros de todos los contenedores llegarán a Loki. Para evitar esto, modificamos la configuración del nginx de prueba en docker-compose.yml — añadimos el campo de registro de etiqueta:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Editamos promtail.yml y configuramos el Pipeline. Los registros que entran son del siguiente tipo:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] "GET /api/index HTTP/1.1" 200 0 "-" "Stub_Bot/0.1" "0.096"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] "GET /200 HTTP/1.1" 200 0 "-" "Stub_Bot/0.1" "0.000"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Etapa del pipeline:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Extraemos del JSON de entrada los campos stream, attrs, attrs.tag (si existen) y los colocamos en el mapa extraído.
 - regex:
     expresión: ^(?P([^|]+))|(?P([^|]+))$
     fuente: "tag"
Si se logró colocar el campo tag en el mapa extraído, usamos expresiones regulares para extraer los nombres de la imagen y el contenedor.
 - etiquetas:
     image_name:
     container_name:
Asignamos etiquetas. Si se encuentran las claves image_name y container_name en los datos extraídos, sus valores se asignarán a las etiquetas correspondientes.
 - match:
     selector: '{job="docker",container_name="",image_name=""}'
     action: drop
Eliminamos todos los logs que no tienen las etiquetas image_name y container_name establecidas.
  - match:
     selector: '{image_name="nginx.promtail.test"}'
     etapas:
       - json:
           expresiones:
             row: log
Para todos los logs donde image_name es nginx.promtail.test, extraemos del log original el campo log y lo colocamos en el mapa extraído con la clave row.
  - regex:
         # suprimir colores forego
         expresión: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         fuente: logrow
Limpiamos la cadena de entrada con expresiones regulares y extraemos el virtual host de nginx y la línea del log de nginx.
     - regex:
         fuente: nginxlog
         expresión: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Analizamos el log de nginx con expresiones regulares.
    - regex:
           fuente: request_url
           expresión: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           fuente: request_url
           expresión: ^/photo/(?P[^/?.]+).*$
       - regex:
           fuente: request_url
           expresión: ^/api/(?P[^/?.]+).*$
Desglosamos request_url. Usando expresiones regulares, determinamos el propósito de la solicitud: a estática, a fotos, a API y establecemos la clave correspondiente en el mapa extraído.
       - template:
           fuente: request_type
           plantilla: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
Mediante operadores condicionales en Template, verificamos los campos establecidos en el mapa extraído y asignamos a la variable request_type los valores correspondientes: photo, static, API. Asignamos other si no se pudo. Ahora request_type contiene el tipo de solicitud.
       - etiquetas:
           api_request:
           virtual_host:
           request_type:
           estado:
Establecemos las etiquetas api_request, virtual_host, request_type y estado (estado HTTP) en función de lo que se logró colocar en el mapa extraído.
       - output:
           fuente: nginx_log_row
Cambiamos la salida. Ahora en Loki se envía el log de nginx limpio desde el mapa extraído.
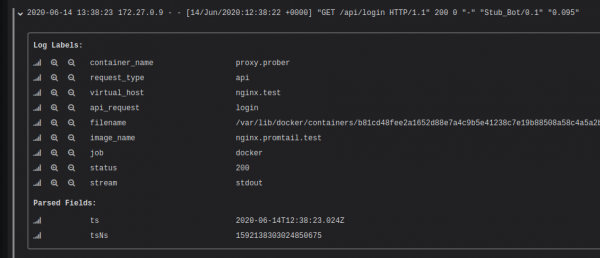
Después de ejecutar la configuración proporcionada, se puede ver que a cada registro se le han asignado etiquetas basadas en los datos del log.
Es importante tener en cuenta que extraer etiquetas con un gran número de valores (cardinalidad) puede ralentizar significativamente el funcionamiento de Loki. Es decir, no se debe incluir en el índice, por ejemplo, user_id. Para más detalles, consulta el artículo “”. Pero esto no significa que no se pueda buscar por user_id sin índices. Se deben utilizar filtros al buscar («greppear» los datos), y el índice actúa aquí como un identificador de flujo.
Visualización de logs
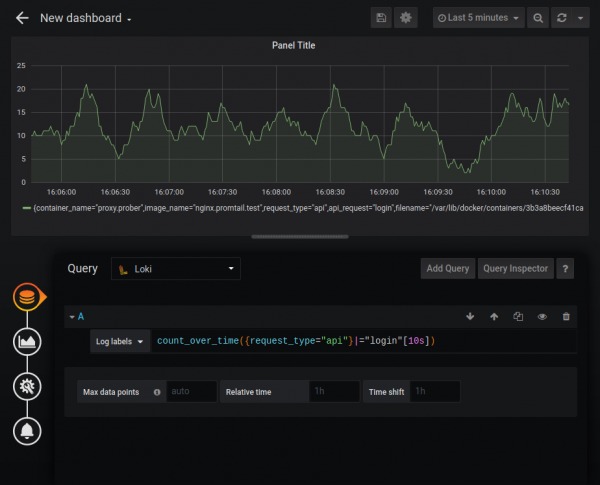
Loki puede actuar como fuente de datos para gráficos en Grafana, utilizando LogQL. Se admiten las siguientes funciones:
- rate — número de registros por segundo;
- count over time — número de registros en un rango determinado.
También hay funciones de agregación como Sum, Avg y otras. Se pueden construir gráficos bastante complejos, como un gráfico de la cantidad de errores HTTP:
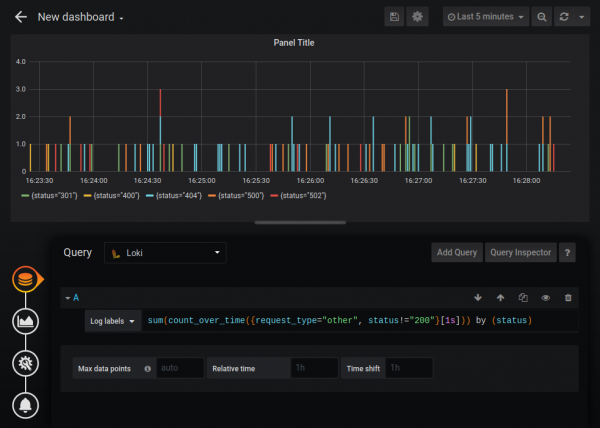
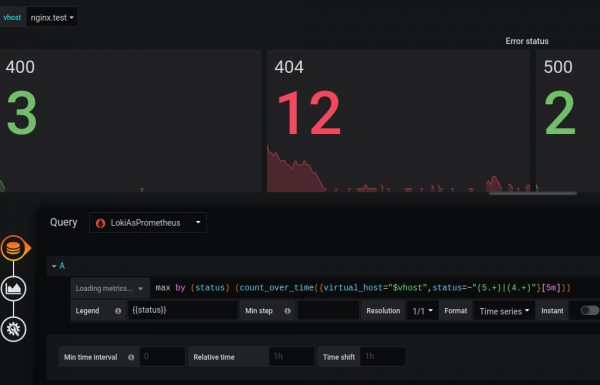
La fuente de datos estándar de Loki tiene algunas limitaciones en comparación con la fuente de datos de Prometheus (por ejemplo, no se puede cambiar la leyenda), pero Loki se puede conectar como fuente del tipo Prometheus. No estoy seguro de que este comportamiento esté documentado, pero, según la respuesta de los desarrolladores “”, por ejemplo, esto es completamente válido, y Loki es totalmente compatible con PromQL.
Agregamos Loki como fuente de datos del tipo Prometheus y escribimos la URL /loki:

Y se pueden hacer gráficos, como si estuviéramos trabajando con métricas de Prometheus:
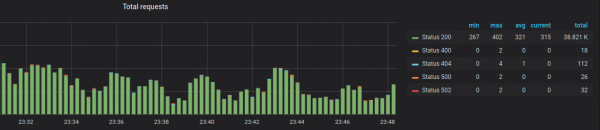
Creo que la discrepancia en la funcionalidad es temporal y los desarrolladores lo corregirán en el futuro.
Métricas
En Loki está disponible la posibilidad de extraer métricas numéricas de los logs y enviarlas a Prometheus. Por ejemplo, en el log de nginx se encuentra la cantidad de bytes en la respuesta y, con una cierta modificación del formato estándar del log, el tiempo en segundos que tomó la respuesta. Estos datos se pueden extraer y enviar a Prometheus.
Agregamos otra sección en promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "tiempo de respuesta ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "suma de bytes de respuesta"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "conteo de bytes de respuesta"
           source: bytes_out
           config:
             action: inc
La opción permite definir y actualizar métricas basadas en datos del mapa extraído. Estas métricas no se envían a Loki, sino que aparecen en el endpoint /metrics de Promtail. Prometheus debe ser configurado para obtener los datos generados en esta etapa. En el ejemplo dado para request_type=“api”, recopilamos la métrica de histograma. Con este tipo de métricas es conveniente obtener percentiles. Para estática y fotos, recopilamos la suma de bytes y la cantidad de líneas en las que obtuvimos bytes, para calcular el valor medio.
Lea más sobre las métricas .
Abrimos el puerto en Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
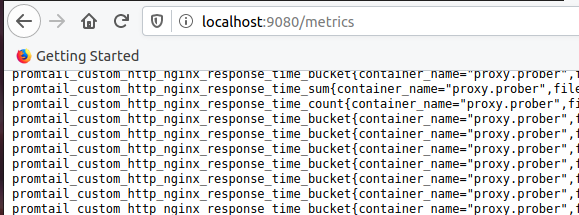
Asegurémonos de que las métricas con el prefijo promtail_custom hayan aparecido:
Configuramos Prometheus. Añadimos el trabajo promtail:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
Y dibujamos el gráfico:
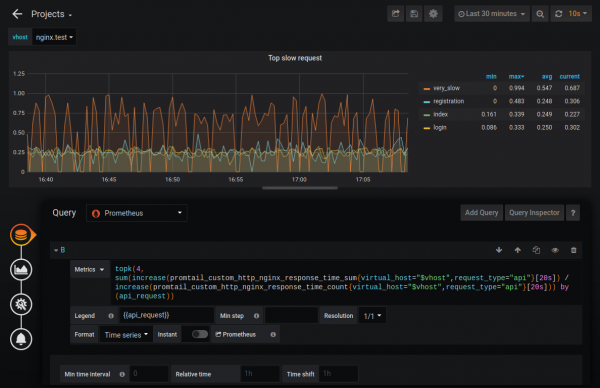
Así podemos conocer, por ejemplo, las cuatro solicitudes más lentas. Además, se puede configurar monitoreo sobre estos datos métricos.
Escalado
Loki puede funcionar tanto en modo único (single binary mode) como en modo fragmentado (horizontally-scalable mode). En el segundo caso, puede almacenar datos en la nube, con los chunks y el índice almacenados por separado. En la versión 1.5 se implementó la posibilidad de almacenar en un solo lugar, aunque actualmente no se recomienda utilizarlo en producción.
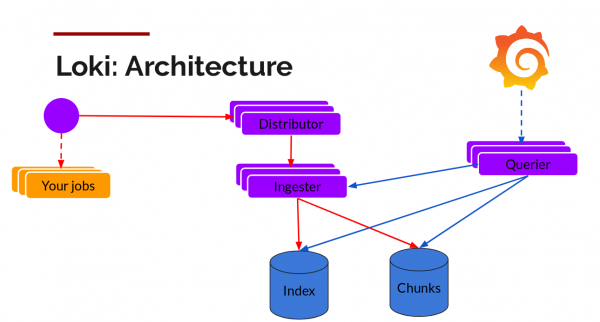
Los chunks se pueden almacenar en un almacenamiento compatible con S3, utilizando bases de datos escalables horizontalmente para almacenar índices: Cassandra, BigTable o DynamoDB. Otras partes de Loki — Distributors (para escritura) y Querier (para consultas) — son sin estado (stateless) y también se escalan horizontalmente.
En la conferencia DevOpsDays Vancouver 2019, uno de los participantes, Callum Styan, mencionó que con Loki su proyecto tiene petabytes de logs con un índice de menos del 1% del tamaño total: “”.
Comparativa entre Loki y ELK
Tamaño del índice
Para probar el tamaño del índice obtenido, tomé logs de un contenedor nginx, para el cual se configuró el Pipeline mencionado anteriormente. El archivo de logs contenía 406,624 líneas con un tamaño total de 109 MB. Los logs se generaron durante una hora, aproximadamente a 100 registros por segundo.
Ejemplo de dos líneas del log:
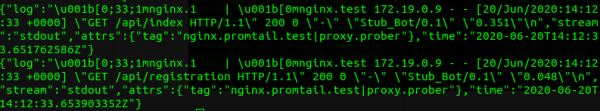
Al indexar en ELK, esto dio un tamaño de índice de 30.3 MB:
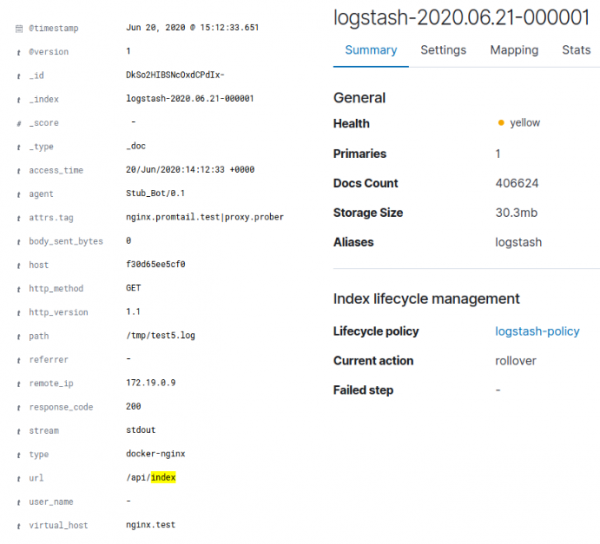
En el caso de Loki, esto generó aproximadamente 128 KB de índice y unos 3,8 MB de datos en bloques. Cabe destacar que el registro fue generado artificialmente y no presentaba gran variedad de datos. La compresión simple de gzip en el registro JSON original de Docker dio una compresión del 95,4%, y considerando que a Loki se enviaron solo registros nginx limpios, la compresión a 4 MB es comprensible. La cantidad total de valores únicos para las etiquetas de Loki fue de 35, lo que explica el pequeño tamaño del índice. Para ELK, el registro también fue limpiado. Por lo tanto, Loki comprimió los datos originales en un 96%, mientras que ELK lo hizo en un 70%.
Consumo de memoria
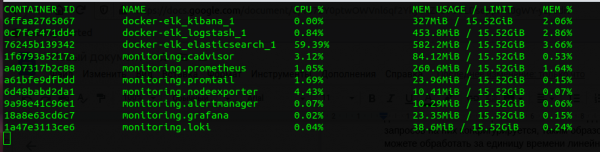
Al comparar toda la pila de Prometheus y ELK, Loki 'consume' varias veces menos. Está claro que un servicio en Go consume menos que un servicio en Java, y la comparación entre el tamaño del Heap de JVM de Elasticsearch y la memoria dedicada a Loki no es correcta, pero aun así vale la pena señalar que Loki utiliza mucha menos memoria. Su ventaja en CPU no es tan evidente, pero también está presente.
Velocidad
Loki 'devora' los registros más rápido. La velocidad depende de muchos factores: qué registros son, cuán sofisticadamente los estamos analizando, la red, el disco, etc., pero definitivamente es más alta que la de ELK (en mi prueba, aproximadamente el doble). Esto se explica por el hecho de que Loki coloca muchos menos datos en el índice y, por lo tanto, gasta menos tiempo en la indexación. Sin embargo, la situación es opuesta en cuanto a la velocidad de búsqueda: Loki se ralentiza notablemente con datos de más de unos pocos gigabytes, mientras que en ELK la velocidad de búsqueda no depende del tamaño de los datos.
Búsqueda en registros
Loki tiene significativamente menos capacidades de búsqueda en registros que ELK. Grep con expresiones regulares es una herramienta poderosa, pero no se compara con una base de datos madura. La falta de consultas de rango, agregación solo por etiquetas, la imposibilidad de buscar sin etiquetas: todo esto nos limita en la búsqueda de información de interés en Loki. Esto no implica que con Loki no se pueda encontrar nada, pero sí define el flujo de trabajo con registros, donde primero se identifica un problema en los gráficos de Prometheus y luego se busca qué sucedió en los registros según estas etiquetas.
Interfaz
Primero, es bonito (lo siento, no pude contenerme). Grafana tiene una interfaz agradable a la vista, pero Kibana es mucho más funcional.
Ventajas y desventajas de Loki
Entre las ventajas se puede destacar que Loki se integra con Prometheus, lo que significa que obtenemos métricas y alertas listas para usar. Es conveniente para la recopilación y almacenamiento de logs con Pods de Kubernetes, ya que hereda de Prometheus la detección de servicios y automáticamente asigna etiquetas.
Entre las desventajas se encuentra la documentación deficiente. Algunas cosas, como las características y capacidades de Promtail, solo las descubrí durante el estudio del código, afortunadamente, es de código abierto. Otra desventaja son las limitadas capacidades de análisis. Por ejemplo, Loki no puede analizar logs multilinea. También se puede considerar como un inconveniente que Loki es una tecnología relativamente nueva (el lanzamiento 1.0 fue en noviembre de 2019).
Conclusión
Loki es una tecnología 100% interesante, que se adapta a proyectos pequeños y medianos, permitiendo resolver múltiples tareas de agregación de logs, búsquedas en logs, monitoreo y análisis de logs.
No estamos utilizando Loki en Badoo, ya que tenemos un stack ELK que nos satisface y que ha evolucionado con diversas soluciones personalizadas a lo largo de los años. Para nosotros, el mayor obstáculo es la búsqueda en los logs. Con casi 100 GB de logs al día, es importante para nosotros poder encontrar todo y un poco más, y hacerlo rápidamente. Para la creación de gráficos y monitoreo utilizamos otras soluciones que están ajustadas a nuestras necesidades e integradas entre sí. El stack de Loki tiene ventajas notables, pero no nos proporcionará más de lo que ya tenemos, y sus beneficios definitivamente no compensarán el costo de migración.
Y aunque después de la investigación quedó claro que no podemos utilizar Loki, esperamos que este post les ayude en su elección.
El repositorio con el código utilizado en el artículo se encuentra .
Fuente: habr.com
