

La traducción del artículo ha sido preparada en la víspera del inicio del curso .
¿Cómo ahorrar en costos en la nube al trabajar con Kubernetes? No existe una única solución correcta, pero en este artículo se describen varias herramientas que te ayudarán a administrar los recursos de manera más eficiente y reducir los gastos en computación en la nube.
Escribí este artículo con Kubernetes para AWS en mente, pero será aplicable (casi) de la misma manera a otros proveedores de nube. Supongo que tu(s) clúster(es) ya tiene(n) configurado el escalado automático (). La eliminación de recursos y la reducción del escalado de despliegues solo permitirá ahorrar si también reduce tu parque de nodos de trabajo (instancias de EC2).
En este artículo se discutirán:
- la limpieza de recursos no utilizados ()
- la reducción del escalado fuera del horario laboral ()
- el uso de escalado automático horizontal (HPA),
- la reducción del sobreaprovisionamiento de recursos (, VPA)
- el uso de instancias Spot
Limpieza de recursos no utilizados
Trabajar en un entorno de rápido cambio es genial. Queremos que las organizaciones técnicas . Una entrega más rápida de software también significa más implementaciones de PR, entornos de vista previa, prototipos y soluciones analíticas. Todo se despliega en Kubernetes. ¿Quién tiene tiempo para limpiar implementaciones de prueba manualmente? Es fácil olvidarse de eliminar un experimento de hace semanas. La factura de la nube, en última instancia, seguirá creciendo porque olvidamos cerrar:
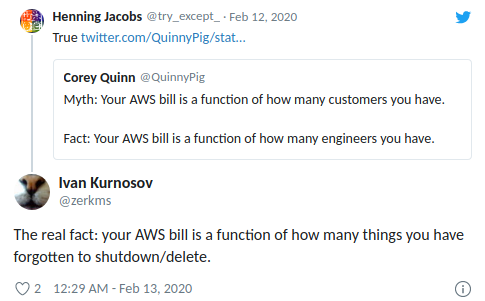
(Henning Jacobs:
Realidad:
(cita) Corey Quinn:
Mito: Tu factura de AWS es una función de cuántos usuarios tienes.
Hecho: Tu factura de AWS es una función de cuántos ingenieros tienes.
Ivan Kurnosov (en respuesta):
Hecho verdadero: Tu factura de AWS es una función de cuántas cosas olvidaste apagar/eliminar.)
(kube-janitor) ayuda a limpiar tu clúster. La configuración del janitor es flexible tanto para uso global como local:
- Las reglas generales para todo el clúster pueden determinar el tiempo máximo de vida (TTL — time-to-live) para implementaciones de PR/pruebas.
- Los recursos individuales pueden ser anotados usando janitor/ttl, por ejemplo, para la eliminación automática de un spike/prototipo después de 7 días.
Las reglas generales se definen en un archivo YAML. Su ruta se pasa a través del parámetro --rules-file en kube-janitor. Aquí hay un ejemplo de una regla para eliminar todos los espacios de nombres con -pr- en el nombre después de dos días:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
El siguiente ejemplo regula el uso de la etiqueta application en los pods de Deployment y StatefulSet para todas las nuevas implementaciones/StatefulSet en 2020, pero al mismo tiempo permite pruebas sin esta etiqueta durante una semana:
- id: require-application-label
  # eliminar deployments y statefulsets sin la etiqueta "application"
  resources:
    - deployments
    - statefulsets
  # ver http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Ejecutar una demo limitada en el tiempo durante 30 minutos en el clúster donde está funcionando kube-janitor:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Otra fuente de costos crecientes son los volúmenes persistentes (AWS EBS). Al eliminar un StatefulSet de Kubernetes, sus volúmenes persistentes (PVC — PersistentVolumeClaim) no se eliminan. Los volúmenes EBS no utilizados pueden fácilmente llevar a gastos de cientos de dólares al mes. Kubernetes Janitor tiene una función para limpiar PVC no utilizados. Por ejemplo, esta regla eliminará todos los PVC que no están montados por un módulo y que no son referenciados por un StatefulSet o CronJob:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
Kubernetes Janitor puede ayudarle a mantener su clúster 'limpio' y prevenir los costos de computación en la nube que se acumulan lentamente. Para instrucciones sobre implementación y configuración, consulte .
Reducción de la escala fuera del horario laboral
Los sistemas de prueba y de staging generalmente solo se requieren durante el horario laboral. Algunas aplicaciones en producción, como la administración/back-office/herramientas de administrador, también requieren solo disponibilidad limitada y pueden ser apagadas por la noche.
(kube-downscaler) permite a los usuarios y operadores reducir la escala del sistema en momentos de inactividad. Los Deployments y StatefulSets se pueden escalar a cero réplicas. Los CronJobs pueden ser pausar. Kubernetes Downscaler se configura a nivel de clúster, para uno o varios espacios de nombres o recursos individuales. Se puede establecer un 'tiempo de inactividad' o, por el contrario, un 'tiempo de actividad'. Por ejemplo, para minimizar el escalado durante la noche y los fines de semana:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # no deshabilitar componentes de infraestructura
  - --exclude-namespaces=kube-system,infra
  # no deshabilitar kube-downscaler y dejar Postgres Operator para que las bases de datos excluidas puedan ser gestionadas
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Lun-Vie 08:00-20:00 Europa/Berlín
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Aquí hay un gráfico del escalado de nodos de trabajo del clúster durante los fines de semana:
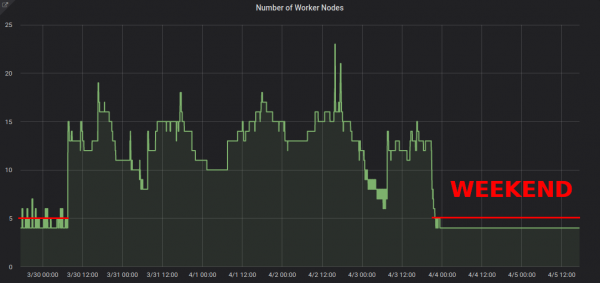
Reducir el escalado de ~13 a 4 nodos de trabajo, sin duda, hace una diferencia tangible en la factura de AWS.
Pero, ¿qué pasa si necesito operar durante el 'tiempo de inactividad' del clúster? Ciertos deployments se pueden excluir permanentemente del escalado añadiendo la anotación downscaler/exclude: true. Los deployments se pueden excluir temporalmente mediante la anotación downscaler/exclude-until con un timestamp absoluto en el formato AAAA-MM-DD HH:MM (UTC). Si es necesario, se puede escalar todo el clúster de nuevo desplegando un pod con la anotación downscaler/force-uptime, por ejemplo, ejecutando una plantilla de nginx:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # eliminar el deployment después de una hora
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Vea , si estás interesado en las instrucciones de despliegue y opciones adicionales.
Utiliza escalado automático horizontal
Muchos aplicativos/servicios manejan un esquema de carga dinámica: a veces sus módulos están inactivos y a veces operan al máximo de su capacidad. Trabajar con un parque constante de pods para manejar la carga máxima no es eficiente. Kubernetes soporta el escalado automático horizontal a través del recurso (HPA). El uso de CPU a menudo es un buen indicador para el escalado:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
Zalando ha creado un componente para la conexión sencilla de métricas personalizadas para el escalado: (kube-metrics-adapter) es un adaptador de métricas universal para Kubernetes, que puede recopilar y servir métricas personalizadas y externas para el escalado horizontal de pods. Soporta escalado basado en métricas de Prometheus, colas de SQS y otras configuraciones. Por ejemplo, para escalar un despliegue basado en una métrica personalizada expuesta por la propia aplicación en formato JSON en /metrics, utiliza:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.<metricType>.<metricName>.<collectorName>/<configKey>
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
Configurar el escalado horizontal con HPA debería ser una de las acciones por defecto para aumentar la eficiencia en servicios que no consideran el estado. Spotify tiene una presentación sobre su experiencia y recomendaciones para HPA: .
Reduciendo la sobreaprovisionamiento de recursos
Las cargas de trabajo de Kubernetes definen sus necesidades de CPU/memoria a través de "solicitudes de recursos" (resource requests). Los recursos de CPU se miden en núcleos virtuales o más comúnmente en "milicore" (milicore), por ejemplo, 500m indica el 50% de vCPU. Los recursos de memoria se miden en bytes, y se pueden utilizar sufijos comunes, por ejemplo, 500Mi, que significa 500 megabytes. Las solicitudes de recursos "bloquean" el volumen en los nodos de trabajo, es decir, un módulo con una solicitud de CPU de 1000m en un nodo con 4 vCPUs dejará solo 3 vCPUs disponibles para otros módulos.
Slack (exceso de reserva) — es la diferencia entre los recursos solicitados y el uso real. Por ejemplo, un pod que solicita 2 GiB de memoria, pero solo utiliza 200 MiB, tiene ~ 1,8 GiB de 'memoria sobrante'. El exceso cuesta dinero. Se puede estimar grosso modo que 1 GiB de memoria sobrante cuesta ~ 10 dólares al mes.
(kube-resource-report) muestra las reservas innecesarias y puede ayudarle a identificar potenciales ahorros:
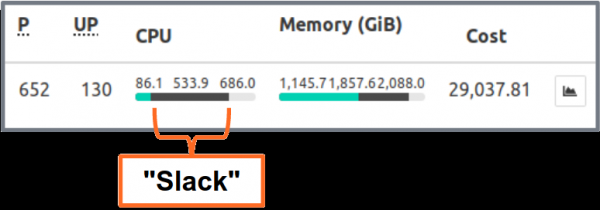
muestra el exceso, agregado por aplicación y equipo. Esto permite encontrar lugares donde las solicitudes de recursos pueden reducirse. El informe HTML generado proporciona solo una instantánea del uso de los recursos. Debe observar el uso de CPU/memoria a lo largo del tiempo para determinar solicitudes de recursos adecuadas. Aquí hay un gráfico de Grafana para un servicio 'típico' con alta carga de CPU: todos los pods utilizan significativamente menos de 3 núcleos de CPU solicitados:
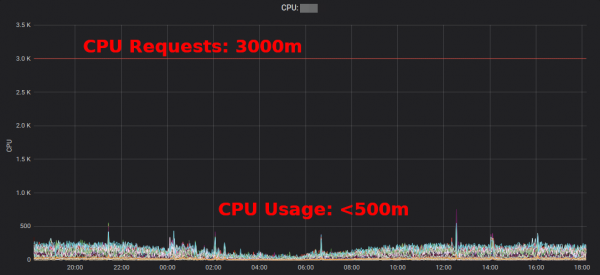
Reducir la solicitud de CPU de 3000m a ~400m libera recursos para otras cargas de trabajo y permite reducir el clúster.
‘El uso medio de CPU de las instancias EC2 a menudo varía entre los extremos bajos de un solo dígito’ — . Mientras que para EC2 , cambiar algunas solicitudes de recursos en el archivo YAML de Kubernetes es sencillo y puede brindar enormes ahorros.
Pero, ¿realmente queremos que las personas cambien los valores en los archivos YAML? No, ¡las máquinas pueden hacerlo mucho mejor! Kubernetes (VPA) es precisamente lo que hace: adapta las solicitudes de recursos y límites según la carga de trabajo. Aquí hay un ejemplo de gráfico de solicitudes de CPU de Prometheus (la línea azul delgada), ajustadas por VPA a lo largo del tiempo:
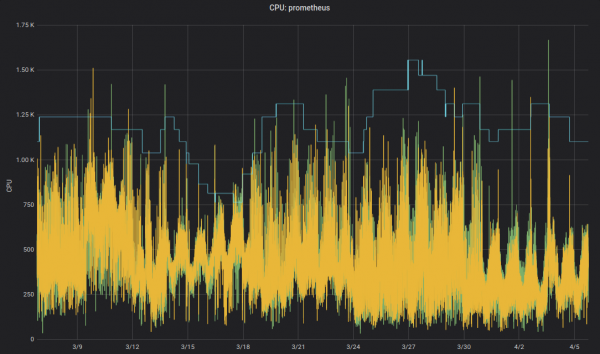
para componentes de infraestructura. Las aplicaciones no críticas también pueden usar VPA.
de Fairwind es una herramienta que crea VPA para cada despliegue en el espacio de nombres, y luego muestra la recomendación de VPA en su tablero. Puede ayudar a los desarrolladores a establecer las solicitudes adecuadas de CPU/memoria para sus aplicaciones:
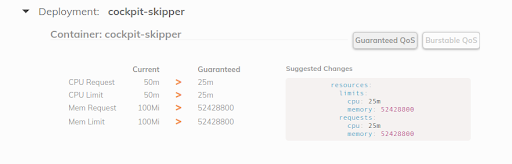
Escribí un pequeño en 2019, y recientemente en .
Uso de instancias EC2 Spot
Por fin, lo que no es menos importante, los costos de AWS EC2 se pueden reducir utilizando instancias Spot como nodos de trabajo de Kubernetes. . Las instancias Spot están disponibles con descuentos de hasta el 90% en comparación con los precios bajo demanda. Ejecutar Kubernetes en EC2 Spot es una buena combinación: necesitas especificar varios tipos de instancias para una mayor disponibilidad, lo que significa que puedes obtener un nodo más grande por el mismo precio o menos, y la capacidad aumentada puede ser utilizada por las cargas de trabajo de contenedores de Kubernetes.
¿Cómo ejecutar Kubernetes en EC2 Spot? Hay varias opciones: usar un servicio de terceros como SpotInst (ahora se llama «Spot», no me preguntes por qué), o simplemente agregar un AutoScalingGroup (ASG) de Spot a tu clúster. Por ejemplo, aquí tienes un fragmento de CloudFormation para un ASG de Spot 'optimizados por capacidad' con varios tipos de instancias:
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Algunas observaciones sobre el uso de Spot con Kubernetes:
- Necesitas manejar las terminaciones de Spot, por ejemplo, mediante la evacuación de nodos al detener la instancia.
- Zalando utiliza escalado automático oficial del clúster con prioridades del grupo de nodos.
- Los nodos Spot para aceptar ‘registros’ de cargas de trabajo para ejecutarse en Spot.
Currículum
Espero que encuentres útiles algunas de las herramientas presentadas para reducir tu factura de computación en la nube. También puedes encontrar gran parte del contenido del artículo en .
¿Cuáles son tus mejores prácticas para ahorrar costos en la nube en Kubernetes? Por favor, háznoslo saber en .
De hecho, menos de 3 CPUs virtuales serán utilizables, ya que el ancho de banda del nodo se reduce debido a los recursos del sistema reservados. Kubernetes distingue entre la capacidad física del nodo y los recursos 'asignables'.).
Ejemplo de cálculo: una instancia m5.large con 8 GiB de memoria costaría aproximadamente 84 dólares al mes (eu-central-1, On-Demand), lo que significa que bloquear 1/8 del nodo cuesta alrededor de 10 dólares al mes.
Hay muchas otras formas de reducir tu factura de EC2, como instancias reservadas, planes de ahorro, etc. — no abordaré estos temas aquí, ¡pero definitivamente deberías investigarlos!
Fuente: habr.com
