

Así es la redundancia
Los códigos de redundancia* se utilizan ampliamente en sistemas informáticos para aumentar la fiabilidad del almacenamiento de datos. En Yandex, se aplican en muchos proyectos. Por ejemplo, el uso de códigos de redundancia en lugar de replicación en nuestro almacenamiento de objetos interno ahorra millones sin disminuir la fiabilidad. Pero a pesar de su amplia difusión, descripciones claras de cómo funcionan los códigos de redundancia son muy raras. Aquellos que desean entender se enfrentan a lo siguiente (de ):
Me llamo Vadim, en Yandex me encargo del desarrollo del almacenamiento de objetos interno MDS. En este artículo, describiré con palabras simples los fundamentos teóricos de los códigos de redundancia (códigos de Reed-Solomon y LRC). Explicaré cómo funciona, sin matemáticas complejas ni términos poco comunes. Al final, proporcionaré ejemplos del uso de códigos de redundancia en Yandex.
No profundizaré en una serie de detalles matemáticos, pero proporcionaré enlaces para aquellos que deseen profundizar más. También señalaré que algunas definiciones matemáticas pueden no ser estrictas, ya que el artículo está dirigido no a matemáticos, sino a ingenieros que quieren comprender la esencia del asunto.
* En la literatura en inglés, los códigos de redundancia a menudo se denominan erasure codes.
1. La esencia de los códigos de redundancia
La esencia de todos los códigos de redundancia es extremadamente simple: almacenar (o transmitir) datos de manera que no se pierdan ante la aparición de errores (fallos de discos, errores de transmisión de datos, etc.).
En la mayoría* de los códigos de redundancia, los datos se dividen en n bloques de datos, y para ellos se consideran m bloques de códigos de redundancia, en total se obtienen n + m bloques. Los códigos de redundancia se construyen de tal manera que se puedan recuperar n bloques de datos utilizando solo una parte de los n + m bloques. A continuación, solo examinaremos los códigos de redundancia de bloques, es decir, aquellos en los que los datos se dividen en bloques.
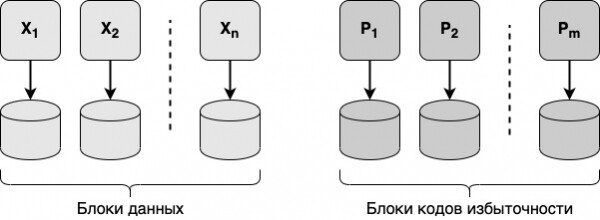
Para recuperar todos los n bloques de datos, se necesita tener al menos n de n + m bloques, ya que no se pueden obtener n bloques con solo n-1 bloque (en este caso, se necesitaría tomar 1 bloque «del aire»). ¿Son suficientes n bloques arbitrarios de n + m bloques para recuperar todos los datos? Depende del tipo de códigos de redundancia. Por ejemplo, los códigos de Reed-Solomon permiten recuperar todos los datos con n bloques arbitrarios, mientras que los códigos de redundancia LRC no siempre lo permiten.
Almacenamiento de datos
En los sistemas de almacenamiento de datos, generalmente, cada uno de los bloques de datos y bloques de códigos de redundancia se graba en un disco separado. Así, en caso de que falle un disco arbitrario, los datos originales aún se pueden recuperar y leer. Los datos pueden recuperarse incluso en caso de que varios discos fallen simultáneamente.
Transmisión de datos
Se pueden usar códigos de redundancia para la transmisión confiable de datos en una red no confiable. Los datos transmitidos se dividen en bloques y se calculan códigos de redundancia para ellos. Tanto los bloques de datos como los bloques de códigos de redundancia se transmiten por la red. En caso de errores en bloques arbitrarios (hasta cierto número de bloques), los datos aún se pueden transmitir sin errores a través de la red. Los códigos de Reed-Solomon, por ejemplo, se utilizan para la transmisión de datos a través de líneas de comunicación ópticas y en comunicación por satélite.
* También existen códigos de redundancia en los que los datos no se dividen en bloques, como los códigos de Hamming y los códigos CRC, que se utilizan ampliamente para la transmisión de datos en redes Ethernet. Estos son códigos para codificación resistente a fallos, destinados a la detección de errores, y no a su corrección (el código de Hamming también permite corregir errores parcialmente).
2. Códigos de Reed-Solomon
Los códigos de Reed-Solomon son uno de los códigos de redundancia más ampliamente utilizados, inventados en la década de 1960 y que encontraron su aplicación generalizada en la década de 1980 para la producción en serie de discos compactos.
Hay dos preguntas clave para comprender los códigos de Reed-Solomon: 1) ¿cómo se crean los bloques de códigos de redundancia?; 2) ¿cómo se recuperan los datos utilizando bloques de códigos de redundancia? Buscaremos respuestas a estas preguntas.
Para simplificar, a partir de ahora consideraremos que n=6 y m=4. Otras configuraciones se analizan por analogía.
Cómo crear bloques de códigos de redundancia
Cada bloque de códigos de redundancia se considera independientemente de los demás. Para calcular cada bloque se utilizan todos los n bloques de datos. En el esquema a continuación, X1-X6 son bloques de datos y P1–P4 son bloques de códigos de redundancia.
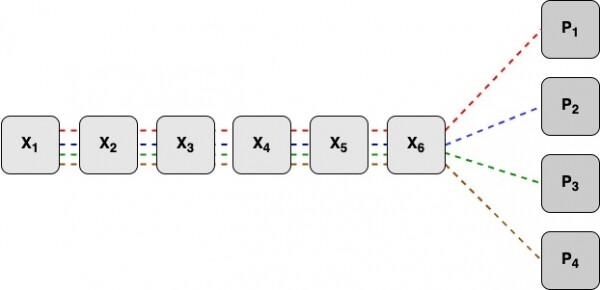
Todos los bloques de datos deben tener el mismo tamaño; para la alineación se pueden usar bits nulos. Los bloques de códigos de redundancia resultantes tendrán el mismo tamaño que los bloques de datos. Todos los bloques de datos se dividen en palabras (por ejemplo, de 16 bits). Supongamos que hemos dividido los bloques de datos en k palabras. Entonces, todos los bloques de códigos de redundancia también se dividirán en k palabras.
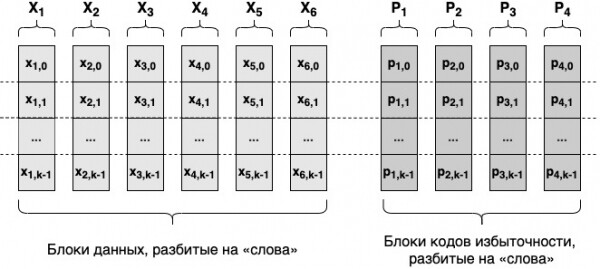
Para calcular la i-ésima palabra de cada bloque de redundancia se utilizarán las i-ésimas palabras de todos los bloques de datos. Se calcularán según la siguiente fórmula:
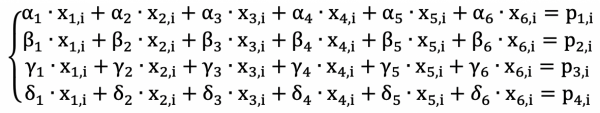
Aquí los valores x son las palabras de los bloques de datos, p son las palabras de los bloques de códigos de redundancia, todos alfa, beta, gamma y delta son números especialmente escogidos, iguales para todos los i. Debo mencionar que todos estos valores no son números ordinarios, sino elementos del campo de Galois; las operaciones +, -, *, / no son las operaciones comunes que conocemos, sino operaciones especiales definidas sobre los elementos del campo de Galois.
¿Para qué sirven los campos de Galois?
A primera vista, todo parece simple: dividimos los datos en bloques, los bloques en palabras, y usando las palabras de los bloques de datos calculamos las palabras de los bloques de códigos de redundancia, obteniendo así bloques de códigos de redundancia. En general, así es como funciona, pero el diablo está en los detalles:
- Como se mencionó anteriormente, el tamaño de la palabra es fijo, en nuestro ejemplo, 16 bits. Las fórmulas anteriores para los códigos de Reed-Solomon son tales que al usar números enteros comunes, el resultado del cálculo de p puede no ser representable con una palabra de tamaño permitido.
- Al recuperar datos, las fórmulas anteriores se considerarán como un sistema de ecuaciones que debe resolverse para recuperar los datos. En el proceso de resolución, puede ser necesario realizar divisiones de números enteros entre sí, cuyo resultado será un número decimal que no puede ser representado con precisión en la memoria de la computadora.
Estos problemas impiden usar números enteros para los códigos de Reed-Solomon. La solución es original y se puede describir de la siguiente manera: inventemos números especiales que se puedan representar mediante palabras de la longitud necesaria (por ejemplo, 16 bits), y el resultado de todas las operaciones realizadas sobre ellos (suma, resta, multiplicación, división) también se representará en la memoria de la computadora mediante palabras de la longitud necesaria.
Estos números "especiales" han sido estudiados durante mucho tiempo en matemáticas, y se les llama campos. Un campo es un conjunto de elementos con operaciones definidas de suma, resta, multiplicación y división.
Los campos de Galois* son campos que tienen un resultado único para cada operación (+, -, *, /) entre cualesquiera dos elementos del campo. Se pueden construir campos de Galois para números que son potencias de 2: 2, 4, 8, 16, etc. (de hecho, para cualquier potencia de un número primo p, pero en la práctica solo nos interesan las potencias de 2). Por ejemplo, para palabras de 16 bits, este campo contiene 65,536 elementos, para los cuales se puede encontrar el resultado de cualquier operación (+, -, *, /) para cada par de ellos. Los valores x, p, alfa, beta, gamma, delta de las ecuaciones anteriores se considerarán como elementos del campo de Galois para los cálculos.
Por lo tanto, tenemos un sistema de ecuaciones con el que se pueden construir bloques de códigos de redundancia, escribiendo un programa de computadora correspondiente. Con este mismo sistema de ecuaciones, se puede llevar a cabo la recuperación de datos.
* Esta no es una definición estricta, más bien es una descripción.
Cómo recuperar datos
La recuperación es necesaria cuando de n + m bloques, algunos bloques están ausentes. Estos pueden ser bloques de datos o bloques de códigos de redundancia. La ausencia de bloques de datos y/o bloques de códigos de redundancia significará que en las ecuaciones anteriores se desconocen las variables correspondientes x y/o p.
Las ecuaciones para los códigos de Reed-Solomon se pueden considerar como un sistema de ecuaciones en el que todos los valores alfa, beta, gamma, delta son constantes, todos los x y p correspondientes a los bloques disponibles son variables conocidas, y los demás x y p son desconocidos.
Por ejemplo, supongamos que los bloques de datos 1, 2, 3 y el bloque de códigos de redundancia 2 no están disponibles, entonces para el i-ésimo grupo de palabras habrá el siguiente sistema de ecuaciones (los desconocidos están marcados en rojo):
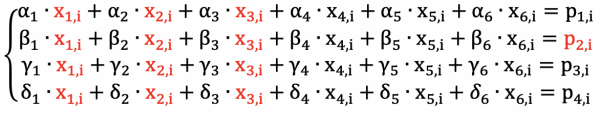
¡Tenemos un sistema de 4 ecuaciones con 4 incógnitas, así que podemos resolverlo y recuperar los datos!
De este sistema de ecuaciones se derivan varias conclusiones sobre la recuperación de datos para los códigos de Reed-Solomon (n bloques de datos, m bloques de códigos de redundancia):
- Los datos se pueden recuperar ante la pérdida de cualquier m bloques o menos. Ante la pérdida de m+1 bloques o más, los datos no se pueden recuperar: no se puede resolver un sistema de m ecuaciones con m + 1 incógnitas.
- Para recuperar incluso un solo bloque de datos, es necesario usar cualesquiera n de los bloques restantes, pudiendo emplear cualquiera de los códigos de redundancia.
Qué más hay que saber
En la descripción anterior, evito una serie de cuestiones importantes que requieren un mayor enfoque en la matemática. En particular, no menciono lo siguiente:
- El sistema de ecuaciones para los códigos de Reed-Solomon debe tener (una única) solución para cualesquiera combinaciones de incógnitas (no más de m incógnitas). A partir de esta exigencia se seleccionan los valores de alfa, beta, gamma y delta.
- El sistema de ecuaciones debe poder construirse automáticamente (dependiendo de qué bloques no estén disponibles) y resolverse.
- Es necesario construir un campo de Galois: para un tamaño de palabra dado, se debe ser capaz de encontrar el resultado de cualquier operación (+, -, *, /) para cualesquiera dos elementos.
Al final del artículo hay enlaces a literatura sobre estas cuestiones importantes.
Elección de n y m
¿Cómo elegir n y m en la práctica? En la práctica, en los sistemas de almacenamiento de datos, los códigos de redundancia se utilizan para ahorrar espacio, por lo que siempre m se elige menor que n. Sus valores concretos dependen de varios factores, incluidos:
- Fiabilidad del almacenamiento de datos. Cuanto mayor sea m, mayor será el número de fallos de discos que se pueden soportar, es decir, mayor será la fiabilidad.
- Redundancia de almacenamiento. Cuanto mayor sea la relación m / n, mayor será la redundancia de almacenamiento, y más costosa será la sistema.
- Tiempo de procesamiento de solicitudes. Cuanto mayor sea la suma n + m, más largo será el tiempo de respuesta a las solicitudes. Dado que para leer los datos (durante la recuperación) es necesario leer n bloques almacenados en n discos diferentes, el tiempo de lectura será determinado por el disco más lento.
Además, almacenar datos en varios centros de datos impone restricciones adicionales en la elección de n y m: cuando se desconecta 1 centro de datos, los datos aún deben ser accesibles para lectura. Por ejemplo, al almacenar datos en 3 centros de datos, se debe cumplir la condición: m >= n/2; de lo contrario, puede darse el caso de que los datos no sean accesibles para lectura al desconectar 1 centro de datos.
3. LRC — Códigos de Reconstrucción Local
Para recuperar datos utilizando los códigos de Reed-Solomon, es necesario utilizar n bloques de datos arbitrarios. Esta es una desventaja muy significativa para los sistemas de almacenamiento de datos distribuidos, ya que para recuperar datos de un disco roto se tiene que leer datos de la mayoría de los otros, creando una carga adicional considerable sobre los discos y la red.
Los errores más comunes son la falta de acceso a un bloque de datos debido a la falla o sobrecarga de un disco. ¿Se puede reducir de algún modo la carga excesiva para recuperar datos en tal (el caso más común) situación? Resulta que sí: para esto existen los códigos de redundancia LRC.
LRC (Códigos de Reconstrucción Local) son códigos de redundancia creados por Microsoft para su uso en Windows Azure Storage. La idea detrás de LRC es muy simple: dividir todos los bloques de datos en dos (o más) grupos y calcular la parte de los bloques de códigos de redundancia para cada grupo por separado. Entonces, parte de los bloques de códigos de redundancia se calculará utilizando todos los bloques de datos (en LRC se denominan códigos de redundancia globales), mientras que la otra parte se calculará utilizando uno de los dos grupos de bloques de datos (que se denominan códigos de redundancia locales).
LRC se representa con tres números: n-r-l, donde n es la cantidad de bloques de datos, r es la cantidad de bloques de códigos de redundancia globales, l es la cantidad de bloques de códigos de redundancia locales. Para leer datos cuando un bloque de datos no está disponible, solo es necesario leer n/l bloques; esto es l veces menos que en los códigos de Reed-Solomon.
Como ejemplo, consideremos el esquema LRC 6-2-2. X1–X6 son 6 bloques de datos, P1, P2 son 2 bloques de redundancia global, P3, P4 son 2 bloques de redundancia local.
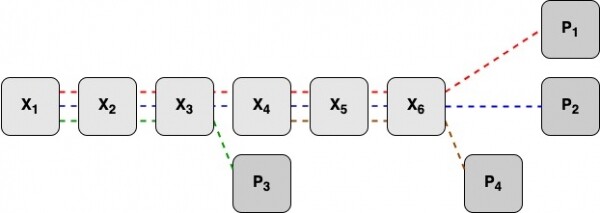
Los bloques de códigos de redundancia P1, P2 se calculan utilizando todos los bloques de datos. El bloque de códigos de redundancia P3 se calcula utilizando los bloques de datos X1–X3, y el bloque de códigos de redundancia P4 se calcula utilizando los bloques de datos X4–X6.
Lo demás se hace en LRC de manera similar a los códigos de Reed-Solomon. Las ecuaciones para calcular las palabras de los bloques de códigos de redundancia serán las siguientes:
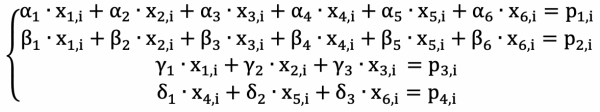
Para seleccionar los números alfa, beta, gamma, delta es necesario cumplir una serie de condiciones que garantizan la posibilidad de recuperación de datos (es decir, la solución del sistema de ecuaciones). Puedes leer más sobre esto en .
Además, en la práctica, para calcular los códigos locales de redundancia P3, P4 se utiliza la operación XOR.
De la sistema de ecuaciones para LRC se deducen varias conclusiones:
- Para recuperar cualquier bloque de datos, es suficiente leer n/l bloques (n/2 en nuestro ejemplo).
- Si r + l bloques son inaccesibles, y todos los bloques pertenecen a un mismo grupo, no se pueden recuperar los datos. Esto se puede explicar fácilmente con un ejemplo. Supongamos que los bloques X1–X3 y P3 son inaccesibles: estos son r + l bloques de un mismo grupo, 4 en nuestro caso. Entonces tenemos un sistema de 3 ecuaciones con 4 incógnitas, el cual no se puede resolver.
- En todos los demás casos de inaccesibilidad de r + l bloques (cuando al menos un bloque de cada grupo es accesible), los datos se pueden recuperar en LRC.
Así, LRC supera a los códigos de Reed-Solomon en la recuperación de datos tras errores únicos. En los códigos de Reed-Solomon, para recuperar incluso un bloque de datos se deben utilizar n bloques, mientras que en LRC, para recuperar un bloque de datos, es suficiente utilizar n/l bloques (n/2 en nuestro ejemplo). Por otro lado, LRC es menos eficiente que los códigos de Reed-Solomon en cuanto al número máximo de errores permitidos. En los ejemplos anteriores, los códigos de Reed-Solomon pueden recuperar datos en caso de producirse hasta 4 errores, mientras que para LRC hay 2 combinaciones de 4 errores en las que no se pueden recuperar los datos.
Lo que es más importante depende de la situación específica, pero a menudo el ahorro en la carga redundante que proporciona LRC supera una fiabilidad de almacenamiento algo menor.
4. Otros códigos de redundancia
Además de los códigos de Reed-Solomon y LRC, existen muchos otros códigos de redundancia. Diferentes códigos de redundancia utilizan diferentes matemáticas. Aquí algunos otros códigos de redundancia:
- Código de redundancia utilizando el operador XOR. La operación XOR se aplica sobre n bloques de datos, obteniendo 1 bloque de códigos de redundancia, es decir, el esquema n+1 (n bloques de datos, 1 código de redundancia). Utilizado en , donde los bloques de datos y los códigos de redundancia se escriben cíclicamente en todos los discos del arreglo.
- El algoritmo par-impar, basado en la operación XOR. Permite construir 2 bloques de códigos de redundancia, es decir, un esquema n+2.
- El algoritmo STAR, basado en la operación XOR. Permite construir 3 bloques de códigos de redundancia, es decir, un esquema n+3.
- Códigos Pyramide — otros códigos de redundancia de Microsoft.
5. Uso en Yandex
Varios proyectos de infraestructura de Yandex utilizan códigos de redundancia para un almacenamiento de datos fiable. Aquí hay algunos ejemplos:
- El almacenamiento de objetos interno MDS, del cual hablé al principio del artículo.
- — Sistema MapReduce de Yandex.
- (Yandex DataBase) — base de datos distribuida newSQL.
En MDS se utilizan códigos de redundancia LRC, esquema 8-2-2. Los datos con códigos de redundancia se escriben en 12 discos diferentes en diferentes servidores en 3 centros de datos: 4 servidores en cada centro de datos. Más detalles sobre esto se pueden encontrar en .
En YT se utilizan tanto los códigos de Reed-Solomon (esquema 6-3), que fueron implementados primero, como los códigos de redundancia LRC (esquema 12-2-2), siendo LRC el método preferido de almacenamiento.
En YDB se utilizan códigos de redundancia basados en par-impar (esquema 4-2). Ya se ha hablado sobre los códigos de redundancia en YDB .
La aplicación de diferentes esquemas de códigos de redundancia se debe a los diferentes requisitos que se presentan a los sistemas. Por ejemplo, en MDS, los datos almacenados con LRC se distribuyen en 3 centros de datos. Es importante que los datos permanezcan accesibles para la lectura incluso si falla 1 de los centros de datos, por lo tanto, los bloques deben estar distribuidos por centros de datos de tal manera que, al no estar disponible cualquier centro de datos, la cantidad de bloques no accesibles no sea mayor que la permitida. En el esquema 8-2-2 se pueden colocar 4 bloques en cada centro de datos, por lo que al desconectar cualquier centro de datos habrá 4 bloques no accesibles, y los datos podrán ser leídos. Cualquiera que sea el esquema que elijamos al distribuir en 3 centros de datos, en cualquier caso debe cumplirse (r + l) / n >= 0,5, es decir, la redundancia de almacenamiento será como mínimo del 50%.
En YT la situación es diferente: cada clúster de YT se encuentra completamente en 1 centro de datos (diferentes clústeres en diferentes centros de datos), por lo que no hay tal restricción. El esquema 12-2-2 proporciona una redundancia del 33%, lo que significa que almacenar datos resulta más económico, además pueden soportar hasta 4 desconexiones simultáneas de discos, igual que el esquema en MDS.
Existen muchas características adicionales en el uso de códigos de redundancia en sistemas de almacenamiento y procesamiento de datos: matices en la recuperación de datos, impacto de la recuperación en el tiempo de respuesta de las consultas, particularidades en la escritura de datos, etc. Tengo la intención de hablar sobre estas y otras características de la aplicación de códigos de redundancia en la práctica, si el tema resulta interesante.
6. Enlaces
- Serie de artículos sobre códigos de Reed-Solomon y campos de Galois:
Se analiza la matemática de manera accesible y detallada. - Artículo de Microsoft sobre LRC:
En la sección 2 se explica brevemente la teoría, y luego se analiza la experiencia de aplicación de LRC en la práctica. - Esquema even-odd:
- Esquema STAR:
- Códigos piramidales:
- Códigos de redundancia en MDS:
- Códigos de redundancia en YT:
- Códigos de redundancia en YDB:
Fuente: habr.com
