

Actualmente trabajo en una empresa proveedora de software, específicamente en soluciones de gestión de acceso. Mi experiencia 'de una vida pasada' está relacionada con el lado del cliente: una gran organización financiera. En ese entonces, nuestro grupo de control de acceso en el departamento de seguridad de la información no podía presumir de tener grandes competencias en IdM. Aprendimos mucho en el proceso y tuvimos que enfrentar numerosos desafíos para establecer un mecanismo funcional de gestión de derechos de usuarios en los sistemas de información de la empresa.
Al combinar mi arduo aprendizaje del lado del cliente con los conocimientos y competencias del proveedor, quiero compartir con ustedes, en esencia, una guía paso a paso: cómo crear un modelo de gestión de acceso basado en roles en una gran empresa y qué resultados podrá ofrecer. Mi guía consta de dos partes: la primera, preparándonos para construir el modelo; la segunda, construyéndolo propiamente dicho. Aquí tienen la primera parte, la preparatoria.
N.B. Construir un modelo de roles es, desafortunadamente, un proceso y no un resultado. Más bien, es parte del proceso de creación de un ecosistema de gestión de acceso en la empresa. Así que prepárense para un juego a largo plazo.
Primero, definamos: ¿qué es la gestión de acceso basada en roles? Supongamos que tienen un gran banco con decenas o incluso cientos de miles de empleados (sujetos), cada uno de los cuales tiene decenas de derechos de acceso a cientos de sistemas de información internos (objetos). Ahora multiplique el número de objetos por el número de sujetos; ese es el mínimo de relaciones que deben establecer inicialmente y luego controlar. ¿Es realmente posible hacerlo manualmente? Por supuesto que no; por eso surgieron los roles.
Un rol es un conjunto de permisos necesarios para que un usuario o grupo de usuarios realice ciertas tareas laborales. Cada empleado puede tener uno o varios roles, y cada rol puede contener desde uno hasta muchos permisos que se permiten al usuario en el marco de ese rol. Los roles pueden estar vinculados a puestos específicos, departamentos o tareas funcionales de los empleados.
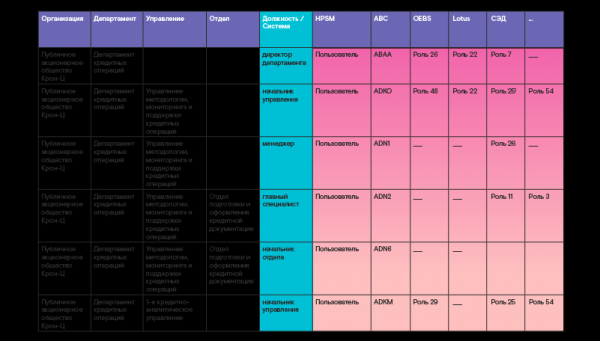
Los roles generalmente se crean a partir de los poderes individuales de un empleado en cada sistema de información. Luego, de los roles de cada sistema se forman los roles de negocio globales. Por ejemplo, el rol de negocio de «gerente de crédito» incluirá varios roles individuales en los sistemas de información que se utilizan en la oficina del cliente del banco. Por ejemplo, en sistemas como el sistema bancario automatizado principal, el módulo de caja, el sistema de gestión documental electrónica, el servicio de gestión y otros. Los roles de negocio generalmente se vinculan a la estructura organizativa –en términos sencillos, al conjunto de departamentos de la empresa y de los cargos en ellos. Así se forma la matriz de roles global (un ejemplo se presenta en la tabla a continuación).
Cabe destacar que construir un modelo de roles al 100%, asegurando todos los derechos necesarios para los empleados de cada cargo en una estructura comercial, es simplemente imposible. Y no es necesario. De hecho, el modelo de roles no puede ser estático, ya que depende del entorno en constante cambio. Y del cambio en la actividad empresarial de la empresa, que, por lo tanto, influye en la modificación de la estructura organizativa y las funciones. Y de la falta de recursos suficientes, y del incumplimiento de las descripciones de cargo, y de la búsqueda de beneficios a expensas de la seguridad, y de muchos otros factores. Por lo tanto, se debe construir un modelo de roles que pueda satisfacer hasta el 80% de las necesidades de los usuarios en los derechos básicos necesarios al asumir un cargo. Los otros 20% podrán, si es necesario, solicitarlos más tarde mediante solicitudes separadas.
Por supuesto, puedes preguntar: «¿Y no existen modelos de roles al 100%?» Bueno, sí, eso ocurre, por ejemplo, en estructuras no comerciales, que no están sujetas a cambios frecuentes, –en algún instituto de investigación. O en organizaciones de la industria de defensa con un alto nivel de seguridad, donde la seguridad es primordial. También puede suceder en una estructura comercial, pero dentro de un departamento específico, cuyo trabajo es un proceso bastante estático y predecible.
La principal ventaja de la gestión de roles es la simplificación de la entrega de derechos, dado que el número de roles es significativamente menor que el de los usuarios del sistema de información. Y esto es cierto para cualquier industria.
Tomemos una empresa de retail: en ella trabajan miles de vendedores, pero todos tienen los mismos permisos en el sistema N, y solo se creará un rol para ellos. Cuando llega un nuevo vendedor a la empresa, se le asigna automáticamente el rol adecuado en el sistema, donde ya están todos los permisos necesarios. También, con un solo clic, se pueden cambiar los derechos de miles de vendedores a la vez, por ejemplo, agregar una nueva opción para generar informes. No es necesario realizar mil operaciones vinculando el nuevo permiso a cada cuenta, basta con añadir esta opción al rol, y aparecerá para todos los vendedores al mismo tiempo.
Otra ventaja de la gestión por roles es la exclusión de la asignación de permisos incompatibles. Es decir, un empleado que tiene un rol determinado en el sistema no puede tener simultáneamente otro rol cuyos derechos no deben combinarse con los del primero. Un claro ejemplo es la prohibición de combinar las funciones de ingreso y control de una operación financiera.
Todos los interesados en saber cómo surgió la gestión de roles de acceso pueden
sumergirse en un recorrido histórico
Si miramos al pasado, la comunidad de TI reflexionó por primera vez sobre los métodos de gestión de acceso en los años 70 del siglo XX. Aunque las aplicaciones eran bastante simples en ese momento, al igual que ahora, todos deseaban gestionar cómodamente el acceso a ellas. Proporcionar, cambiar y controlar los derechos de los usuarios era simplemente para facilitar la comprensión de qué acceso tenía cada uno de ellos. Pero en esa época no existían estándares comunes, se desarrollaban los primeros sistemas de gestión de acceso, y cada empresa se basaba en sus propias concepciones y reglas.
Hoy en día, existen muchos modelos diferentes de gestión de acceso, pero no aparecieron de inmediato. Nos centraremos en aquellos que han hecho una contribución significativa al desarrollo de esta área.
El primer y, probablemente, el modelo más sencillo es La gestión de acceso discrecional (DAC – Control de acceso discrecional). Este modelo implica que todos los participantes en el proceso de acceso comparten los derechos. Cada usuario tiene acceso a objetos u operaciones específicos. En esencia, aquí hay múltiples sujetos de derechos que corresponden a múltiples objetos. Este modelo ha sido considerado demasiado flexible y complicado de mantener: las listas de acceso con el tiempo se vuelven enormes y difíciles de controlar.
El segundo modelo es Control de acceso obligatorio (MAC – Mandatory access control). En este modelo, cada usuario tiene acceso a un objeto de acuerdo con la autorización a un cierto nivel de confidencialidad de los datos. En consecuencia, los objetos deben clasificarse según su nivel de confidencialidad. A diferencia del primer modelo flexible, este resultó ser demasiado estricto y restrictivo. Su aplicación no se justifica cuando una empresa tiene numerosos recursos de información diversos: para delimitar el acceso a los diferentes recursos, será necesario introducir muchas categorías que no se cruzarán.
Dada la obvia imperfección de estos dos métodos, la comunidad de TI continuó desarrollando modelos más flexibles y, al mismo tiempo, más o menos universales para soportar diferentes tipos de políticas organizativas de control de acceso. Y fue entonces cuando apareció ¡el tercer modelo de control de acceso basado en roles! Este enfoque resultó ser el más prometedor, ya que exige no solo la autorización de la identidad del usuario, sino también sus funciones laborales en los sistemas.
La primera estructura de modelo de roles claramente descrita fue propuesta por los científicos estadounidenses David Ferraiolo y Richard Kuhn del Instituto Nacional de Estándares y Tecnología de EE. UU. en 1992. Fue entonces cuando apareció por primera vez el término RBAC (Control de acceso basado en roles). Estas investigaciones y descripciones de los componentes básicos, así como sus interrelaciones, sentaron las bases del estándar vigente hasta hoy INCITS 359-2012, aprobado por el Comité Internacional de Estándares de Tecnología de la Información (INCITS).
El estándar define el rol como "una función dentro de la organización con cierta semántica relacionada con los poderes y responsabilidades asignadas al usuario designado a ese rol". El documento establece los elementos principales del RBAC: usuarios, sesiones, roles, permisos, operaciones y objetos, así como las relaciones e interacciones entre ellos.
El estándar proporciona la estructura mínima necesaria para construir un modelo de roles: la agrupación de permisos en roles y luego la concesión de acceso a los usuarios a través de esos roles. Se definen mecanismos para la formación de roles a partir de objetos y operaciones, así como la jerarquía de roles y la herencia de poderes. En cualquier empresa existen roles que agrupan los poderes elementales necesarios para todos los empleados. Esto puede incluir acceso al correo electrónico, al CMS, al portal corporativo, etc. Estos poderes pueden incluirse en un rol general llamado "empleado", de manera que no sea necesario enumerar todos los permisos elementales en cada uno de los roles de nivel superior repetidamente. Basta con indicar la característica de herencia del rol "empleado".
Más tarde, el estándar fue complementado con nuevos atributos de acceso relacionados con un entorno en constante cambio. Se introdujo la posibilidad de establecer restricciones estáticas y dinámicas. Las estáticas implican la imposibilidad de combinar roles (la introducción y el control de operaciones mencionados anteriormente). Las restricciones dinámicas pueden estar determinadas por parámetros cambiantes, como el tiempo (horas/días laborales/no laborales), la ubicación (oficina/casa), etc.
Es importante mencionar el control de acceso basado en atributos (ABAC — Control de acceso basado en atributos). Este enfoque se basa en proporcionar acceso mediante reglas de uso compartido de atributos. Este modelo puede usarse de manera independiente, pero a menudo complementa activamente al clásico de roles: a un rol específico se le pueden agregar atributos de usuarios, recursos y dispositivos, así como también del tiempo o la ubicación. Esto permite utilizar menos roles, introducir restricciones adicionales y hacer que el acceso sea lo más mínimo posible, aumentando así la seguridad.
Por ejemplo, se puede permitir el acceso a las cuentas a un contable si trabaja en una región específica. Entonces, la ubicación del especialista se compararía con un valor de referencia determinado. O se puede otorgar acceso a las cuentas solo si el usuario se autentica desde un dispositivo registrado como permitido. Es un buen complemento al modelo de roles, pero se utiliza raramente por la necesidad de crear muchas reglas y tablas de permisos o restricciones.
Permítanme dar un ejemplo de aplicación de ABAC de mi 'vida pasada'. En nuestro banco había varias sucursales. Los empleados de las oficinas de clientes en estas sucursales realizaban operaciones idénticas, pero debían trabajar en el sistema principal solo con las cuentas de su región. Al principio, comenzamos a crear roles separados para cada región, y obtuvimos una gran cantidad de roles repetidos con acceso a diferentes cuentas. Luego, al usar el atributo de ubicación del usuario y vincularlo a un rango específico de cuentas para la verificación, reducimos significativamente el número de roles en el sistema. Como resultado, quedaron roles solo para una sucursal, que se replicaron para los puestos correspondientes en todas las demás divisiones territoriales del banco.
Ahora hablemos sobre los pasos preparatorios necesarios sin los cuales simplemente no se puede construir un modelo de roles funcional.
Paso 1. Creamos el modelo funcional
Lo primero es crear un modelo funcional: un documento de alto nivel que describa detalladamente la funcionalidad de cada departamento y cada puesto. Generalmente, la información proviene de diversos documentos: descripciones de puestos y regulaciones de los distintos departamentos: secciones, direcciones, departamentos. El modelo funcional debe ser aprobado por todos los departamentos interesados (negocios, control interno, seguridad) y ratificado por la dirección de la empresa. ¿Para qué sirve este documento? Para que el modelo de roles pueda referenciarlo. Por ejemplo, si se va a construir un modelo de roles basado en los derechos existentes de los empleados, los cuales fueron extraídos del sistema y «unificados». Entonces, al coordinar los roles obtenidos con el propietario del negocio, se puede hacer referencia a un punto específico del modelo funcional, que justifique la inclusión de un derecho u otro en el rol.
Paso 2. Auditar los sistemas de TI y elaborar un plan de priorización
En la segunda etapa, es necesario realizar una auditoría de los sistemas de TI para entender cómo se organiza el acceso a ellos. Por ejemplo, en mi empresa financiera había varias centenas de sistemas de información. Todos los sistemas tenían algunos indicios de gestión de roles, en la mayoría había ciertos roles, pero eran principalmente teóricos o estaban documentados en manuales que estaban desactualizados, y el acceso se concedía en función de las solicitudes efectivas de los usuarios. Naturalmente, construir un modelo de roles en varias centenas de sistemas es prácticamente imposible, hay que empezar por algún lado. Realizamos un análisis exhaustivo del proceso de gestión de accesos para determinar su nivel de madurez. Durante el análisis, se establecieron criterios de priorización para los sistemas de información: criticidad, disponibilidad, planes para su desactivación, etc. Con ellos, organizamos la secuencia para el desarrollo/actualización de los modelos de roles de estos sistemas. Luego, incluimos los modelos de roles en el plan de integración con la solución de Gestión de Identidades, para automatizar la gestión de accesos.
Entonces, ¿cómo se determina la criticidad de un sistema? Responda las siguientes preguntas:
- ¿Está el sistema relacionado con procesos operativos de los cuales depende la actividad principal de la empresa?
- ¿Afectará la interrupción del funcionamiento del sistema a la integridad de los activos de la empresa?
- ¿Cuál es el tiempo máximo de inactividad del sistema tras el cual no es posible restablecer la actividad después de una interrupción?
- ¿Puede la violación de la integridad de la información en el sistema llevar a consecuencias irreversibles, tanto financieras como reputacionales?
- Criticidad frente al fraude. La existencia de funcionalidades que, sin un control adecuado, podrían permitir la realización de acciones fraudulentas internas/externas;
- ¿Cuáles son los requisitos legales, así como las normas y procedimientos internos para estos sistemas? ¿Habrá multas por parte de los reguladores en caso de incumplimiento?
En nuestra empresa financiera llevamos a cabo una auditoría de esta manera. La dirección desarrolló un procedimiento de auditoría de Revisión de Derechos de Acceso para abordar los usuarios existentes y derechos, comenzando por aquellos sistemas de información que estaban en la lista de alta prioridad. El departamento de seguridad fue designado como el propietario de este proceso. Pero para obtener una visión completa de los derechos de acceso en la empresa, era necesario involucrar a los departamentos de TI y de negocios. Y aquí empezaron las disputas, malentendidos e incluso a veces sabotajes: nadie quería dejar sus responsabilidades actuales y involucrarse en actividades que a primera vista parecían incomprensibles.
N.B. Las grandes empresas con procesos de TI desarrollados probablemente están familiarizadas con el procedimiento de auditoría de TI - controles generales de TI (ITGC), que permite identificar deficiencias en los procesos de TI y establecer controles para mejorar los procesos según las mejores prácticas (ITIL, COBIT, IT Governance, etc.). Esta auditoría permite a TI y a los negocios entenderse mejor y desarrollar una estrategia de desarrollo conjunta, analizar riesgos, optimizar costos y desarrollar enfoques más efectivos en el trabajo.
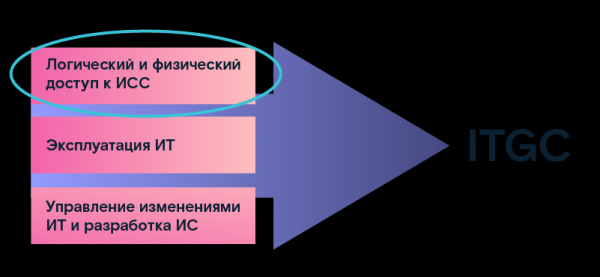
Una de las áreas de auditoría es la determinación de los parámetros de acceso lógico y físico a los sistemas de información. Los datos obtenidos los utilizamos como base para un uso posterior en la construcción del modelo de roles. Como resultado de esta auditoría, tenemos un registro de sistemas de TI, en el que se identificaron sus parámetros técnicos y se proporcionaron descripciones. Además, para cada sistema se designó un propietario del área de negocio, cuyo interés era el de la explotación de ese sistema: él era el responsable de los procesos de negocio que este sistema atendía. También se nombró a un gerente del servicio de TI, encargado de la implementación técnica de las necesidades empresariales en un sistema específico. Se registraron los sistemas más críticos para la empresa y sus parámetros técnicos, plazos de entrada y salida de operación, entre otros. Estos parámetros fueron de gran ayuda en el proceso de preparación para la construcción del modelo de roles.
Paso 3 Creando la metodología
La clave del éxito en cualquier asunto es el método elegido correctamente. Por lo tanto, tanto para construir el modelo de roles como para llevar a cabo la auditoría, necesitamos crear una metodología en la que describiremos la interacción entre las divisiones, asignaremos responsabilidades en los reglamentos de la empresa, etc.
Para empezar, es necesario investigar todos los documentos existentes que establecen el procedimiento para proporcionar acceso y derechos. En realidad, los procesos deberían estar documentados en varios niveles:
- requisitos corporativos generales;
- requisitos para las áreas de seguridad de la información (dependen de las áreas de actividad de la organización);
- requisitos para los procesos tecnológicos (instrucciones, matrices de acceso, guías metodológicas, requisitos de configuraciones).
En nuestra empresa financiera, encontramos muchos documentos desactualizados, por lo que tuvimos que actualizarlos de acuerdo con los nuevos procesos implementados.
Por orden de la dirección, se creó un grupo de trabajo que incluye representantes de las áreas de seguridad, TI, negocio y control interno. En el decreto se establecieron los objetivos de la creación del grupo, las áreas de actividad, la duración de su existencia y los responsables de cada parte. Además, desarrollamos una metodología para realizar auditorías y un procedimiento para construir un modelo de roles: estos fueron aprobados por todos los representantes responsables de las áreas y ratificados por la dirección de la empresa.
Los documentos que describen el procedimiento de trabajo, plazos, responsabilidades, etc., son la garantía de que en el camino hacia el objetivo preciado, que al principio no es evidente para todos, nadie tendrá preguntas como "¿por qué lo hacemos, para qué necesitamos esto, etc.?" y no habrá posibilidad de "eludir" o ralentizar el proceso.
Paso 4. Fijamos los parámetros del modelo actual de gestión de acceso.
Elaboramos lo que se llama el "pasaporte del sistema" en cuanto a gestión de acceso. En esencia, se trata de un cuestionario sobre un sistema de información específico, en el que se registran todos los algoritmos de gestión de acceso a este. Las empresas que ya han implementado soluciones de clase IdM están familiarizadas con este tipo de cuestionario, ya que es el punto de partida para la investigación de los sistemas.
Parte de los parámetros sobre el sistema y los propietarios se trasladó al cuestionario del registro de TI (ver paso 2, auditoría), pero se añadieron nuevos:
- cómo se gestionan las cuentas (directamente en la base de datos o a través de interfaces programáticas);
- cómo los usuarios acceden al sistema (usando una cuenta separada o utilizando credenciales de AD, LDAP, u otros);
- qué niveles de acceso al sistema se utilizan (nivel de aplicación, nivel del sistema, uso de recursos de archivos de red por parte del sistema);
- descripción y parámetros servidores, en los que opera el sistema;
- qué operaciones de gestión de cuentas son compatibles (bloqueo, renombrado, etc.);
- según qué algoritmos o reglas se forma el identificador del usuario del sistema;
- qué atributo se puede utilizar para establecer la relación con la entrada del empleado en el sistema de gestión de personal (nombre completo, número de empleado, u otro);
- todos los posibles atributos de la cuenta y las reglas para su llenado;
- qué derechos de acceso existen en el sistema (roles, grupos, derechos atómicos, etc., si hay derechos anidados o jerárquicos);
- mecanismos de separación de derechos de acceso (por funciones, departamentos, funcionalidades, etc.);
- ¿existen en el sistema reglas de segregación de funciones (SOD) y cómo funcionan;
- ¿cómo se manejan en el sistema los eventos de ausencia, transferencia, despido, actualización de datos de empleados, etc.?
Se puede seguir esta lista con detalles sobre varios parámetros y otros objetos involucrados en el proceso de gestión de acceso.
Paso 5. Creamos una descripción orientada al negocio de los poderes
Otro documento que necesitaremos al construir el modelo de roles es un catálogo de todos los posibles poderes (derechos) que se pueden otorgar a los usuarios en el sistema de información, con una descripción detallada de la función empresarial que los respalda. A menudo, los poderes en el sistema están codificados en ciertos nombres que consisten en letras y números, y los empleados del negocio no pueden entender qué hay detrás de estos símbolos. Entonces, acuden al servicio de TI, y allí... tampoco pueden responder a la pregunta, por ejemplo, sobre derechos poco utilizados. Entonces, hay que realizar pruebas adicionales.
Es bueno si ya existe una descripción empresarial o incluso una combinación de estos derechos en grupos y roles. Para algunas aplicaciones, la mejor práctica es crear un catálogo similar ya en la etapa de desarrollo. Pero esto no ocurre a menudo, así que nuevamente acudimos al departamento de TI para recopilar información sobre todos los posibles derechos y describirlos. Nuestro catálogo, al final, contendrá lo siguiente:
- nombre del poder, incluyendo el objeto al que se aplica el derecho de acceso;
- acción que se permite realizar con el objeto (visualizar, modificar, etc., posibilidad de restricción, por ejemplo, por criterios territoriales o por grupo de clientes);
- código del poder (código y nombre de la función/solicitud del sistema que se puede ejecutar utilizando el poder);
- descripción del poder (descripción detallada de las acciones en el SI al aplicar el poder y sus consecuencias para el proceso;
- estado del poder: “Activo” (si el poder está asignado a al menos un usuario) o “Inactivo” (si el poder no se utiliza).
Paso 6 Exportamos de los sistemas los datos sobre los usuarios y derechos y los alineamos con la fuente de personal.
En la etapa final de preparación, es necesario extraer los datos de los sistemas de información sobre todos los usuarios y los derechos que tienen en este momento. Aquí hay dos posibles escenarios. Primero: el departamento de seguridad tiene acceso directo al sistema y cuenta con medios para exportar informes correspondientes, lo cual no es común, pero es muy conveniente. Segundo: enviamos una solicitud al departamento de TI para obtener informes en el formato necesario. La práctica muestra que acordar con TI y recibir los datos necesarios a la primera no es fácil. Se requiere hacer varios intentos hasta que la información se obtenga en el formato y forma deseados.
Qué datos es necesario exportar:
- Nombre de la cuenta
- Nombre y apellidos del empleado al que está asignada
- Estado (activa o bloqueada)
- Fecha de creación de la cuenta
- Fecha del último uso
- Lista de derechos/grupos/roles disponibles
Así que hemos obtenido las exportaciones del sistema con todos los usuarios y todos los derechos que se les han otorgado. Y de inmediato dejamos de lado todas las cuentas bloqueadas, ya que el trabajo para construir el modelo de roles solo se llevará a cabo con los usuarios activos.
Luego, si en su empresa no hay medios automatizados para cerrar el acceso a empleados despedidos (lo cual ocurre con frecuencia) o hay una automatización parcheada que no siempre funciona correctamente, es necesario identificar todas las 'almas muertas'. Se refiere a las cuentas de empleados ya despedidos cuyos derechos no han sido bloqueados por alguna razón: es necesario bloquearlas. Para ello, comparamos los datos exportados con la fuente de personal. La exportación de personal también debe ser obtenida previamente del departamento que gestiona la base de datos de personal.
Es necesario separar las cuentas cuyos propietarios no se han encontrado en la base de datos de personal, que no están asignadas a nadie, es decir, están huérfanas. Para esta lista, necesitaremos la fecha del último uso: si es bastante reciente, aún habrá que buscar a los propietarios. Esto puede incluir cuentas de contratistas externos o cuentas de servicio que no están asignadas a nadie, pero que están relacionadas con algún proceso. Para determinar la propiedad de las cuentas, se pueden enviar correos a todos los departamentos pidiendo que respondan. Cuando se encuentren los propietarios, ingresamos sus datos en el sistema: así, todas las cuentas activas están identificadas y bloqueamos las restantes.
Una vez que nuestras exportaciones estén limpios de registros innecesarios y solo queden cuentas activas, podemos proceder a construir el modelo de rol para un sistema de información específico. Pero sobre esto hablaré en el siguiente artículo.
Autor: Lyudmila Sevastyanova, gerente de promoción de Solar inRights
Fuente: habr.com
